




Complexity AI
Complexity AI : améliore l’efficacité de l’IA pour rendre le travail plus efficace et plus simple.
Étiquettes :Amélioration de l’efficacité de l’IAQu’est-ce que Complexity AI ?
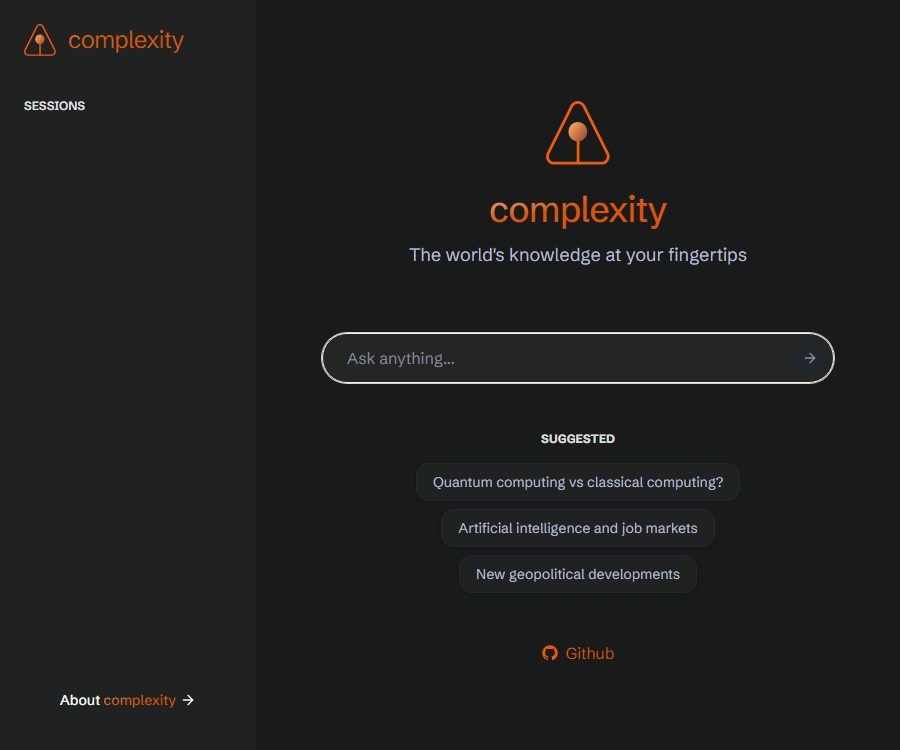
Complexity AI est un moteur de recherche web basé sur l’IA, créé par Emil Ahlbäck et Hamed Mohammadpour. Son objectif est de répondre aux questions en langage naturel et de présenter des contenus de pages web pertinents. Il s’appuie sur les capacités de conversation de Cohere ainsi que sur un connecteur de recherche de pages web, et sa fonctionnalité est similaire à celle d’un outil simplifié de questions-réponses en ligne.
Cette entrée correspond au site de recherche Complexity AI et à son dépôt de code équipe FOLLGAD, et non à l’extension navigateur améliorée Perplexity du même nom. Les développeurs, adresses web, fonctionnalités et statuts de licence des deux sont différents.
Fonction principale
Questions-réponses en ligne
- L’utilisateur saisit une question en texte sur la page web ; le système effectue d’abord une recherche sur la page, puis le modèle génère une réponse concise en langue naturelle.
- Les réponses s’affichent progressivement de manière fluide, ce qui permet de comprendre rapidement des concepts, de comparer des sujets ou de suivre des informations générales.
- Par défaut, le code ouvert est configuré pour les modèles de la série Cohere Command R, mais les modèles utilisés en déploiement réel peuvent être ajustés via des variables d’environnement du serveur.
Recherche de documents et de citations de paragraphes
- La recherche de connecteurs renvoie des documents pertinents ; la page de résultats affiche les titres sous forme de cartes de documents trouvés, et le texte des réponses indique l’intervalle de citation.
- L’utilisateur peut consulter le document correspondant à un segment de texte, afin de déterminer si la réponse est étayée par les matériaux de recherche.
- Citer une source ne signifie pas que la conclusion est nécessairement correcte ; il reste nécessaire de vérifier la date, le contexte et l’autorité de la page originale.
Questions de suivi et suggestions continues
- Il est possible de continuer à poser des questions dans la même session ; le serveur fournira au modèle les questions-réponses existantes en tant qu’historique de conversation.
- À la fin de chaque tour, le système peut générer automatiquement jusqu’à trois questions courtes supplémentaires en fonction de la session en cours.
- Les sessions longues peuvent omettre des détails précoces en raison d’un troncement du contexte du modèle ; les conditions clés doivent être réexpliquées lors de questions supplémentaires.
Enregistrement et partage de sessions
- Le navigateur enregistre localement la liste des sessions pour faciliter le retour aux questions et réponses précédentes.
- Le code du serveur écrit en même temps le problème, la réponse, l’identifiant de l’utilisateur, les références et les informations du document dans la base de données, afin de permettre le chargement historique et le partage en lecture seule.
- La fonction de partage générera une page de session en lecture seule ; avant d’envoyer, il convient de vérifier si le dialogue contient des informations personnelles, relatives à des clients ou internes.
Retour d’information et analyse d’utilisation
- La page de résultats propose des options pour approuver, désapprouver et fournir des commentaires textuels, afin d’aider les développeurs à évaluer la qualité des réponses et les besoins fonctionnels.
- Intégration du code ouvert PostHog, et enregistrement d’événements tels que les visites de pages, les questions, les réponses, les clics, les retours et les identifiants d’utilisateurs générés anonymement.
- Le site ne divulgue pas de procédures complètes pour la conservation et la suppression des données, et il n’est pas conseillé de se fier uniquement à des identifiants anonymes pour garantir la confidentialité des requêtes sensibles.
Entrée et sortie
| Projet | Contenu pris en charge | Forme du résultat | Restrictions |
|---|---|---|---|
| Entrée | Problèmes de texte en langue naturelle et questions successives | Soumission au processus de questions-réponses sur le site web | Aucune fonction de téléchargement de documents, d’images ou d’audio non visible. |
| Recherche | Le modèle appelle le connecteur de recherche sur le web pour obtenir un document. | Recherche des cartes de documents et mappage des citations | La portée et la date de mise à jour ne sont pas publiques. |
| Réponse | Générer du contenu en combinant des questions, de l’histoire et des matériaux de recherche | Texte Markdown en flux | Il peut y avoir des omissions, des informations obsolètes ou des conclusions erronées. |
| Opérations suivantes | Questions supplémentaires, copier et partager, retour qualité | Séances continues et pages lues seulement | Les données de session peuvent être stockées localement et sur le serveur. |
Mode d'utilisation
- Ouvrez la page du produit et indiquez le problème spécifique dans le champ de saisie, en incluant autant que possible le sujet, la période et le format de résultat souhaité.
- Attendez que le système termine la recherche de pages web et la génération de réponses en flux ; consultez d’abord les fiches des documents trouvés, puis vérifiez les références correspondant aux affirmations clés.
- Utiliser des questions de conseil ou poser des questions supplémentaires pour préciser les conditions ; le cas échéant, demander une comparaison des différents points de vue ou un rétrécissement de la période.
- Vérifiez les sources originales pour les faits importants, et ne considérez pas les résultats obtenus comme des conclusions médicales, juridiques, financières ou autres de nature professionnelle.
- Lorsqu’une collaboration est nécessaire, on peut partager une session en lecture seule, mais il convient d’abord de supprimer les contenus sensibles et de comprendre que la personne qui reçoit le lien pourra voir l’intégralité de la conversation.
Adapté aux utilisateurs et aux scénarios
- Recherche d’informations générales : obtenir rapidement un aperçu du sujet en langage naturel, puis continuer la lecture à partir des documents cités.
- Point de départ pour l’apprentissage et la recherche : poser des questions successives autour d’un concept, organiser les termes, les différences et les directions de recherche ultérieures.
- Préparation du sujet : rechercher des pistes sur des pages web publiques et des opinions courantes, mais une vérification indépendante des faits reste nécessaire avant la publication.
- Apprentissage pour les développeurs : lire les méthodes de mise en œuvre de Next.js, Cohere, la recherche sur le web, la réponse en flux et l’affichage des références.
Services de gestion et déploiement autonome
La page du produit ne mentionne pas de abonnements publics, de points, de quotas ou de solutions professionnelles, et ne promet pas non plus une gratuité permanente. La page web offre actuellement une possibilité de poser des questions directement, mais le nombre d’utilisations autorisées, les restrictions de concurrence et les modalités de facturation futures ne sont pas encore divulgués.
| Forfait ou version | Prix | Période de facturation | Droits ou crédit principal | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Page de hébergement officielle | Pas encore rendu public | Pas encore rendu public | Poser des questions sur le site, rechercher des réponses, citer et maintenir une session continue ; la limite n’est pas divulguée | Utilisateurs souhaitant une expérience directe |
| Déploiement autonome du code source | Le prix du logiciel n’a pas encore été divulgué. | Assumer soi-même les coûts de service | Il faut configurer Cohere, la base de données, les services d’analyse et l’environnement de déploiement. | Équipe dotée de capacités de développement et de maintenance |
Le déploiement autonome peut également entraîner des frais liés aux appels de modèles, aux recherches sur le web, aux bases de données, ainsi qu’aux services d’hébergement et d’analyse. Comme le dépôt ne dispose pas de licence, il convient d’obtenir au préalable l’autorisation appropriée des détenteurs des droits d’auteur avant de procéder au déploiement, aux modifications ou à une utilisation commerciale.
Plateforme, API et statut open source
- Le produit est proposé sous forme de page web responsive ; aucune application mobile officielle, client desktop ou extension de navigateur n’a été trouvée.
- L’entrepôt a rendu publiques les implémentations des interfaces internes telles que les questions-réponses et les suggestions, mais n’a pas fourni d’API stable, de SDK, de solutions d’authentification ou d’engagements de niveau de service destinés à des tiers.
- Le dépôt de code permet de consulter et de cloner la structure technique, mais il ne contient pas de fichiers de licence ; le fait que le code source soit public ne signifie pas qu’une autorisation de copie, de modification, de distribution ou d’utilisation commerciale est accordée.
- Le dépôt n’est pas archivé, mais la dernière mise à jour du code remonte à décembre 2024 ; le rythme actuel de maintenance ainsi que les prochaines étapes restent pour l’instant indéterminés.
Considérations sur la vie privée, la sécurité et les droits d’auteur
- Une implémentation publique stockera l’identifiant de l’utilisateur localement dans le navigateur et conservera une copie de la session sur place.
- Les questions, les réponses, les citations et les documents pertinents seront enregistrés dans la base de données du serveur ; la composante d’analyse peut également recevoir des événements de consultation de page, de pose de questions, de réponses et de retours.
- Le produit ne dispose d’aucune politique de confidentialité indépendante et publique, d’aucune durée de conservation, d’aucun processus pour demander la suppression des données, d’aucunes conditions de service ni de directives de sécurité ; il n’est donc pas adapté à l’envoi de données confidentielles, réglementées ou permettant l’identification de personnes.
- Les résultats de recherche sur le web et les réponses du modèle peuvent contenir des contenus protégés par des droits d’auteur tiers ; la citation n’accorde pas automatiquement le droit de reproduction ou d’utilisation à des fins commerciales.
- Il n’existe pas de règles de remboursement ni de contrat de paiement publics ; si un système de règlement apparaît à l’avenir, il conviendra de vérifier les prix, les renouvellements, les conditions d’annulation et de remboursement avant de payer.
Limites des capacités
- Il s’agit d’un outil léger de questions-réponses en ligne, qui n’est pas une base de données professionnelle vérifiée, et ne dispose pas non plus d’une portée de recherche publique.
- Le modèle peut interpréter incorrectement les pages web, confondre les dates ou générer des affirmations sans fondement suffisant ; les citations peuvent également ne soutenir qu’une partie de la phrase.
- Il n’est pas possible de confirmer si le déploiement actuel est parfaitement identique à celui du répertoire public ; la stabilité des modèles, du traitement des données et des services peut varier en fonction des paramètres d’environnement.
- L’interface est principalement en anglais ; la qualité des saisies et des réponses dans d’autres langues n’est pas garantie.
Questions fréquentes
Que peut faire Complexity AI ?
Il reçoit des questions textuelles, recherche sur le web et génère en continu des réponses avec des cartes de documents trouvés et des citations de paragraphes, tout en permettant de poser d’autres questions dans la même session.
Est-ce le produit officiel de Perplexity ?
Non. Cette entrée correspond à un projet de recherche indépendant intitulé Complexity AI et ne doit pas être confondu avec Perplexity ou l’extension de navigateur du même nom.
Complexity AI est-il gratuit ?
La page web actuelle offre une possibilité de poser des questions directement, mais ne mentionne pas d’engagement gratuit à long terme, de limite de nombre de questions ou de plan de paiement ; par conséquent, elle ne peut être qualifiée de service gratuit permanent.
Complexity AI est-il un logiciel open source ?
Le dépôt officiel a rendu le code source public, mais n’a pas indiqué de licence. Les utilisateurs peuvent lire le code, sans pour autant pouvoir en déduire qu’ils ont obtenu l’autorisation de le modifier, de le distribuer ou de l’utiliser à des fins commerciales.
Une API ou un SDK est-il fourni ?
Le code du projet contient une interface de questions-réponses interne et utilise le SDK Cohere, mais aucune API stable ni SDK officiel n’a été publié pour être appelé par des tiers.
Peut-on saisir des informations sensibles ?
Ce n’est pas recommandé. Une implémentation publique traiterait les sessions localement et sur le serveur, ainsi que l’analyse de l’utilisation, tandis que le site n’a pas encore rendu publiques ses politiques complètes de conservation des données, de suppression et de sécurité.
Outils similaires à Complexity AI



 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164