




LiteLLM
LiteLLM : améliore l’efficacité de l’IA pour rendre le travail plus efficace et plus simple
Étiquettes :Amélioration de l’efficacité de l’IAQu’est-ce que LiteLLM ?
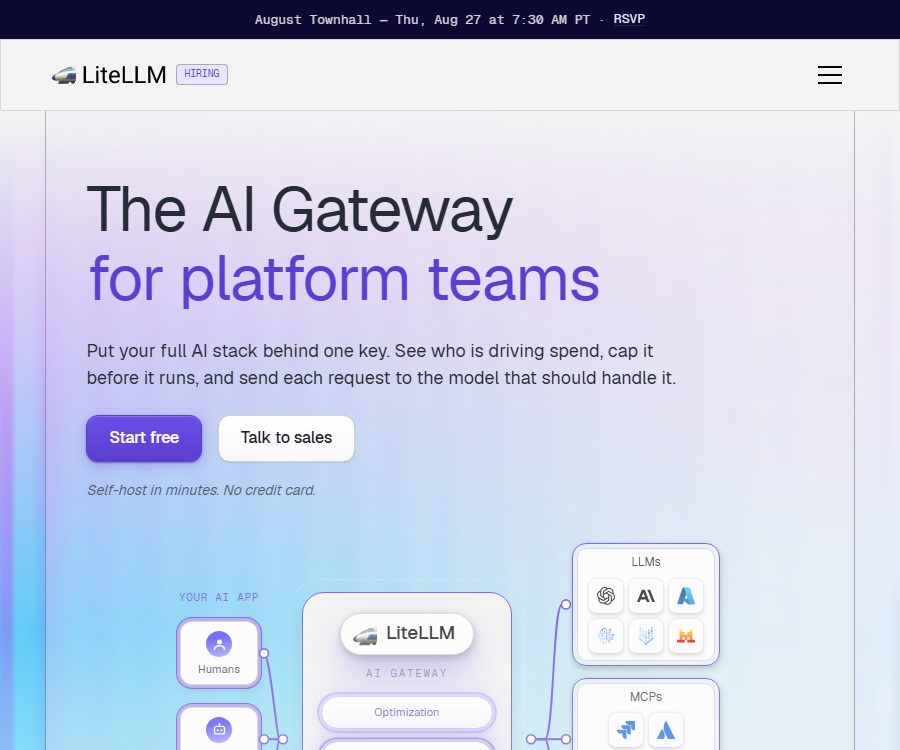
LiteLLM est un gateway IA open source et un SDK Python qui permet d’unifier différents services de modèles tels que OpenAI, Anthropic, Gemini, Azure, Amazon Bedrock, Vertex AI, Ollama, etc., sous une méthode d’appel similaire. Les applications peuvent changer de modèle en utilisant des interfaces compatibles avec OpenAI, ce qui réduit le travail nécessaire pour maintenir des codes adaptés pour chaque fournisseur.
Le projet est maintenu par Berri AI et peut être utilisé directement par les développeurs dans leurs projets Python, ou déployé en tant que serveur proxy partagé au sein d’une équipe. Il ne s’agit pas d’un grand modèle de langage, et aucun quota de traitement des modèles n’est fourni ; les réponses réelles sont toujours générées par les modèles cloud ou locaux configurés par l’utilisateur.
Deux principales manières d'utilisation
| Méthode | Public cible | Capacités principales | Scénario typique |
|---|---|---|---|
| Python SDK | Développeur d’applications | Appel unifié, mappage des exceptions, routage, tentative de réessai, fallback et rappel | Intégrer plusieurs modèles dans un projet Python unique |
| AI Gateway | Équipe plateformes et infrastructures | Authentification centralisée, clés virtuelles, budget, journalisation, panneau de gestion et contrôle multi-locataires | Fournir une entrée de modèle unifiée pour plusieurs applications, utilisateurs ou équipes |
Le SDK est plus proche d’un ensemble de codes, tandis que le gateway est un service central qui fonctionne de manière indépendante. Les petits projets peuvent commencer par utiliser un SDK, puis déployer un gateway lorsque des contrôles d’accès unifiés, des frais et une auditabilité deviennent nécessaires.
Fonction principale
API du grand modèle unifié
LiteLLM mappe plusieurs fournisseurs de modèles sur une interface unifiée, couvrant différents points d’entrée tels que la messagerie, les réponses, l’incorporation, les images, l’audio, le traitement par lots, le réordonnancement et les messages. Les différents modèles ne prennent pas nécessairement en charge toutes ces fonctionnalités ; il est donc nécessaire de consulter le tableau de compatibilité des points d’entrée du fournisseur concerné avant de les intégrer.
- Appeler plusieurs modèles en utilisant un format compatible OpenAI
- Connecter les API commerciales, les modèles de plateformes cloud et certains services d’inférence locale
- Unifier les types d’exceptions courantes et les structures de réponse
- Définir des alias pour le modèle afin de réduire le lien entre le code métier et les modèles spécifiques.
- Réduire les coûts de migration lors de l’ajout de nouveaux modèles ou fournisseurs
Routeur intelligent et récupération en cas de panne
Le routeur peut distribuer les requêtes entre plusieurs modèles ou déploiements, et configurer des stratégies de tentative répétée, de délai d’expiration et de fallback. Lorsqu’un point de terminaison est limité en ressources ou défaillant, le système peut essayer d’utiliser d’autres déploiements, à condition que l’équipe ait correctement configuré des modèles de secours et des paramètres compatibles.
- Déploiement multiple du load balancing
- Concevoir des itinéraires en fonction du coût, des délais ou de la disponibilité
- Gestion du throttling et des erreurs de service temporaire
- Appeler le modèle de secours en cas d’échec du modèle principal
- Réduire certaines appels répétitifs grâce au cache
Clé virtuelle et contrôle d’accès
Le gateway peut délivrer des clés virtuelles aux applications, projets, utilisateurs ou équipes, sans avoir à distribuer directement les clés des modèles en amont. L’administrateur peut limiter les modèles disponibles, le budget, le taux de demande et la durée de validité, ainsi que faire des statistiques des dépenses par entité.
La clé virtuelle ne constitue qu’un niveau de gouvernance ; il reste nécessaire de protéger la clé principale, la base de données et l’interface de gestion. Les environnements de production ne doivent pas utiliser de clés d’exemple, et les interfaces de gestion ne doivent pas être exposées directement à Internet.
Suivi des coûts et gestion budgétaire
LiteLLM estime les coûts en fonction de la correspondance entre le prix du modèle et le volume des requêtes, et peut les regrouper par clé, utilisateur, équipe, projet ou étiquette. Les équipes peuvent définir des budgets et des limites de vitesse afin de réduire les factures inattendues causées par des scripts de test ou un trafic anormal.
- Suivre le nombre de requêtes, le nombre de tokens et l’estimation des coûts
- Définir le budget d’un utilisateur, d’une équipe ou d’un projet
- Limiter le nombre de requêtes et de tokens par minute
- Observer la distribution des coûts par modèle ou étiquette
- Intégration au système de surveillance via Prometheus et autres moyens
Journalisation, observabilité et Guardrails
Le gateway prend en charge les journaux de requêtes et de réponses, les appels de retour, les indicateurs ainsi que diverses intégrations d’observabilité ; il peut également se connecter aux mécanismes de sécurité du contenu et à Guardrails. La décision de consigner ou non les prompts et les réponses est déterminée par la configuration, et une stratégie de minimisation des journaux doit être privilégiée lors du traitement de données sensibles.
MCP et passerelle d’agent intelligent
Le projet actuel comprend également des fonctionnalités de gateway MCP et de gateway d’agent A2A, qui permettent de placer les outils MCP ou les agents compatibles derrière une entrée unique. L’administrateur doit néanmoins gérer séparément l’autorisation des outils, l’accès réseau, les politiques de validation et la portée des identifiants.
Modèles et services pris en charge
Selon la description officielle actuelle, plus de 100 fournisseurs de modèles sont pris en charge, un nombre qui peut varier selon les versions. Parmi les options les plus courantes figurent OpenAI, Anthropic, Google Gemini, Azure OpenAI, Amazon Bedrock, Vertex AI, Cohere, Mistral, DeepSeek, xAI, Ollama et vLLM, etc.
| Catégorie | Exemple | Utiliser les rappels |
|---|---|---|
| Modèle commercial API | OpenAI, Anthropic, Gemini, Mistral, xAI | Il faut des clés distinctes et payer au prix du fournisseur |
| Modèle de plateforme cloud | Azure, Bedrock, Vertex AI | Relatif aux comptes cloud, régions, permissions et configuration réseau |
| Inference locale ou auto-hébergée | Ollama, vLLM, LM Studio | Il est nécessaire de préparer soi-même le modèle, les ressources de calcul et les points de terminaison serveur. |
| Services multimodaux | Fournisseurs d’images, d’audio, d’incrustations et de réordonnancement | Le degré de prise en charge des points d’extrémité varie selon le fournisseur. |
Prix et versions
Les informations ci-dessous ont été vérifiées le 24 août 2026. LiteLLM adopte un modèle basé sur un noyau open source gratuit accompagné de fonctionnalités professionnelles payantes ; les frais pour les entreprises ne sont pas calculés en fonction des tokens du modèle, mais sont établis en fonction de la capacité annuelle de requêtes via le gateway, de l’architecture de déploiement et des besoins en support.
| Version | Licence ou prix | Capacités principales | Public cible |
|---|---|---|---|
| Open Source | Aucun frais de licence, hébergement gratuit permanent | API unifiée, clés virtuelles, utilisateurs et équipes, suivi des coûts, budget, limitations de vitesse, mécanismes de fallback, journaux et indicateurs Prometheus | Développeurs et équipes capables de se déployer et de maintenir eux-mêmes |
| Enterprise | Contrat annuel, contacter le service des ventes pour une demande de prix | Fonctionnalités de la version open source avec SSO, SCIM, OIDC ou JWT, journaux d’audit, rotation des clés, permissions organisationnelles, contrôle multi-région et support entreprise | Organisations à grande échelle, réglementées ou nécessitant des accords de niveau de service |
| Essai Enterprise | 30 jours, sans carte de crédit | Utilisé pour tester les fonctionnalités de licence d’entreprise | Équipe chargée de valider les exigences en matière de sécurité et de gouvernance avant l’achat |
La version entreprise standard comprend des canaux de communication dédiés ; le niveau de service de support 24h/24 mentionné dans la documentation officielle peut nécessiter des frais supplémentaires. Les prix réels, les capacités demandées, les réseaux isolés, le déploiement multi-régional et les niveaux de réponse sont déterminés par le contrat.
Quels sont encore les coûts de la version gratuite
- Frais d’appel des modèles upstream tels que OpenAI, Anthropic, Gemini, etc.
- Coût des serveurs cloud, des conteneurs ou du matériel local
- PostgreSQL, Redis et stockage d’objets nécessaires à l’environnement de production
- Frais de journalisation, de surveillance, de sauvegarde, de trafic réseau et de services de sécurité
- Coûts de main-d’œuvre pour le déploiement, la mise à niveau, la gestion des pannes et les audits de conformité
Par conséquent, « auto-hébergement gratuit » signifie simplement que le noyau open source n’est pas soumis à des frais de licence, mais cela ne veut pas dire que le fonctionnement du gateway et l’inférence des modèles sont gratuits. Avant d’acheter ou de déployer, il convient de prendre en compte la consommation des modèles, l’infrastructure ainsi que les opérations de maintenance dans le coût total.
Mode de déploiement
- Intégrer directement le SDK ou lancer un service proxy à l’aide d’un paquet Python
- Exécuter AI Gateway et l’interface de gestion via des images de conteneurs officielles
- Utiliser Docker Compose pour créer des environnements de test ou de petite taille
- Déploiement dans un cluster Kubernetes via Helm
- Déploiement sur AWS ou Google Cloud à l’aide des modules officiels Terraform
- L’édition entreprise peut fonctionner sur des infrastructures propres et prend en charge des solutions de réseau isolé.
Un environnement de production nécessite généralement également une base de données, un cache, un proxy inversé, TLS, une gestion des secrets, ainsi que du monitoring et des sauvegardes. Bien que les recommandations officielles préconisent l’utilisation d’étiquettes stables pour les images de production, les équipes doivent tout de même fixer une version claire afin d’éviter des changements de comportement dus à des mises à jour non planifiées.
Processus d'utilisation rapide
- Décider clairement si l’on utilise le SDK Python ou un gateway AI centralisé, et énumérer les fournisseurs de modèles à intégrer.
- Préparez les comptes, les clés API, les régions et les quotas pour les services de chaque modèle ; ne mettez pas les clés dans le code source.
- Installez LiteLLM dans l’environnement de test ou lancez le conteneur officiel, et configurez les alias du modèle ainsi que les endpoints upstream.
- Créer une clé principale et des clés virtuelles, définir des listes blanches de modèles, des budgets et des limites de vitesse pour les applications, les équipes ou les projets.
- Faire en sorte que l’application utilise l’adresse du gateway et une méthode d’appel compatible avec OpenAI, afin de valider la sortie en flux, les appels d’outils et le traitement des erreurs.
- Configurer les délais d’attente, les tentatives de réessai, le retrait en arrière, le masquage des journaux, les indicateurs, les alertes et les sauvegardes de la base de données.
- Effectuer des tests de concurrence, de défaillance et de coûts, puis publier une version stable fixe dans l’environnement de production.
À qui s’adresse-t-il
- Développeurs d’applications IA qui doivent appeler simultanément plusieurs grands modèles
- Équipe plateforme souhaitant une gestion unifiée des clés de modèle et des frais
- Les entreprises qui doivent allouer des budgets et des droits de modèle à plusieurs départements
- Système de production nécessitant un fallback de modèle et un équilibrage de charge
- Les organisations qui souhaitent conserver le gateway de modèle dans leur propre réseau
- Équipes qui doivent passer d’un modèle cloud à un modèle local
Avantages du produit
- Large compatibilité avec une grande variété de modèles et de fournisseurs de services, réduction des adaptations redondantes
- Deux niveaux d’utilisation : SDK et passerelle centralisée
- Le noyau open source peut être examiné, modifié et déployé par soi-même.
- Les clés virtuelles, les budgets et les limitations de débit conviennent à la gouvernance multi-locataires
- Capacités de routage, de réessai, de fallback, de mise en cache et d’observabilité
- Soutien aux conteneurs, Kubernetes et aux infrastructures cloud majeures
Restrictions et risques
Une interface compatible ne signifie pas une identité totale.
Les différents modèles présentent encore des différences en termes d’appels d’outils, de sortie structurée, d’images, d’audio, de longueur du contexte et de comportement en cas d’erreur. Avant de changer de modèle, il est nécessaire de réaliser des tests avec des exemples réels, et non de se contenter de valider une simple demande de chat.
L’estimation des prix nécessite une maintenance.
Le suivi des coûts dépend des prix des modèles et des informations de calcul des tokens ; des écarts peuvent survenir en cas de modification des prix par les fournisseurs ou du lancement de nouveaux modèles. Les règlements financiers doivent se baser sur les factures provenant des fournisseurs, tandis que les statistiques de LiteLLM sont plus adaptées au suivi opérationnel.
Le gateway deviendra une infrastructure clé.
Une fois tous les flux de modèles centralisés, une configuration incorrecte, une panne de base de données ou une mise à jour de version peuvent affecter plusieurs applications. Un environnement de production doit disposer d’une haute disponibilité, d’une planification de la capacité, de vérifications de santé, de fonctionnalités de rollback et de reprise après sinistre.
Le logiciel open source n’est pas automatiquement sécurisé.
L’administrateur doit configurer lui-même l’authentification, l’isolement réseau, TLS, le renouvellement des clés et la masquage des journaux. Si les journaux de requêtes et de réponses sont activés, les prompts et les réponses du modèle peuvent être stockés dans une base de données ou un système d’observabilité tiers.
Données et vie privée
L’hébergement auto géré signifie que les fournisseurs de LiteLLM ne sont généralement pas responsables de l’hébergement du trafic du gateway et des clés des utilisateurs, mais les requêtes de modèles sont néanmoins envoyées aux services de modèles en amont configurés. Les journaux, le cache, Guardrails et les plugins d’observabilité peuvent également accéder aux entrées et aux sorties.
- Ne conserver la clé du modèle que dans un système de gestion des secrets
- Émettre des clés virtuelles indépendantes pour différentes applications
- Désactiver les prompts inutiles et le journal du corps de la réponse
- Masquer les informations personnelles, les secrets commerciaux et les identifiants
- Vérifier les politiques de conservation des données de chaque service de modélisation et de surveillance
- Mettre à jour régulièrement les correctifs de sécurité et vérifier la signature des images de conteneur
Explication des licences open source
Dans le dépôt LiteLLM, tous les répertoires ne sont pas soumis à la même licence. Selon la licence principale, le contenu du répertoire enterprise suit sa propre licence d’entreprise, tandis que le reste du code non restreint est soumis à la licence MIT.
| Portée du code | Statut de la licence | Conseils d'utilisation |
|---|---|---|
| Noyau open source et annuaires non commerciaux | Licence MIT | Peut être utilisé, modifié et distribué sous réserve de conserver les droits d’auteur et la déclaration de licence. |
| répertoire enterprise | Licence séparée pour le répertoire d’entreprises | On ne peut pas supposer que tout le code d’entreprise puisse être utilisé librement à des fins commerciales, simplement parce que l’infrastructure du entrepôt est open source. |
| Modèles externes et SDK | Chaque clause | Les poids du modèle, les API et les dépendances tierces ne héritent pas automatiquement de la licence LiteLLM |
Versions et recommandations de maintenance
LiteLLM est mis à jour fréquemment ; la stratégie de version officielle prend en charge les quatre dernières versions stables, tandis que les anciennes versions verront leurs mises à jour progressivement interrompues. Les systèmes en production doivent retenir une version stable spécifique et tester d’abord dans un environnement préparatoire avant de procéder à la mise à niveau.
- Enregistrer la version exacte de l’image ou du paquet actuel
- Lire les historiques de modifications et suivre les annonces de sécurité
- Préparer des sauvegardes et un retrait pour les modifications de la structure de la base de données
- Tester le modèle central, les appels d’outils, les réponses en flux et les chemins de fallback
- Planifier une mise à niveau avant la fermeture de la fenêtre de prise en charge de la version
Questions fréquentes
LiteLLM est-il gratuit ?
La licence pour la version auto-hébergée open source est de 0 dollar. Les API des modèles, les serveurs, les bases de données, la surveillance et l’exploitation continuent d’engendrer des coûts, tandis que les fonctionnalités de gouvernance d’entreprise et de support nécessitent une demande de prix.
LiteLLM propose-t-il des quotas de modèles ?
Non fourni. L’utilisateur doit configurer son propre compte de fournisseur de modèles, ses clés et ses quotas, ou se connecter à un service de modèles déployé par lui-même.
LiteLLM est-il identique à OpenRouter ?
Ce n’est pas tout à fait identique. LiteLLM est principalement un gateway et un SDK auto-hébergés, qui ne vend pas lui-même de quotas de modèles de manière unifiée ; OpenRouter, quant à lui, est un service d’agrégation de modèles hébergé.
Peut-on le déployer en mode privé ?
Oui. La version open source peut fonctionner sur sa propre infrastructure, tandis que la version entreprise est également auto-hébergée et offre, selon le contrat, des capacités de gouvernance, de support et d’isolation réseau plus avancées.
Est-ce que le modèle chinois est pris en charge ?
Certains fournisseurs de modèles en chinois et internationaux sont pris en charge, mais les modèles spécifiques, les régions et les capacités des points d’extrémité peuvent varier. Avant de vous connecter, veuillez consulter la liste actuelle des fournisseurs et tester concrètement le fonctionnement en chinois.
Combien coûte l’édition entreprise ?
Le site officiel ne divulgue pas de montant fixe ; une offre est établie en fonction de la capacité demandée annuellement, de l’architecture de déploiement et des besoins en support. Une version d’essai d’entreprise de 30 jours est actuellement disponible, le prix définitif étant déterminé par le contrat de vente.
Résumé
LiteLLM convient aux équipes de développement qui ont besoin d’une interface de modèle unifiée, ainsi que de contrôles d’accès, de budgets, de routage et d’observabilité. La version open source couvre la plupart des fonctionnalités de base des passerelles, tandis que la version entreprise ajoute une gouvernance avancée des identités, un audit, le support multi-région, mais l’utilisateur reste responsable des coûts liés aux modèles, de l’infrastructure et de la maintenance de la sécurité.
Outils similaires à LiteLLM



 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164