




Laminar
Laminar, outil intelligent axé sur l’amélioration de l’efficacité de l’IA
Étiquettes :Amélioration de l’efficacité de l’IAQu’est-ce que Laminar ?
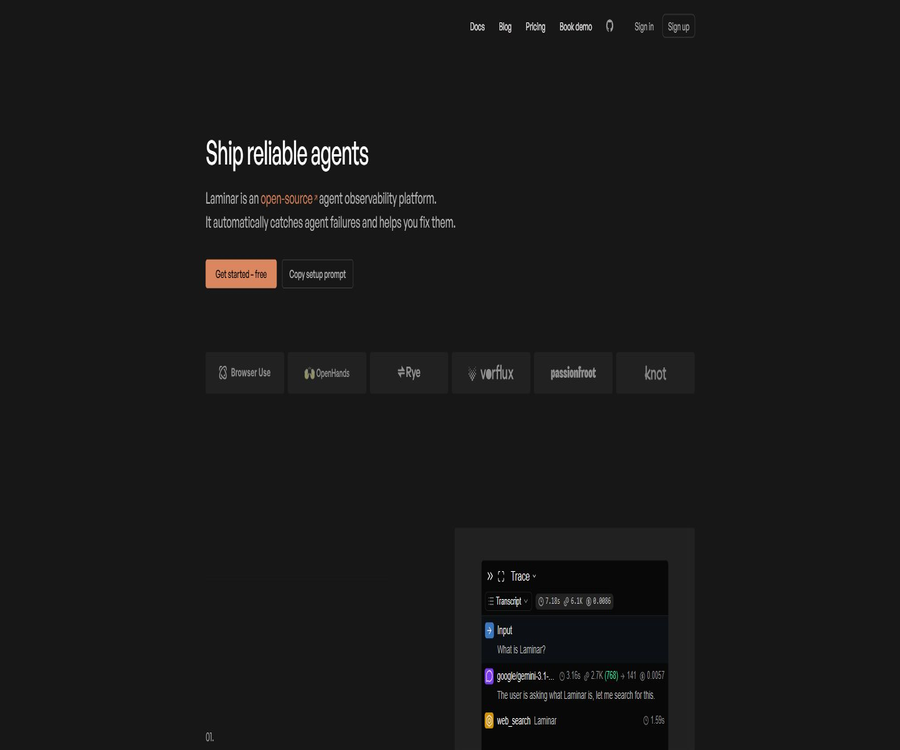
Laminar est une plateforme open source d’observation, de débogage et d’évaluation conçue spécialement pour les agents IA et les modèles de langage de grande taille. Développée par l’équipe de lmnr.ai, elle a été sélectionnée pour Y Combinator S24. Elle enregistre les appels aux modèles, l’utilisation des outils, les flux de contrôle et les activités des sous-agents, puis transforme les exécutions en production en données consultables, interrogables et évaluables.
Les utilisateurs peuvent soit utiliser Laminar Cloud géré, soit déployer une stack open source complète. Le produit est basé sur OpenTelemetry pour le suivi et offre une vue de suivi interactive plus lisible pour les agents à long terme, multi-étapes et parallèles.
Quel problème principal résout-il ?
- Voir quels modèles et outils l’agent a réellement appelés à chaque étape.
- Coûts de localisation erronée, de rappels répétés, de boucles et d’exceptions.
- Détecter automatiquement des modèles de comportement à partir du suivi de la production en masse.
- Exécuter une évaluation de régression avant de modifier les prompts, le modèle ou le code.
- Transformer des cas réels d’échec en ensemble de données d’évaluation.
- Analyser les données à l’aide de SQL, de la recherche plein texte et de tableaux de bord.
- Conserver les traçages sensibles dans le cloud ou sur une infrastructure propre.
Suivi des agents IA
Tracing enregistre les entrées et sorties du modèle pendant l’exécution de l’agent, les paramètres et résultats des outils, les appels de fonctions, les erreurs, les délais, les tokens et les coûts. Laminar affiche les trajectoires complexes des agents sous forme de transcription dialoguée, et plie les sous-agents en cartes révélables, afin de réduire la charge cognitive lorsqu’on consulte uniquement l’arbre Span.
Traçage automatique et manuel
| Méthode d’implantation des points de suivi | Mode de fonctionnement | Scénarios adaptés |
|---|---|---|
| Instrumentation automatique | Capturer les clients de frameworks et de modèles pris en charge après l’initialisation du SDK | Accès rapide aux applications proxy existantes |
| Emballage de fonction | Envelopper la fonction avec observe et enregistrer les entrées/sorties | Suivi des étapes métier et fonctions d’outil |
| Span manuel | Création explicite de hiérarchies et d’attributs supplémentaires | Flux de contrôle complexe et frameworks personnalisés |
| Importation d’OpenTelemetry | Recevoir des données de suivi OTLP standard | Systèmes observables et agents inter-services déjà disponibles |
Intégrations courantes
- Clients des modèles OpenAI, Anthropic et Gemini.
- Vercel AI SDK et OpenAI Agents SDK.
- Claude Agent SDK et OpenHands SDK.
- LangChain, Mastra et Pydantic AI.
- Agents de navigateur Browser Use, Stagehand et Playwright.
- LiteLLM et d’autres services compatibles avec OpenTelemetry.
Suivi en temps réel et recherche dans le texte intégral
La plateforme peut afficher en temps réel les Span tant que l’agent n’est pas terminé, ce qui est utile pour observer les tâches longues, les sous-agents parallèles et les opérations du navigateur. Toute la traçabilité prend en charge la recherche plein texte, le filtrage des champs et une vue tableau, permettant aux développeurs de localiser rapidement les exécutions anormales à partir du texte d’erreur, des paramètres de l’outil ou du contenu de l’utilisateur.
Rejeu de session du navigateur
Pour des proxies navigateur tels que Browser Use, Stagehand et Playwright, Laminar peut associer les opérations sur la page au suivi du proxy. Les développeurs peuvent ainsi voir pourquoi le modèle a choisi une action donnée, ainsi que consulter l’état du navigateur au moment de l’exécution.
Surveillance de la production des signaux
Signals permet aux équipes de décrire en langage naturel les résultats ou échecs à surveiller, par exemple si un agent appelle à plusieurs reprises une fonction, fabrique des données après l’échec d’une interface, ou si un utilisateur abandonne une tâche. Le système lit le suivi complet et non seulement la réponse finale, et génère des événements structurés lorsqu’une correspondance est trouvée.
Composition de Signal
| Composants | effet | Exemple de configuration |
|---|---|---|
| Prompt | Décrire le comportement à détecter ou à extraire | Exécution qui tire des conclusions sans fondement même après échec de la recherche d’outils |
| Schéma structuré | Définir les champs à extraire dans l’événement | Outils défaillants, déclarations d’erreur et impact sur les utilisateurs |
| Trigger | Décider quand analyser le suivi | Fin de la racine Span ou fin du Span spécifié |
| Filters | Restreindre la portée du suivi à analyser | Token minimal, état d’erreur ou nom de Span |
| Severity | Marquer le niveau de gravité de l’événement | Critique, Avertissement ou Info |
Processus de travail de Signals
- Le nouveau suivi satisfait aux déclencheurs et aux conditions de filtrage.
- Le système compresse les longues traces tout en conservant le modèle, les outils et la trace principale des erreurs.
- L’agent Signals examine le contenu compressé en se basant sur des règles de langage naturel.
- Lire l’ensemble du Span si nécessaire pour confirmer les entrées et sorties spécifiques.
- Transformer la découverte en événement structuré conforme au schéma.
- L’événement est rattaché à la piste originale et intégré à l’index de recherche.
- Les événements similaires sont regroupés automatiquement pour identifier des motifs répétitifs.
- Les événements conformes aux règles sont signalés via Slack ou par e-mail.
Différences entre Signals et les scores des LLM classiques
Les évaluateurs ordinaires ne vérifient souvent que le dernier segment de sortie du modèle, ce qui rend difficile la détection d’erreurs des outils survenues des dizaines d’étapes auparavant, de sous-agents invalides et de appels répétés. Signals lit l’intégralité du flux de traitement et peut relier la conclusion finale aux résultats des outils intermédiaires.
| Élément de comparaison | Note de sortie normale | Laminar Signals |
|---|---|---|
| Portée de l’analyse | Généralement, c’est la réponse finale. | Modèle complet, outils, sous-agents, tentative de réessai et suivi des erreurs |
| Expression de règle | Code ou indication de note fixe | Règles de détection du langage naturel + schéma structuré |
| Résultat | Un ou plusieurs nombres fractionnaires | Événements structurés consultables, regroupables et gérant les alertes |
| Mode de fonctionnement | Utilisé principalement pour des échantillons hors ligne | Il est possible d’analyser en temps réel les nouvelles traques, ainsi que de reprendre des données historiques. |
| Questions adaptées | Qualité et format de la réponse | Échec logique, friction utilisateur, résultats commerciaux et gaspillage de coûts |
AI Agent Debugger
Le débogueur organise une investigation d’un problème en sessions, comprenant l’exécution originale, la répétition, l’évaluation, les commandes et des notes de développement. Lorsque le développeur ou l’agent de programmation modifie le code, il peut rejouer le suivi enregistré à partir d’une position spécifiée, tandis que les appels du même modèle précédents sont renvoyés depuis le cache.
Valeur de la lecture en cache
Un agent longue durée peut présenter des problèmes seulement après avoir fonctionné pendant longtemps, et relancer complètement le processus consomme à nouveau du temps ainsi que des coûts liés au modèle. Le cache préfixe permet de ne revoir qu’une partie du code à partir du point de modification, accélérant ainsi les itérations des suggestions, des outils et des flux de contrôle.
- Exécuter le proxy en mode débogage et enregistrer un suivi complet.
- Lisez le contenu transcrit pour trouver les Span erronés ou les comportements invalides.
- Modifier les suggestions, les outils, le code ou le flux de contrôle.
- La répétition depuis la frontière à valider a été exécutée enregistrée.
- Comparer le suivi, la sortie, le délai et le coût entre l’ancien et le nouveau.
- Exécuter les évaluations sur un ensemble de données fixe prouve que la correction n’est pas fortuite.
- Enregistrer les résultats et les notes dans la même session de débogage.
- Publier les modifications après être revenu à l’accès contrôlé par régression.
Évaluation hors ligne
L’évaluation laminaire se compose de points de données, d’actuateurs, d’évaluateurs et de noms de groupes. Le système exécute en parallèle chaque entrée, enregistre les intervalles d’exécution et de notation, puis représente graphiquement les multiples exécutions au sein du même groupe afin de faciliter la détection de tendances ou de régressions après une mise à niveau du modèle.
| Section d’évaluation | Contenu | effet |
|---|---|---|
| Datapoints | Entrée, cibles optionnelles et métadonnées | Définir un échantillon de test fixe |
| Executor | Fonction pour exécuter un modèle, un agent ou un outil | Générer la sortie réelle à noter |
| Evaluators | Fonction qui retourne une valeur numérique ou un score multidimensionnel | Évaluer la précision, le format, le coût ou les conditions commerciales |
| Group | Nom associé à plusieurs exécutions liées | Comparer les versions et observer les changements des indicateurs |
| Custom Rendering | Voir la vue de ligne d’évaluation personnalisée pour les types de données | Améliorer l’efficacité de la vérification manuelle et de la comparaison des différences |
Ensembles de données et annotations
L’équipe peut créer des ensembles de données d’évaluation à partir du suivi de la production, de requêtes SQL, d’interfaces ou de données locales, puis compléter ces données par des étiquettes manuelles via une file d’étiquetage. En intégrant les échecs réels et les cas limites dans l’ensemble de données, on peut rendre les tests de régression plus proches des problèmes en environnement en ligne.
- Convertir en masse les résultats de recherche en ensemble de données.
- Créer des échantillons d’évaluation à partir du suivi d’une seule anomalie.
- Enregistrer la réponse cible et les métadonnées pour les points de données.
- Attribuer les tâches de révision manuelle à l’aide d’une file d’attente de marquage.
- Exécuter les tests dans des scripts locaux ou des processus d’intégration continue.
- Comparer les tendances des scores de plusieurs versions au sein du même groupe.
Playground
Playground permet de rejouer les Span déjà suivis et de comparer les résultats côte à côte après remplacement des prompts, du modèle ou des entrées. Il convient pour valider rapidement un ajustement local, mais une évaluation couvrant davantage d’échantillons doit être utilisée pour une publication officielle.
SQL, MCP et tableaux de bord
Laminar permet d’interroger directement les traces, les métriques et les événements Signal à l’aide de son éditeur SQL intégré, et il est également possible de créer des ensembles de données ou des tableaux de bord à partir des résultats des requêtes. L’accès via la CLI et le MCP permet aux agents programmés de lire les données observables, d’exécuter des analyses et de participer aux cycles de débogage.
| Entrée d’analyse | Capacité | Adéquat pour les utilisateurs |
|---|---|---|
| SQL Editor | Suivi des requêtes, Span, métriques et événements | Ingénieurs en données et développeurs avancés |
| Dashboards | Créer des graphiques à l’aide d’indicateurs et de SQL personnalisé | Produits, plateformes et équipes d’opération et de maintenance |
| Full-text Search | Recherche de l’entrée, de la sortie et des erreurs de Span | Dépannage et support client |
| CLI | Exécuter des évaluations, gérer les données et déboguer des sessions | Développeurs et processus d’intégration continue |
| MCP | Permettre à l’application client IA de consulter et d’analyser les données Laminar | Recherche sur les agents de programmation et l’automatisation |
SDK Python et TypeScript
Des clients Python et TypeScript sont fournis officiellement, permettant d’initialiser les clés de projet, d’automatiser l’instrumentation des modèles et frameworks pris en charge, ainsi que d’envelopper la logique personnalisée à l’aide de décorateurs ou de fonctions. Le package Python exige une version Python actuellement prise en charge, et les dépendances ainsi que l’étendue de l’instrumentation doivent être confirmées via les instructions de mise à jour avant toute mise à niveau.
- Créer des espaces de travail, des projets et des clés API de projet.
- Installer le SDK Python ou TypeScript ainsi que les intégrations nécessaires.
- Initialiser Laminar lors de la phase de démarrage de l’application.
- Ajouter l’emballage observe aux fonctions métier clés.
- Exécutez la requête locale et vérifiez le niveau de suivi ainsi que le contenu.
- Ajouter des métadonnées d’utilisateurs, de sessions, d’étiquettes et de versions.
- Configurer l’échantillonnage et le traitement des données sensibles avant la production.
- Créer des tableaux de bord, Signals et des contrôles d’accès.
Prix en cloud
Les informations sur les prix ont été vérifiées le 23 août 2026 ; les montants réels, les taxes, les taux de change et les remises peuvent varier. Les données finales seront celles affichées sur la page de paiement.
Laminar Cloud facture en fonction du forfait de base, de la quantité de données suivies par mois, des tokens d’analyse Signals et de la durée de conservation. Free ne dispose pas de capacité supplémentaire pour les données, tandis que Starter et Pro permettent de continuer à payer par GB au-delà de la quantité incluse.
| Forfait ou version | Prix | Période de facturation | Droits ou crédit principal | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Free | 0 dollar | Chaque mois | 1 Go de données, 5 dollars pour les signaux, conservation sur 7 jours, 1 projet et 1 place, sans dépassement | Développeurs individuels et petits prototypes |
| Starter | 30 dollars | Chaque mois | 3 Go de données, forfait Signals à 15 dollars, conservation sur 30 jours, projets et places illimités, majoration de 2 dollars par Go en cas de dépassement | Petites équipes et applications de production précoce |
| Pro | 150 dollars | Chaque mois | 10 GB de données, crédit Signals de 50 dollars, conservation sur 6 mois, projets et places illimités, majoration de 1,5 dollar par GB au-delà | Équipe de production multidépartementale |
| Enterprise | Cotation sur mesure | Dispositions contractuelles | Limites personnalisées et réservations, déploiement local, support dédié et fonctionnalités de sécurité d’entreprise | Organisations à grande échelle, conformité et déploiement privé |
Facturation Signals
Signals ne facture pas un pour un en fonction des tokens originaux de l’agent, mais en fonction du nombre de tokens réellement consommés par l’agent d’analyse interne lors de la lecture du suivi. Le système compresse d’abord le suivi ; selon les estimations officielles, il est possible de le compresser en moyenne à environ 10 % de la quantité de tokens initiale, mais le taux réel dépend de la sortie de l’outil et de la structure du suivi.
| forfait | Inclut le quota Signals | Prix d’entrée en excès | Prix de sortie excédentaire |
|---|---|---|---|
| Free | 5 dollars | Pas de prise en charge du dépassement | Pas de prise en charge du dépassement |
| Starter | 15 dollars | 0,5 dollar par million de tokens | 3 dollars par million de tokens |
| Pro | 50 dollars | 0,4 dollar par million de tokens | 2,5 dollars par million de tokens |
| Enterprise | sur mesure | sur mesure | sur mesure |
Points à considérer pour l’estimation des coûts
- Il n’existe pas de relation de conversion fixe entre les données de suivi GB et la quantité de tokens d’agent.
- En enregistrant la sortie complète de l’outil, la quantité de données augmente considérablement.
- La plage de filtrage des signaux détermine le nombre de traçages à analyser.
- Le suivi de l’historique de remblaiement consomme de manière importante les crédits Signals.
- Une durée de conservation prolongée peut nécessiter un forfait plus élevé ou un stockage auto-hébergé.
- Les frais de raisonnement du modèle ne sont pas inclus dans l’abonnement Laminar.
- Le self-hosting nécessite toujours de prendre en compte les coûts de la base de données, du stockage d’objets et de l’exploitation.
Logiciels libres et licences
Les entrepôts Laminar Core, le SDK Python et le SDK TypeScript sont soumis à la licence Apache 2.0, permettant de les consulter, de les modifier et de les déployer soi-même. Les services cloud commerciaux, les images d’entreprise, les fonctionnalités de licence et le support exclusif restent soumis à des conditions commerciales distinctes.
| Projet | État | Licence ou conditions | Utilisation principale |
|---|---|---|---|
| Entrepôt principal lmnr | Public et entretenu de manière continue | Apache version 2 | Front-end, services d’application, moteur de recherche et déploiement local |
| Python SDK | Public | Apache version 2 | Suivi et évaluation des applications Python |
| TypeScript SDK | Public | Apache version 2 | Suivi des applications Node et TypeScript |
| Répertoire de déploiement Helm | Public | Exécuter selon les documents du entrepôt | Déployer des composants à l’échelle d’entreprise avec Kubernetes |
| Fonction d’entreprise | Certaines parties nécessitent une clé de licence | Licence commerciale | Intégration exclusive, support et fonctionnalités de sécurité avancées |
| Laminar Cloud | Services commerciaux de gestion | Utiliser selon le forfait | Plateforme cloud sans maintenance |
Docker auto-hébergé
L’autogestion légère permet d’utiliser Docker Compose pour démarrer l’interface utilisateur, les services applicatifs et les composants de données nécessaires, ce qui convient au développement et à des utilisations à petite échelle. En environnement de production, il faut utiliser des fichiers d’orchestration complets, avec une configuration pour la persistance, les sauvegardes, le chiffrement réseau, l’authentification, les limites de ressources et les stratégies de mise à jour.
Kubernetes auto-hébergé
La solution officielle Helm est conçue pour les clusters AWS et Google Cloud, et prend en charge PostgreSQL, ClickHouse, Redis, RabbitMQ, la recherche full-text ainsi que le stockage d’objets. Les images entreprises publiques peuvent être téléchargées, mais certaines intégrations et fonctionnalités nécessitent une clé de licence entreprise.
| Composant | Principales responsabilités | Précautions de production |
|---|---|---|
| PostgreSQL | Comptes, projets et métadonnées | Haute disponibilité, sauvegardes et mises à niveau |
| ClickHouse | Suivi et analyse à grande échelle des données | Disques, stockage d’objets et politiques de conservation |
| Redis | Cache et état temporaire | Limites de mémoire et récupération en cas de panne |
| RabbitMQ | File d’attente de traitement asynchrone | Persistance, accumulation et surveillance |
| Quickwit | Index de recherche dans tout le texte | Stockage d’objets, taille de l’index et reconstruction |
| Frontend et serveur d’application | Interface, interfaçage et traitement des données | Verrouillage de version, élargissement et point d’accès réseau |
Confidentialité et suppression des PII
Les projets cloud peuvent activer la suppression des PII du côté serveur avant l’écriture, en détectant les noms, adresses e-mail, numéros de téléphone, comptes et autres informations personnelles dans les entrées et sorties de chaque Span, puis en les remplaçant par des placeholders. Le texte original n’est pas stocké dans le stockage de suivi ni dans l’index de recherche, mais cette fonction n’a d’effet que sur les nouveaux Spans une fois activée.
- L’interrupteur PII est configuré par projet, et non de manière uniforme pour l’ensemble de l’espace de travail.
- Le suivi historique existant ne sera pas rétraité automatiquement.
- Les informations structurelles telles que les noms des champs JSON, les noms des Span, l’état et le coût seront conservées.
- L’ID de l’utilisateur qui a enregistré les métadonnées ne sera pas supprimé par cet interrupteur.
- Des erreurs de reconnaissance ou des omissions peuvent encore survenir ; les champs sensibles doivent être supprimés en amont en priorité.
- Les équipes auto-hébergées doivent configurer elles-mêmes l’accès, le chiffrement, les sauvegardes et la suppression.
Capacités de sécurité d’entreprise
La comparaison des forfaits publics énumère les fonctionnalités de sécurité telles que la connexion OAuth, SOC 2 Type II, HIPAA et la suppression des PII du côté serveur, mais les forfaits disponibles en détail doivent être confirmés à travers la console et le contrat. L’équipe de régulation doit également examiner les sous-traitants, les zones de stockage des données, les clauses de conservation et de réponse aux incidents.
À qui s’adresse-t-il
- Équipe d’ingénierie pour le développement d’agents IA à plusieurs étapes.
- Équipes de plateforme nécessitant le suivi du comportement des modèles, outils et sous-agents.
- Créer une équipe de qualité pour évaluer la régression en fonction des modifications du modèle.
- Espérer identifier, en langage naturel, les produits présentant des anomalies de production ainsi que le personnel opérationnel.
- Équipes de données nécessitant SQL, des tableaux de bord et une analyse de recherche plein texte pour le suivi.
- Les entreprises qui souhaitent gérer elles-mêmes une plateforme d’observabilité open source.
- Développeur qui fait participer l’agent de programmation au cycle de débogage.
Avantages du produit
- Fournit une vue de suivi dialoguée pour les tâches à long terme et multi-agents.
- OpenTelemetry est natif et facilite l’intégration avec les systèmes d’observabilité existants.
- Les signaux permettent de détecter des problèmes logiques et métier à travers un suivi complet.
- Le débogueur réduit les coûts des appels répétés grâce à la lecture en cache.
- L’évaluation, les ensembles de données, l’annotation et le suivi de la production forment un cycle fermé.
- Prend en charge SQL, MCP, CLI et des tableaux de bord personnalisés.
- La plateforme principale et le SDK sont soumis à une licence open source permissive.
Restrictions et précautions
- Le suivi complet peut enregistrer des indications, les résultats des outils et des données commerciales sensibles.
- Les signaux dépendent du jugement du modèle, ce qui peut entraîner des faux positifs ou des faux négatifs.
- Il n’est pas possible de faire un calcul simple entre le Trace Token et les GB de stockage.
- Free ne conserve que 7 jours et ne permet pas de dépassement des données.
- Une pile auto-hébergée complète comprend diverses bases de données et middleware, ce qui rend son administration plus complexe.
- Certaines capacités d’entreprise et intégrations nécessitent une licence commerciale.
- La répétition du cache ne peut pas remplacer les tests d’extrémité à extrémité et de charge réels.
- La portée de l’instrumentation automatique varie en fonction de la version du framework.
Recommandations pour le choix et le déploiement
- Statistiques sur le nombre d’exécutions de l’agent, la taille moyenne du suivi et les exigences de conservation.
- Lister les champs sensibles à suivre et ceux à exclure.
- D’abord, intégrez l’SDK au projet de test et vérifiez la structure Span.
- Décider d’utiliser des frontières de données cloud ou auto-hébergées.
- Créer des signaux initiaux pour les erreurs, les coûts et les résultats commerciaux.
- Créer un petit ensemble de données de régression à partir d’échecs de production.
- Intégrer l’évaluation dans l’intégration continue en définissant une concurrence appropriée.
- Observer la consommation en GB et en Signals sur une période de facturation complète.
- Élaborer des manuels de fonctionnement pour les alertes, la conservation, la suppression et les droits d’accès.
- Vérifier régulièrement les sauvegardes, les mises à jour et la restauration en cas de panne.
Questions fréquentes
À quoi sert Laminar ?
Il est utilisé pour suivre, déboguer, surveiller et évaluer les agents d’IA ainsi que les applications de grands modèles de langage. La plateforme enregistre le fonctionnement des modèles, des outils et des sous-agents, et offre Signals, des ensembles de données, du SQL et des tableaux de bord.
Laminar est-il gratuit ?
Le plan gratuit Cloud offre 1 GB de données par mois, un crédit de 5 dollars pour Signals, une conservation sur 7 jours, 1 projet et 1 poste. Le code source principal open source peut également être déployé par l’utilisateur lui-même, mais les coûts d’infrastructure et de maintenance incombent à l’utilisateur.
Laminar est-il open source ?
Oui, le stockage central et les SDK principaux sont soumis à la licence Apache 2.0. Certains miroirs d’entreprise, intégrations, fonctionnalités de licence et services hébergés restent des fonctionnalités commerciales.
Signals lit-il toutes les traces ?
Seuls les traces qui répondent aux conditions de déclenchement et de filtrage correspondantes seront analysées. Le système compresse d’abord la trace, puis un agent interne examine son exécution complète et lit les Span spécifiques en fonction des besoins.
Peut-on l’héberger soi-même ?
Oui, un environnement léger peut utiliser Docker Compose, tandis qu’à l’échelle d’une entreprise, on peut déployer avec Helm sur AWS ou Google Cloud. Pour un déploiement en production, il est nécessaire de gérer soi-même la base de données, la recherche, le stockage d’objets, les sauvegardes et la sécurité.
Est-ce que Python et TypeScript sont pris en charge ?
Soutien : il existe des SDK officiels pour les deux langages, permettant une instrumentation automatique, des Span manuels, ainsi que l’observation et l’évaluation des fonctions. Avant de l’utiliser, il convient de vérifier que la version du framework est compatible avec l’intégration du SDK actuel.
Résumé
Laminar intègre le suivi des agents d’IA, la surveillance de la génération de langage naturel, le débogage par lecture du cache, l’évaluation hors ligne et l’analyse de données dans une plateforme native OpenTelemetry. Il est particulièrement adapté aux équipes d’ingénierie qui ont besoin de comprendre le comportement interne des tâches longues, et ne se contentent pas de voir uniquement la réponse finale.
La version gérée va de gratuite à 150 dollars par mois, avec une augmentation en fonction du volume de données et de l’utilisation de Signals ; la version open source offre un contrôle plus poussé sur les données, mais exige une gestion complète. Le choix final doit se baser sur l’analyse du volume de données à suivre, de la durée de conservation, des informations sensibles, des coûts liés à Signals et de la complexité de l’hébergement autonome.
Outil similaire à Laminar



 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164