




GooseAI
GooseAI, outil intelligent axé sur l’amélioration de l’efficacité de l’IA
Étiquettes :Amélioration de l’efficacité de l’IAUne phrase pour présenter
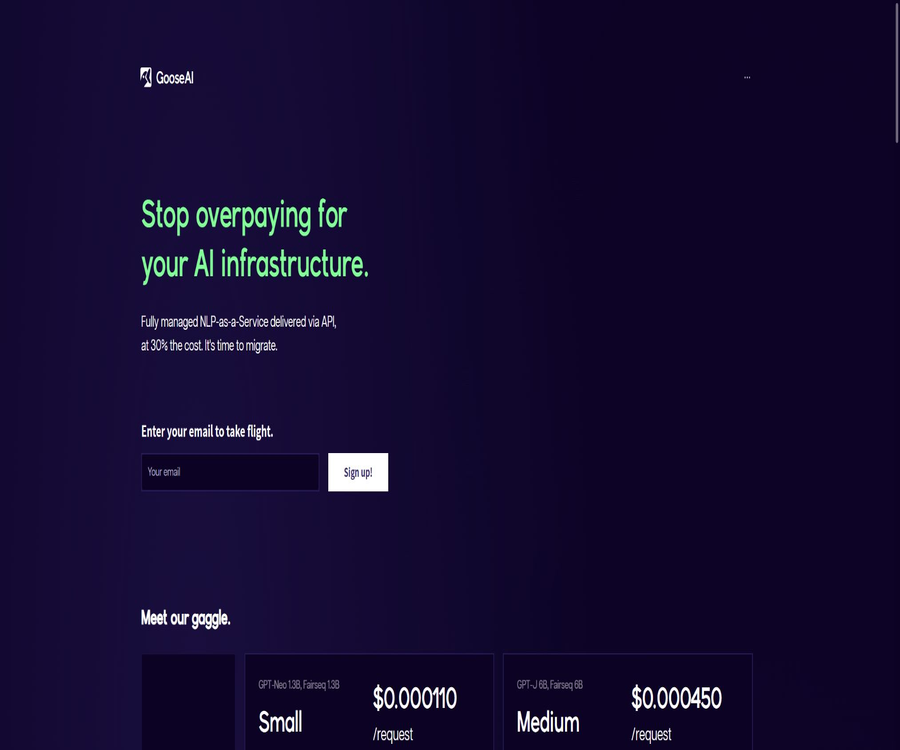
GooseAI est un service de raisonnement NLP hébergé destiné aux développeurs, qui permet d’appeler divers modèles linguistiques ouverts via l’interface Completions compatible avec les normes du secteur, et qui facture en fonction des tokens générés.
État actuel du produit
Au 23 août 2026, le site officiel de GooseAI, la page d’inscription, le Playground, la console des clés API et la page des prix sont tous accessibles ; les interfaces de modèles non authentifiés renvoient un état indiquant une autorisation requise. La plateforme reste en ligne et accessible pour s’inscrire et effectuer des appels.
Le site officiel continue de promouvoir principalement des modèles de génération plus anciens tels que GPT-Neo, GPT-J, Fairseq et GPT-NeoX, avec des interfaces principales restant basées sur les complétions de texte traditionnelles. Il ne s’agit pas d’une plateforme de chat multimodale moderne, et il ne doit pas être confondu avec l’agent IA open source du même nom, goose.
| Éléments de vérification | Résultat actuel | Conclusion |
|---|---|---|
| Site officiel | Afficher normalement les prix des produits et des modèles | Le service est toujours en fonctionnement. |
| Inscription au compte | La page de certification est accessible | Il est possible de créer un compte |
| Playground | Page accessible | Peut être utilisé pour des essais de modélisation |
| Console de clés API | La page est accessible et nécessite un accès. | Soutien aux clés autonomes |
| Interface API | Retour sans clé : non autorisé | L’interface est en ligne et protégée par une authentification. |
| Mise à jour du modèle | Les modèles de texte open source initiaux restent prédominants. | Effectuer des tests de qualité avant l’achat |
Présentation des outils
GooseAI a été lancé conjointement par CoreWeave et Anlatan, destiné aux développeurs et aux équipes de technologies créatives qui souhaitent intégrer des capacités de génération de texte dans leurs produits. La plateforme gère l’hébergement des modèles ainsi que l’infrastructure de traitement, permettant aux utilisateurs de soumettre des prompts via une API et de recevoir les résultats de la continuation du texte.
Son principal avantage est un coût de migration faible : les projets utilisant l’ancienne version du client Python d’OpenAI peuvent conserver la plupart des méthodes d’appel Completions, en remplaçant uniquement les clés, l’adresse de base de l’interface et l’ID du modèle. La portée réelle de la compatibilité doit encore être confirmée par des tests.
Fonction principale
Génération de texte sous tutelle
L’interface Completions prédit les tokens suivants en se basant sur le prompt fourni par l’utilisateur, et peut être utilisée pour compléter des phrases, créer des brouillons d’articles, générer des histoires, des titres ou des prototypes de texte structuré. Ce n’est pas un moteur de recherche : les réponses ne sont pas automatiquement accompagnées de sources vérifiables.
Divers modèles de langage ouverts
La page des prix actuels liste, en fonction de l’échelle des paramètres, les niveaux 125M, 1,3B, 2,7B, 6B, 13B et 20B, couvrant GPT-Neo, Fairseq, GPT-J et GPT-NeoX. Les tokeniseurs, la cohérence, la vitesse et le coût varient d’un modèle à l’autre.
Test du modèle Playground
La plateforme Playground permet aux utilisateurs d’essayer les modèles et les paramètres de génération avant d’accéder au code, afin de comparer les différences dans les résultats pour la même instruction. Le choix du modèle doit se baser sur des exemples réels de l’activité commerciale, et non seulement sur le nombre de paramètres.
Liste et détails des moteurs
L’interface Engines est utilisée pour lister les modèles pouvant être appelés, ou pour consulter le nom, le propriétaire, la disponibilité et la description d’un moteur individuel. En environnement de production, il convient de vérifier régulièrement si le moteur cible reste disponible.
Prompt unique ou en lot
Le document Completions permet à Prompt d’utiliser des chaînes de caractères, des arrays de chaînes de caractères, des arrays de tokens ou des ensembles d’arrays de tokens, et peut traiter plusieurs entrées en parallèle. Les entrées en masse augmentent la quantité totale générée ainsi que les coûts ; il convient donc d’établir des limites strictes.
Génération de plusieurs résultats
La demande peut générer plusieurs résultats candidats pour chaque Prompt grâce au paramètre de quantité. Le nombre de candidats est multiplié par le nombre de Prompts, et la facturation réelle ainsi que la taille de la réponse augmentent en conséquence.
Contrôle de la longueur de génération
L’utilisateur peut définir le nombre maximal et minimal de tokens générés ; la page des prix indique que le nombre peut atteindre 2 048 tokens par génération. Le prompt et la sortie restent soumis aux limites de longueur spécifiques au contexte du modèle.
Échantillonnage et biais de token
L’interface propose divers paramètres de génération pour contrôler le hasard, la distribution des candidats, les conditions d’arrêt et les préférences pour des tokens spécifiques. Les IDs de token de GPT-NeoX ne sont pas entièrement compatibles avec ceux d’autres modèles ; il est nécessaire de valider à nouveau lors du transfert des paramètres de biais.
Gestion du solde prépayé
L’API est facturée selon un crédit d’utilisation, et le solde du compte doit rester positif. Les appels à la clé API consomment directement le solde du compte ; il est donc nécessaire d’utiliser une gestion des clés du côté serveur.
Aperçu des modèles et des prix
Voici les prix publics en dollars américains sur le site officiel au 23 août 2026. Le prix de base pour chaque demande comprend les 25 premiers tokens générés ; les tokens supplémentaires sont facturés un par un. Les tokens d’entrée ne sont pas facturés séparément pour l’instant.
| Niveaux de paramètres | Série de modèles | Prix de base/demande | Token de sortie supplémentaire | Direction adaptée aux tests |
|---|---|---|---|---|
| 125M | GPT-Neo, Fairseq | 0,000035 dollar américain | 0,000001 dollar américain/Token | Vérification des formats et processus à faible coût |
| 1.3B | GPT-Neo, Fairseq | 0,000110 dollar américain | 0,000003 dollar américain/Token | Écriture légère et prototypage en masse |
| 2.7B | GPT-Neo, Fairseq | 0,000300 dollar américain | 0,000008 dollar américain/Token | Tâches de texte de petite et moyenne taille |
| 6B | GPT-J, Fairseq | 0,000450 dollar américain | 0,000012 dollar américain/Token | Contenu long et génération de créativité |
| 13B | Fairseq | 0,001250 dollar américain | 0,000036 dollar américain/Token | Tâches nécessitant des modèles plus grands |
| 20B | GPT-NeoX | 0,002650 dollar américain | 0,000063 dollar américain/Token | Essai de modèle ouvert de la plus haute gamme |
Une plus grande taille de modèle ne signifie pas nécessairement une plus grande précision pour chaque tâche ; elle peut également augmenter les délais et les coûts. Avant le déploiement, il convient de fixer un ensemble de test et d’évaluer en même temps la qualité des résultats, le débit, le taux d’erreurs et le coût par tâche.
Règles de facturation
| Projet | Règles officielles | Impact réel |
|---|---|---|
| Unité de facturation | Prix de demande de base + tokens générés supplémentaires | Une sortie courte entraîne également des frais de base. |
| Quantité de base incluse | Les 25 premiers tokens générés | Après dépassement, additionner selon les tokens |
| Saisir le token | Pas de frais actuellement | Les prompts longs restent soumis à des limites de contexte et de performance. |
| Limite de génération unique | La page des prix peut contenir jusqu’à 2 048 tokens | Il convient de le vérifier à nouveau en fonction du contexte du modèle. |
| Moyen de paiement | Acheter à l’avance des GooseAI Credits | Il faut recharger avant que le solde ne soit insuffisant. |
| Période de validité du crédit | 12 mois après l’achat | Le solde inutilisé viendra à échéance. |
| Remboursement | Le crédit n’est pas remboursable. | Vérifier d’abord avec une petite somme, puis recharger |
| Remise entreprise | Contacter le service des ventes pour un crédit en masse | Un devis séparé est nécessaire. |
Le crédit est consommé selon le principe du premier arrivé, premier servi ; les soldes achetés en premier sont déduits en premier. Les frais de plateforme et les taxes peuvent varier ; les achats d’entreprise doivent préciser dans le contrat le prix, la durée de validité, la portée des services et les responsabilités de facturation.
Exemple de calcul des coûts
| Exemple | Niveau de modèle | Longueur de génération | Méthode d’estimation | Projets non inclus |
|---|---|---|---|---|
| Brève continuation | 1.3B | 25 Token | Seulement le prix de base : 0,000110 dollar américain | Frais et tentatives de réessai en cas d’échec |
| 100 Token suite | 1.3B | 100 Token | Prix de base + 75 tokens supplémentaires | Candidats concurrents et tentatives de réessai |
| 100 Token suite | 6B | 100 Token | Prix de base + 75 tokens supplémentaires | Coûts de réseau et d’applications |
| Génération à plusieurs candidats | arbitraire | Chaque prompt génère plusieurs résultats | Somme des quantités générées par chaque candidat | Coûts de traitement postérieur |
| Prompt en lot | arbitraire | Plusieurs entrées en parallèle | Chaque requête et chaque sortie sont cumulées séparément | Limitation du débit et répétition en cas d’échec |
Lors de l’estimation, il ne faut pas se baser uniquement sur le prix d’une seule appelation ; il convient également de prendre en compte la longueur moyenne des résultats, le nombre de candidats, le taux de réessais, les résultats invalides et la concurrence maximale. Un système de production doit enregistrer la consommation réelle de chaque action métier.
Guide d’intégration API
Créer et protéger la clé API
- Inscrivez-vous à un compte GooseAI et terminez la vérification de votre e-mail ou de votre compte.
- Accédez à la section de gestion des clés API du Dashboard pour créer une clé secrète distincte.
- Conserver la clé dans la gestion des clés du serveur ou dans les paramètres d’environnement, sans l’inclure dans le code frontend.
- Créer des clés distinctes pour les environnements de développement, de test et de production afin d’éviter leur utilisation commune.
- Rechargez d’abord un petit montant de crédit et configurez des alertes pour le solde interne et les frais.
- En cas de fuite de clé, annuler et remplacer immédiatement, tout en vérifiant les appels anormaux.
Migrazione depuis l’ancienne version du client OpenAI
- Vérifier que les applications existantes utilisent des Completions et des appels d’Engine traditionnels, et non l’interface de chat moderne.
- Conserver les bibliothèques clients compatibles et les remplacer par la clé secrète GooseAI.
- Remplacez l’adresse de base du client par l’adresse API de la première version de GooseAI.
- Obtenez l’ID du modèle actuellement disponible à partir de la liste des Engines, et n’écrivez pas manuellement les anciens IDs à partir des documents.
- Choisissez un modèle et exécutez la demande minimale avec un prompt fixe.
- Vérifier la structure de la réponse, la raison de l’arrêt, le nombre de tokens, le code d’erreur et les frais.
- Après les tests, basculez progressivement le trafic tout en conservant la configuration de fallback.
Concevoir une demande Completions
- Préparez un prompt concis, en précisant le format de sortie, le ton et les conditions de fin.
- Spécifiez l’ID du moteur et définissez un nombre maximal de tokens générés raisonnable.
- On commence par établir une base de référence reproductible à partir d’une faible randomisation et d’un seul candidat.
- Configurer une séquence d’arrêt pour éviter que le modèle ne continue à générer des paragraphes sans rapport.
- Enregistrer l’ID de la demande, le modèle, les paramètres, le délai, la quantité de sortie et les frais.
- Filtrage de sécurité, vérification de format et vérification des faits sur la sortie.
- En cas de limitation de débit ou d’erreur de service, on utilise un recul exponentiel avec une limite.
À qui s’adresse-t-il
- Équipe de développement chargée de maintenir les applications Completions anciennes : réduction de la charge de travail liée au transfert des interfaces.
- Produits d’écriture créative : test du modèle ouvert pour la continuation, la génération d’histoires et de styles.
- Équipe de prototypes de texte en masse : utiliser de petits modèles pour valider le format et les flux de travail.
- Évaluateur de modèles : Comparer différentes tailles de paramètres dans un environnement d’hébergement unifié.
- Utilisateurs éducatifs et de recherche : observer le comportement de GPT-Neo, GPT-J et GPT-NeoX.
- Projets sensibles au coût : contrôle du budget de génération de textes courts en fonction des tokens produits.
- Développeurs backend nécessitant la compatibilité avec l’ancienne version du client OpenAI.
Scénarios d'utilisation typiques
- Générer des paragraphes suivants et des versions candidates pour des textes d’articles, d’histoires ou de jeux.
- Compléter la description du produit, le brouillon de résumé ou le titre en fonction d’un modèle fixe.
- Évaluation de la qualité et du coût pour l’exécution du même prompt sur plusieurs modèles ouverts.
- Utilisez les niveaux 125M ou 1,3B pour des tests de charge d’interfaces et de files d’attente à faible coût.
- Passer le prototype de l’ancienne version d’OpenAI Completions à un autre fournisseur d’inference hébergé.
- Générer en masse des textes créatifs nécessitant un tri manuel ultérieur.
- Étudier différents paramètres d’échantillonnage, les biais de token et les conditions de cessation.
Avantages du produit
- L’infrastructure d’inference GPU est gérée par la plateforme, sans nécessité de déployer les modèles soi-même.
- Compatible avec la logique d’appel du client traditionnel OpenAI, le seuil de migration est relativement faible.
- La page des prix affiche le prix de base de la demande ainsi que le prix unitaire des tokens de sortie supplémentaires.
- Seule la génération de tokens est facturée, l’entrée n’est pas facturée séparément pour le moment.
- Des séries de modèles et des tailles allant de 125 M à 20 B sont disponibles.
- La page Playground permet de comparer rapidement les résultats avant d’écrire du code.
- Création autonome de clés API, avec des offres de crédit en masse pour les entreprises.
Restrictions d'utilisation et précautions
- Le modèle actuel est principalement basé sur des modèles de texte ouverts anciens, et ses capacités diffèrent nettement de celles de la nouvelle génération de modèles de chat.
- L’accent est mis sur les Completions ; il ne faut pas supposer un soutien pour les images, l’audio, les appels d’outils ou les interfaces de chat modernes.
- La plupart des contenus juridiques et relatifs à la vie privée du document ont été mis à jour pour la dernière fois en 2022 et peuvent être dépassés par les pratiques actuelles.
- Le site officiel affirme que le pourcentage d’économie est une comparaison marketing ; le coût réel dépend de la sortie et des tentatives de réessai.
- La saisie est gratuite, mais des prompts longs affectent néanmoins le contexte, les délais et les performances du modèle.
- Plusieurs prompts et plusieurs candidats augmentent rapidement la génération de tokens et les coûts.
- Le crédit a une durée de 12 mois et n’est pas remboursable ; il ne convient pas de faire des achats anticipés en grande quantité d’un coup.
- Le modèle peut générer des contenus fictifs, biaisés, nuisibles ou non conformes au format.
- Les modèles diffèrent en ce qui concerne les Tokenizers, et le biais des tokens ainsi que l’estimation de la longueur ne peuvent pas être réutilisés directement.
- Il n’existe pas de SLA modernes, d’informations sur le stockage des données ni de résumés des certifications de sécurité les plus récentes en public ; les entreprises doivent les vérifier séparément.
Interfaces et sorties pris en charge
| Capacité | Soutien disponible | Explication |
|---|---|---|
| Liste des moteurs | Soutien | Lister les modèles disponibles |
| Détails du moteur | Soutien | Vérifier l’état et la description d’un modèle unique |
| Complétions de texte | Soutien | Continuation générée selon le prompt |
| Plusieurs prompts | Soutien | Traitement concurrentiel possible |
| Plusieurs candidats | Soutien | Chaque prompt génère plusieurs résultats |
| Sortie en flux | Les anciennes versions d’interface sont généralement compatibles, il faut le vérifier par essai. | Se baser sur le comportement de réponse actuel |
| Chat Completions | Non confirmé dans le document principal actuel | Ne partez pas du principe d’une interface de chat moderne. |
| Embeddings | Non confirmé dans la navigation actuelle | Absence d’action, capacité déjà prise en charge |
| Images et audio | Non pris en charge | Service de raisonnement NLP pour le texte |
| Ajustement fin | Aucune documentation auto-aidée actuelle trouvée | Il est nécessaire de contacter les autorités pour confirmation. |
GitHub, SDK et open source
GooseAI dispose d’une organisation GitHub du même nom, mais les trois dépôts publics actuels sont des forks de projets autres, notamment le client GPT-3 en langage Go, KoboldAI et Transformers. Cela ne signifie pas que le code source backend de la plateforme GooseAI est déjà open source.
La documentation officielle recommande principalement d’utiliser l’ancienne version du client Python d’OpenAI en modifiant l’adresse de base, sans fournir de SDK GooseAI indépendant. Le fait que le service utilise des modèles ouverts ne signifie pas pour autant que la plateforme elle-même est open source.
| Projet | Situation actuelle | Jugement sur le logiciel open source |
|---|---|---|
| Plateforme cloud GooseAI | Le code source n’est pas public. | Services de hébergement fermés |
| Modèle de gestion | Provenant de plusieurs projets de modèles ouverts | Les licences sont évaluées séparément pour chaque modèle. |
| Organisation GitHub officielle | Il y a trois Forks publics | Ce n’est pas le code source principal de la plateforme |
| SDK officiel indépendant | Non trouvé | Utiliser un client compatible ou demander directement |
| go-gpt3 Fork | Licence MIT | Ancien client générique, pas le code source de la plateforme |
| KoboldAI Fork | Licence AGPL-3.0 | Différents projets d’application |
| Transformers Fork | Licence Apache-2.0 | Branche du cadre en amont |
Confidentialité et traitement des données
Le site actuel affiche toujours la politique de confidentialité mise à jour pour la dernière fois le 31 janvier 2022. Cette politique couvre les informations relatives aux comptes, les données d’utilisation, les cookies, les appareils ainsi que les informations sur les comptes tiers, et précise ce qui peut être partagé avec des prestataires de services, des fournisseurs d’analyse, des successeurs commerciaux ou des autorités judiciaires.
La politique indique clairement que ses mentions générales sur la confidentialité ne s’appliquent pas aux données traitées par les clients via le service ; les utilisateurs professionnels doivent examiner en plus le DPA et le contrat. Les documents actuellement publics ne contiennent aucune promesse claire concernant une durée de conservation fixe pour les prompts et les résultats générés, ni l’interdiction d’en faire un usage pour l’entraînement.
- Ne soumettez pas de mots de passe, de clés, de pièces d’identité ou de données réglementées dans le Prompt.
- Demander le DPA en vigueur, les sous-traitants et les indications relatives à la conservation des données avant de se connecter à l’entreprise.
- Vérifier les modalités de transfert transfrontalier des données, de leur suppression, de leurs sauvegardes et de traitement des demandes des autorités.
- Revéler à l’utilisateur final, dans l’application, la participation de services de modèles tiers.
- Masquer le Prompt et la sortie, tout en conservant les audits d’accès nécessaires.
- Les utilisateurs de moins de 18 ans ne doivent pas utiliser ce service.
Conditions et conformité
La date de dernière modification des conditions de service est également le 31 janvier 2022 ; les frais peuvent être ajustés et les paiements sont gérés par Stripe ou d’autres services. Le client achète et consomme un crédit, lequel peut être révoqué en cas de non-respect des règles, de données de facturation falsifiées ou d’actes illégaux.
Le client est responsable de la conservation de ses données et accorde à GooseAI les licences nécessaires pour l’hébergement, le stockage, la transmission et le formatage requis pour la prestation des services. Les clauses interdisent le reverse engineering ; la loi applicable et la juridiction compétente sont celles de New York.
- Il est interdit de créer ou de diffuser des contenus illégaux, abusifs, portant atteinte aux droits d’autrui ou constituant une divulgation involontaire de données privées.
- Il est interdit d’utiliser les services pour enfreindre le droit d’auteur, les marques déposées, la vie privée ou le droit à la publicité.
- Il est nécessaire de protéger la clé API et d’assumer toutes les dépenses qu’elle engendre.
- Un processus de plaintes et de suppression doit être mis en place pour permettre aux utilisateurs de demander la suppression du contenu généré.
- Les achats d’entreprise doivent prendre en compte les taxes et frais, les limites de responsabilité, la suspension des services et le traitement des soldes.
- Lisez à nouveau les conditions les plus récentes avant de vous connecter, et ne vous fiez pas uniquement au résumé de 2022.
Informations de base
| Projet | Contenu |
|---|---|
| Nom de l’outil | GooseAI |
| Entité opérationnelle | GooseAI, Inc. |
| Partenaires de lancement | CoreWeave et Anlatan |
| Type d’outil | API de raisonnement pour le NLP géré et les modèles linguistiques |
| Modèle principal | GPT-Neo, GPT-J, Fairseq, GPT-NeoX |
| Interface principale | Moteurs et complétions de texte |
| Modèle de prix | Crédit prépayé, facturation selon la génération de tokens |
| Entrée de facturation | Pas de frais actuellement |
| Période de validité du crédit | 12 mois |
| Remboursement | Le crédit n’est pas remboursable. |
| Playground | Oui |
| API publique | Oui |
| SDK officiel indépendant | Non trouvé |
| La plateforme est-elle open source | Non |
| Date de vérification des informations | 23 août 2026 |
Indice de recommandation
Note de recommandation : 3,5 / 5. La tarification de GooseAI est transparente et ses interfaces sont simples ; elle convient aux développeurs qui maintiennent encore des applications de complétion traditionnelles ou qui ont besoin d’évaluer des modèles ouverts en phase initiale.
Le principal défaut réside dans le fait que les modèles et l’architecture des interfaces sont obsolètes, que les documents de politique ont été mis à jour il y a longtemps, et qu’il manque des explications claires concernant les fonctionnalités de chat moderne, multimodal et de sécurité d’entreprise. De nouveaux projets devraient d’abord comparer la qualité et le coût total avec des API de modèles plus récentes.
Questions fréquentes
Qu’est-ce que GooseAI ?
Il s’agit d’un service de raisonnement basé sur des modèles linguistiques gérés, qui offre via une API la capacité d’extension de texte pour des modèles ouverts. Il s’adresse principalement aux développeurs, et non aux utilisateurs ordinaires de chat.
GooseAI est-il encore en activité ?
Oui. Le site officiel, l’inscription, le Playground, le Dashboard et l’API protégée par authentification sont toujours en ligne.
GooseAI est-il gratuit ?
Créer un compte est gratuit, mais l’API consomme des crédits prépayés en fonction de la quantité générée. Une inscription gratuite ne signifie pas une inférence gratuite permanente.
Y a-t-il des frais pour entrer un token ?
La page de tarification actuelle indique que seuls les tokens générés sont facturés, l’entrée n’est pas facturée séparément. Les prompts longs restent soumis aux limites de contexte et de performance.
Combien de tokens sont inclus dans le prix de base ?
Le prix de base de chaque demande comprend les 25 premiers tokens générés ; le reste est calculé au tarif unitaire des tokens supplémentaires selon le niveau du modèle.
La limite de crédit expire-t-elle ?
Oui, il expire 12 mois après l’achat et est déduit selon le principe du premier arrivé, premier servi. Le crédit n’est pas remboursable.
Quels modèles sont pris en charge ?
La page des prix actuels liste GPT-Neo, Fairseq, GPT-J et GPT-NeoX, avec des tailles de paramètres allant de 125M à 20B. Les moteurs réellement disponibles doivent être confirmés via la liste API.
Est-ce compatible avec l’API d’OpenAI ?
Compatibilité avec la logique d’appel traditionnelle de l’Engine et des Completions ; les clients anciens nécessitent généralement uniquement le remplacement de la clé, de l’adresse de base et de l’ID du modèle. L’interface Chat moderne ne peut pas être considérée comme compatible par défaut.
Y a-t-il un SDK officiel ?
Aucun SDK indépendant GooseAI n’a été trouvé. Les exemples officiels utilisent l’ancienne version du client Python d’OpenAI, il est également possible d’envoyer directement des requêtes API.
GooseAI est-il open source ?
La plateforme de gestion n’est pas open source. Certains des modèles qu’elle prend en charge et les GitHub Fork associés ont leurs propres licences, mais cela ne signifie pas que le code du service cloud soit ouvert.
Quelle est sa relation avec le goose AI Agent ?
Ce n’est pas grave. Ce dernier est un autre projet d’agent IA open source, avec une orientation produit, une équipe, un nom de domaine et du code différents.
Peut-il être utilisé dans des produits commerciaux ?
Il est possible d’appeler les services conformément aux conditions de la plateforme, mais il faut également vérifier séparément la licence du modèle sélectionné, les droits sur le contenu généré, l’AUP et la conformité commerciale. L’entreprise doit signer les contrats applicables ainsi que le DPA.
Résumé
GooseAI convient aux équipes de développement qui ont besoin d’appeler à faible coût des modèles ouverts tels que GPT-Neo, GPT-J, Fairseq ou GPT-NeoX. Son mode de facturation des résultats est intuitif, et son Playground permet de tester facilement les différences entre les prompts et les modèles.
Les nouveaux projets ne devraient pas être mis en ligne simplement parce que leur prix unitaire est bas ; il convient de comparer la qualité du modèle, le contexte, la concurrence, la pertinence des politiques et les risques de maintenance. Il faut d’abord effectuer une évaluation pratique avec un montant de crédit limité avant de décider s’il convient d’en étendre l’utilisation.
Outils similaires à GooseAI



 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164