




Data Donkee
Data Donkee, outil intelligent spécialisé dans la programmation par IA
Étiquettes :Outils de programmation IAUne phrase pour présenter
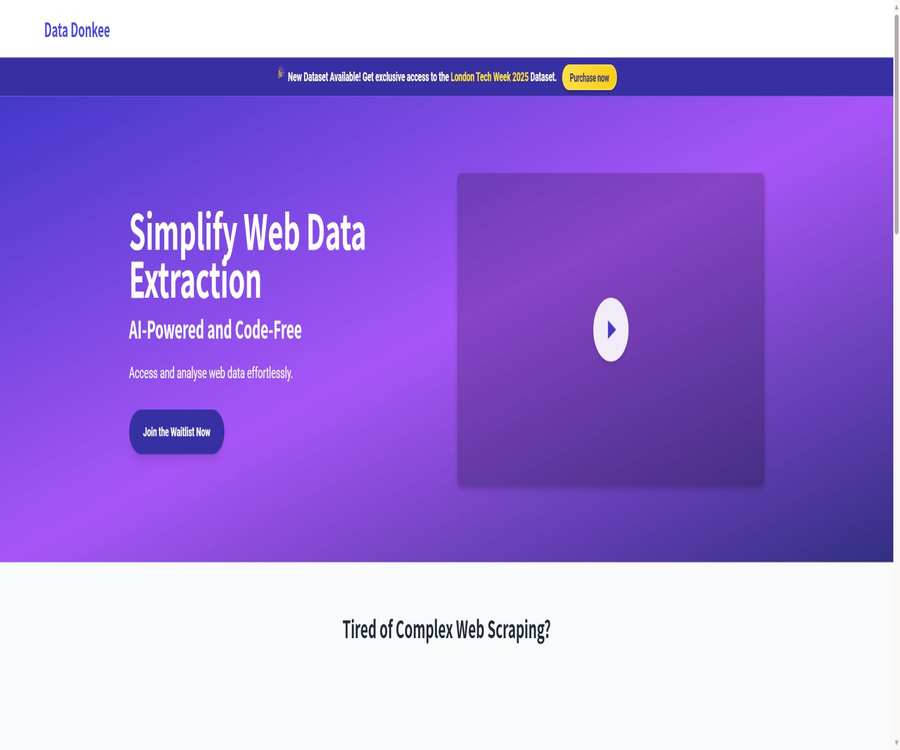
Data Donkee est un agent web IA conçu pour l’extraction de données depuis des sites web sans code ; les utilisateurs définissent leurs besoins en langage naturel et avec JSON Schema, et le système génère ensuite un programme d’extraction pour fournir des données structurées.
Présentation des outils
Data Donkee vise à résoudre les problèmes liés aux méthodes traditionnelles de développement de crawlers, tels que la lenteur de développement, les coûts élevés de maintenance en cas de modifications des sites web, et les difficultés à gérer les pages dynamiques complexes. Il met l’accent sur la séparation de la définition des champs de données et de l’exécution du crawl, permettant aux professionnels métier de décrire d’abord ce dont ils ont besoin.
Au 22 août 2026, le site officiel reste principalement accessible via l’inscription sur une liste d’attente, sans offre d’inscription automatique en ligne, de console de gestion des produits, de forfaits standard ou de documentation API officielle. Il convient donc de le considérer comme un produit en accès précoce, et non comme un SaaS mature déjà pleinement commercialisé.
Aperçu des compétences clés
| Capacité | Entrée de l’utilisateur | Traitement du système | Sortie |
|---|---|---|---|
| Exigences en langage naturel | Site cible et description des données | Comprendre la tâche de capture | Plan d’extraction |
| Contrainte de schéma | Champs, types et règles de champ obligatoire | Organiser les résultats par structure | Objet de données cohérent |
| AI Web Agent | Pages et objectifs de tâche | Naviguer et localiser le contenu | Champ cible |
| Génération de code | Langage naturel et schéma | Créer des programmes de capture réutilisables | Réduire les coûts de raisonnement répétitif |
| Traitement de sites dynamiques | Structure de page complexe | Navigation autonome et extraction | Enregistrement structuré |
| Résultat du téléchargement | Tâche terminée | Nettoyer et ranger | Fichiers de données analysables |
Fonction principale
Description en langage naturel des besoins de données
L’utilisateur peut indiquer directement le site cible, les critères de filtrage, la plage de pages et les champs requis, sans avoir à écrire au préalable des sélecteurs ou du code de crawl. Les exigences doivent rester spécifiques, sinon le système pourrait récupérer des pages incorrectes ou interpréter mal le sens des champs.
Définition de la structure JSON Schema
L’exemple du site officiel utilise JSON Schema pour décrire le nombre total de résultats, les pays, les noms de domaine et les tableaux de produits, et définit les types ainsi que l’obligation pour le titre, le prix, la monnaie et l’identifiant du produit. Le schéma aide à uniformiser le format, mais ne peut pas garantir automatiquement l’exactitude des données sources.
Génération automatique de programmes de capture
La plateforme affirme que l’IA créera des programmes de capture personnalisés en fonction des besoins, et réduira les coûts de traitement ultérieurs grâce à du code réutilisable. La page publique ne précise pas si le code généré est livré aux utilisateurs, quel environnement de exécution est utilisé, ou s’il est possible de l’installer soi-même.
Navigation complexe des pages
Le Web Agent est décrit comme capable de gérer de manière autonome des structures de sites web complexes. Il reste nécessaire de procéder à des tests pratiques sur le site cible pour déterminer s’il peut gérer de façon fiable la connexion, les codes de vérification, le scroll infini, les restrictions géographiques et les pages anti-automatisation robustes.
Sortie de données structurées
Une fois la tâche terminée, il est possible d’obtenir des résultats structurés et nettoyés à télécharger, pour une analyse, des études de marché ou une importation dans le système. Le site officiel ne précise pas les formats de fichiers pris en charge, le nombre maximal d’enregistrements par opération ni la durée de conservation des exportations.
Extraction à grande échelle
La cible du produit inclut l’extension entre sites et pour de grandes quantités de données, ainsi que la génération de code réutilisable afin de réduire les coûts liés aux traitements d’IA répétitifs. La bande passante, la concurrence, le réseau de proxy, les tentatives de récupération en cas d’échec et les niveaux de service ne sont pas encore divulgués.
Vente de jeux de données prêts à l’emploi
Le site officiel met également en lien avec une boutique indépendante de produits numériques, où sont actuellement mis en vente publiquement les ensembles de données des participants à la London Tech Week 2025. Il s’agit d’un produit de données unique, qui n’est pas le même que l’abonnement Web Agent, encore en phase de préparation.
Processus d'utilisation standard
- Vérifier que les données cibles ont une base légale pour être obtenues, stockées et utilisées.
- Définir la portée de la page, la fréquence de mise à jour, les critères de filtrage et l’usage commercial final.
- Décrivez la tâche en langage naturel et précisez clairement la signification de chaque champ.
- Créer un JSON Schema en définissant les types, les champs obligatoires, les tableaux et la possibilité de valeurs nulles.
- Tenez d’abord des tests sur un petit nombre de pages, en vérifiant manuellement les résultats par rapport à la page originale.
- Ajouter la suppression des doublons, les valeurs aberrantes, les timestamps et les enregistrements de pages de référence.
- Étendre à des tâches complètes et surveiller les échecs, les changements de site et la qualité des données.
- Définir des délais de conservation et de suppression en fonction de l’usage, afin de ne pas conserver indéfiniment les données extraites.
Tutoriel sur la conception de tâches
Conception du prélèvement de données de produits
- Lister l’identifiant du produit, le titre, la marque, le prix, la monnaie, les stocks et l’heure de capture.
- Prévoir que le prix retourné ne contienne que des chiffres, et placer la devise dans un champ distinct.
- Distinguer le prix affiché sur la page de liste, le prix sur la page de détails, le prix avec remise et le prix pour membres.
- Vérifier les variantes, les ruptures de stock, le pagination et les enregistrements duplicats avec une petite quantité de produits.
- Conserver la page de référence et l’heure du crawl pour faciliter le suivi en cas de variation des prix.
- Mise en place d’une révision manuelle pour les prix anormalement bas, les titres vides et les devises incorrectes.
Écrire un schéma fiable
- D’abord, dessinez le tableau final, puis convertissez chaque colonne en champ.
- Choisissez le type approprié pour les dates, les nombres, les valeurs booléennes, le texte et les tableaux.
- Seuls les champs indispensables à l’activité sont obligatoires.
- Indiquez l’unité, des exemples, les valeurs autorisées et les règles d’exclusion dans la description du champ.
- Définir une stratégie de valeur manquante pour les données absentes, afin que le modèle ne les invente pas lui-même.
- Enregistrer la version du schéma pour éviter que l’analyse en amont échoue soudainement après mise à jour de la tâche.
Vérifier les résultats du crawl
- Extraire aléatoirement des échantillons de différents types de pages et les comparer point par point avec les pages web.
- Vérifier que la pagination, les listes, les détails, les fenêtres contextuelles et le chargement différé ne manquent pas.
- Statistiques des pourcentages de valeurs manquantes, de doublons, d’erreurs de type et de valeurs irréalistes.
- Rétestez après une mise à jour du site, un changement d’état de connexion ou de région.
- Classer les causes d’échec en problèmes d’accès, de navigation, de parsing et de schéma.
- Elle n’est utilisée dans les rapports ou pour la prise de décision automatique qu’après avoir atteint un taux de précision prédéfini.
À qui s’adresse-t-il
- Chercheur de marché : Collecte d’informations publiques sur les produits, les entreprises et les événements.
- Équipe e-commerce : mettre à jour les prix, les stocks et les modifications du catalogue de produits.
- Analyste de données : création rapide d’entrées de données structurées.
- Équipe de création d’entreprise : Vérifier les besoins en données en l’absence d’ingénieur spécialisé en scrapers.
- Équipe de conseil et d’information concurrentielle : regrouper les données publiques selon un schéma uniforme.
- Équipe d’apprentissage automatique : création de jeux de données vérifiés pour les projets de recherche.
- Équipe de développement : Évaluer le coût de maintenance d’une logique de capture générée par l’IA et réutilisable.
Scénarios d'utilisation typiques
| Scène | Champs principaux | Fréquence de mise à jour | Risque clé |
|---|---|---|---|
| Surveillance des prix en e-commerce | Produits, prix, monnaie, stock | Jour après jour ou plus | Conditions d’accès et interprétation erronée des prix |
| Organisation des documents de l’événement | Entreprise, poste, sujet, date | Avant et après l’événement | Profils et consentement marketing |
| Recherche de logements | Lieu, superficie, prix, état | Chaque jour | Duplication des logements et réglementations locales |
| Tendances de recrutement | Poste, compétences, lieu, date de publication | Chaque semaine | Postes expirés et informations personnelles |
| Table des matières | Titre, auteur, date, catégorie | Régulièrement | Droits d’auteur et réutilisation intégrale |
| Catalogue des fournisseurs | Nom, catégorie, région, canaux de contact | Chaque mois | Précision et base d’utilisation commerciale |
Prix et état d’ouverture
Le prix standard de l’agent Web de Data Donkee n’a pas encore été divulgué ; il est possible de s’inscrire sur une liste d’attente pour accéder à une version précoce. Les affirmations du site officiel concernant l’évolutivité et les coûts faibles relèvent de la positionnement du produit et ne peuvent pas remplacer une estimation précise basée sur le nombre de pages, d’enregistrements, de tâches ou de quantité de calculs.
| Produit | Prix actuel | Mode ouvert | Explication |
|---|---|---|---|
| AI Web Agent | Non divulgué | S’inscrire sur la liste d’attente | Pas de forfait standard, de crédit d’essai ni de instructions de facturation |
| Ensemble de données des participants à London Tech Week 2025 | 5000 dollars | Achat unique en magasin indépendant | Séparé de l’abonnement Web Agent |
| Personnalisation ou extraction d’entreprise | Non divulgué | Il peut être nécessaire de contacter l’équipe. | Le site officiel ne dispose pas de page de prix officielle. |
La boutique de datasets publics utilise des plateformes de produits numériques tierces pour les paiements. Avant d’acheter, il convient de vérifier le contenu des fichiers, le nombre d’enregistrements, la date de mise à jour, la source des données, la portée de la licence, les conditions de remboursement et la conformité des données personnelles, et non de se fier uniquement au nom du produit pour en évaluer la valeur.
Vérification avant achat et essai
| Éléments de vérification | Niveau de transparence du site officiel | Questions à confirmer |
|---|---|---|
| Disponibilité | Phase de candidature | Quand le lancement, est-il nécessaire d’avoir une invitation |
| Facturation | Non divulgué | Par page, enregistrement, tâche ou temps d’exécution |
| Limite | Non divulgué | Concurrents, nombre de pages, taille du fichier et tarif supplémentaire |
| Format | Écrire uniquement le téléchargement structuré | JSON, CSV ou d’autres formats |
| Capacité d’accès | Description générale | Connexion, pages dynamiques, codes de vérification et restrictions géographiques |
| Conservation des données | Non divulgué | Délais de suppression des entrées, résultats, journaux et sauvegardes |
| Garantie de service | Non divulgué | Disponibilité, support, récupération et remboursement en cas d’échec |
| Propriété du code | Non divulgué | Le générateur d’outils de scraping peut-il télécharger ou être hébergé en interne |
Avantages du produit
- Décrire les tâches en langage naturel pour réduire la barrière à l’entrée pour les non-spécialistes souhaitant commencer à extraire des données.
- Prend en charge JSON Schema, ce qui permet de définir à l’avance des contraintes sur les champs et les types de données.
- Il est souligné que la création de programmes de capture réutilisables devrait permettre de réduire le coût de chaque appel à l’IA.
- L’objectif couvre les sites web dynamiques complexes et l’extraction de données à grande échelle.
- Le processus est simple : il ne comporte que trois étapes clés, de la description des besoins au téléchargement du résultat.
- Le fondateur se présente publiquement comme ayant de nombreuses années d’expérience dans des projets de données d’entreprise.
Restrictions d'utilisation et précautions
- Le produit est encore en phase de préparation pour son lancement ; ses fonctionnalités, son interface et son modèle économique peuvent changer.
- Pas de prix public, de quota gratuit, de documentation d’aide, d’API ou de niveau de service.
- Le site officiel affirme que l’absence d’illusions dans les résultats ne constitue pas une garantie de zéro erreur.
- Les sites complexes, les codes de vérification et les mesures anti-automatisation peuvent entraîner l’échec de la tâche.
- Après un changement de structure du site, même si le code est réutilisable, des tâches de maintenance et de tests de régression sont nécessaires.
- Une structure correcte ne signifie pas que le contenu est fiable ; les champs clés doivent encore être vérifiés manuellement.
- La récupération de pages publiques peut également enfreindre les conditions d’utilisation du site, les droits d’auteur, les droits sur les bases de données ou la réglementation sur la vie privée.
- Avant d’acheter des ensembles de données prêts à l’emploi, il est nécessaire de vérifier la source, les licences, la date de validité et les informations personnelles associées.
- Ne pas utiliser d’outils pour contourner la connexion, les murs de paiement, les codes de vérification ou le contrôle d’accès.
Conformité et extraction responsable
- Lisez les conditions d’utilisation du site cible, les règles de capture et la documentation des interfaces publiques.
- Privilégiez l’utilisation de l’API officielle, le téléchargement de données ouvertes ou l’obtention d’une autorisation écrite.
- Contrôler la fréquence des demandes et la concurrence pour éviter de perturber le fonctionnement normal du site.
- Aucune information privée, données de paiement ou données personnelles sensibles après connexion ne sont récupérées.
- Ne conserver que les champs nécessaires à l’activité commerciale, et définir les droits d’accès ainsi que la date de suppression.
- Respecter les droits d’auteur, les marques déposées, les droits sur les bases de données et les restrictions relatives à la redistribution du contenu.
- Avant d’utiliser le marketing ciblé sur les contacts, vérifiez séparément le consentement, l’abonnement et la législation locale.
- Enregistrer le canal, l’heure, le schéma et les étapes de traitement afin de faciliter les corrections et les audits.
Confidentialité et sécurité des données
Le site officiel ne propose pas d’accès à une politique de confidentialité indépendante vérifiable, à des conditions d’utilisation ou à des informations relatives au traitement des données. Étant donné que les tâches de capture peuvent inclure des pages cibles, des schémas, des résultats et des profils, les entreprises ne doivent pas télécharger de données sensibles en l’absence de documents écrits.
- Demander où se trouvent l’entrée de la tâche, les résultats du scraping, la génération de code et le stockage des journaux.
- Vérifier les niveaux d’accès des employés de la plateforme, des fournisseurs de modèles et des fournisseurs d’infrastructure.
- Vérifier si les données sont utilisées pour l’entraînement de modèles, l’amélioration des produits ou d’autres tâches pour le client.
- Demander des procédures de chiffrement, d’autorisation, de sauvegarde, d’alerte en cas d’incident et de suppression.
- Utiliser des ensembles de données publiques et à faible sensibilité pendant la phase de test.
- Supprimez rapidement la copie dans le cloud après l’exportation, et protégez le fichier local.
- Effectuer une évaluation des bases légales, des restrictions relatives aux finalités et des droits de la personne concernée en ce qui concerne les données personnelles.
API, GitHub et statut open source
Au moment de la vérification, le site officiel de Data Donkee ne propose pas de références API publiques, d’SDK, d’outils en ligne de commande ni de procédure pour demander des clés de développeur. JSON Schema est la norme pour les entrées de tâche, mais cela ne signifie pas que la plateforme offre déjà une interface programmable.
Aucune organisation GitHub officielle, aucun dépôt de code source ou aucune licence open source appartenant à Data Donkee n’a été identifiée. Le site officiel mentionne que du code réutilisable généré par l’IA est disponible, mais cela ne signifie pas que les utilisateurs peuvent télécharger ce code ou que la plateforme elle-même est open source.
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Data Donkee |
| Type d’outil | Extraction de données de sites web par IA et scrapers sans code |
| Phase du produit | Liste d’attente et visites anticipées |
| Entrée principale | Exigences en langage naturel et JSON Schema |
| Sortie principale | Données structurées nettoyées |
| Plateformes principales | Web |
| Prix du Web Agent | Non divulgué |
| Biens de données publiques | Ensemble de données des participants à London Tech Week 2025 |
| Prix du jeu de données | 5000 dollars |
| API publique | Aucun résultat trouvé |
| SDK officiel | Aucun résultat trouvé |
| GitHub officiel | Aucun résultat trouvé |
| Est-ce open source | Non |
Indice de recommandation
Le score de recommandation est de 3,4 sur 5. La conception de la tâche, combinant le langage naturel et JSON Schema, est claire ; les idées de code réutilisables conviennent également pour réduire les coûts liés à l’extraction repetitive de pages web.
Comme le produit est encore en phase de test, aucune information publique n’est disponible concernant les prix, la confidentialité, les conditions, les limites techniques et la stabilité. Il convient mieux d’être ajouté à la liste d’attente et testé avec des tâches peu sensibles, plutôt que d’être utilisé directement pour des projets de production importants.
Questions fréquentes
Data Donkee est-il officiellement disponible ?
Il n’est pas encore entièrement ouvert, et le bouton principal du site officiel reste celui de s’inscrire sur la liste d’attente. Aucune console de contrôle en ligne accessible directement n’a été trouvée.
Faut-il programmer ?
La positionnement du produit est qu’aucune programmation n’est requise ; les utilisateurs peuvent décrire leurs besoins en langage naturel et à l’aide de schémas. Comprendre les types de champs et la qualité des données permet néanmoins d’améliorer considérablement les résultats.
Qu’est-ce que JSON Schema ?
C’est une norme qui décrit les champs de données, leurs types, leur hiérarchie et les règles de remplissage obligatoire. Data Donkee l’utilise pour contrôler la structure des résultats de capture.
Data Donkee est-il gratuit ?
Le site officiel ne divulgue pas les quotas gratuits ni les forfaits payants pour Web Agent. S’inscrire sur la liste d’attente ne signifie pas obtenir un droit d’utilisation gratuit et permanent.
Peut-il capturer des sites web dynamiques ?
Le site officiel indique que Web Agent est conçu pour des structures dynamiques complexes, mais ne mentionne pas les capacités et limites du navigateur. Une validation doit être effectuée à l’aide d’un échantillon de petite taille du site cible.
Les résultats sont-ils toujours exacts ?
Pas nécessairement. Schema peut améliorer la cohérence du format, mais la compréhension de la page, la mise en correspondance des champs, la pertinence du contenu et les erreurs du site source continuent d’affecter les résultats.
Y a-t-il une API ?
Aucune documentation API publique ni demande de clé n’a été trouvée. Le site officiel présente un JSON Schema, ce qui ne doit pas être interprété à tort comme l’existence d’une API REST ouverte.
Data Donkee est-il open source ?
Pas de code source open source, aucun dépôt de code source officiel ou licence non détectée. Les directives pour la création d’un outil de capture ne comprennent pas non plus de documentation sur la livraison du code source.
Résumé
Data Donkee simplifie le scraping de pages web en se limitant à la description des besoins, à la définition du schéma, ainsi qu’à la génération des résultats d’extraction et de téléchargement, ce qui convient aux équipes commerciales et de données souhaitant réduire le travail manuel lié aux bots de scraping.
Le jugement le plus important pour l’instant est qu’il est encore en phase de candidature. Avant une utilisation officielle, il convient de vérifier un par un le prix, la limite, la compatibilité avec le site, la propriété du code, les documents de confidentialité et la conformité des données.
Outils similaires à Data Donkee



 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164