




ReworkdAI
@ReworkdAI, outil intelligent spécialisé dans la programmation par IA
Étiquettes :Outils de programmation IAQu’est-ce que Reworkd ?
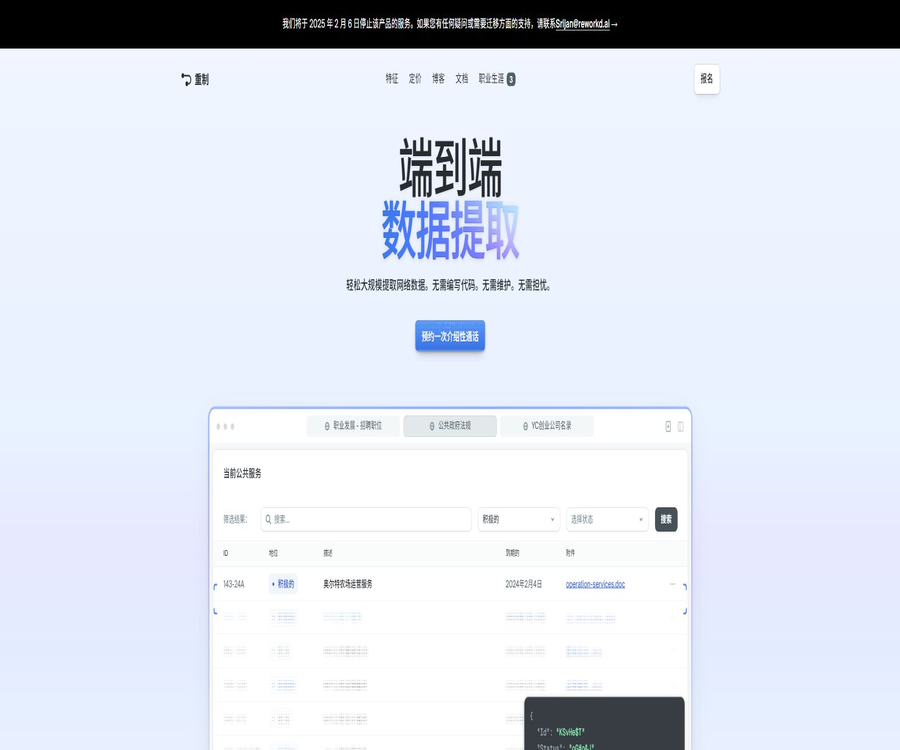
Reworkd est une plateforme d’extraction de données web par IA destinée aux entreprises et aux équipes de développement. Une fois que l’utilisateur a décrit l’objet à extraire et défini le schéma des données, l’agent comprend la structure du site, génère du code Playwright, exécute un navigateur, vérifie les résultats et enregistre les données structurées.
L’équipe a d’abord attiré l’attention grâce à l’agent open source AgentGPT, puis a déplacé son focus commercial vers le scraping de pages web pouvant être maintenu à grande échelle. AgentGPT reste accessible, mais ne doit plus être présenté comme le produit principal actuel de Reworkd.
Fonctionnalités clés
- Génération automatique de crawlers : écriture de code spécifique au site en fonction des objectifs en langage naturel et du Schema.
- Compréhension de pages multimodales : sélection des éléments en combinant la structure de la page, les captures d’écran et l’état du navigateur.
- Script d’autoréparation : détecte les problèmes en cas de modification du site ou de dysfonctionnement des sélecteurs, puis génère à nouveau le code.
- Gestion des pages dynamiques : prise en charge du clic, de l’affichage détaillé, du pagination, du défilement infini et de l’attente de chargement.
- Sortie structurée : sauvegarder les données selon le type de champ et le niveau hiérarchique.
- Exécution programmée : récupérer un ensemble de sources à une fréquence fixe.
- Suppression des doublons et mise à jour : utilisation de la clé primaire pour déterminer les enregistrements nouveaux, les doublons et ceux qui ont changé.
- Téléchargement de fichiers : accès asynchrone et enregistrement de PDF et d’autres pièces jointes.
- API et export : lecture des résultats via une clé, gestion des données de session et processus d’accès.
- Analyse des performances : visualiser les succès, les échecs, le nombre de résultats et les modifications du site.
Processus de génération de code par IA
Reworkd ne fait pas en sorte que les grands modèles devinent directement le contenu d’une page web ; au lieu de cela, il fait d’abord comprendre la page à un agent, qui génère ensuite du code d’extraction exécutable. Le code s’exécute dans un navigateur hébergé, et les résultats extraits font l’objet d’une validation via un schéma.
- charger le site cible et analyser les éléments interactifs.
- Rechercher du contenu candidat selon le schéma du champ.
- Générer le code pour la page d’accès et l’extraction des données.
- Exécutez le code et observez les événements du navigateur ainsi que les requêtes réseau.
- Vérifier que la sortie correspond au type de champ et à la structure.
- En cas d’erreur, modifiez en fonction des journaux et redéployez.
Grapin auto-réparateur
Lorsque le layout d’un site, les noms de classes ou la logique de chargement sont modifiés, les sélecteurs traditionnels peuvent retourner des valeurs vides sans avertissement. Reworkd surveille les résultats et l’état de fonctionnement, détecte les échecs et tente de générer à nouveau le code correspondant.
- Le sélecteur de détection ne trouve pas l’élément ou la sortie diminue soudainement.
- Positionner les champs correspondants en fonction de la nouvelle structure de la page.
- Générer des scripts spécifiques au site, modifiés.
- Voir les modifications concrètes via les différences de code.
- Conserver les enregistrements de fonctionnement facilite le retrait à un état antérieur et les vérifications manuelles.
- Exécuter à nouveau la validation du schéma sur la sortie réparée.
Schéma et types de données
Un schéma définit quels champs chaque ligne de données doit contenir, les types de champs et les relations imbriquées ; il sert également de base à la génération de code et à la validation des résultats. Un schéma bien conçu permet d’obtenir des résultats stables plus facilement que l’utilisation de instructions vagues.
- Utiliser des noms de champs explicites pour exprimer la signification métier réelle.
- Définir le type correct pour le prix, la date, l’URL et l’état booléen.
- Utiliser des objets et des tableaux pour représenter les variantes de produits ou une liste détaillée.
- Distinguer les champs obligatoires des champs optionnels qui peuvent être manquants.
- Évitez de mélanger plusieurs valeurs incompatibles dans un champ.
- Choisir le champ stable comme clé primaire pour éliminer les doublons.
Pagination et contenu dynamique
Le SDK officiel Harambe est utilisé pour gérer le pagination, les sauts de page, le chargement dynamique, la lecture d’HTML et le stockage des données. Les scripts générés permettent de cliquer sur la page suivante, de faire défiler la page ou d’accéder à la page détaillée pour compléter les champs.
- Cliquez sur le numéro de page ou sur « Suivant » jusqu’à ce qu’il n’y ait plus de nouveaux résultats.
- Gérer le défilement infini et le chargement différé des listes.
- Ouvrir les panneaux pliables, les onglets et les fenêtres contextuelles.
- Passer de la page de liste à la page détaillée pour collecter plus de données.
- Attendre une requête réseau ou l’apparition d’un élément spécifié.
- Utilisation de cookies et de stockage local en état de connexion.
Tâches planifiées et modèles
Les groupes de récupération peuvent être exécutés à intervalles réguliers pour assurer une surveillance continue des prix, des stocks, des postes ou des documents réglementaires. Pour les sites utilisant le même système de création de sites, les modèles permettent de réutiliser la logique de récupération, réduisant ainsi les coûts de génération de code, de tokens et de débogage.
- Définir la fréquence de exécution répétée en fonction des besoins métier.
- Ajouter les sites ayant une structure identique au même modèle.
- Examiner en détail les succès et les échecs provenant de différentes sources.
- Mettre à jour les scripts réutilisés de manière uniforme après les modifications du site.
- Éviter de générer du code à plusieurs reprises pour chaque site isomorphe.
- Suivre les fluctuations du volume de production et des sources par rapport au rapport hebdomadaire.
Élimination des doublons et suivi des modifications
Reworkd crée une vue de résultat matérialisée en fonction de la clé unique ou de la clé composite choisie par l’utilisateur. Les nouveaux enregistrements sont marqués comme créés, les nouvelles valeurs des enregistrements existants sont marquées comme mises à jour, et le contenu entièrement identique n’est pas inséré à nouveau.
- Les SKU, UPC et les IDs de page stables conviennent comme clés primaires à un seul champ.
- La marque, le modèle et la couleur peuvent être combinés en clé composite.
- Le prix, les stocks et la date de mise à jour ne conviennent pas comme clés uniques.
- Pour le même objet, des règles de clé cohérentes doivent être utilisées dans différentes sources.
- Avant de modifier la clé primaire, il convient d’évaluer si les enregistrements historiques risquent de se répéter.
- Le résultat lu par l’API est une vue matérialisée dédoublée.
Téléchargement de documents et d’annexes
Lorsque les résultats de la récupération contiennent des adresses de fichiers, Reworkd peut accéder et télécharger les pièces jointes de manière asynchrone, tout en enregistrant le type de fichier, la valeur de vérification, l’adresse d’origine et les informations de stockage. Cette fonctionnalité convient aux annonces réglementaires, aux documents d’appel d’offres et aux manuels produits.
- Téléchargez les PDF, les documents et d’autres pièces jointes fournies sur les pages web.
- Enregistrer la source originale et le nom du fichier.
- Utiliser des valeurs de vérification pour identifier les fichiers dupliqués ou modifiés.
- Associer la tâche de téléchargement à la ligne de données correspondante.
- Effectuer un téléchargement via le navigateur pour les fichiers générés dynamiquement ou nécessitant un clic.
- Continuer à traiter les fichiers enregistrés via l’API.
API et compétences des développeurs
L’organisation peut créer une clé API pour lire les résultats des groupes de capture et l’état de fonctionnement depuis des systèmes externes. La documentation publique fournit également des interfaces relatives aux cookies, au stockage local, à l’état de la censure et au traitement de fichiers.
- Obtenir les résultats dédoublés du groupe de crawling spécifié.
- Vérifier l’état et les commentaires de la révision manuelle les plus récents.
- Lire ou définir les cookies du navigateur.
- Lire ou définir le stockage local du navigateur.
- Télécharger les données par export en masse.
- Générer un client à l’aide de spécifications d’interfaces ouvertes.
- Intégrer les résultats dans une base de données, pour des analyses ou le entraînement de modèles.
Débogage du navigateur et observabilité
La plateforme propose un traceur de navigateur unifié, qui regroupe les événements de Reworkd et de Playwright, les journaux de la console, les activités réseau ainsi que les événements des protocoles de navigateur dans une même vue. Les différences de code intégré permettent de comparer les ajouts et suppressions avant et après la correction.
- Délai de chargement de la page dépassé et ressources bloquées.
- Vérifier les erreurs de script dans la console.
- Vérifier les requêtes réseau, les codes d’état et les changements de réponse.
- Comparer le code d’extraction ancien et nouveau de l’agent.
- Déterminer si la baisse de la sortie provient d’un changement de page ou d’une panne de fonctionnement.
- Voir l’état des tâches et le nombre de résultats en temps réel.
À qui s’adresse-t-il
- Équipe e-commerce : surveillance des produits, des prix, des stocks et des avis.
- Équipe de recherche de marché : rassemble des informations sur les entreprises, le secteur et la concurrence.
- Plateforme de recrutement et de talents : collecte des offres d’emploi publiques et des informations sur les entreprises.
- Équipes financières et d’achats : suivi des annonces, des appels d’offres et des documents réglementaires.
- Équipe d’IA : Création des ensembles de données pour l’entraînement, le fine-tuning et RAG.
- Équipe d’ingénierie des données : remplacement de nombreux scripts spécifiques aux sites fragiles.
- Start-up : Mettre en place rapidement des pipelines en l’absence d’ingénieurs spécialisés en scraping.
Scénarios d’application typiques
- Synchroniser quotidiennement les prix et la disponibilité des produits sur plusieurs boutiques en ligne.
- Extraire les noms, le secteur d’activité, l’équipe et les coordonnées à partir du répertoire de l’entreprise.
- Téléchargez les réglementations nouvellement ajoutées et les annexes de consultation publiée sur le site du gouvernement.
- Récupérer la liste des postes et accéder à la page détaillée pour ajouter des exigences.
- Suivre en continu les changements dans la liste des biens immobiliers, des véhicules ou des voyages.
- Préparer des millions de lignes de données de pages web publiques pour le modèle de domaine.
- Suivi des adresses des sites web, des descriptions des services et des mises à jour de l’état d’exploitation.
Avantages du produit
- Processus complet de capture allant de la demande, à la génération de code, à l’exécution, jusqu’à la correction.
- L’extraction par code est plus facile à valider et à reproduire que de laisser le modèle générer directement des données.
- Navigateur hébergé intégré, proxy, traitement des codes de vérification et planification.
- Prend en charge le pagination, le contenu dynamique, les pages de détail et le téléchargement de fichiers.
- Les mécanismes de suppression des doublons et de mise à jour conviennent au suivi à long terme des données.
- Fournit une API, des spécifications d’interfaces ouvertes et un SDK Harambe open source.
- Trace et Diff de code aident à localiser les problèmes en production.
Restrictions d'utilisation
- La génération automatique de code peut encore omettre des pages limites ou des champs erronés.
- La lutte contre les bots sur le site, la connexion, les restrictions géographiques et les codes de vérification augmentent les coûts.
- Après réparation automatique, il faut vérifier si la sémantique correspond toujours au champ d’origine.
- La récupération de pages web publiques peut également être soumise à des restrictions liées aux conditions d’utilisation, aux droits d’auteur et aux droits de base de données.
- Une forte concurrence augmente les coûts liés aux navigateurs, aux proxies, au trafic et aux codes de vérification.
- Lorsque la structure du site diffère fortement, le réutilisation des modèles a un effet limité.
- La page officielle conserve des bannières obsolètes et désactivées, et les informations sur les produits ne sont pas toujours mises à jour de manière cohérente.
- Il reste nécessaire de procéder à un échantillonnage des données clés et de vérifier les règles métier.
Forfait d’abonnement
La page de tarification publique liste actuellement les trois niveaux Hobby, Pro et Enterprise. La page conserve également un bandeau obsolète indiquant la désactivation d’un ancien produit, mais l’accès à la plateforme nouvelle, à la page d’état, aux documents ainsi qu’aux mises à jour ultérieures reste possible ; il convient de vérifier auprès des autorités le cycle de service en vigueur avant d’acheter.
| forfait | Frais mensuels | Navigateur concurrent | Conservation des données | Explication principale |
|---|---|---|---|---|
| Hobby | 0 dollar | 10 | 30 jours | Accès API, adapté aux tests et aux tâches à petite échelle |
| Pro | 99 dollars | 50 | 90 jours | Traitement des codes de vérification, tâches planifiées et hébergement complet |
| Enterprise | sur mesure | sur mesure | sur mesure | Une échelle plus importante, un support dédié et des capacités contractuelles |
Prix de l'utilisation des infrastructures
En plus de la cotisation d’abonnement, la plateforme facture également en fonction de la consommation réelle d’infrastructure. Les prix unitaires standard affichés sur la page publique sont les suivants ; les solutions professionnelles peuvent être personnalisées selon le contrat.
| Éléments de facturation | Hobby | Pro | Enterprise |
|---|---|---|---|
| Limite de base ou frais de plateforme | 10 dollars | 49 dollars/mois | sur mesure |
| Trafic d’agent standard | 0,125 dollar/GB | 0,125 dollar/GB | sur mesure |
| Trafic d’agent avancé | 8 $/GB | 8 $/GB | sur mesure |
| Calcul du navigateur | 0,10 dollar de l’heure | 0,10 dollar de l’heure | sur mesure |
| Vérification anti-robot | 5 $/1000 fois | 5 $/1000 fois | sur mesure |
Les résultats extraits de la page de tarification ne montrent pas complètement l’étiquette du champ correspondant au premier coût d’infrastructure ; par conséquent, il ne doit pas être additionné directement aux frais de abonnement pour former un montant mensuel fixe. Avant le règlement, il convient de vérifier dans le compte le crédit gratuit, le montant minimum d’achat et les noms des différentes quantités consommées.
Comment créer le premier extracteur
- Inscrivez-vous à Reworkd et créez un nouveau groupe de capture.
- Saisissez le site cible et les indications relatives aux données à collecter.
- Définir les noms des champs, leurs types, les relations imbriquées et les options facultatives.
- Choisissez une clé de dédoublonnage stable et unique.
- Laissez l’agent scanner la page et générer la première version du code de capture.
- Voir le navigateur en fonctionnement et vérifier la pagination, les clics et la page des détails.
- Vérifier ligne par ligne si la sortie correspond au texte original de la page.
- Indiquez les champs manquants ou les interactions spéciales par le biais d’un chat.
- Vérifiez plusieurs pages avant de les enregistrer et d’activer le planification.
Comment mettre en ligne un pipeline de données à long terme
- Vérifier les modes et fréquences d’accès autorisés pour le site cible.
- Préparez des échantillons de résultats normaux, vides, de mise en page anormale et de pages d’erreur.
- Définir les tentatives de réessai, les délais d’attente, les limites de vitesse et le plafond de concurrence.
- Configurer une clé primaire stable et tester l’ajout et la mise à jour de records.
- Utiliser une API pour écrire les résultats dans une zone de stockage temporaire plutôt que d’écraser directement les données de production.
- Créer des alertes pour le taux de complétude des champs, le volume de sortie et le taux d’échec.
- Vérification manuelle des différences de code après auto-réparation et des résultats d’échantillons.
- Enregistrer les modèles de fichiers, le code et les versions du schéma.
- Évaluer mensuellement les coûts d’agence, de calcul, de codes de vérification et de stockage.
Recommandations sur la qualité des données
- Enregistrer l’adresse originale de la page avec chaque ligne de résultats.
- Ajouter une validation de format et de plage pour les prix et les dates.
- Surveiller les augmentations ou diminutions soudaines du volume de production quotidien.
- Créer des échantillons de test distincts pour les différents types de pages.
- Comparer régulièrement les résultats de la capture avec des captures d’écran de la page.
- Vérifier à nouveau la sémantique des champs après les modifications du site.
- Ne confondez pas un fonctionnement correct avec des données parfaitement exactes.
Considérations juridiques et de conformité
Les entreprises doivent elles-mêmes vérifier les conditions du site cible, les règles robots, les droits d’auteur, les droits sur les bases de données, la réglementation sur la vie privée et les autorisations d’accès. Les données pouvant être lues par la technologie ne peuvent pas nécessairement être librement copiées, rééditées ou utilisées à des fins d’entraînement commercial.
- Privilégiez l’utilisation d’API publiques ou obtenez l’autorisation du propriétaire des données.
- Ne pas contourner les connexions, les barrières de paiement et le contrôle d’accès pour obtenir du contenu non autorisé.
- Restreindre la collecte d’informations personnelles et sensibles.
- Respecter les exigences de fréquence d’accès au site cible.
- Conserver la source des données, la date de collecte et le processus de suppression.
- Vérifier séparément la portée de la licence pour l’entraînement des modèles.
GitHub et l’état open source
Reworkd a rendu publics sur GitHub les projets AgentGPT, Harambe, Tarsier et Bananalyzer, mais l’ensemble des proxies, de l’infrastructure d’hébergement et des services d’autoréparation de la plateforme de récupération de données web commerciale ne sont pas des produits open source.
| Projet | État ou licence | Utilisation |
|---|---|---|
| Plateforme commerciale retravaillée | SaaS fermé | Prise en charge du scraping de pages web et auto-réparation |
| AgentGPT | GPL 3.0 | Agent IA autonome universel dans le navigateur |
| Harambe | Projets officiels publics | SDK d’extraction de pages web et primitives de capture |
| Tarsier | Projets officiels publics | Outil de perception visuelle pour les agents d’interaction web |
| Bananalyzer | Projets officiels publics | Framework d’évaluation et ensemble de données pour les agents IA de tâches web |
| perplexity-style-streaming | Exemple officiel public | Interface fluide et expérimentations de développement |
Différences entre AgentGPT et le Reworkd actuel
| Élément de comparaison | AgentGPT | Reworkd actuel |
|---|---|---|
| Positionnement | Expérience d’agents IA autonomes généraux | Plateforme d’extraction de données de sites web d’entreprise |
| Entrée | Nom et objectifs d’ouverture | Site web, cible de crawling et Schema |
| Sortie | Processus de réflexion et d’exécution de la tâche | Données de page web structurées vérifiables |
| Mode de fonctionnement | Application web open source | Navigateur de gestion, API et planification |
| Entretien | Modèle de gestion des utilisateurs et déploiement | La plateforme détecte et corrige les scripts de capture. |
| Axes commerciaux | Ce n’est plus l’activité principale | Produits phares actuels |
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Reworkd |
| Société de développement | Reworkd AI, Inc. |
| Type d’outil | Extraction de pages web par l’IA, extraction de données structurées, bots auto-réparateurs |
| Technologie clé | Génération de code multimodal, Playwright et SDK Harambe |
| Modèle de prix | Gratuit et abonnement + frais d’utilisation de l’infrastructure |
| Accès API | Soutien |
| Tâche planifiée | Soutien |
| Statut open source | Les plateformes commerciales sont fermées ; les outils tels qu’AgentGPT sont open source |
Indice de recommandation
4,5 / 5. Reworkd convient aux entreprises et équipes de données qui doivent gérer un grand nombre de crawlers de sites ; la génération de code, l’autoréparation, la suppression des doublons et l’observabilité forment un pipeline assez complet ; cependant, les coûts d’utilisation, les limites juridiques et la cohérence des informations sur le site officiel doivent être soigneusement évalués.
Questions fréquentes
Que fait Reworkd principalement maintenant ?
L’objectif principal actuel est de permettre à l’IA de générer et de gérer du code de capture de pages web, afin de transformer les sites dynamiques et leurs fichiers joints en données structurées.
Quelle est la relation entre Reworkd et AgentGPT ?
AgentGPT était le projet de proxy général open source initial de l’équipe Reworkd ; la version commerciale actuelle est désormais axée sur l’extraction de données de pages web.
Faut-il écrire soi-même du code de spider ?
En général, ce n’est pas nécessaire ; le proxy génère le code une fois que l’utilisateur a défini les objectifs et le schéma, mais les sites complexes peuvent encore nécessiter une assistance par chat et un débogage manuel.
Le site sera-t-il automatiquement corrigé après la mise à jour ?
La plateforme détectera l’échec et tentera de générer à nouveau le code, mais la sémantique des champs corrigés et l’exactitude des données doivent encore être vérifiées.
Reworkd propose-t-il un forfait gratuit ?
Oui, Hobby coûte 0 dollar par mois et les informations publiées indiquent 10 navigateurs en parallèle, une conservation de 30 jours et un accès à l’API.
Combien coûte le forfait Pro ?
Le prix public est de 99 dollars par mois, incluant 50 navigateurs en parallèle et un archivage des données sur 90 jours, ainsi que la gestion des tâches planifiées et des codes de vérification.
Les frais d’infrastructure sont-ils facturés séparément ?
Oui, des services tels que le trafic proxy, le calcul par navigateur et la vérification anti-robot sont facturés selon l’utilisation ; il convient de vérifier le quota gratuit avant le règlement du compte.
Est-il possible de télécharger un fichier PDF en pièce jointe ?
Oui, la plateforme prend en charge le téléchargement asynchrone de fichiers et conserve l’origine, le type de fichier et les informations de vérification.
Reworkd propose-t-il une API ?
Fournit une sortie lisible sans doublons, gère les cookies et le stockage local, et permet d’accéder via des spécifications d’interfaces ouvertes.
Est-ce que Reworkd est open source ?
Les plateformes commerciales ne sont pas open source, mais des projets officiels tels qu’AgentGPT, Harambe, Tarsier et Bananalyzer sont publiés.
Outils similaires à ReworkdAI



 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164