




ReworkdAI
@ReworkdAI, intelligente Werkzeuge für die AI-Programmierung
Tags:AI-ProgrammierwerkzeugeWas ist Reworkd?
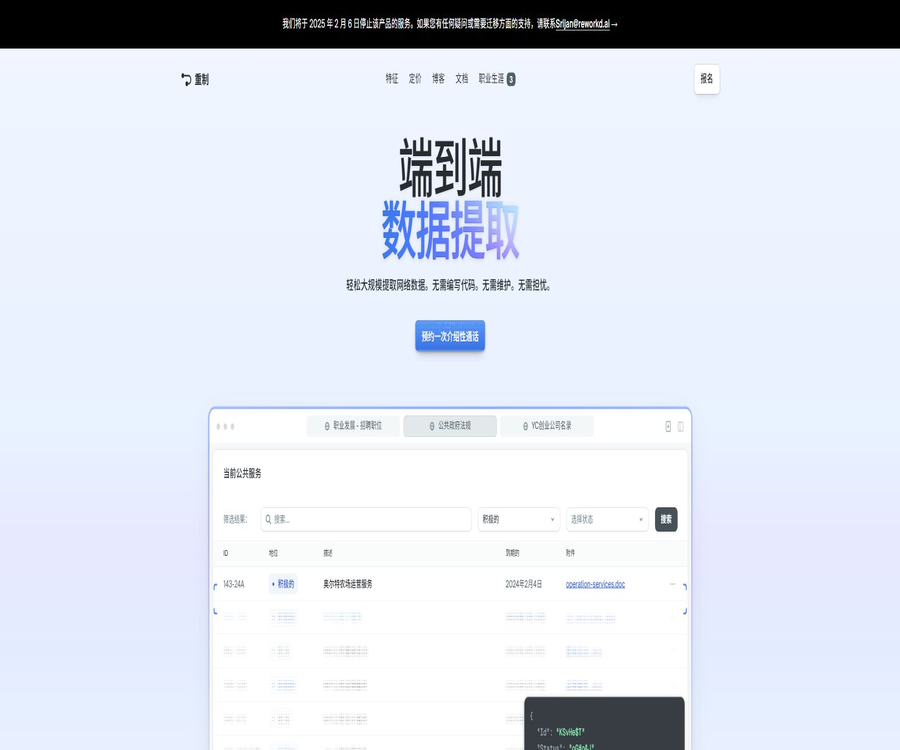
Reworkd ist eine KI-basierte Plattform zur Extraktion von Webdaten, die sich an Unternehmen und Entwicklerteams richtet. Nachdem der Benutzer das Ziel der Datenerfassung beschrieben und das Daten-Schema definiert hat, versteht der Agent die Struktur der Website, generiert Playwright-Code, startet den Browser, überprüft die Ergebnisse und speichert die strukturierten Daten.
Das Team erregte ursprünglich Aufmerksamkeit durch den Open-Source-AgentGPT, wandte seine Geschäftstätigkeit später jedoch auf skalierbar zu wartende Web-Crawling-Lösungen um. AgentGPT ist weiterhin zugänglich, sollte aber nicht mehr als Hauptprodukt von Reworkd dargestellt werden.
Kernfunktionen
- Automatische Erstellung von Scrapern: Schreiben von speziellen Code-Teilen für die Website auf der Grundlage von Zielen in natürlicher Sprache und des Schemas.
- Multimodales Seitenverständnis: Auswahl von Elementen unter Berücksichtigung der Seitenstruktur, von Screenshot-Aufnahmen und des Browserzustands.
- Selbstheilender Script: Erkennnt Probleme bei Änderungen der Website oder bei fehlerhaften Selektoren und erzeugt den Code neu.
- Verarbeitung dynamischer Webseiten: Unterstützung für Klicken, Ausklappen, Seitenwechsel, unbegrenztes Scrollen und Warten auf Ladevorgänge.
- Strukturierte Ausgabe: Die Daten werden nach Feldtyp und Hierarchie gespeichert.
- Regelmäßige Ausführung: Wiederholte Abfrage einer Gruppe von Quellen zu einer festen Frequenz.
- Doppelte Einträge entfernen und aktualisieren: Mit der Primärschlüssel wird festgestellt, ob es sich um neue, doppelte oder veränderte Einträge handelt.
- Dateiherunterladen: Asynchrone Zugriffsmöglichkeit zur Speicherung von PDFs und anderen Anhängen.
- API und Export: Ergebnisse über Schlüssel abrufen, Sitzungsdaten verwalten und Anmeldeprozesse steuern.
- Ausführungsanalyse: Überprüfung von Erfolgen, Fehlern, Anzahl der Ausgaben und Änderungen auf der Website.
Prozess der Erstellung von AI-Code
Reworkd lässt große Modelle nicht direkt den Inhalt einer Webseite erraten, sondern lässt zunächst einen Agenten die Seite verstehen, um anschließend ausführbaren Scraping-Code zu erzeugen. Der Code wird in einem Hosted-Browser ausgeführt, und die extrahierten Ergebnisse werden zudem mit einem Schema überprüft.
- Laden Sie die Ziel-Website und analysieren Sie die interaktiven Elemente.
- Suchen Sie nach geeigneten Inhalten anhand des Feldschemas.
- Erstellen Sie Code zur Erstellung von Zugriffsseiten und zum Extrahieren von Daten.
- Führen Sie den Code aus und beobachten Sie die Browser-Ereignisse sowie die Netzwerkanfragen.
- Überprüfen Sie, ob die Ausgabe dem Feldtyp und der Struktur entspricht.
- Bei Fehlern werden die Einstellungen anhand des Logs geändert und neu bereitgestellt.
Selbstheilender Greifer
Nach Anpassungen der Seitenstruktur, der Klassennamen oder der Ladelogik können herkömmliche Selektoren ohne Warnung leere Werte zurückgeben. Reworkd überwacht die Ergebnisse und den Betriebszustand, erkennt Fehler und versucht, den entsprechenden Code neu zu generieren.
- Der Selektor findet das Element nicht oder die Ausgabe sinkt plötzlich.
- Positionieren Sie die entsprechenden Felder unter Berücksichtigung der neuen Seitenstruktur.
- Erstellen Sie einen angepassten, für die Website speziellen Script.
- Über die Codeunterschiede können die konkreten Änderungen eingesehen werden.
- Die Beibehaltung von Betriebsprotokollen erleichtert den Rückgriff auf frühere Zustände sowie manuelle Überprüfungen.
- Führen Sie die Schema-Validierung erneut auf der reparierten Ausgabe durch.
Schema und Datentypen
Ein Schema definiert, welche Felder in jeder Datenspur enthalten sein sollen, welche Feldtypen verwendet werden und welche Verhältnisse zwischen den Feldern bestehen. Es dient außerdem als Grundlage für die Erstellung von Code sowie zur Überprüfung der Ergebnisse. Ein klar strukturiertes Schema führt zu stabileren Ergebnissen als allgemeine Anweisungen.
- Verwenden Sie klare Feldnamen, um die tatsächliche Geschäftsbedeutung auszudrücken.
- Setzen Sie die richtigen Typen für Preis, Datum, Webadresse und booleschen Zustand.
- Verwenden Sie Objekte und Arrays, um Varianten oder Listen von Produktdetails darzustellen.
- Unterscheiden Sie zwischen Pflichtfeldern und optionalen Feldern, die fehlen können.
- Vermeiden Sie es, in einem Feld mehrere inkompatible Werte zu mischen.
- Wählen Sie ein stabiles Feld als Primäschlüssel zur Entdupplikation aus.
Seiteneinteilung und dynamischer Inhalt
Das offizielle Harambe-Grabbing-SDK wird zur Verarbeitung von Seitenroutierung, Seitenwechseln, dynamischer Laden, HTML-Lesung und Datenspeicherung verwendet. Die erzeugten Skripte ermöglichen es, zur nächsten Seite zu gehen, die Seite zu scrollen oder zur Detailseite zu wechseln, um zusätzliche Felder einzufügen.
- Klicken Sie auf die Seitennummer oder „Nächste Seite“, bis keine neuen Ergebnisse mehr angezeigt werden.
- Umgang mit unbegrenztem Scrollen und verzögertem Laden von Listen.
- Öffnen Sie Faltschienen, Tabellen und Pop-up-Fenster.
- Gehe von der Liste-Seite zur Details-Seite, um weitere Daten zu sammeln.
- Warten auf eine Netzwerkanfrage oder das Erscheinen des angegebenen Elements.
- Verwendung von Cookies und lokalem Speicher im angemeldeten Zustand.
Zeitgesteuerte Aufgaben und Vorlagen
Die Scraping-Gruppen können in festen Intervallen erneut ausgeführt werden, um Preise, Lagerbestände, Stellenangebote oder regulatorische Dokumente kontinuierlich zu überwachen. Für Websites, die dasselbe Website-System verwenden, kann die Scraping-Logik wiederverwendet werden, wodurch die Kosten für die Erstellung von Code sowie für die Fehlerbehebung reduziert werden.
- Legen Sie die Häufigkeit der wiederholten Ausführung entsprechend den Geschäftsanforderungen fest.
- Websites mit derselben Struktur in dasselbe Template aufnehmen.
- Konzentriert sich auf die Erfolge und Misserfolge aus verschiedenen Quellen.
- Nach Änderungen der Website werden die Skripte einheitlich aktualisiert und wiederverwendet.
- Vermeiden Sie es, für jede isomere Website Code mehrfach zu erstellen.
- Verfolgen Sie mit wöchentlichen Berichten die Schwankungen in der Menge und den Quellen.
Doppelte Einträge entfernen und Änderungen verfolgen
Reworkd erstellt eine materialisierte Ergebnisansicht basierend auf der vom Benutzer gewählten eindeutigen Schlüssel- oder Kombinationsschlüssel. Neue Einträge werden als erstellt markiert, neue Werte für bestehende Einträge als aktualisiert, und vollständig identische Inhalte werden nicht erneut eingefügt.
- SKU, UPC und die stabile Seite-ID eignen sich als Primärschlüssel mit einem Feld.
- Marken, Modelle und Farben können zu Kombinationsschlüsseln zusammengefügt werden.
- Preise, Lagerbestände und Aktualisierungszeiten eignen sich nicht als einzige Schlüssel.
- Für dasselbe Objekt sollten in verschiedenen Quellen einheitliche Schlüsselregeln angewandt werden.
- Bevor die Primärschlüssel geändert werden, sollte geprüft werden, ob es zu Doppelungen in den historischen Datensätzen kommen kann.
- Das von der API ausgelesene Ergebnis ist eine materialisierte Ansicht, aus der die Duplikate bereits entfernt wurden.
Dateien und Anhänge herunterladen
Wenn die Ergebnisse der Extraktion eine Datei-Adresse enthalten, kann Reworkd diese asynchron abrufen und herunterladen. Gleichzeitig werden die Dateityp, die Prüfsumme, die Quelladresse sowie weitere Speicherinformationen gespeichert. Diese Funktion eignet sich besonders für regulatorische Mitteilungen, Ausschreibungsunterlagen und Produkthandbücher.
- Laden Sie PDFs, Dokumente sowie weitere Anhänge herunter, die auf Webseiten bereitgestellt werden.
- Notieren Sie die ursprüngliche Quelle und den Dateinamen.
- Verwenden Sie Prüfwerte, um wiederholte oder veränderte Dateien zu erkennen.
- Verknüpfen Sie die Download-Aufgaben mit den entsprechenden Datensätzen.
- Führen Sie einen Browser-Download für dynamisch generierte oder klickbare Dateien durch.
- Weiterverarbeitung der gespeicherten Dateien über die API.
APIs und Entwicklerfähigkeiten
Organisationen können API-Schlüssel erstellen, um die Ausgaben der Scraping-Gruppen sowie den Betriebszustand aus externen Systemen abzurufen. Die offiziellen Dokumentationen bieten zudem Schnittstellen für Cookies, lokalen Speicher, den Überprüfungsstatus sowie die Verarbeitung von Dateien.
- Erhalten Sie die deduplizierten Ergebnisse für die angegebene Crawling-Gruppe.
- Erfahren Sie den neuesten Status der manuellen Überprüfung und die Kommentare.
- Lesen oder setzen von Browser-Cookies.
- Lesen oder Setzen der lokalen Speicherung des Browsers.
- Daten durch Massenexport herunterladen.
- Klienten werden mithilfe von offenen Schnittstellenspezifikationen erstellt.
- Die Ergebnisse werden in eine Datenbank eingefügt oder für Analyse- oder Modelltrainingsprozesse genutzt.
Browser-Debugging und Observabilität
Die Plattform bietet einen einheitlichen Browser-Trace, der Reworkd mit Playwright-Ereignissen, Konsole-Protokollen, Netzwerkaktivitäten sowie Browserprotokollereignissen in derselben Ansicht zusammenführt. Unterschiede im eingebetteten Code können hinsichtlich der hinzugefügten und entfernten Elemente vor und nach der Korrektur verglichen werden.
- Zeitüberschreitung bei der Ladeung der Seiten und blockierte Ressourcen.
- Überprüfen Sie die Skriptfehler in der Konsole.
- Überprüfen Sie die Netzwerkanfragen, Statuscodes und Änderungen in den Antworten.
- Vergleich des alten und neuen Crawling-Codes des Proxies.
- Ermitteln, ob der Rückgang der Ausgabe auf Änderungen auf der Seite oder auf Betriebsfehler zurückzuführen ist.
- Über den Echtzeit-Stream können Sie den Status der Aufgaben sowie die Anzahl der Ausgaben einsehen.
Für welche Benutzer geeignet
- E-Commerce-Team: Überwachung von Produkten, Preisen, Lagerbeständen und Bewertungen.
- Marktforschungsteam: Sammelt Informationen über Unternehmen, Branchen und Wettbewerber.
- Stellensuch- und Talentplattform: Sammlung öffentlicher Stellenangebote und Unternehmensinformationen.
- Finanz- und Einkaufsteam: Überwachung von Bekanntmachungen, Ausschreibungen und regulatorischen Dokumenten.
- AI-Team: Erstellung von Trainings-, Feinabstimmungs- und RAG-Datensätzen.
- Dateneingabeteam: Ersatz für zahlreiche anfällige, spezielle Skripte für einzelne Sites.
- Start-ups: Schnelle Einrichtung von Pipelines ohne fest angestellte Entwickler für Crawlers.
Typische Anwendungsfallen
- Täglich werden die Preise und der Verfügbarkeitsstatus der Produkte in mehreren Shops synchronisiert.
- Aus dem Firmenverzeichnis Namen, Branche, Team und Kontaktdaten extrahieren.
- Laden Sie die auf der Regierungswebsite neu hinzugefügten Vorschriften sowie die Anhänge zu den Ausschreibungen herunter.
- Sammeln Sie die Stellenausweise und gehen Sie auf die Detailseite, um weitere Anforderungen hinzuzufügen.
- Ständige Überwachung der Änderungen in den Listen für Immobilien, Fahrzeuge oder Reisen.
- Millionen von Zeilen an öffentlichen Webdaten für das Domänenmodell bereitstellen.
- Überwachung der Website-Adressen, Servicebeschreibungen und Aktualisierungen des Betriebszustands.
Vorteile des Produkts
- Vom Bedarf über die Codegenerierung, den Betrieb bis hin zur vollständigen Abdeckung des Fehlerbehebungsprozesses.
- Die extraktive Kodierung ist leichter zu überprüfen und zu reproduzieren als das direkte Erzeugen von Daten durch das Modell.
- Integrierter Hosted-Browser, Proxy, Verifizierungscode-Verarbeitung und Scheduling.
- Unterstützung von Seitenlayout, dynamischem Inhalt, Detailseiten und Dateiherunterladen.
- Mechanismen zur Entdoppelung und Aktualisierung eignen sich für die langfristige Überwachung von Daten.
- APIs, offene Schnittstellenspezifikationen und ein Open-Source-Harambe SDK werden bereitgestellt.
- Trace und Code-Diff helfen dabei, Probleme in der Produktion zu identifizieren.
Nutzungsbeschränkungen
- Die automatische Erstellung von Code kann trotzdem Seiten an den Rändern oder fehlerhafte Felder übersehen.
- Webseiten gegen Scraping, Anmeldungen, geografische Beschränkungen und Verifizierungscode erhöhen die Kosten.
- Nach der Selbstreparatur muss überprüft werden, ob die Semantik weiterhin der ursprünglichen Felder entspricht.
- Das Abrufen öffentlicher Webseiten kann ebenfalls durch Bedingungen, Urheberrechte und Datenbankrechte eingeschränkt sein.
- Hohe Konkurrenz führt zu höheren Kosten für Browser, Proxy-Server, Datenverkehr und Verifizierungscode.
- Bei großen Unterschieden in der Struktur der Website ist die Wiederverwendung von Vorlagen eingeschränkt.
- Die offizielle Seite behält veraltete, nicht mehr genutzte Bannereinblendungen bei, und die Produktinformationen sind nicht vollständig konsistent.
- Für die Schlüsseldaten sind weiterhin Stichprobenentnahmen sowie Überprüfungen nach Geschäftsregeln erforderlich.
Abonnementspaket
Auf der offiziellen Preisseite sind derzeit die Versionen Hobby, Pro und Enterprise aufgeführt. Auf der Seite ist außerdem ein veralteter Banner für eingestellte Produkte zu sehen, doch der Zugang zur neuen Plattform, zur Statusseite, zu den Dokumenten sowie zu zukünftigen Updates bleibt weiterhin möglich. Vor dem Kauf sollte man bei den Behörden nachfragen, wie lange der aktuelle Servicevertrag gültig ist.
| Paket | Monatsgebühr | Konkurrierende Browser | Datenhaltung | Haupterklärung |
|---|---|---|---|---|
| Hobby | 0 US-Dollar | 10 Stück | 30 Tage | API-Zugriff, geeignet für Tests und kleine Aufgaben |
| Pro | 99 Dollar | 50 Stück | 90 Tage | Verifizierungscode-Verarbeitung, Zeitplanung von Aufgaben und vollständige Verwaltung |
| Enterprise | Maßanfertigung | Maßanfertigung | Maßanfertigung | Höheres Maß an Skalierung, exklusiver Support und Vertragsmöglichkeiten |
Kosten für den Einsatz von Infrastruktur
Neben der Abonnementgebühr berechnet die Plattform auch Kosten nach dem tatsächlichen Verbrauch der Infrastruktur. Auf der öffentlichen Seite werden derzeit die üblichen Preise angezeigt; für Unternehmenslösungen können die Preise im Rahmen eines Vertrags individuell festgelegt werden.
| Abrechnungsposten | Hobby | Pro | Enterprise |
|---|---|---|---|
| Grundbetrag oder Gebühren der Plattform | 10 Dollar | 49 Dollar pro Monat | Maßanfertigung |
| Standard-Proxy-Datenverkehr | 0,125 US-Dollar/GB | 0,125 US-Dollar/GB | Maßanfertigung |
| Hochrangiger Agentenverkehr | 8 Dollar/GB | 8 Dollar/GB | Maßanfertigung |
| Browser-Berechnung | 0,10 US-Dollar/Stunde | 0,10 US-Dollar/Stunde | Maßanfertigung |
| Anti-Roboter-Verifizierung | 5 Dollar/1000 Mal | 5 Dollar/1000 Mal | Maßanfertigung |
Auf der Preisseite werden die Feldbezeichnungen für die ersten Infrastrukturkosten nicht vollständig angezeigt. Daher sollten sie nicht direkt zur Monatsgebühr hinzugerechnet werden. Vor der Abrechnung sollten im Konto die kostenlosen Leistungen, die Mindestausgaben sowie die Bezeichnungen der verschiedenen Verbrauchswerte überprüft werden.
Wie erstellt man den ersten Scraper?
- Registrieren Sie Reworkd und erstellen Sie eine neue Crawling-Gruppe.
- Geben Sie die Ziel-Website sowie eine Beschreibung der zu sammelnden Daten ein.
- Definieren Sie die Feldnamen, Typen, Nestungsbeziehungen und Optionen.
- Wählen Sie einen stabilen und eindeutigen Schlüssel zur Deduplizierung.
- Lassen Sie den Agenten die Seite scannen und die erste Version des Crawling-Codes erstellen.
- Beobachten Sie, wie der Browser läuft, und überprüfen Sie die Seitenlayout, Klicks sowie die Detailseiten.
- Überprüfen Sie Zeile für Zeile, ob die Ausgabe mit dem Originaltext der Seite übereinstimmt.
- Erklären Sie über das Chat-Fenster fehlende Felder oder spezielle Interaktionen.
- Überprüfen Sie mehrere Seiten, bevor Sie speichern und die Scheduling-Funktion aktivieren.
Wie man langfristige Datensysteme online bringt
- Überprüfen Sie, welche Zugriffsweisen und -häufigkeiten auf der Zielwebsite erlaubt sind.
- Erstellen Sie Beispiele für normale Ergebnisse, leere Ergebnisse, abweichende Layouts und Fehlerseiten.
- Einstellen von Wiederholungsversuchen, Zeitüberschreitungen, Geschwindigkeitsbeschränkungen und Obergrenzen für die Konkurrenz.
- Konfigurieren Sie eine stabile Primärschlüssel und testen Sie das Hinzufügen sowie Aktualisieren von Datensätzen.
- Verwenden Sie die API, um die Ergebnisse in einen Zwischenspeicher zu schreiben, anstatt die Produktionsdaten direkt zu überschreiben.
- Erstellen von Alarmen für die Vollständigkeit der Felder, die Ausgabeanzahl und die Fehlerrate.
- Manuelle Überprüfung der nach der Selbstreparatur unterschiedlichen Codeversionen und der Ergebnisse der Beispiele.
- Protokollvorlagen, Code und Schema-Versionen.
- Bewerten Sie monatlich die Kosten für Agenten, Berechnungen, Verifizierungscodes und Speicherung.
Empfehlungen zur Datenqualität
- Speichern Sie die ursprüngliche Seite-Adresse zusammen mit jedem Ergebniszeile.
- Hinzufügen von Format- und Bereichskontrollen für Preis und Datum.
- Überwachen Sie plötzliche Anstiege oder Abfälle der täglichen Ausgabe.
- Für verschiedene Seitenarten werden separate Testbeispiele erstellt.
- Vergleichen Sie regelmäßig die Ergebnisse der Extraktion mit Screenshoten der Seiten.
- Nach Änderungen der Website wird die Semantik der Felder erneut überprüft.
- Verwechseln Sie einen erfolgreichen Ablauf nicht mit vollständig korrekten Daten.
Rechtliche und regulatorische Aspekte
Unternehmen müssen selbst die Bedingungen der Zielwebseiten, die Robots-Regeln, Urheberrechte, Rechte an Datenbanken, Datenschutzvorschriften sowie Zugriffsrechte prüfen. Daten, die technisch gelesen werden können, dürfen nicht notwendigerweise frei kopiert, weiterveröffentlicht oder für kommerzielle Zwecke genutzt werden.
- Verwenden Sie vorrangig offene APIs oder holen Sie die Genehmigung des Datenbesitzers ein.
- Kein Umgehen von Anmeldungen, Paywalls und Zugriffskontrollen zur Erlangung nicht autorisierter Inhalte.
- Einschränkung der Erfassung von persönlichen und sensiblen Daten.
- Befolgen Sie die Anforderungen bezüglich der Häufigkeit des Besuchs der Zielwebseite.
- Beibehalten der Datenquellen, der Erhebungszeit sowie des Löschprozesses.
- Prüfen Sie die Lizenzbedingungen gesondert für den Einsatz beim Modelltraining.
GitHub und der Open-Source-Zustand
Reworkd hat die auf GitHub veröffentlichten Projekte AgentGPT, Harambe, Tarsier und Bananalyzer offiziell überarbeitet, doch die vollständige Proxy-Infrastruktur, die Hosting-Infrastruktur sowie die Selbstreparaturdienste für Plattformen zum Scraping von Geschäftswebseiten sind keine Open-Source-Produkte.
| Projekt | Status oder Lizenz | Verwendung |
|---|---|---|
| Überarbeitete Geschäftsplattform | Closed-Source-SaaS | Verwaltung von Web-Scrapping und Selbstreparatur |
| AgentGPT | GPL 3.0 | Allgemeine, autonome KI-Agenten im Browser |
| Harambe | Offizielle öffentliche Projekte | Web-Extraktions-SDK und Extraktionsprimitiven |
| Tarsier | Offizielle öffentliche Projekte | Visuelle Wahrnehmungstools für Web-Interaktions-Proxye |
| Bananalyzer | Offizielle öffentliche Projekte | Bewertungsrahmen und Datensätze für AI-Agenten bei Webaufgaben |
| perplexity-style-streaming | Offizielle öffentliche Beispiele | Fließende Benutzeroberfläche und Entwicklungsversuche |
Unterschiede zwischen AgentGPT und dem aktuellen Reworkd
| Vergleichspunkte | AgentGPT | Aktuelle Reworkd-Version |
|---|---|---|
| Positionierung | Experimente mit allgemeinen, autonomen KI-Agenten | Plattform zur Extraktion von Daten von Unternehmenswebseiten |
| Eingabe | Name und offene Ziele | Webseiten, Crawling-Ziele und Schema |
| Ausgabe | Prozess des Denkens und Ausführens von Aufgaben | Überprüfbare strukturierte Webdaten |
| Arbeitsweise | Open-Source-Webanwendungen | Verwaltung von Browsern, APIs und Scheduling |
| Wartung | Benutzerverwaltungsmodell und Deployment | Die Plattform erkennt und behebt die Scraping-Skripte. |
| Wirtschaftlicher Schwerpunkt | Nicht mehr Hauptgeschäft | Derzeitige Kernprodukte |
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | Reworkd |
| Entwicklungsunternehmen | Reworkd AI, Inc. |
| Arten von Werkzeugen | KI-basierte Web-Scraping, Extraktion strukturierter Daten, selbstheilende Spider |
| Kerntechnologien | Multimodale Codegenerierung, Playwright und Harambe SDK |
| Preismuster | Kostenlos und mit Abonnement + Gebühren für Infrastrukturnutzung |
| API-Zugriff | Unterstützung |
| Zeitgesteuerte Aufgaben | Unterstützung |
| Open-Source-Zustand | Kommerzielle Plattformen sind geschlossen; Tools wie AgentGPT sind offen. |
Empfehlungswert
4,5 / 5. Reworkd eignet sich für Unternehmen und Datenteams, die viele Crawlertools verwalten müssen – die Codegenerierung, Selbstreparaturfunktionen, Doppelungsbeseitigung sowie Überwachungsmöglichkeiten bilden dabei ein umfassendes System. Allerdings müssen Kosten, rechtliche Aspekte sowie die Übereinstimmung der Informationen auf der offiziellen Website sorgfältig bewertet werden.
Häufige Fragen
Was macht Reworkd derzeit hauptsächlich?
Der Schwerpunkt liegt derzeit darauf, dass KI-Systeme Code zur Extraktion von Webseiten erstellen und warten, um dynamische Websites sowie Anhänge in strukturierte Daten umzuwandeln.
Was ist der Zusammenhang zwischen Reworkd und AgentGPT?
AgentGPT war ein frühes Open-Source-Projekt für allgemeine Agenten der Reworkd-Gruppe; das aktuelle kommerzielle Produkt konzentriert sich nun auf das Extrahieren von Webdaten.
Muss man selbst den Skriptcode für die Webscraping-Tools schreiben?
In der Regel ist das nicht notwendig – nachdem der Benutzer Ziele und Schemata definiert hat, generiert der Agent den Code. Bei komplexen Webseiten kann jedoch weiterhin Anleitung per Chat sowie manuelle Anpassungen erforderlich sein.
Wird sich die Website nach einem Update automatisch beheben?
Die Plattform erkennt den Fehler und versucht, den Code erneut zu generieren, doch die Semantik der bereinigten Felder sowie die Genauigkeit der Daten müssen weiterhin überprüft werden.
Gibt es ein kostenloses Abo bei Reworkd?
Ja, Hobby kostet 0 Dollar pro Monat. Auf der offiziellen Seite werden 10 gleichzeitige Browser, eine Speicherung über 30 Tage sowie API-Zugriffe angegeben.
Wie viel kostet das Pro-Paket?
Der öffentliche Preis beträgt 99 US-Dollar pro Monat, inklusive 50 gleichzeitigen Browsern und einer Datenspeicherung von 90 Tagen sowie der Verwaltung von Zeitplänen und Authentifizierungscodes.
Werden die Kosten für die Infrastruktur separat berechnet?
Ja, Dienste wie Proxy-Traffic, Browser-Verarbeitung und Anti-Bot-Verifizierung werden nach Verbrauch abgerechnet. Vor der Abrechnung des Kontos sollte die kostenlose Nutzungsgrenze überprüft werden.
Kann man die PDF-Anlage herunterladen?
Ja, die Plattform unterstützt asynchrone Dateiherunterladeungen und behält Quelle, Dateityp sowie Prüfinformationen bei.
Bietet Reworkd eine API?
Es werden eine Entdupplikation der Ausgabe, die Verwaltung von Cookies und lokalen Speichern bereitgestellt, sowie eine Anbindung über offene Schnittstellenspezifikationen möglich.
Ist Reworkd Open Source?
Die Geschäftsplattformen sind nicht offen quellbereitgestellt, doch offizielle Projekte wie AgentGPT, Harambe, Tarsier und Bananalyzer sind es.
Tools, die dem ReworkdAI ähneln



 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164