




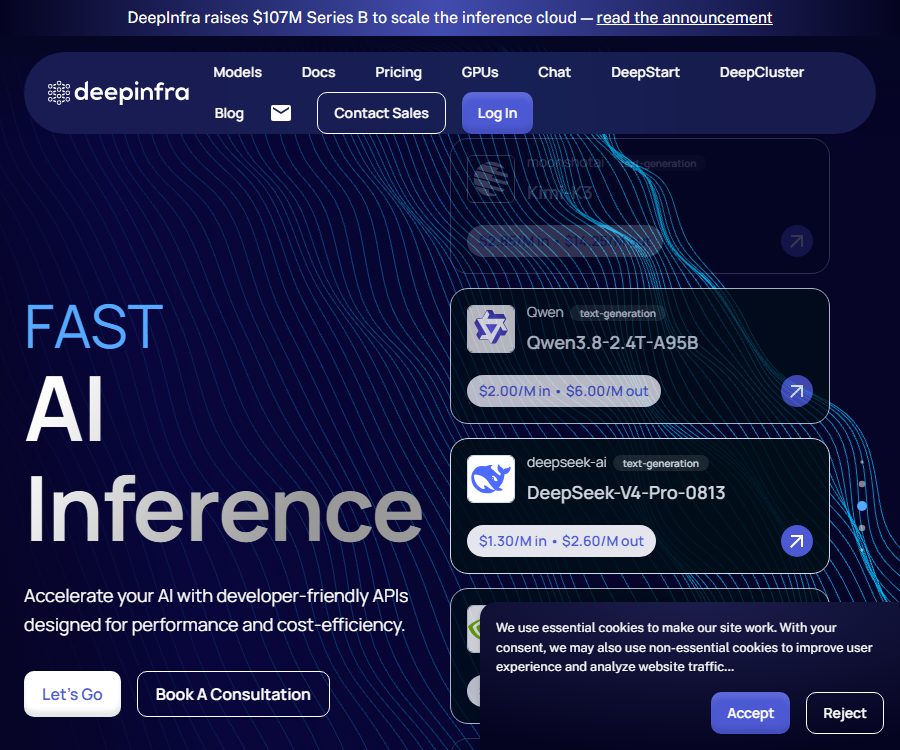
DeepInfra 是什麼
DeepInfra 是由美國的 Deep Infra Inc. 所運營的 AI 推理雲服務,適用於那些需要將語言、圖像、語音、影片以及傳統機器學習模型整合到其產品中的開發者與企業。
平台同時提供共享 Serverless 推理、批次處理、私有模型部署、GPU 實例、代碼沙箱以及託管智能體等功能。它解決的是模型上線、彈性擴縮容、介面相容性以及推理解算成本等問題,而非僅提供一個聊天頁面而已。
主要能力
- 共享模型推理:從模型目錄選擇語言、嵌入、重排、圖片、影片、語音或分類模型,按實際 Token 或執行量計費,無需自行管理 GPU。
- OpenAI 相容介面:聊天、文字補全、嵌入及圖片生成皆可重複使用 OpenAI SDK,只需修改基礎地址、模型名稱與金鑰即可。
- 原生多模態介面:涵蓋圖片生成、語音辨識、目標檢測、圖像分類、零樣本分類、實體辨識及遮罩填補等,適用於那些無法被其他相容介面處理的任務。
- 批處理:將大量非即時請求以檔案及批次的方式異步提交,適用於離線評測、內容處理與資料標註,公開文件標註的效率比即時推論低 20%。
- 私有模型:在專屬 GPU 上部署 Hugging Face 模型、自有權重、語言 LoRA 或圖像 LoRA,提供隔離端點、自動擴縮及更可預測的延遲。
- GPU實例:租用B200容器,透過SSH執行訓練、微調、推論或自訂工作負載,按運行時間計費。
- 沙箱環境:可依需求啟動隔離式的 Linux 微型虛擬機,讓智慧體能執行程式碼、讀寫工作區檔案以及存取公網,停止運作後則不會再收取計算費用。
支援的模型任務
| 任務類別 | 典型輸入 | 主要輸出 | 適合場景 |
|---|---|---|---|
| 聊天與推理 | 消息、系統指令、工具定義、圖片 | 文本、結構化數據、工具調用 | 客服、知識助手、智能體和代碼應用 |
| 嵌入與重排 | 查詢和文件集合 | 向量或相關性分數 | 語義檢索、RAG 和搜尋排序 |
| 圖片與影片 | 提示詞、圖片及生成參數 | 圖片、編輯結果或影片任務 | 視覺素材、原型和內容生產 |
| 語音 | 音頻或文本 | 轉寫、翻譯或合成語音 | 會議轉寫、字幕和語音互動 |
| 視覺與文本分類 | 圖片、文字或候選標籤 | 類別、框、實體或概率 | 審核、資訊抽取和自動標註 |
兩套 API 的差異
| 介面類型 | 覆蓋能力 | 主要優勢 | 適合用戶 |
|---|---|---|---|
| OpenAI 相容介面 | 聊天、補全、嵌入、圖片等 | 可復用現有 OpenAI 用戶端和呼叫結構 | 遷移現有應用或快速原型 |
| DeepInfra 原生介面 | 平台提供的全部模型類型 | 支援更多視覺、語音、分類任務及回呼等能力 | 需要完整模型目錄和細粒度參數的項目 |
所有介面都使用 Bearer Token 進行鑒權。不同模型的參數、上下文長度、流式輸出、工具呼叫、結構化輸出以及多模態支援並不一致,因此不能僅透過更換模型名稱就認為其行為完全相同。
快速接入流程
- 註冊帳戶,在控制台建立 API Token,並為開發、測試和生產環境使用不同的金鑰。
- 從模型目錄選擇模型,核對許可證、上下文、輸入類型、輸出格式、單價、速率限制和資料處理例外。
- 相容介面可繼續使用 OpenAI SDK;特殊任務則改用原生介面,並依照模型 Schema 來構造請求。
- 先以小流量測試超時、流式回應、工具呼叫、錯誤重試和輸出品質,再設定併發、預算和自動儲值限制。
- 上線後透過使用量與請求成本記錄監控 Token、緩存命中、延遲及失敗率,避免無上限重試。
共享推理的計費方式
語言模型通常會按照每 100 萬個輸入及輸出 Token 來計費,而有些模型則提供更低的緩存輸入單價。至於圖片、語音、影片等類型的模型,則可能根據圖片的大小、音頻的長度、生成的秒數或推理執行的時間來計費。
| 套餐或版本 | 價格 | 計費週期 | 核心權益或額度 | 適合用戶 |
|---|---|---|---|---|
| Llama 3.1 8B Turbo | 輸入 0.02 美元,輸出 0.04 美元 | 每 100 萬 Token | 128K 上下文的低成本文本推理 | 分類、摘要和輕量助手 |
| Llama 3.3 70B Turbo | 輸入 0.10 美元,輸出 0.32 美元 | 每 100 萬 Token | 更大模型的通用聊天和推理 | 品質要求更高的應用 |
| DeepSeek V4 Flash | 輸入 0.09 美元,輸出 0.18 美元 | 每 100 萬 Token | 另有更低緩存輸入單價 | 長上下文和高吞吐任務 |
| Qwen 3.5 9B | 輸入 0.10 美元,輸出 0.15 美元 | 每 100 萬 Token | 256K 上下文 | 多語言和輕量推理 |
| Kimi K2.5 | 輸入 0.45 美元,輸出 2.25 美元 | 每 100 萬 Token | 另有緩存輸入價格 | 長上下文與複雜任務 |
以上是即時價格頁面的代表樣本,並非固定套餐或價格保證。模型上線/下線、版本、快取規則以及單價都可能會變化,因此正式估算時應參考所選模型的相關資訊以及帳戶的結算資料。
免費額度、充值與退款
- 目前尚未確認是否有對所有帳戶都長期有效的免費 API 套裝或每月的免費使用額度;註冊優惠及促銷所獲得的額度,不能視為永久性權益。
- 共享推理採用按量付費,帳戶可添加資金並配置自動充值;餘額不足可能使請求、沙箱或實例操作被暫停。
- 企業服務可透過服務訂單約定帳期、支援及其他條款,公開頁面沒有統一企業報價。
- 現行條款並未提供適用於所有預付餘額及已消費用量的通用退款保證;在服務違約且無法重新履行時,條款將相關退款視為特定的救濟措施。
批次處理與成本優化
- 對不要求即時返回的任務使用 Batch API,可按文件標註獲得 20% 折扣,並降低實時併發壓力。
- 重複使用長提示前綴時,可使用提示緩存降低預填充延遲與緩存讀取成本,保留檔位包括短時和一小時選項。
- 讓回應僅產生所需長度,並為最大輸出 Token、併發與重試次數設定上限。
- 先用小模型處理分類、路由和抽取,再把少數複雜請求交給大模型,通常比所有請求統一使用高價模型更可控。
私有模型與專屬部署
| 部署類型 | 計費方式 | 核心能力 | 適合用戶 |
|---|---|---|---|
| 共享 Serverless | 按 Token 或推理量 | 無需管理實例,自動共享容量 | 流量波動和快速上線 |
| 私有 LLM | 按 GPU 小時 | 自有意權重、隔離端點、自動擴縮、相容介面 | 訂製模型與穩定延遲 |
| LoRA 部署 | 按專屬資源 | 載入語言或圖像適配器 | 領域微調與品牌風格 |
| B200 GPU 實例 | 3.69 美元起每小時 | SSH、容器、180GB顯存,按分鐘計費 | 訓練、微調和自訂程式 |
| 企業方案 | 訂製報價 | 服務訂單、容量、支援與商務條款 | 大規模或特殊合規需求 |
在私有部署模式下,即便沒有提出任何請求,只要 GPU 仍在運作,就會持續產生費用。文件中的示例指出,如果忘記關閉雙 GPU 的部署模式,64小時內可能會產生約256美元的費用,因此必須設定預算上限並啟用自動縮容功能。
Sandboxes 代碼沙箱
- 每個 Sandbox 都是獨立的 Linux 微型虛擬機器,可以執行指令及 Python 程式、傳輸檔案,並能存取公網,但無法接收進入的連線,亦無法存取其他沙箱或 DeepInfra 內部的網路。
- 按秒計費且無最低時長,創建、啟動、運行和停止過程均計費;停止狀態不計算費用。
- 只有工作區目錄在正常停止和重啟之間保留,停止後最多保留 7 天;失敗狀態會在數分鐘內被刪除,工作區不保證能恢復。
- 預設的閒置超時時間為 1 小時,連續運作 24 小時後會自動停止。單個指令的最長運作時間為 30 分鐘,每個帳戶最多可擁有 5 個處於非停止狀態的沙箱。
- 檔案單次讀寫的上限為 100 MiB,重要結果應及時複製到外部儲存。
數據隱私與零保留邊界
- 普通推理的輸入僅在處理期間存在於記憶體中,不會被寫入磁碟;輸出返回後會從記憶體中刪除,平台聲明不會使用這些數據來訓練模型。
- 圖片生成輸出會短期保存以便訪問,批處理可能把數據加密寫入磁盤並在結果返回後的短期內刪除。
- 呼叫 Google 或 Anthropic 模型時,資料會傳送至對應的模型端點,其輸出儲存、日誌及訓練規則皆適用於相關提供方的政策。
- 平台通常不記錄請求的實際內容,但會記錄請求編號、成本、採樣參數等元資料,並保留為了調試或安全需求而記錄少量請求的權限。
- 帳戶、通訊內容、設備資訊、使用記錄、網路位址以及帳單相關資料,皆會依照隱私政策來處理;當帳戶被刪除後,個人資訊通常會在 30 天後被移除,不過,因法律、稅務或安全考量而必須保留的記錄則除外。
安全與合規
DeepInfra 表示其安全措施符合 SOC 2 與 ISO 27001 的標準,同時也提供與 GDPR 和 HIPAA 相關的技術及組織層面的保障措施。不過,這些認證和控制措施並不能自動讓客戶的應用程式符合相關規定;在處理健康、金融或其他敏感資料之前,仍需確認合約、DPA、所選用的模型以及當地的相關要求。
- API Token應僅保存在伺服器端或金鑰管理系統中,並依環境區分且定期輪換。
- 對終端用戶建立限制性的存取權限時,可使用具有範圍與期限的 JWT,以避免發放主帳戶 Token。
- 使用第三方模型前檢查數據會被發送到哪裡,不要把統一零保留表述套用到明確列出的例外。
- 為日誌、回呼及批次處理檔案設定存取控制與刪除流程,並避免將使用者的敏感內容寫入自身的可觀測性系統。
SDK、集成與開源狀態
- 官方 TypeScript 客戶端 deepinfra-node 採用 MIT 讓可證,涵蓋文本、嵌入、圖像、語音和分類等原生介面。
- Python deepinfra 這個套件涵蓋了推論功能與沙箱環境,目前的倉庫說明文件將其描述為官方 SDK,且採用 MIT 授權協議。
- 文件還提供了 LangChain、LlamaIndex、Vercel AI SDK、AutoGen、Anthropic SDK 以及多種智能體框架的整合方式。
- 開源的是用戶端及部分整合代碼,並不代表 DeepInfra 雲平台、調度系統或託管模型也全部開源;每個第三方模型仍受其本身的許可證與使用政策約束。
適合用戶與限制
- 應用開發者:可快速接入多個模型並保留相容介面,但需針對模型差異進行測試與回退。
- RAG 與搜尋團隊:組合嵌入、重排和生成模型,並透過批次處理及快取優化成本。
- 擁有自定權重的團隊:使用私有 GPU 部署可獲得隔離與穩定的延遲,同時需承擔持續運行的成本。
- 智能體開發者:用 Sandbox 執行不可信代碼,但必須把短生命週期和資料遺失的風險納入設計中。
- 需要絕對固定模型行為、永久免費配額或完全無第三方處理的專案,不應僅依賴共享目錄的預設設定。
常見問題
DeepInfra 有永久免費的 API 嗎?
目前尚未確認是否有適用於所有帳戶的永久免費套餐或固定的每月使用額度。促銷剩餘額度可能會隨著活動及帳戶狀況而變動,實際使用時應根據即時單價及實際帳單金額來估算。
可以直接使用 OpenAI SDK 嗎?
可以,聊天、補全、嵌入和圖片等相容的介面皆可重複使用 OpenAI SDK。仍需更換基礎地址、DeepInfra Token 和模型名,並檢查參數的相容性。
DeepInfra 會保存提示詞並用於訓練嗎?
普通推理輸入不會儲存至磁碟,輸出後即被刪除,平台聲明其不會用於訓練。圖片、批次處理,以及 Google、Anthropic 模型則屬於例外,調試或安全場景下也可能會記錄少量請求。
共享推理和私有部署怎麼選?
流量波動、模型仍在評估時優先共享推理;需要自定權重、隔離、穩定延遲或專屬容量時選擇私有部署,並持續監控 GPU 運行費用。
DeepInfra 是開源平台嗎?
雲平台本體並非已公開的完整開源專案。官方的 Python、TypeScript 客戶端以及部分整合元件採用開源授權許可證,而所託管的模型則分別遵循各自的授權許可證。
批處理為什麼更便宜?
批次處理允許平台以非同步方式調度那些並不緊急的請求,相關文件中顯示,其效率比即時推論低 20%。它不適用於需要即時回應的場景,且可能會將輸入與結果以加密方式暫時儲存起來。
總結
DeepInfra 的優勢在於,只需一個帳戶即可使用各種相容的介面、原生的多模態模型、批次處理功能、私有權重設定,以及 GPU 和程式碼沙箱等功能。此外,還可以根據工作負載來選擇按 Token、執行次數或 GPU 小時來計費。在上線之前,最重要的是要確認每個模型的價格與許可證的相關規定,設定預算和重試次數的上限,並妥善處理無數據保留的例外情況。
類似於DeepInfra的工具
 桂公網安備45132202000164號