




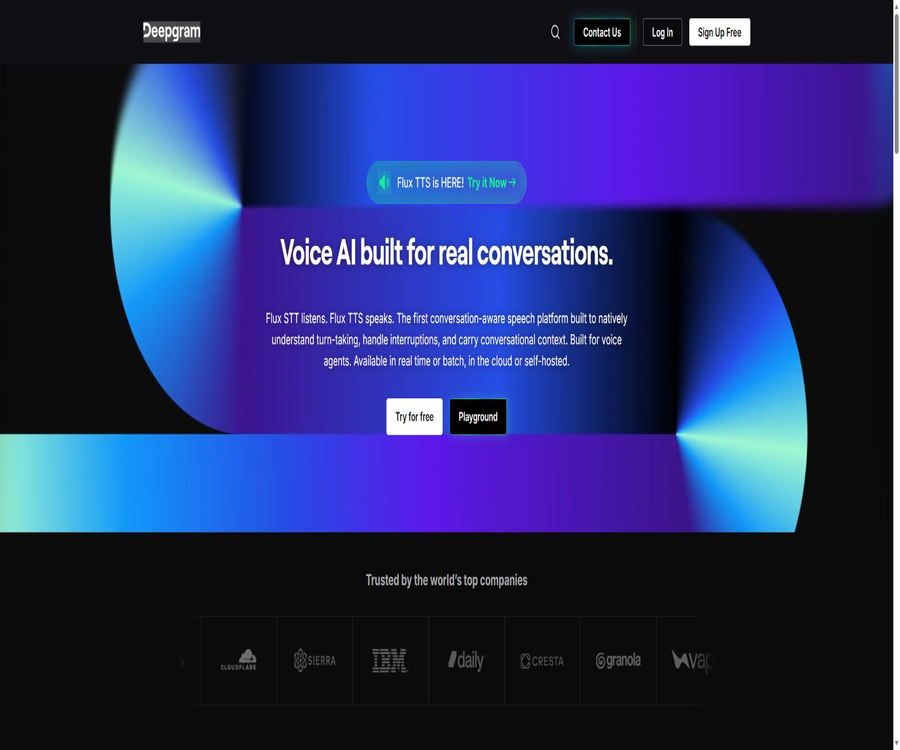
Deepgram
Deepgram, outil intelligent spécialisé dans l’audio IA
Étiquettes :Outils audio IAUne phrase pour présenter
Deepgram est une plateforme d’IA vocale destinée aux développeurs et aux entreprises, qui offre, via des API, une reconnaissance vocale en temps réel et en batch, une synthèse vocale dialoguée, une orchestration complète de Voice Agents ainsi que la compréhension audio, et prend en charge le cloud hébergé, les environnements dédiés et le déploiement local.
Présentation des outils
Deepgram propose une capacité complète, allant de l’écoute au raisonnement puis à la parole, pour les applications vocales réelles. Les développeurs peuvent soit utiliser séparément Speech-to-Text ou Text-to-Speech, soit créer, via une connexion WebSocket, des agents intelligents vocaux en temps réel capables de gérer les interruptions, les tours de parole et les appels d’outils.
Les modèles principaux actuels comprennent Nova-3 pour la transcription générale, Flux STT pour les tours de dialogue, Flux TTS interactif et la série Aura pour la synthèse vocale. Les produits et modèles sont des services commerciaux ; le SDK officiel étant open source ne signifie pas que les poids des modèles ou le code source de la plateforme le soient également.
Aperçu des capacités du produit
| Produit | Principales importations | Sortie principale | Utilisations typiques |
|---|---|---|---|
| Speech-to-Text | Flux en temps réel ou fichier audio | Texte avec heure, locuteur et niveau de confiance | Transcription, sous-titres et analyse |
| Text-to-Speech | Contexte du texte et des dialogues | Synthèse vocale en flux | Service client, assistants et robots téléphoniques |
| Voice Agent API | Audio en temps réel bidirectionnel et configuration | Dialogue vocal interrompable | Service client, prise de rendez-vous et appels externes |
| Audio Intelligence | Transcription audio ou texte | Résumé, thème, émotion et intention | Contrôle qualité, analyse et routage |
| Self-Hosted | Infrastructure GPU d’entreprise | Étendue de raisonnement vocal privée | Résidence des données et faible latence |
| Playground | Microphone, fichier ou texte | Résultats de l’essai du modèle | Vérification du prototype et comparaison des paramètres |
Modèle de reconnaissance vocale
Nova-3
Nova-3 est le modèle de reconnaissance vocale de niveau production actuellement recommandé, pouvant être utilisé pour des flux en temps réel et des fichiers audio préenregistrés. Il prend en charge plusieurs langues, la détection automatique du langue, le bruit et les sons provenant de distances éloignées, et permet d’améliorer la reconnaissance des termes de marque, de produits et du secteur grâce au Keyterm Prompting.
Flux STT
Flux STT est conçu spécifiquement pour les agents vocaux en temps réel ; il ne se contente pas de reconnaître le texte, mais intègre également dans le modèle la détection de la fin des tours de parole ainsi qu’un rythme de dialogue configurable. Les versions anglaise et multilingue sont facturées séparément, et la version multilingue permet d’influencer la reconnaissance à l’aide de suggestions linguistiques.
Nova-3 Medical et modèles sur mesure
Nova-3 propose des options destinées au vocabulaire médical ; les entreprises peuvent également contacter le service commercial pour obtenir des modèles personnalisés adaptés à des données propres ou spécifiques. Les modèles professionnels doivent néanmoins être évalués en utilisant des accents, des équipements, des scénarios et des corpus de vocabulaire réels, et ne peuvent pas se baser uniquement sur des références générales.
Whisper Cloud et le modèle ancien
Deepgram continue de proposer l’hébergement de Whisper Large, tout en conservant Nova-2, Enhanced et Base pour les déploiements existants. Pour de nouveaux projets, il est généralement conseillé de comparer d’abord Nova-3 et Flux, afin d’éviter d’opter par défaut pour Whisper, dont la capacité d’extension est plus limitée en raison de sa compatibilité historique.
Fonction de reconnaissance vocale
- Le streaming est utilisé pour la transcription incrémentale en temps réel des appels, des conférences et des agents vocaux.
- Pre-Recorded est utilisé pour télécharger des enregistrements et générer du texte complet de manière asynchrone ou synchrone.
- La diarisation du locuteur permet d’identifier plusieurs personnes et d’indiquer qui parle à chaque moment.
- Le formatage intelligent gère automatiquement la ponctuation, la casse, les dates et les monnaies.
- Le Keyterm Prompting améliore la reconnaissance des noms de produits, des abréviations et des termes techniques.
- Redaction est utilisé pour identifier et supprimer certaines informations personnelles sensibles.
- La détection d’entités permet d’extraire des entités telles que des personnes, des organisations, des lieux et des dates.
- La détection automatique de langue aide à gérer les langues inconnues ou les changements de scène.
Synthèse vocale Text-to-Speech
Flux TTS
Flux TTS est un modèle fluide et nativement conçu pour les agents vocaux en temps réel, qui utilise le contexte à travers les différentes phases de la conversation pour maintenir la continuité du ton, du rythme et de l’émotion. Il peut fournir des retours sur le texte que l’utilisateur a réellement entendu avant une interruption, et permet d’ajuster la vitesse et le style sans interrompre la conversation.
Aura-2
Aura-2 est conçu pour la synthèse vocale professionnelle, à grande échelle et à faible latence, et peut être utilisé dans les services client, les notifications et les applications de dialogue. Les modèles Aura-2 existants ne seront pas migrés de force suite à la sortie de Flux TTS.
Aura-1
Aura-1 reste disponible en tant qu’option de synthèse vocale à moindre coût. Lors du choix, il convient de comparer à la fois les langues, les voix, les délais, la prononciation du contenu structuré et la région de déploiement, et non seulement le prix par millier de caractères.
Contrôle vocal interactif
Deepgram conçoit actuellement la synthèse vocale comme une partie de l’architecture de dialogue, capable de suivre l’état, les limites des tours de parole et les interruptions. Pour les projets ayant des exigences strictes en matière de voix de marque ou de clonage vocal, il convient de vérifier d’abord le modèle actuel et les capacités d’autorisation.
Voice Agent API
L’API Voice Agent combine la reconnaissance vocale, l’orchestration de LLM et la synthèse vocale dans une connexion en temps réel, réduisant ainsi le travail des développeurs qui devaient assembler plusieurs services. Les utilisateurs peuvent également utiliser leurs propres LLM ou TTS, et n’utiliser que les autres capacités de voix et d’orchestration de Deepgram.
- Détection intégrée de Barge-in, permettant aux utilisateurs d’interrompre naturellement l’agent intelligent.
- La prédiction du tour de parole aide le système à déterminer quand écouter, réfléchir et parler.
- L’appel de fonction permet de consulter des systèmes métier ou d’exécuter des outils au cours d’une conversation.
- Le contrôle en cours de session permet d’ajuster les configurations et le comportement au cours de la session.
- Les configurations réutilisables facilitent la réutilisation des paramètres des agents.
- L’architecture Multi-Agent prend en charge le transfert entre des agents intelligents spécialisés.
- La capacité de téléphonie est utilisée pour se connecter aux réseaux de téléphonie entrante et sortante.
- Le Browser Agent SDK permet d’intégrer des fonctionnalités de voix en temps réel dans les applications Web.
Audio Intelligence
L’Audio Intelligence est utilisée pour générer, à partir de transcriptions, des résultats structurés tels que des résumés, des thèmes, des émotions et des intentions. Certaines fonctionnalités sont facturées séparément en fonction des tokens d’entrée et de sortie ; elles ne font pas partie intégrante et gratuite du prix du reconnaissance vocale.
| Capacité | Résultat | Scénarios adaptés | Risques principaux |
|---|---|---|---|
| Summarization | Résumé du dialogue | Comptes rendus du service client, résumé des réunions | Les conditions limitatives pourraient être oubliées |
| Topic Detection | Métadonnées | Classification du contenu et routage | Instabilité des frontières multi-thèmes |
| Sentiment Analysis | Tendance émotionnelle | Contrôle qualité des services et tendances | Contexte, culture et déviation ironique |
| Intent Recognition | Intention de l’utilisateur | Départition automatique et actions suivantes | Une intention erronée peut déclencher un processus incorrect. |
| Entity Detection | Personnages, organisations, lieux et dates | Saisie et recherche dans le CRM | La orthographe des noms doit être vérifiée. |
| Redaction | Supprimer une partie du texte sensible | Gestion de la confidentialité et du respect des réglementations | Ne peut pas remplacer une protection complète contre les fuites de données |
Processus d’accès complet
- Créez un compte Deepgram et un projet pour obtenir un crédit gratuit.
- Générer une clé API ne possédant que les permissions nécessaires, et la stocker dans des configurations serveur sécurisées.
- Choisissez Streaming ou Pré-enregistré en fonction du traitement de conversations en temps réel ou d’enregistrements.
- Choisissez Nova-3, Flux ou un autre modèle adapté au langage et à la scène.
- Définir l’encodage audio, la fréquence d’échantillonnage, la langue, le locuteur et les paramètres de formatage.
- Exécuter des tests de référence avec des équipements réels, du bruit, des accents et un vocabulaire professionnel.
- Les segments temporaires, les segments finaux, les erreurs, les délais d’exécution et les réconnections dans les résultats du traitement.
- Enregistrer la durée audio, le nombre de caractères, les fonctionnalités supplémentaires et la concurrence pour surveiller les coûts.
- Configurer avant le lancement les politiques de confidentialité, de conservation, de région, de quotas et de dégradation en cas de panne.
Tutoriel de transcription en temps réel
- Obtenir un audio monophonique ou stéréo stable depuis un navigateur, un téléphone ou un appareil audio.
- Établir une connexion WebSocket et effectuer l’authentification avec des identifiants à court ou long terme du côté serveur.
- Indiquez le codage, le taux d’échantillonnage et le nombre de canaux corrects pour éviter une interprétation erronée de l’audio.
- Utiliser Nova-3 pour le traitement de la transcription générale, ou Flux pour les tours de dialogue.
- Activez le Formatage intelligent, la Diarisation et les Mots-clés selon les besoins.
- Utiliser les résultats intermédiaires pour l’interface en temps réel, et les résultats finaux pour la persistance et les actions métier.
- Créer un état machine pour la déconnexion, le silence, les longues pauses, la réconnection et la répétition des segments.
- Calculer le taux d’erreur de mot, la précision des entités et le délai bout en bout à l’aide d’un ensemble d’étiquetage manuel.
Tutoriel pour créer un Voice Agent
- Définir les tâches de l’agent, les actions autorisées et les conditions nécessitant une intervention humaine.
- Configurer la reconnaissance vocale Flux ou Nova, les fournisseurs de LLM et les voix TTS.
- Rédiger des indications systémiques pour limiter l’identité, la portée des activités et les engagements non assumables.
- Exécuter l’appel de fonction et valider les paramètres, les droits d’accès et l’idempotence du côté serveur.
- Tester les interruptions, le silence, la répétition, les bruits de fond et le parlage simultané par les utilisateurs.
- Enregistrer ce que l’utilisateur entend réellement, afin d’éviter des incohérences dans l’état du système après une interruption.
- Ajouter une authentification, des étapes de confirmation et une prise en charge manuelle pour les opérations sensibles.
- Surveiller la durée de chaque appel, le délai, le taux de transfert vers un agent humain, le taux de réussite des tâches et les coûts.
Évaluation de la qualité de production
- Préparer un ensemble de tests couvrant les principales langues, accents, appareils, bruits et termes professionnels.
- Des transcriptions de référence fiables sont créées manuellement, et des règles de notation sont établies.
- Tester séparément les modes en temps réel et par lots, sans comparer les délais et la précision de manière mixte.
- Comparer Nova-3 monolingue, multilingue, Flux et les fournisseurs existants.
- Des points sont attribués séparément aux entités clés telles que les chiffres, les noms de personnes, les adresses, les médicaments et les comptes.
- Évaluer le jugement de tour en dehors du taux d’erreur de mot, le retard du premier caractère et le retard final.
- Estimer les coûts pour plusieurs canaux, les fonctionnalités supplémentaires, l’Audio Intelligence et les tentatives de réessai.
- L’augmentation du trafic n’a lieu que lorsque le seuil opérationnel est atteint.
À qui s’adresse-t-il
- Équipe de développement d’agents vocaux : création d’assistants vocaux en temps réel à faible latence et interrompables.
- Plateforme de centre d’appels : transcription des appels, résumé des conversations et identification des intentions.
- Produits de conférence et de sous-titres : génération de sous-titres en temps réel, d’identifiants de locuteurs et de chapitres.
- Entreprises médicales et financières : utilisation de la conformité et du déploiement privé via des contrats d’entreprise.
- Plateformes de médias et de podcasts : transcription en masse, recherche et compréhension des enregistrements.
- Équipe des ventes et du service client : convertir les données vocales en informations CRM et de contrôle qualité.
- Équipe d’ingénierie de plateforme : intégration via des SDK, des endpoints régionaux et une solution auto-hébergée.
Scénarios d'utilisation typiques
| Scène | Capacité de recommandation | Indicateurs clés | Contrôle des risques |
|---|---|---|---|
| Robot de service client en temps réel | Flux STT + Flux TTS ou Voice Agent | Interrompre, retarder, taux de résolution | Passer en mode manuel et authentification |
| Sous-titres de réunion | Nova-3 Streaming + Diarisation | Taux d’erreur de mot et taux de précision du locuteur | Les participants sont d’accord |
| Archivage audio | Nova-3 Pre-Recorded | Débit, coût et taux de récupération | Réservation et contrôle d’accès |
| Dossiers médicaux | Nova-3 Medical + Redaction | Terminologie et entités clés | BAA et vérification manuelle |
| Contrôle qualité téléphonique | STT + Intelligence audio | Résumé, émotions et intentions | Éviter de punir uniquement en se basant sur des scores émotionnels |
| Avis vocal | Aura-2 ou Aura-1 | Prononciation, retard et coût | Vérification de la marque et de l’accessibilité |
| Plateforme de voix locale | Self-Hosted | Résidence des données et capacité | GPU, mises à niveau et gestion des licences |
Plan de prix
Les prix ci-dessous ont été vérifiés sur la page officielle le 22 août 2026. Une partie des prix pour le traitement par reconnaissance vocale en flux est soumise à des promotions temporaires ; l’avantage offert pour Flux TTS et Voice Agent utilisant Flux TTS prendra fin le 12 septembre 2026, il est donc nécessaire de vérifier à nouveau les prix avant leur mise en service.
| Plan | Prix ou seuil | Principaux droits | Taille par défaut | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Free Credit | Nouveau compte : 200 dollars | Pas de carte de crédit nécessaire, aucun échéance fixe pour le crédit accordé | Utiliser un modèle public | Prototype et évaluation |
| Pay As You Go | Selon la consommation réelle | Pas de engagement minimum | STT en flux, jusqu’à 150 simultanés | Développeurs et équipes startup |
| Growth | A partir de 4 000 dollars par an à payer d’avance | Jusqu’à 20 % de réduction maximale et plus de concurrence simultanée | Flux STT jusqu’à 225 simultanés | Applications de production en croissance |
| Enterprise | Contacter le service des ventes | Modèles à grande échelle, personnalisés, déploiement privé et support | Concurrence sur mesure et SLA | Entreprises de grande taille ou réglementées |
Prix de la reconnaissance vocale en texte
Reconnaissance vocale en temps réel par streaming
| modèle | Pay As You Go | Growth | Unité de facturation | Remarques |
|---|---|---|---|---|
| Flux English | Actuellement 0,0065 dollar américain | Actuellement 0,0057 dollar américain | par minute | Prix promotionnel en flux |
| Flux Multilingual | 0,0078 dollar américain | 0,0068 dollar américain | par minute | Soutien au dialogue multilingue |
| Nova-3 Monolingual | Actuellement 0,0048 dollar américain | Actuellement 0,0042 dollar américain | par minute | Prix promotionnel en flux |
| Nova-3 Multilingual | Actuellement 0,0058 dollar américain | Actuellement 0,0050 dollar américain | par minute | Prix promotionnel en flux |
| Custom | Contacter le service des ventes | Contacter le service des ventes | contrat | Données propres ou spéciales |
Reconnaissance de la parole enregistrée
| modèle | Pay As You Go | Growth | Unité de facturation | Adéquat pour la tâche |
|---|---|---|---|---|
| Nova-3 Monolingual | 0,0043 dollar américain | 0,0036 dollar américain | par minute | Enregistrement monolingue |
| Nova-3 Multilingual | 0,0052 dollar américain | 0,0043 dollar américain | par minute | Enregistrements multilingues |
| Whisper Large | 0,0048 dollar américain | 0,0048 dollar américain | par minute | Compatibilité avec des processus Whisper spécifiques |
| Custom | Contacter le service des ventes | Contacter le service des ventes | contrat | Modèle personnalisé |
Fonctionnalité supplémentaire Speech-to-Text
| Fonctionnalité | Pay As You Go | Growth | En direct ou en enregistrement | Remarques |
|---|---|---|---|---|
| Redaction | 0,0020 dollar par minute | 0,0017 dollar par minute | Les deux | Supprimer certaines informations sensibles |
| Keyterm Prompting | 0,0013 dollar par minute | 0,0012 dollar par minute | Les deux | Renforcer les termes clés |
| Smart Formatting | Contient | Contient | Les deux | Pontuation et mise en forme |
| Entity Detection | 0,0017 dollar par minute | 0,0017 dollar par minute | Les deux | Extraction d’entités |
| Speaker Diarization | En temps réel : 0,0020 dollar par minute | Selon la page | en temps réel | Le mode enregistrement contient actuellement |
| Speaker Diarization | Contient | Contient | Enregistrement | Annotation multiple |
Prix Text-to-Speech
Flux TTS est gratuit pendant une période limitée jusqu’au 12 septembre 2026, puis le tarif normal par caractère sera rétabli à partir du 13 septembre 2026. La période gratuite n’est pas un plan gratuit permanent.
| modèle | Pay As You Go | Growth | Unité de facturation | Statut du prix |
|---|---|---|---|---|
| Flux TTS | Gratuit jusqu’au 12 septembre, puis 0,0450 dollar | Gratuit jusqu’au 12 septembre, puis 0,0405 dollar | Chaque 1000 caractères | Offre limitée dans le temps |
| Aura-2 | 0,030 dollar américain | 0,027 dollar américain | Chaque 1000 caractères | Prix standard actuel |
| Aura-1 | 0,0150 dollar américain | 0,0135 dollar américain | Chaque 1000 caractères | Prix standard actuel |
Prix de l’API Voice Agent
L’agent vocal est facturé en fonction de la durée de la conversation, et des niveaux diffèrent selon que l’on utilise ou non les LLM et TTS fournis par Deepgram. Voici les prix actuels pendant la période d’essai gratuite de Flux TTS, ainsi que les prix standard une fois cette période terminée.
| niveau | Prix actuel Pay As You Go | Prix après l’événement | Prix actuel de Growth | Conforme à la configuration |
|---|---|---|---|---|
| Standard | 0,056 dollar par minute | 0,075 dollar par minute | 0,051 dollar par minute | Utiliser la pile vocale par défaut complète |
| Standard BYO TTS | 0,065 dollar par minute | Avec le présent | 0,051 dollar par minute | Synthèse vocale intégrée |
| Custom BYO LLM | 0,050 dollar par minute | 0,065 dollar par minute | 0,041 dollar par minute | Modèle de langue intégré |
| LLM personnalisé BYO avec TTS | 0,050 dollar par minute | Avec le présent | 0,041 dollar par minute | Modèle de langue et synthèse vocale intégrés |
| Advanced | 0,122 dollar par minute | 0,163 dollar par minute | 0,110 dollar par minute | Niveaux plus avancés de LLM |
| Advanced BYO TTS | 0,122 dollar par minute | Avec le présent | 0,110 dollar par minute | LLM avancé avec TTS intégré |
Règles de facturation et pièges de coûts
- La reconnaissance vocale est facturée en secondes réelles, sans arrondi à des minutes fixes.
- Le tarif pour les sons stéréo est calculé en fonction de la durée totale de traitement de chaque canal ; 10 minutes en stéréo sont facturées comme 20 minutes.
- La rédaction, les mots-clés, les entités et une partie de la diarisation entraînent des frais supplémentaires.
- Audio Intelligence facture en fonction des tokens d’entrée et de sortie, ce qui n’est pas inclus dans le prix unitaire du STT.
- Tout dépassement du plafond de crédit est facturé au taux de Growth initial majoré de 10 % et réglé hebdomadairement.
- Pour activer la croissance et les utilisations supplémentaires, il est nécessaire de conserver une carte de crédit valide ; sinon, l’épuisement du plafond interrompra la demande.
- La limite de concurrence est définie au niveau du projet ; plusieurs clés API partageant le même pool n’augmentent pas la capacité.
- Créer des projets supplémentaires pour contourner les limitations de vitesse constitue une violation des conditions d’utilisation.
- Une fois les promotions et les offres gratuites à durée limitée terminées, le coût unitaire peut varier automatiquement.
Limite de vitesse
| Service | Limite par défaut Pay As You Go | Restrictions publiques à la croissance | Explication |
|---|---|---|---|
| Voice Agent | Jusqu’à 45 connexions simultanées | Jusqu’à 60 connexions simultanées | Calculé par projet |
| Flux STT Streaming | Jusqu’à 150 requêtes simultanées | La page de planification affiche un maximum de 225 | Les documents régionaux doivent être confirmés à nouveau. |
| Nova-3 Pre-Recorded | Jusqu’à 50 requêtes simultanées | Le plan public est de 50 | Tâches en batch |
| Nova-3 Streaming | Jusqu’à 150 requêtes simultanées | Jusqu’à 225 | Transcription en temps réel |
| Speaker Diarization Streaming | 50 en Amérique du Nord, 25 en Europe et en Australie | Conformément à l’accord | En dessous de la limite de flux normal |
| Text-to-Speech REST | Jusqu’à 15 requêtes simultanées par modèle | L’aperçu du plan indique une échelle globale plus importante. | Préférence aux restrictions de modèle et de région |
| Audio Intelligence | Jusqu’à 10 requêtes simultanées | Jusqu’à 10 | Analyse supplémentaire |
Mode de déploiement
| Méthode | Emplacement d’exécution | Responsabilités de maintenance | Données et scénarios d’application |
|---|---|---|---|
| Hosted | Cloud multi-locataires Deepgram | Deepgram est responsable de l’infrastructure et des mises à jour. | Commencer le développement le plus rapidement possible |
| Cloud régional | Points d’entrée en Amérique du Nord, en Europe ou en Australie | Deepgram est responsable de | Traitement régional et résidence des données |
| Dédier ou VPC | Environnement cloud dédié aux clients | Selon l’accord d’entreprise | Isolation et capacité personnalisée |
| Self-Hosted | VPC du client ou centre de données | Le client est responsable de l’infrastructure, des sauvegardes et des mises à jour. | Confidentialité stricte et faible latence |
| Amazon SageMaker | Client AWS VPC | Points d’entrée hébergés par AWS et configuration client | Déploiement de modèles via Marketplace |
Exigences pour l’hébergement auto-géré
Le déploiement local prend en charge Docker, Podman, Kubernetes, le bare metal et certaines plateformes cloud, mais uniquement Linux x86-64 ou amd64 ainsi que des GPU NVIDIA. Nova et Aura offrent un support plus large, tandis que le modèle Flux exige des générations de GPU et plus de mémoire.
- Le moteur STT nécessite généralement au moins une GPU NVIDIA avec 16 Go de mémoire vidéo, un CPU à 4 cœurs et 32 Go de mémoire vive.
- Le moteur TTS de la classe Aura nécessite exactement 2 GPU dédiés, un CPU à 8 cœurs et 64 GB de mémoire.
- Flux TTS utilise une seule GPU, mais peut occuper environ 60 GB de mémoire système lors du chargement.
- Les conteneurs auto-hébergés nécessitent toujours une licence et des rapports d’utilisation ; ils ne sont pas entièrement hors ligne automatiquement, sauf dans le cadre du mode d’isolation SageMaker.
- Le client est responsable du suivi, de la capacité, des sauvegardes, des mises à jour, des proxies et de la terminaison TLS.
- L’autonomisation de Docker, Podman ou Kubernetes nécessite généralement une licence Enterprise.
Confidentialité, sécurité et amélioration des modèles
Deepgram laisse aux accords commerciaux la responsabilité de la conservation, du stockage et de la suppression des données clients des entreprises. Selon les documents d’autogestion, l’audio, les transcriptions et autres contenus de reconnaissance d’une demande d’autogestion typique ne sont pas envoyés à Deepgram ; seuls des métadonnées d’utilisation tels que la durée, le nombre de caractères, les fonctionnalités et l’état de réussite sont communiqués.
Les clients Pay As You Go et Growth peuvent choisir d’adhérer ou de quitter le Model Improvement Program ; le retrait à partir de mars 2026 n’affecte pas les tarifs affichés sur le site officiel. Avant de traiter des données personnelles réelles, il convient de confirmer les options de la console, la région, la durée de conservation et le protocole de traitement des données.
- Deepgram divulgue les informations relatives aux certifications SOC 2 Type I et Type II.
- Les clients médicaux d’Enterprise peuvent signer un BAA pour traiter des informations de santé protégées électroniquement.
- Les points d’extrémité régionaux en Europe sont utilisés pour répondre aux exigences de traitement et de stockage des données au sein de l’Union européenne.
- La clé API doit être stockée uniquement du côté serveur, et organisée par projet, environnement et avec les permissions minimales nécessaires.
- La rédaction ne peut que réduire partiellement le risque d’exposition ; elle ne peut pas remplacer la minimisation des données à la source.
- Évitez d’enregistrer dans le journal l’audio brut, la transcription complète et les clés valables sur le long terme.
- Les agents vocaux à haut risque doivent fournir des informations, un consentement pour l’enregistrement, une prise en charge humaine et une audit.
SDK, GitHub et statut open source
Deepgram maintient des SDK pour JavaScript, Python, .NET, Go et Java au sein de son organisation officielle GitHub, et fournit également des paquets liés au navigateur Voice Agent. La documentation actuelle du SDK JavaScript indique que la version v5 est la version principale en cours, et les projets en cours de migration doivent se référer aux instructions d’upgrade correspondantes.
Plusieurs SDK officiels sont soumis à la licence MIT, permettant aux développeurs de consulter, modifier et distribuer ces codes clients. Cependant, la plateforme cloud Deepgram, son modèle commercial, les poids des modèles et les conteneurs auto-hébergés ne deviennent pas pour autant des produits open source.
| Projet | Entretien | État | Licence ou instructions |
|---|---|---|---|
| SDK JavaScript et TypeScript | Deepgram officiel | Public | MIT, version principale actuelle v5 |
| Python SDK | Deepgram officiel | Public | Selon la licence d’entrepôt |
| .NET SDK | Deepgram officiel | Public | MIT |
| Go SDK | Deepgram officiel | Public | MIT |
| Java SDK | Deepgram officiel | Public | MIT |
| Rust SDK | communauté | Public | Ce n’est pas le même niveau de soutien officiel |
| Voice Agent SDK | Deepgram officiel | Public | MIT |
| Poids du modèle et plateforme cloud | Deepgram | Pas open source | Produits commerciaux |
Langues et plateformes prises en charge
| Capacité | Langue ou plateforme | Statut public | Précautions à prendre |
|---|---|---|---|
| Reconnaissance vocale Nova | Plus de 45 langues | Soutien | Les fonctionnalités spécifiques varient en fonction du modèle et de la langue. |
| Nova-3 Multilingual | Descriptions de produits en plus de 50 langues | Soutien | Détection automatique de langue |
| Flux STT Multilingual | 10 langues | Soutien | Pour les conversations en temps réel |
| Flux TTS | Voix anglaise actuelle | Soutien | D’autres langues sont encore en cours de planification |
| API cloud | Serveur et WebSocket | Soutien | Les points d’extrémité régionaux diffèrent |
| Self-Hosted | Linux x86-64 et GPU NVIDIA | Soutien aux entreprises | Les exigences en matière de matériel varient selon le modèle. |
| SDK pour mobile | Pas d’application consommateur indépendante | Par intégration backend ou Web | La clé ne peut pas être placée dans le client. |
Avantages du produit
- De STT, TTS à Voice Agent : une pile vocale cohérente.
- Flux intègre la fin des tours et les retours d’interruption dans le modèle de dialogue, réduisant ainsi le collage externe.
- Nova-3 couvre la transcription en temps réel et par lots, et offre un enrichissement multilingue et terminologique.
- La facturation par seconde évite les gaspillages dus à l’arrondi vers le haut en fonction des minutes fixes.
- Une ligne de crédit gratuite de 200 dollars est offerte pour effectuer une évaluation de données réelles.
- Les options de déploiement en gestion déléguée, régional, VPC, local et SageMaker sont assez complètes.
- Le SDK officiel prend en charge de nombreux langages serveur populaires et met son code source à disposition.
- La sécurité des entreprises, les accords médicaux et les options de stockage des données en UE sont assez clairs.
Restrictions d'utilisation et précautions
- La précision du modèle est affectée par la langue, l’accent, le bruit, le matériel, les conditions à distance et le chevauchement des paroles.
- Les prix promotionnels et les offres gratuites à durée limitée ont une date de fin clairement définie, tandis que les coûts à long terme doivent être estimés au tarif standard.
- La somme des durées de chaque canal stéréo peut facilement conduire à une sous-estimation des coûts.
- Certaines fonctionnalités d’amélioration de la transcription et l’Audio Intelligence sont facturées en supplément.
- La concurrence par défaut est limitée par projet, et il n’est pas possible de l’éviter en créant davantage de projets.
- L’agent vocal doit valider les autorisations, les paramètres et la confirmation de l’utilisateur lorsqu’il exécute des actions externes.
- Les modèles d’émotions et d’intentions peuvent présenter des biais et ne doivent pas servir de seul critère de décision.
- L’hébergement auto-géré nécessite une GPU, Linux, la gestion de conteneurs, des connexions autorisées et un contrat d’entreprise.
- Le fait que l’SDK officiel soit open source ne signifie pas que les modèles de voix ou la plateforme puissent être déployés en privé gratuitement.
- Les informations médicales, juridiques, financières et d’identité importantes doivent encore faire l’objet d’une vérification manuelle.
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Deepgram |
| Société de développement | Deepgram, Inc. |
| Type d’outil | Reconnaissance vocale, synthèse vocale et plateforme Voice Agent |
| Modèle principal | Nova-3, Flux STT, Flux TTS, Aura-2 et Aura-1 |
| Interface principale | API REST et API WebSocket |
| Limite gratuite | Nouveau compte : limite de crédit de 200 dollars |
| Modèle de prix | Payant, prépaiement annuel Growth et personnalisé Enterprise |
| Seuil de croissance | À partir de 4 000 dollars par an |
| Déploiement principal | Hébergé, cloud régional, VPC, auto-hébergé et SageMaker |
| Soutien en chinois | Soutien de la série Nova, les capacités spécifiques doivent être consultées dans le tableau des langages du modèle. |
| Faut-il s’inscrire ? | Oui |
| Fournit-on une API ? | Oui |
| SDK officiel | JavaScript, Python, .NET, Go, Java, etc. |
| GitHub officiel | Oui |
| Le SDK est-il open source | Oui, plusieurs SDK officiels utilisent MIT. |
| Le produit est-il open source | Non |
Indice de recommandation
Le score de recommandation est de 4,7 sur 5. Deepgram couvre l’ensemble du processus de production, allant de la transcription en temps réel au TTS dialogué et aux agents vocaux complets, offrant une gamme complète de modèles, de documents, d’SDK, ainsi que des options de déploiement régional et local.
Le défi réside dans le grand nombre de lignes de produits et de dimensions de facturation ; la fin des promotions, les canaux audio, les fonctionnalités supplémentaires et le nombre de connexions simultanées peuvent tous modifier le coût total. La méthode la plus fiable consiste à utiliser un crédit de 200 dollars pour évaluer une charge réelle de référence, puis à estimer le budget de production en fonction du prix standard.
Questions fréquentes
Deepgram est-il gratuit ?
Les nouveaux comptes bénéficient d’une ligne de crédit gratuite de 200 dollars, sans carte de crédit, et selon le site officiel, elle n’a pas de date d’échéance fixe. Une fois cette ligne de crédit épuisée, des frais sont facturés en fonction de l’utilisation réelle.
Combien coûte la reconnaissance vocale Deepgram ?
Le prix actuel promotionnel en temps réel pour Nova-3 en langue unique est de 0,0048 dollar américain par minute, et pour l’audio préenregistré, de 0,0043 dollar américain par minute. Les prix varient pour les langues multiples, Flux et les fonctionnalités supplémentaires.
Flux TTS est-il gratuit à vie ?
Non. Flux TTS est gratuit uniquement pendant une période limitée jusqu’au 12 septembre 2026 ; à partir du 13 septembre, le tarif standard Pay As You Go est de 0,0450 dollar américain par 1000 caractères.
Comment est facturée l’API Voice Agent ?
La facturation se fait en fonction du nombre de minutes de conversation et de la combinaison LLM/TTS choisie. Le tarif actuel pour l’offre Standard est de 0,056 dollar par minute, et passera à 0,075 dollar une fois l’offre terminée.
Est-ce que c’est compatible avec le chinois ?
La série Nova prend en charge le chinois et d’autres langues, mais les fonctionnalités de reconnaissance spécifiques, les options de modèles et la disponibilité par région dépendent de la liste linguistique la plus récente. Les projets en chinois doivent toujours être testés pour les accents, les mots anglais intégrés et les termes spécialisés.
Peut-on l’installer localement ?
Oui, les clients Enterprise peuvent l’héberger eux-mêmes dans une VPC, sur du bare metal ou sur une plateforme de conteneurs, ou le déployer via Amazon SageMaker. Le matériel nécessite généralement Linux et des GPU NVIDIA.
Deepgram enregistre-t-il l’audio ?
La conservation et la suppression des données clients dans le cloud sont gérées conformément aux accords commerciaux. Une demande typique d’hébergement propre n’envoie pas d’audio ou de transcriptions à Deepgram, mais communique des métadonnées sur la consommation.
Peut-on se retirer du programme d’amélioration du modèle ?
Oui, les clients Pay As You Go et Growth peuvent choisir de s’inscrire ou de se désinscrire ; à partir de mars 2026, le retrait n’affectera pas les prix affichés sur le site officiel.
Comment est facturé le multicanal ?
Calculé sur la durée totale de traitement de tous les canaux. Un audio stéréo de 10 minutes sera facturé comme s’il s’agissait de 20 minutes de traitement.
Quels SDK sont fournis ?
L’entreprise maintient officiellement des SDK pour JavaScript, Python, .NET, Go et Java, et fournit des paquets navigateur liés à Voice Agent. Le SDK Rust est un projet communautaire.
Deepgram est-il open source ?
Les produits et les modèles ne sont pas open source. Plusieurs SDK officiels utilisent la licence MIT, ce qui signifie uniquement que le code d’accès au client est ouvert.
Résumé
Deepgram convient aux équipes de développement ayant besoin d’une reconnaissance vocale en temps réel de niveau professionnel, d’une synthèse vocale conversationnelle et d’agents vocaux, et peut également répondre aux exigences de données et de déploiement des entreprises grâce à des endpoints régionaux et à des services auto-hébergés. Nova-3 est adapté à la transcription générale, tandis que Flux convient mieux aux conversations en temps réel nécessitant le traitement des tours de parole et des interruptions.
Avant le lancement, il convient de vérifier en même temps la précision, le délai, la concurrence, les canaux audio, les fonctionnalités supplémentaires ainsi que le coût standard après la fin des promotions. L’open source du SDK abaisse la barrière à l’entrée, mais les modèles, les services cloud et les conteneurs auto-hébergés restent des produits commerciaux.
Outils similaires à Deepgram

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164