




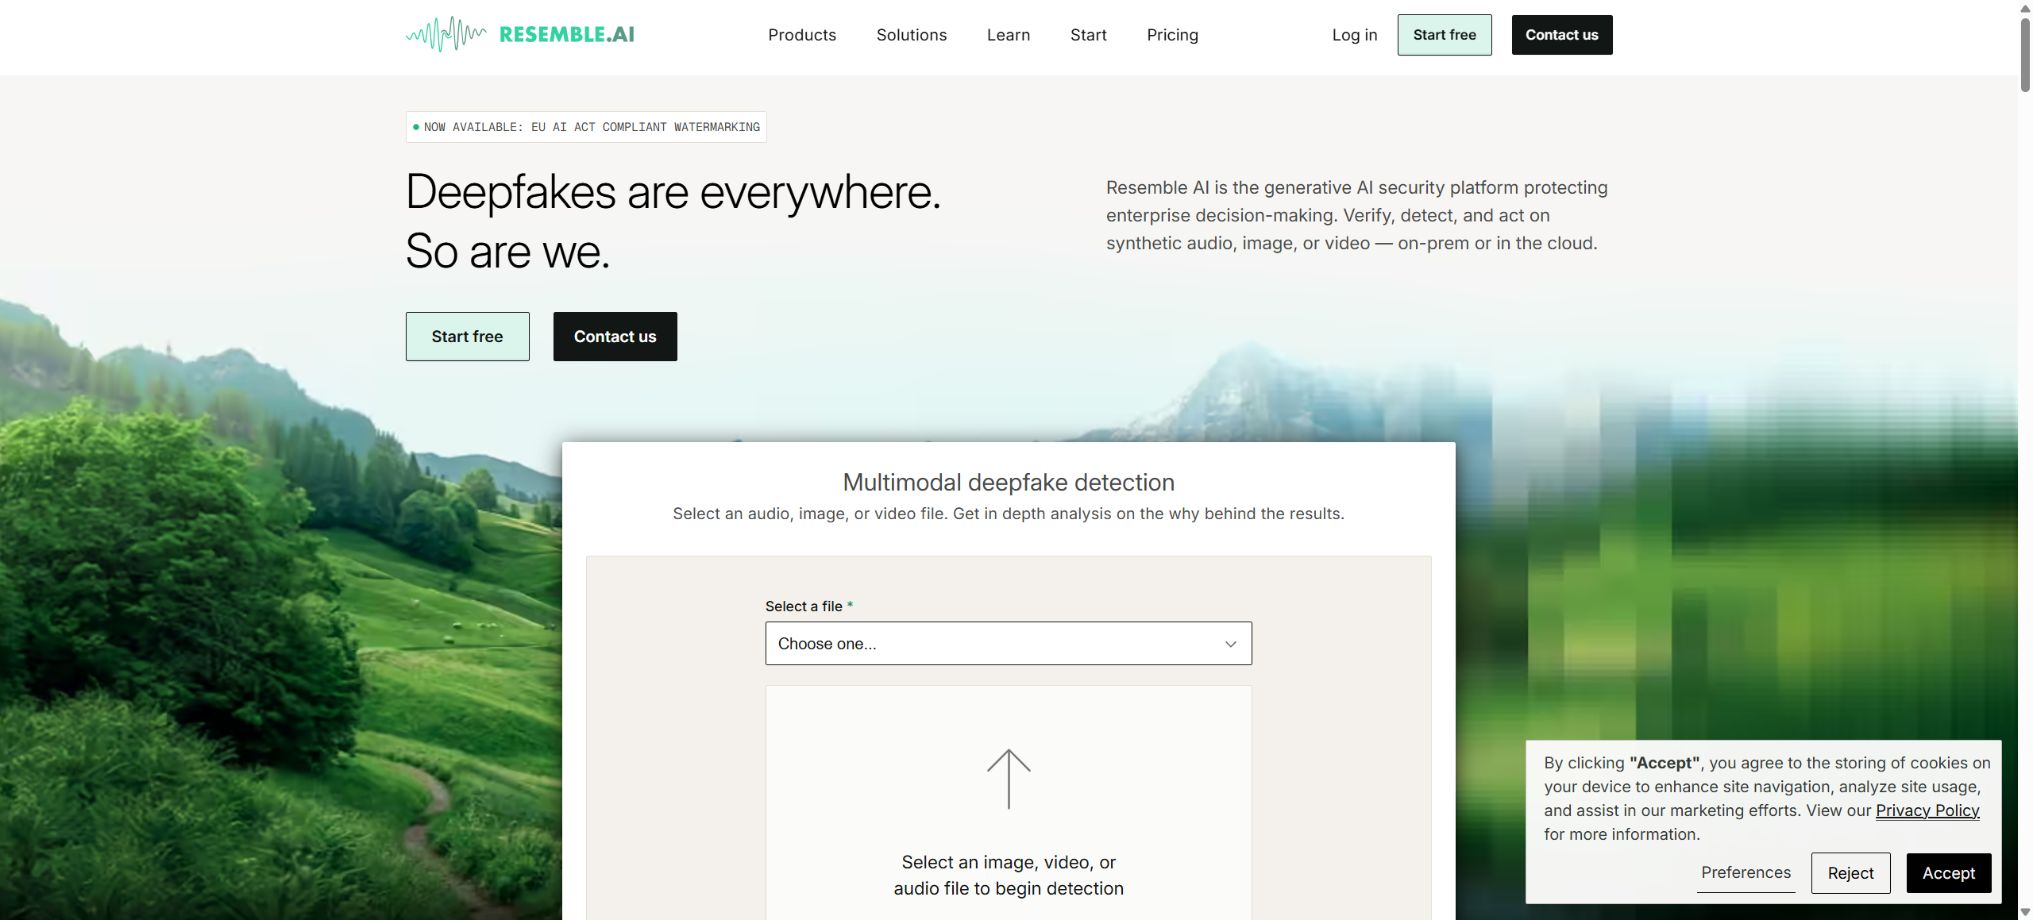
Resemble AI
Plateforme audio offrant la clonation, la génération, la détection de voix et des API d’entreprise
Étiquettes :Outils audio IAQu’est-ce que Resemble AI ?
Resemble AI est une plateforme qui couvre à la fois la génération de voix par l’IA et la sécurité des médias génératifs. Ses capacités de création et de développement comprennent la transcription texte-voix, le clonage de voix, la conception de sons à partir de texte, la transcription voix-voix, la transcription vocale, l’amélioration de l’édition audio et des agents vocaux en temps réel ;
Les capacités de sécurité comprennent la détection des Deepfake audio, d’image et vidéo, l’interprétation de ces détections, l’analyse en temps réel des conférences, l’enregistrement et la correspondance des identités, la signature C2PA ainsi que les watermarks indétectables.
La positionnement du produit est passé d’un simple outil de doublage par IA à une plateforme intégrée de « génération, validation et détection ». Les équipes de contenu peuvent créer une voix de marque et des commentaires multilingues, les développeurs peuvent accéder à la voix en temps réel via des API, tandis que les équipes de sécurité peuvent envoyer des médias suspects dans le processus de détection et conserver les résultats d’audit.
Ressemble à Ultra Text-to-Speech
Resemble Ultra est le modèle de synthèse vocale par défaut utilisé par les plateformes de hébergement actuelles pour la création et la mise à niveau de sons, et prend en charge une génération synchrone ainsi que des sorties en flux HTTP et WebSocket. L’API sélectionne automatiquement le modèle associé en fonction du voice_uuid ; les développeurs ne doivent pas passer resemble-ultra en tant que paramètre de modèle ordinaire de force.
Les versions anciennes d’hébergement Chatterbox, Chatterbox Turbo, Chatterbox Multilingual ainsi que les versions TTS antérieures sont indiquées dans la documentation officielle comme désormais hors service ; celles qui restent liées aux modèles anciens nécessitent une mise à niveau vers Ultra pour continuer à générer du son. Avant la migration, il convient de vérifier à nouveau la qualité du son, la prononciation, le délai et la compatibilité avec les projets.
Clonage de voix
La clonage de voix permet de créer des sons réutilisables à partir d’enregistrements clairs d’environ 10 secondes. L’API permet soit de télécharger l’audio complet en une seule fois pour l’entraînement, soit de créer la voix puis de télécharger les enregistrements par lots, recevant ensuite une notification lorsque l’entraînement est terminé via un callback.
L’API de clonage exige actuellement un plan Business ou supérieur.
De petits échantillons permettent de créer rapidement des sons, mais le bruit ambiant, la musique, le réverbère, les voix superposées et une compression excessive réduisent la similarité. Toute voix humaine doit faire l’objet d’un accord explicite de la personne concernée, avec définition des scénarios d’utilisation, de la durée, des membres de l’équipe, de la suppression du modèle et de la portée des contenus dérivés.
Design sonore
Le Voice Design ne nécessite pas d’enregistrements audio réels. L’utilisateur décrit par des mots l’âge, l’accent, le ton, le style et l’usage du personnage ; le système génère alors 3 voix candidates. Après écoute, la candidate choisie est convertie en voice_uuid utilisable pour TTS.
La conception sonore convient aux personnages de fiction, aux prototypes et aux projets où il est impossible d’enregistrer des personnes réelles, mais elle ne garantit pas que la voix candidate soit totalement déconnectée de personnes réelles. Les marques et les projets de jeux doivent néanmoins effectuer une vérification de similarité et conserver les paramètres finaux du candidat retenu ainsi que ceux générés.
Parole en parole
La transcription voix en voix convertit le rythme, le ton et l’interprétation de l’enregistrement d’entrée en une voix cible, ce qui est adapté aux personnages en temps réel, aux jeux, aux révisions de doublage et aux agents vocaux. Le document actuel liste Core STS v2 et v1, où v2 améliore le suivi du pitch et prend en charge 48 kHz ; les données d’entraînement exigent généralement plus de 10 minutes.
Le STS conserve mieux l’aspect performatif que la génération de texte pur, mais il ne résout pas automatiquement les problèmes de bruit d’entrée, d’erreurs de parole et de droits d’auteur. L’autorisation doit être obtenue tant pour le locuteur d’entrée que pour la voix cible ; en outre, les scénarios en direct nécessitent une détection des abus et une capacité d’arrêt manuel.
Synchronisation, API en flux HTTP et WebSocket
L’interface synchrone renvoie l’audio complet en une seule fois, ce qui convient aux phrases courtes et aux tâches hors ligne ; l’interface HTTP en flux génère et renvoie les données WAV au fur et à mesure, et inclut des timestamps de morceaux et de phonèmes dans l’en-tête du fichier.
WebSocket maintient une connexion longue durée pour retourner des trames audio de manière continue avec un délai plus faible.
Actuellement, WebSocket est destiné aux solutions Business et supérieures ; par défaut, il autorise généralement 20 sessions simultanées par cluster et 20 connexions parallèles par clé API. La concurrence ne correspond pas au nombre de requêtes par seconde ; les développeurs doivent encore gérer les erreurs de capacité, les tentatives de reprise différée, les interruptions de connexion et les messages audio_end.
Agent vocal en temps réel
Les agents en temps réel peuvent combiner des voix Resemble avec des prompts, une base de connaissances, des outils, des Webhook et des numéros de téléphone, afin d’être utilisés pour le service client, les réservations, les ventes, les PNJ dans les jeux et la formation interactive. Le système prend en charge l’API des agents, les appels d’outils, la base de connaissances et l’accès téléphonique.
La naturalité vocale des agents en temps réel ne peut pas remplacer la fiabilité des faits. Lorsqu’il s’agit de comptes, de paiements, de soins médicaux, de questions juridiques ou de vérification d’identité, il convient de limiter les permissions des outils, d’établir une transmission par un interlocuteur humain, de confirmer les opérations sensibles et de conserver des journaux d’audit.
Édition, amélioration et transcription audio
Audio Edit permet d’effectuer une édition asynchrone des fichiers audio générés par ses propres sons non commerciaux, Audio Enhancement sert à réduire le bruit et à améliorer la clarté de la voix, tandis que Speech to Text permet de créer et de consulter des tâches de transcription. Ils sont adaptés pour nettoyer les enregistrements, créer des sous-titres et reprendre des commentaires locaux.
L’amélioration peut modifier les détails du timbre sonore, et la transcription peut également mal interpréter les noms de personnes, les chiffres et les termes techniques. Les documents importants doivent conserver leur version originale et être vérifiés manuellement ; on ne doit pas considérer les résultats du traitement comme une preuve infaillible.
Détection multimodale des deepfake
Resemble Detect est conçu pour le son, les images et la vidéo ; il analyse des traces telles que le TTS, le clonage de voix, le remplacement de visage et les images génératives, et peut fournir des résultats fiables ainsi que des informations explicatives lors du téléchargement de fichiers, via une API ou dans des processus en temps réel. Actuellement, DETECT-3B Omni est positionné comme un modèle de détection d’entreprise couvrant ces trois types de médias.
La conclusion du test est une évaluation probabiliste ; la compression, le montage, la réenregistrement, de nouveaux modèles ainsi que les traitements adversariaux peuvent tous entraîner des erreurs de jugement. Dans les scénarios à haut risque, il ne faut pas refuser automatiquement un utilisateur en se basant uniquement sur un score ; il convient de prendre en compte l’origine, l’authentification, une vérification manuelle et une procédure de recours.
Resemble Intelligence et Meetings
Intelligence permet d’offrir une analyse plus approfondie des résultats de détection, Meetings permet de surveiller en temps réel les médias suspects lors des réunions. Team inclut des fonctionnalités d’analyse de réunion, tandis que Business ajoute une intégration avec le calendrier au niveau de l’organisation ainsi que des notifications de sécurité pour les réunions.
La surveillance des réunions implique l’enregistrement audio, vidéo et les métadonnées des participants. L’organisation doit informer au préalable, limiter la durée de conservation et se conformer aux règles en vigueur dans sa région concernant l’enregistrement, la vie privée et la surveillance des employés.
Recherche d’identité
L’API d’identité permet d’enregistrer l’identité d’une personne ou d’une marque, de lier des médias de référence, et de rechercher si le contenu téléchargé correspond aux entités enregistrées, afin de détecter les usurpations, les voix non autorisées ou les matériaux de marque. Elle peut servir de couche de signalisation pour le KYC, la modération du contenu et la protection des droits des talents.
Une similarité d’identité ne suffit pas à prouver une fraude à elle seule, et une mauvaise correspondance peut également affecter des utilisateurs légitimes. Les systèmes de production nécessitent une calibration de seuils, une authentification secondaire et une vérification manuelle ; on ne peut pas considérer la recherche d’identité comme la seule conclusion issue de la biométrie.
Marque d’eau PerTH et C2PA
Resemble Watermarker permet d’encoder et de décoder des marques insensibles pour les médias, tandis que le projet PerTH se concentre sur les watermark neuronaux audio, dans le but de pouvoir identifier l’origine même après compression et éditions courantes. La plateforme prend également en charge la vérification des SynthID ainsi que la signature des enregistrements C2PA.
Les filigranes conviennent pour prouver l’origine du contenu marqué, mais l’absence de détection de filigrane ne signifie pas nécessairement que le fichier est authentique, car des outils tiers n’ont peut-être jamais inséré de marques compatibles. La meilleure pratique consiste à combiner filigranes, certificats de contenu, détection de deepfake et historique de publication.
Forfait gratuit flexible
La cotisation pour Flex est de 0 dollar, aucune carte de crédit n’est requise. Elle comprend 1 place pour l’équipe, la plateforme et l’API, la détection d’audio, d’image et de vidéo, l’interprétation des détections, l’enregistrement des identités, la détection en temps réel des réunions, la vérification SynthID et la signature C2PA. Les utilisateurs rechargent des Credits puis paient en fonction du volume réel de traitement, sans engagement minimum ; les Flex Credits ne expirent pas pour le moment.
0 dollar signifie qu’il n’y a pas de frais de abonnement mensuel, mais cela ne veut pas dire que tout le traitement est gratuit. La génération de voix, la détection, la recherche d’identité et l’ajout de watermark consomment du solde selon les tarifs correspondants ; il convient de vérifier dans la console, avant achat, les tarifs de génération qui ne figurent pas sur la page publique.
Comparaison des prix et des versions
| Forfait ou version | Prix, plafonds et avantages clés |
|---|---|
| Prix de l’équipe | Team coûte 350 dollars par mois ; en paiement annuel, cela représente en moyenne 280 dollars par mois, soit 3360 dollars pour l’année, ce qui économise 840 dollars par rapport au paiement mensuel sur une année. Il comprend 5 postes, toutes les fonctionnalités Flex, des tarifs réduits pour des volumes plus faibles pour certains services, Intelligence des réunions, ainsi que la possibilité de télécharger de gros fichiers en masse. Team convient aux équipes de taille moyenne qui souhaitent mettre en œuvre des outils de détection en production, mais il ne comprend pas SSO, un calendrier de réunions au niveau de l’organisation ni d’SLA entreprise. La remise pour paiement annuel nécessite un engagement annuel à payer d’un seul coup. |
| Prix d’affaires | Business : 1000 dollars par mois ; en paiement annuel, cela représente en moyenne 800 dollars par mois, soit 9600 dollars pour l’année, ce qui économise 2400 dollars par rapport au paiement mensuel sur toute l’année. Il comprend 20 postes, une configuration ajustable en fonction du déploiement, une intégration avec le calendrier au niveau de l’organisation, des notifications de sécurité pour les réunions et SSO. Business est également le niveau d’accès actuel pour l’API de clonage de voix et la voix en flux WebSocket. Si les dépenses mensuelles dépassent 1000 dollars, qu’une plus grande concurrence est nécessaire ou qu’un déploiement local est requis, il est recommandé de contacter le service des ventes pour évaluer les prix par volume pour les entreprises. |
| Vérification et traitement sécurisé des prix | Dans Flex, le détecteur d’audio et d’image coûte 0,035 dollar par seconde, le détecteur de vidéo 0,07 dollar par seconde, et l’intelligence artificielle 0,025 dollar par seconde. Dans les plans Team et Business, le détecteur d’audio et d’image coûte 0,015 dollar par seconde, celui de vidéo 0,03 dollar par seconde, et l’intelligence artificielle 0,015 dollar par seconde. La recherche d’identité coûte 0,0005 dollar par appel, le codage du watermark 0,0005 dollar par opération, et le décodage 0,0002 dollar par opération ; ces trois services ont actuellement le même tarif dans Flex, Team et Business. La présentation des prix en « par seconde » pour les images correspond à la manière dont le tableau des prix officiel est affiché ; les unités de facturation réelles et le calcul en fonction du fichier doivent se baser sur la console. |
| Comment évaluer le prix de la génération de voix gérée ? | La page des prix actuellement publiée présente principalement les solutions de sécurité pour les médias génératifs ainsi que les frais de traitement, sans indiquer dans le même tableau les tarifs unitaires complets pour Resemble Ultra TTS, la clonage, STS et Agent. Par conséquent, le catalogue ne doit pas retenir les prix de génération par seconde des anciens blogs ou des forfaits historiques. Les utilisateurs ayant besoin de génération vocale doivent s’inscrire sur Flex pour consulter les tarifs en temps réel, ou demander une estimation aux commerciaux en fonction du langage, de la durée, de la concurrence et du mode de déploiement. Lors de la planification budgétaire, il convient de calculer séparément la génération, l’hébergement en flux continu, le clonage, les appels via Agent ainsi que les tests de sécurité. |
Prix de l’équipe
Abonnement mensuel pour l’équipe : 350 dollars ; abonnement annuel, soit en moyenne 280 dollars par mois, soit 3360 dollars pour l’année, ce qui représente une économie de 840 dollars par rapport à un paiement mensuel sur toute l’année.
Il comprend 5 postes, toutes les fonctionnalités Flex, des tarifs plus bas pour des volumes de service réduits, l’intelligence pour les réunions, ainsi que la possibilité de télécharger de gros fichiers et en masse.
Team convient aux équipes de taille moyenne souhaitant mettre en production des tests, mais ne comprend pas SSO, un calendrier de réunions au niveau de l’organisation ni d’SLA d’entreprise. La remise pour paiement annuel nécessite un engagement annuel à payer d’un seul coup.
Prix d’affaires
Abonnement Business : 1000 dollars par mois ; en paiement annuel, cela revient à 800 dollars par mois, soit 9600 dollars pour l’année, ce qui représente une économie de 2400 dollars par rapport au paiement mensuel sur toute l’année.
Il comprend 20 postes, une configuration adaptable en fonction du déploiement, une intégration avec le calendrier au niveau de l’organisation, des notifications de sécurité pour les réunions et SSO.
Business représente également le niveau d’accès actuel pour les API de clonage de voix et la transmission de voix en flux WebSocket. Si les dépenses mensuelles dépassent 1000 dollars, ou si l’on a besoin d’une plus grande concurrence ou d’un déploiement local, il est recommandé de contacter le service des ventes pour évaluer les prix par volume pour les entreprises.
Solution d’entreprise Enterprise
Offre sur mesure d’Enterprise, avec des remises sur la capacité, des SLA entreprise, un entraînement de modèles personnalisés, un déploiement local, un support exclusif, des documents SOC 2 et des licences personnalisées. Une forte concurrence, l’isolation des données, le cloud privé ou des environnements isolés exigent généralement un contrat entreprise.
Le déploiement local n’est pas inclus automatiquement dans une abonnement public ; lors de l’achat, il convient de confirmer par écrit le modèle, les modalités de détection, le matériel, la fréquence des mises à jour, la conservation des journaux, le délai de réponse au support et la portée de la licence.
Vérification et traitement sécurisé des prix
Pour Flex, la détection d’audio et d’images coûte 0,035 dollar par seconde, la détection de vidéo 0,07 dollar par seconde, et l’intelligence artificielle 0,025 dollar par seconde. Pour Team et Business, la détection d’audio et d’images coûte 0,015 dollar par seconde, celle de vidéo 0,03 dollar par seconde, et l’intelligence artificielle 0,015 dollar par seconde.
La recherche d’identité coûte 0,0005 dollar par appel, le codage Watermarker 0,0005 dollar par appel, et le décodage 0,0002 dollar par appel ; ces trois services ont actuellement le même prix pour Flex, Team et Business. L’affichage des images par « seconde » correspond à la méthode de facturation indiquée dans le tableau des prix officiels ; les unités de facturation réelles et le calcul en fonction du fichier doivent se baser sur la console.
Comment évaluer le prix de la génération de voix gérée ?
La page des prix actuellement publiée présente principalement les solutions de sécurité pour les médias génératifs ainsi que les frais de traitement, sans indiquer dans le même tableau les tarifs par unité d’utilisation complets pour Resemble Ultra TTS, la clonage, STS et Agent. Par conséquent, le catalogue ne devrait pas retenir les prix de génération par seconde des anciens blogs ou des forfaits historiques.
Les utilisateurs ayant besoin de génération de voix doivent s’inscrire sur Flex pour consulter les tarifs en temps réel, ou demander à un commercial une estimation en fonction du langage, de la durée, du nombre de connexions simultanées et du mode de déploiement. Lors de la planification budgétaire, il convient de calculer séparément la génération, les hébergements en flux continu, le clonage, les téléphones Agent et les tests de sécurité.
Modèle open source Chatterbox
Resemble AI a rendu publique sur GitHub la série de modèles vocaux Chatterbox. Le répertoire actuel contient Chatterbox Turbo, doté de 350 millions de paramètres, conçu pour un faible délai de réponse en anglais et avec des tags de performance.
Nano avec des paramètres de 110 M, pouvant fonctionner sur des CPU et des appareils à ressources limitées ; ainsi que Multilingual V3 avec des paramètres de 500 M, prenant en charge 23 langues y compris le chinois, et divers packs de fine-tuning monolingues.
Le code et le modèle Chatterbox sont soumis à la licence MIT ; ils peuvent être utilisés pour des projets personnels, de recherche ou commerciaux, ainsi que pour être hébergés dans des produits propriétaires, mais il est toujours nécessaire de conserver l’avis de licence et de respecter les lois applicables ainsi que les exigences de consentement. La plateforme d’hébergement Resemble Ultra et Chatterbox open source constituent deux lignes de produits ; la documentation officielle actuelle indique clairement que l’ancienne version hébergée de Chatterbox est en cours de suppression des services.
Projets open source PerTH et Resemble Enhance
GitHub officiel met également à disposition l’outil de watermarking audio PerTH sous licence MIT, ainsi que Resemble Enhance pour le bruit et l’amélioration du son. Les développeurs peuvent tester localement l’extraction des watermarks et le traitement audio, mais cela ne signifie pas que Detect, Identity, Meetings et la plateforme d’hébergement soient eux-mêmes open source.
Les exemples open source et certains anciens SDK peuvent avoir cessé d’être maintenus ; par exemple, le SDK officiel Go a été marqué comme obsolète. Les nouveaux projets doivent se référer à la documentation API actuelle ainsi qu’à la page des bibliothèques client, et verrouiller une version avant mise à niveau pour effectuer des tests de régression.
Guide d’utilisation de Resemble AI
Terminer une tâche de base
- Inscrivez-vous sur Resemble AI et créez une clé API réservée uniquement à l’environnement de test ;
- Sélectionner le modèle en fonction du type d’entrée, du contexte, de la qualité, de la vitesse et du prix ;
- Appeler d’abord Resemble Ultra Text-to-Speech pour effectuer la requête minimale et vérifier la structure de réponse ;
- Tester ensuite la sortie en flux, les paramètres et les réponses aux anomalies par clonage vocal ;
- Enregistrer les tokens, le nombre d’appels, le délai, le taux d’erreurs et le coût par appel ;
- Transférez la clé dans le gestionnaire de clés du serveur avant de l’intégrer à l’application officielle ;
Créer des flux de travail professionnels réutilisables
- Utiliser des clés et des quotas différents pour les environnements de développement, de test et de production ;
- Créer un ensemble d’évaluation représentatif en utilisant Resemble Ultra pour la synthèse vocale, le clonage de voix et Voice Design pour la conception sonore ;
- Définir les délais d’attente, la concurrence, les tentatives de réessai, le throttling et les plafonds budgétaires ;
- Effectuer des vérifications sur la sortie en ce qui concerne les faits, la sécurité, le format et les informations sensibles ;
- Surveiller les changements de version, de prix, de délai et de taux d’échec des modèles de surveillance ;
- Préparer des plans de dégradation du modèle, de coupure et de prise en main manuelle ;
À qui s’adresse-t-il ?
- Équipe de contenu nécessitant une voix de marque, des personnages de jeu et des commentaires multilingues ;
- Développeurs de agents vocaux à faible latence, de services client et d’applications interactives ;
- Équipe de sécurité et de contrôle des risques chargée de vérifier l’authenticité des audio, des images et des vidéos ;
- Organisation qui protège l’identité des acteurs, des marques et des dirigeants contre les usurpations ;
- Équipe de recherche et d’ingénierie souhaitant gérer en autonomie les modèles vocaux MIT.
Avantages du produit
- Intégrer la génération de voix, l’identité, les watermark et la détection des Deepfake sur une même plateforme ;
- Ressemble Ultra couvre la synchronisation ainsi que deux types de TTS en flux ;
- Prend en charge le clonage rapide de la voix, le Voice Design et la transcription vocale ;
- La détection couvre l’audio, les images et la vidéo, et fournit des informations explicatives ;
- Flex ne comporte pas de frais de abonnement mensuel, et les Credits ne expirent pas pour le moment.
- Chatterbox, PerTH et Enhance offrent des options open source auto-hébergées.
Restrictions et précautions
- L’attention portée aux prix publics actuels se porte désormais sur les produits de sécurité ; le prix unitaire complet pour la génération de voix gérée doit être vérifié dans la console.
- VoiceCloningAPI, WebSocket et certaines capacités de production exigent un niveau Business ou supérieur ; les utilisateurs débutants ne peuvent pas supposer que toutes les interfaces vocales soient accessibles gratuitement avec Flex.
- La détection des deepfake comporte des faux positifs et des faux négatifs, et l’absence de watermark ne prouve pas que le contenu est authentique.
- Clon et STS doivent obtenir une autorisation sonore ;
- La licence MIT de Chatterbox open source ne dispense pas des obligations relatives à la vie privée, aux portraits, aux droits de personnalité sonore et à la lutte contre la contrefaçon ;
Questions fréquentes
Ressemble AI est-il gratuit ?
Il existe un forfait Flex à 0 dollar par mois, sans frais de souscription, qui fonctionne selon un système de paiement à l’utilisation via des crédits rechargés. Les crédits ne expirent pas pour le moment, mais la création, la détection et l’utilisation des watermarks continuent de faire l’objet de frais.
Combien coûte Resemble AI ?
Team : 350 dollars par mois, soit 280 dollars par mois en paiement annuel ; Business : 1000 dollars par mois, soit 800 dollars par mois en paiement annuel.
Personnalisation Enterprise. Aucun frais mensuel pour Flex.
Est-il possible de cloner sa propre voix ?
Oui, une enregistrement clair d’environ 10 secondes suffit pour créer un clone rapide, mais l’API exige actuellement un plan Business ou supérieur, et l’accord du locuteur est obligatoire.
Est-il possible de détecter les Deepfake dans les vidéos et les images ?
Oui. Detect couvre actuellement l’audio, les images et la vidéo, et peut être combiné avec Intelligence, Identity, surveillance de réunion et watermarking ;
Les résultats doivent encore être vérifiés manuellement en fonction du risque.
Ressemble-t-il à AI open source ?
La plateforme de gestion et le modèle Ultra ne sont pas entièrement open source ; les modèles vocaux officiels Chatterbox, le watermark PerTH et Resemble Enhance sont fournis en tant que projets open source, parmi lesquels Chatterbox et PerTH utilisent la licence MIT.
Outils similaires à Resemble AI

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164