




Une phrase pour présenter
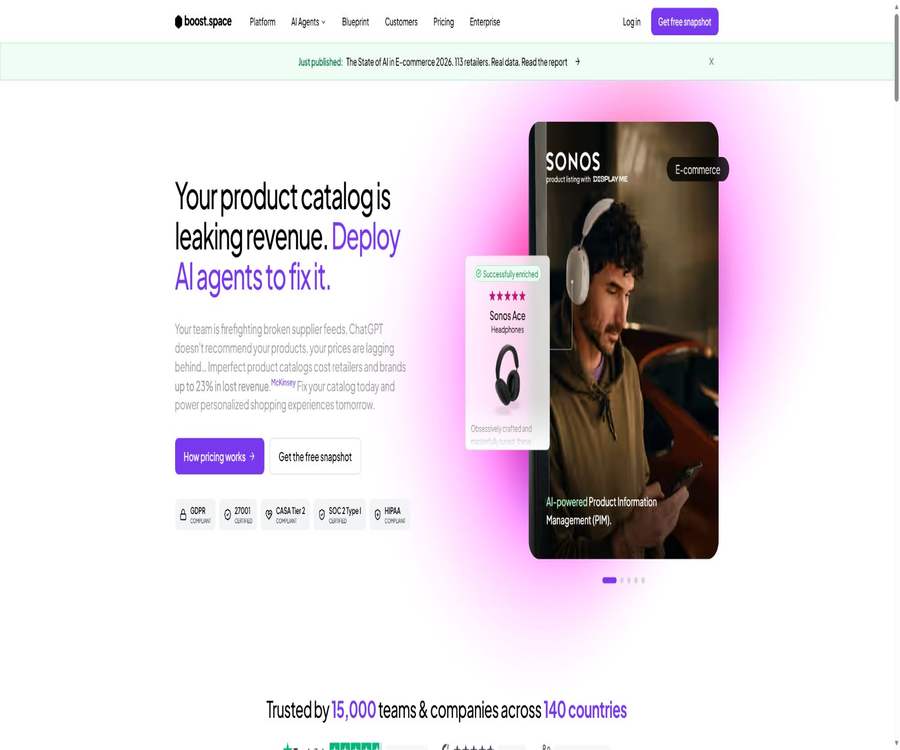
Boost.space est une plateforme d’agents de données et d’IA destinée aux commerçants en ligne, aux détaillants et aux marques, qui permet de regrouper les données dispersées dans les boutiques en ligne, les systèmes CRM, ERP, les fournisseurs et les systèmes publicitaires en une base de données en temps réel. Cela permet ensuite aux agents automatisés ou à l’IA, dans le cadre de leurs droits d’accès, de lire, de traiter et d’écrire à nouveau ces données.
Présentation des outils
Boost.space est géré par l’entreprise tchèque Boost.space s.r.o. Le site officiel met actuellement l’accent sur la gouvernance des données e-commerce et les agents IA déployables. Il ne s’agit pas d’un simple chatbot, mais plutôt d’une plateforme commerciale offrant à la fois des bases de données structurées, une synchronisation bidirectionnelle, de l’automatisation, de l’IA intégrée, un MCP à distance, des API REST et des SDK.
La plateforme souhaite résoudre des problèmes tels que le catalogue de produits incomplet, le format désordonné des données des fournisseurs, les incohérences dans les enregistrements multi-canaux, ainsi que le manque de contexte commercial fiable pour l’IA. L’équipe peut d’abord unifier la structure des données, puis confier les tâches de mise en ordre, de vérification, de tarification, de mise en ligne ou d’activation du public à des processus manuels, à des scénarios automatisés ou à des agents IA.
Architecture du produit
| niveau | effet | Exemple d’e-commerce | Caractéristiques des droits d’accès |
|---|---|---|---|
| Module | Définir un type de données, équivalent à une table dans une base de données | Produits, commandes, clients ou fournisseurs | Créé par l’administrateur avec configuration des champs et de la portée de visibilité |
| Space | Diviser des conteneurs de données indépendants dans un module | Catalogues de différentes marques, marchés ou fournisseurs | Il est possible de définir séparément les membres, les rôles et les droits d’accès. |
| Record | Enregistrer un enregistrement d’opération spécifique | Un SKU, une commande ou un client | Pouvant être filtré, associé, synchronisé et mis à jour |
| Field | Définir les attributs typés dans l’enregistrement | Prix, stock, EAN, classification ou date de publication | Le type de champ détermine les méthodes de validation, de mappage et d’automatisation. |
Les champs typés, les relations entre enregistrements et les champs clés constituent la base d’un fonctionnement fiable de la plateforme. Lorsque les champs clés sont correctement configurés, les données externes peuvent mettre à jour les enregistrements existants au lieu de créer constamment des éléments duplicats.
Fonction principale
Données commerciales unifiées
La plateforme peut regrouper les données des boutiques en ligne, du CRM, de l’ERP, des fournisseurs, des distributeurs, des plateformes publicitaires et d’autres outils commerciaux, et établir une structure unifiée grâce à des modules, des espaces, des enregistrements et des champs. Le site officiel présente actuellement 2675 intégrations natives, mais l’état d’application concrète peut varier : certaines sont prêtes à l’emploi, d’autres nécessitent une configuration supplémentaire ou un contact avec le support.
Synchronisation bidirectionnelle et suppression des doublons
Le processus de synchronisation permet d’écrire des données externes dans Boost.space, ainsi que de renvoyer vers le système connecté les enregistrements ayant été nettoyés ou mis à jour. Une fois les champs clés définis, le processus d’importation peut correspondre aux enregistrements existants, réduisant ainsi le risque d’accumulation continue de produits, de contacts ou de commandes redondantes.
Mappage et importation de l’IA
AI Mapping peut analyser les données en amont, proposer des champs cibles et des types de champs, et aider à créer une mise en correspondance d’importation. Il est recommandé de vérifier manuellement les SKU, les prix, la monnaie, les stocks et les champs clés avant l’importation officielle, afin d’éviter que des erreurs de mise en correspondance ne se propagent aux canaux en aval.
Champs d’IA et traitement des données
Le champ d’IA peut générer ou compléter les attributs des enregistrements selon des indications, tandis que les outils de texte permettent de raccourcir, d’allonger, de traduire et de réécrire. La plateforme offre également la conversion et la vérification de colonnes entières, utiles pour un nommage uniforme, le nettoyage du format, la vérification des règles ou le marquage des enregistrements non conformes.
Agent Chat et recherche sémantique
L’agent de chat intégré permet aux utilisateurs de poser des questions ou d’utiliser le système d’exploitation en langage naturel, et peut aider à créer des automatisations. Une base de données vectorielle peut établir une représentation sémantique pour un espace donné, permettant aux recherches ou aux agents de trouver des enregistrements en fonction de leur sens, plutôt que de dépendre uniquement d’une correspondance exacte des mots-clés.
Scénarios d’automatisation
L’équipe peut utiliser des déclencheurs liés à des scénarios, des recherches, des opérations, des agrégations et des étapes itératives pour permettre un flux continu de données en fonction d’un plan ou d’événements métier. Chaque action de lecture, de création ou de mise à jour peut être comptabilisée comme une opération ; lorsque la consommation atteint la limite du forfait, la synchronisation peut être suspendue.
MCP à distance
Boost.space héberge le serveur Remote MCP ; les clients AI externes peuvent se connecter aux données métier sans avoir à déployer eux-mêmes de serveur. Le proxy ne peut utiliser que les permissions accordées à l’utilisateur, ce qui lui permet de rechercher et d’écrire des enregistrements, de créer des structures, d’exécuter des opérations AI, ainsi que de déclencher des scénarios d’automatisation spécifiques une fois l’exécution sur demande activée.
API REST et SDK
L’API REST fournit des adresses de base indépendantes par locataire et utilise des tokens Bearer pour l’authentification, couvrant des ressources telles que les modules, les espaces, les enregistrements, les champs, les fichiers, les utilisateurs, les équipes, les étiquettes, les états, la base de données vectorielle et les fonctionnalités d’IA. Les développeurs peuvent utiliser la pagination, le filtrage, les plages de droits et les spécifications OpenAPI pour créer des systèmes internes ou des connecteurs personnalisés.
Agent d’IA e-commerce prêt à l’emploi
| Agent IA | Tâche principale | Entrée typique | Résultat attendu |
|---|---|---|---|
| Product Enrichment Agent | Compléter et normaliser les attributs du produit | SKU, titre, description, spécifications et images | Un registre des produits plus complet et au format cohérent |
| Supplier Product Listing Agent | Transformer les données des fournisseurs en informations sur les produits disponibles via les canaux | Formulaire de fournisseur, flux ou catalogue | Liste des produits adaptés aux canaux cibles |
| Dynamic Pricing Agent | Ajustement des prix assisté par les prix concurrentiels et les signaux commerciaux | Prix internes, informations sur la concurrence et règles | Suggestions de prix révisables ou résultats mis à jour |
| Marketplace Growth Agent | Rechercher des opportunités de croissance sur les plateformes de marché | Catalogue de produits, performance des canaux et données de marché | Produits candidats, canaux ou tâches d’optimisation |
| GEO Optimization Agent | Améliorer la visibilité du produit dans les réponses d’IA | Fiches produits, informations sur la marque et recherches ciblées | Manques de contenu et recommandations d’optimisation |
| Audience Activation Agent | Transformer les données des clients en public cible utilisable | Attributs du client, comportement et état des autorisations | Groupe de cible et données d’activation |
Le site officiel décrit ces agents comme des composants métier pouvant être déployés directement, mais leurs performances dépendent néanmoins de la qualité des données, de la couverture des champs, des droits d’accès, de la région, des règles de canal et de la validation manuelle. Lorsqu’il s’agit de prix, du public cible des publicités ou de la mise en ligne de produits, une étape d’approbation doit être maintenue et chaque modification doit être enregistrée.
Processus de création d’une base de données
- Déterminer les objets de données à unifier, tels que les produits, les commandes, les clients, les stocks ou les fournisseurs, et identifier le responsable métier pour chaque type de données.
- Créez un Module pour chaque type d’objet, puis divisez les Espaces par marque, marché, canal ou équipe.
- Configurer les champs tels que le texte, les chiffres, les montants, les dates, les relations associées, etc., et choisir un SKU stable, un numéro de commande ou une identifiante de client comme champ clé.
- Connecter une application de canal ou importer des données d’échantillon, générer une carte préliminaire à l’aide d’AI Mapping, puis vérifier manuellement chaque champ.
- Exécutez d’abord la synchronisation dans l’espace de test pour vérifier les enregistrements redondants, les valeurs nulles, les devises, les fuseaux horaires, les états et les relations associées.
- Une fois les résultats confirmés, activez la synchronisation officielle et configurez les alertes en cas d’anomalie, les journaux d’activité, les sauvegardes et les responsables.
Processus de déploiement d’agents IA
- Choisir un problème unique et quantifiable, tel que le taux d’absence d’attributs des produits, le délai de mise en ligne par le fournisseur ou le retard dans la mise à jour des prix.
- Organiser les champs requis pour l’agent, les historiques, les règles métier et l’espace cible autorisant l’écriture, en supprimant ou en isolant d’abord les données manifestement erronées.
- Seules les permissions de lecture et d’écriture nécessaires à l’exécution de la tâche sont accordées, et les données clients sensibles ainsi que les champs financiers restent au minimum visibles.
- Utiliser de petits ensembles de fichiers représentatifs pour tester les suggestions, la mise en correspondance, le format de sortie et la gestion des erreurs, sans couvrir directement l’ensemble du répertoire.
- Les responsables commerciaux vérifient les faits, le ton de la marque, la classification, les prix et les exigences de conformité, avant d’approuver la rédaction ou la diffusion.
- Suivre la précision statistique continue, le taux de modification manuelle, le temps de traitement et les indicateurs métier ; en cas de non-respect des normes, suspendre et ajuster les règles.
Accès via MCP ou API
- Créez un token API ou MCP dans les paramètres personnels, et sélectionnez la plus petite portée de permissions en fonction du module et de l’opération.
- Les utilisateurs MCP copient les informations de connexion au système exclusif et effectuent l’autorisation dans un client AI pris en charge ; les utilisateurs API, quant à eux, enregistrent l’identifiant du locataire et le jeton.
- Exécutez d’abord une requête en lecture seule pour vous assurer que l’agent ou le programme ne peut accéder qu’aux modules, espaces et enregistrements prévus.
- Ajouter une vérification des paramètres, un contrôle d’idempotence, des journaux et une confirmation manuelle pour écrire, supprimer ou déclencher des scénarios.
- Surveillez les limitations de vitesse, les tentatives de réessai, les opérations et la consommation de crédits d’IA, et concevez des stratégies d’évitement pour les erreurs 429 ou les erreurs de service.
- Lorsque l’utilisation d’un jeton change ou qu’une fuite est suspectée, un nouveau jeton est créé et l’ancien est annulé, car les permissions du jeton existant ne peuvent pas être modifiées directement.
À qui s’adresse-t-il
- Équipes e-commerce et retail : unifier les données de produits, de commandes et de stocks de plusieurs boutiques en ligne, plateformes de marché et fournisseurs.
- Responsable de la gestion des produits de marque : compléter les attributs des produits, standardiser le catalogue et réduire le temps de préparation pour la mise en ligne sur plusieurs canaux.
- Équipe des données et des opérations : nettoyage, validation, mise en relation et synchronisation des données des CRM, ERP et plateformes publicitaires.
- Conseillers et fournisseurs d’automatisation : mise en œuvre de flux de données inter-applications via des scénarios, des API ou des SDK.
- Développeur d’agents IA : Permettre aux agents d’accéder à un contexte métier en temps réel, contrôlé par des droits d’accès, grâce à MCP ou REST API.
- Entreprises de taille moyenne et grande : organisations qui ont besoin d’un environnement de déploiement dédié, de processus de gouvernance, de services de support ou de devis personnalisés.
Scénarios d'utilisation typiques
- Intégration du catalogue des fournisseurs : conversion des différents tableaux, flux et noms de champs en une structure de produits unifiée.
- Synchronisation des produits multicanal : après nettoyage des titres, des spécifications et des catégories, les résultats sont réécrits dans le système cible.
- Complétion des informations du produit : identification des couleurs, matériaux, tailles, étiquettes ou descriptions manquantes et organisation de leur vérification.
- Aide à la tarification dynamique : génération de recommandations en combinant des règles internes et des signaux externes, mais l’approbation finale du changement de prix relève du responsable.
- Activation des données clients : organiser les attributs des clients dans le cadre d’une autorisation légale et créer des publics cibles pour le marketing.
- Optimisation de la détectabilité par l’IA : vérifier si les informations sur le produit sont suffisantes pour permettre des recommandations précises dans les recherches et les questions-réponses par l’IA.
- Manipulation de données en langage naturel : permet aux équipes de rechercher des enregistrements, de mettre à jour des champs ou de créer des processus simples via Agent Chat.
- Accès via des agents internes : Permettre à ChatGPT, Claude, Cursor ou d’autres clients d’accéder et de traiter les données métier par l’intermédiaire de MCP.
Avantages du produit
- Placer les bases de données, la synchronisation, l’automatisation et les agents d’IA sur la même base de données pour réduire le nombre d’entreposages intermédiaires.
- Les champs typés, les relations entre enregistrements et les champs clés aident à améliorer la cohérence des entrées des agents.
- La synchronisation bidirectionnelle est prise en charge, permettant aux données nettoyées de retourner dans le système d’entreprise au sein d’un processus contrôlé.
- Le site officiel indique actuellement 2675 intégrations natives, couvrant les outils de e-commerce, CRM, ERP et marketing les plus courants.
- L’agent de chat intégré coexiste avec le MCP hébergé, prenant en charge à la fois les utilisateurs sans code et les clients IA externes.
- Les API REST et les SDK typés aident les développeurs à créer des interfaces personnalisées, des traitements par lots et des applications internes.
- Les permissions suivent l’utilisateur et la portée de l’espace, ce qui permet de limiter les données que l’agent peut lire et modifier.
Restrictions d'utilisation et précautions
- La valeur de la plateforme dépend fortement de la qualité des données brutes ; des clés primaires erronées, des prix obsolètes ou des champs incomplets peuvent affecter la synchronisation et les décisions des agents.
- L’écriture bidirectionnelle peut propager rapidement des erreurs au magasin, au CRM ou à l’ERP ; il est donc nécessaire de tester au préalable et de conserver des plans d’approbation et de retrait.
- Les suggestions d’IA pour compléter, traduire, valider et tarifer peuvent contenir des erreurs factuelles et ne doivent pas contourner les vérifications commerciales, juridiques ou financières.
- Les fonctionnalités d’IA consomment des crédits AI ; les scénarios automatisés peuvent également consommer des opérations. La page publique actuelle ne liste pas de manière unifiée l’ensemble des quotas.
- Lorsque l’on atteint la limite de record ou d’opération, il peut être nécessaire de supprimer les données anciennes, d’augmenter le quota ou de faire une mise à niveau ; il convient d’estimer la consommation maximale avant d’effectuer des achats.
- Une intégration partielle nécessite des paramétrages supplémentaires, un compte tiers ou des frais distincts ; le nombre d’intégrations ne signifie pas que toutes peuvent être utilisées sans aucune configuration.
- Les anciennes formules de forfaits self-service, les modules Legacy et les solutions actuelles d’agences d’entreprise peuvent apparaître simultanément dans les documents ; il ne faut pas mélanger droits et prix.
- Les clients d’IA externes créeront de nouvelles voies d’accès aux données ; il convient de vérifier les politiques de conservation des données, d’entraînement et de transfert transfrontalier propres au client.
- Les entreprises doivent confirmer avant la signature les aspects liés au stockage des données, aux sauvegardes, à leur suppression, aux sous-traitants, à la réponse aux incidents, aux SLA et à l’étendue de la preuve de conformité.
Prix et options d’achat
Le plan ci-dessous a été vérifié le 20 août 2026 sur la page des tarifs publics actuelle de Boost.space, en dollars américains. La page actuelle propose un processus d’achat pour les entreprises en trois étapes : Snapshot, Blueprint et Platform. Les détails finaux, les taxes et les engagements de service sont fixés selon la proposition de prix et le contrat.
| Phase | Prix public | cycle | Livraison principale | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Snapshot | Gratuit | Environ 24 heures | L’équipe effectue une vérification manuelle des magasins et fournit environ 2 à 3 pages de résultats, couvrant les vérifications de visibilité telles que ChatGPT, Perplexity et AI Overviews. | Les commerçants qui souhaitent d’abord identifier un catalogue de produits ou des problèmes de visibilité pour l’IA |
| Blueprint | Prix fixe de 5000 dollars | Environ 4 semaines | Environ 25 à 40 pages de rapport, un cahier des charges avec des preuves au niveau SKU et une feuille de route ; il est nécessaire d’avoir un feed de produits ainsi que la collaboration du client pendant environ 2 heures. | Détaillants ou marques qui doivent quantifier les opportunités et définir l’étendue de la mise en œuvre |
| Platform | Cotation sur mesure | Déterminé selon les résultats du Blueprint | Commencer par un intermédiaire, et définir la portée en fonction du volume de données, des canaux, des marchés et des indicateurs sur 90 jours. | Les entreprises qui se préparent à déployer des agents IA et à mesurer en continu les résultats commerciaux |
Le Snapshot est un diagnostic de magasin effectué manuellement, et ne correspond pas à un compte complet sur la plateforme, gratuit et permanent ; une fois le Blueprint terminé, le client peut conserver les livrables, sans obligation d’acheter la Plateforme. La Plateforme n’a pas de prix public uniforme, car le type d’agent, l’ampleur des données, ainsi que les canaux et le périmètre du marché influencent les coûts de mise en œuvre.
Les informations de tarification anciennes peuvent encore afficher Free, Pro, Business et Enterprise, ainsi que les limites des forfaits autonomes en termes de nombre d’enregistrements, de crédits AI et d’opérations, mais la page de tarification actuellement publiée ne présente plus ces montants fixes comme options principales d’achat. Les clients existants doivent se référer à la page de facturation de leur compte et au contrat ; il ne faut pas utiliser les anciens prix pour estimer le montant à payer par de nouveaux clients.
Les conditions actuelles décrivent également une licence temporaire gratuite de 14 jours ainsi que des abonnements mensuels, trimestriels, annuels ou des contrats sur mesure, mais il ne faut pas les confondre avec le Snapshot gratuit. Il convient de vérifier si l’inscription actuelle offre encore automatiquement une période d’essai complète au moment de l’ouverture du compte ou de la confirmation de la vente.
Crédits d’IA et consommation
| Poste de quantité | Consommation courante | Effets après atteinte de la limite maximale | Vérification avant achat |
|---|---|---|---|
| Nombre d’enregistrements | Enregistrer les produits, les commandes, les clients et d’autres enregistrements | Il est nécessaire de supprimer les anciennes entrées ou de mettre à niveau. | Quantité actuelle, taux de croissance, période de conservation historique |
| AI credits | Champs d’IA, traitement de texte, conversion, validation et autres fonctionnalités d’IA | Certaines opérations d’IA ne pourront pas se poursuivre. | Limite mensuelle, consommation par utilisation, report possible |
| Operations | Opérations de lecture, création, mise à jour, etc., dans la scène | La synchronisation peut être suspendue ou donner lieu à des besoins d’extension. | Fréquence d’exécution, nombre d’enregistrements par fois, tentatives de réessai et frais liés à des tiers |
| Administrateurs et permissions | Configuration du système et rôles de gouvernance | Soumis à un plan ou un contrat spécifique | Rôles d’équipe, principes du moindre privilège et exigences d’audit |
La documentation officielle indique que les crédits AI sont fournis mensuellement et ne s’accumulent pas, mais la page de tarification entreprise actuellement publiée ne mentionne pas de quota unique. Les clients doivent exiger qu’une offre précise indique clairement les crédits AI, les opérations, les utilisateurs ou administrateurs, le stockage, le support ainsi que les règles relatives à l’utilisation excédentaire.
Plateformes de support et intégration
| Plateforme ou interface | Soutien disponible | Utilisation principale |
|---|---|---|
| Application web | Soutien | Module de gestion, espace, enregistrements, droits d’accès, synchronisation et Agent Chat intégré |
| Intégration native | 2675 sites officiels affichés actuellement | Connecter le e-commerce, le CRM, l’ERP, les fournisseurs, la publicité et d’autres outils |
| Make automatisation | Soutien | Créer des scénarios de déclenchement, de recherche, d’écriture, d’agrégation et d’itération ; les anciennes solutions peuvent nécessiter des comptes séparés. |
| Remote MCP | Soutien | Connecter ChatGPT, Claude, Cursor, VS Code et les clients MCP universels |
| REST API | Soutien | Utiliser des programmes pour interroger, créer et mettre à jour des données commerciales structurées |
| TypeScript SDK | Instalable en public | Client API typé |
| Python SDK | Instalable en public | Fournit des clients synchrones et asynchrones, nécessite Python 3.11 ou une version ultérieure |
| SDK PHP et Go | Le document indique que l’état des paquets publics doit être vérifié. | La vue d’ensemble officielle du SDK comprend ces deux langages, mais la page d’installation indiquait auparavant qu’il était encore en préparation. |
| Application de bureau ou mobile indépendante | La localisation publique n’est pas claire. | Les principales façons d'utilisation sont la plateforme Web, l’intégration et les interfaces de développement. |
Capacités API, SDK et MCP
Les permissions du token API ne doivent pas dépasser celles de son créateur, et il est possible de limiter leur portée par module et opération. Lors du développement, il convient d’éviter d’utiliser des tokens d’administrateur global, en utilisant des tokens distincts pour les tests, la production et les proxies personnels.
| Capacité | Certification et mode d'utilisation | Adéquat pour la tâche | Limites importantes |
|---|---|---|---|
| REST API | Adresse du locataire et jeton Bearer | Intégration de systèmes, traitement en masse et applications sur mesure | Il faut gérer soi-même le pagination, les droits d’accès, les limitations de vitesse, les tentatives de réessai et l’idempotence. |
| Remote MCP | Connexion au système exclusif et autorisation de l’utilisateur | Laisser l’agent d’IA externe rechercher, écrire et exécuter des scénarios sur demande | Les capacités d’agent sont contrôlées par les droits d’accès de l’utilisateur, et le client lui-même possède également des règles de confidentialité. |
| Agent Chat | Utiliser directement dans l’application Boost.space | Requêtes en langage naturel, modification de données et aide à la création automatisée | Les résultats doivent encore être vérifiés et consomment des ressources d’IA correspondantes. |
| TypeScript SDK | Installer le client typé officiel | Intégration de Node.js ou de services front-end | La compatibilité des versions et l’état de publication publique doivent être vérifiés selon la documentation du SDK. |
| Python SDK | Installer boostspace-sdk | Tuyaux de données, scripts et services backend | Le paquet actuellement disponible est en version Beta et exige Python 3.11 ou supérieur. |
Sécurité des données et vie privée
Le site officiel présente actuellement des informations sur la conformité au RGPD, à ISO 27001, à CASA Tier 2, à SOC 2 Type I et à HIPAA. Lors des achats, les entreprises doivent demander des rapports ou des certifications adaptés au produit réel, à la zone de déploiement et au partenaire contractuel ; il ne faut pas se fier uniquement aux badges du site pour penser que toutes les charges de travail sont automatiquement conformes.
La politique de confidentialité indique que Boost.space peut agir en tant que responsable ou traitant dans différents contextes, et que le client décide généralement de l’objectif du traitement des données commerciales qu’il soumet. Lors de la connexion à des composants tiers tels que Make, à des environnements cloud ou à des clients d’IA externes, il convient également de vérifier les rôles des données de chacune des parties, les sous-traitants et les dispositions relatives aux transferts transfrontaliers.
- Avant la signature, confirmer la région de stockage des données, l’emplacement des sauvegardes, la durée de conservation, le processus de suppression et la capacité d’exportation des données.
- Il est demandé de fournir le protocole de traitement des données, la liste des sous-traitants, le rapport de sécurité ainsi que les délais de notification en cas d’incident.
- Les champs sensibles sont collectés selon le principe du minimum nécessaire, et l’accès y est restreint par l’espace, les rôles et la portée des tokens.
- L’agent d’IA utilise d’abord des échantillons démasqués pour les tests, tandis que les écritures, les suppressions et les modifications de prix dans l’environnement de production nécessitent une approbation manuelle.
- Vérifier régulièrement le journal des activités, les erreurs de synchronisation, les modifications en masse anormales, l’utilisation des tokens et les connexions tierces.
- Lors de la fin de la collaboration, exporter les enregistrements nécessaires, résilier la connexion et le token, et vérifier le cycle de suppression dans les sauvegardes.
Situation du logiciel open source
La plateforme Boost.space n’est pas un produit open source ; il n’existe aucune preuve indiquant que sa base de données, son moteur de synchronisation, ses agents IA ou ses services MCP hébergés puissent être déployés en tant que système open source complet. Le statut open source dans le catalogue doit être marqué comme non open source.
Le paquet logiciel officiel Python SDK est distribué sous la licence MIT et inclut un paquet de distribution du code source, mais son répertoire GitHub correspondant n’est pas actuellement accessible au public. La licence SDK ne couvre que le code client et ne signifie pas que les plateformes commerciales, les données des utilisateurs ou le contenu généré deviennent open source.
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Boost.space |
| Société de développement | Boost.space s.r.o. |
| Siège de l’entreprise | République tchèque |
| Type d’outil | Plateformes de données e-commerce, agents IA, synchronisation et automatisation des données |
| Priorité actuelle | Gestion des produits, gouvernance des catalogues, données des fournisseurs, tarification dynamique, GEO et activation du public |
| Modèle de données | Module, Espace, Enregistrement et Champ |
| Nombre d’intégrations | Le site officiel affiche actuellement 2675 intégrations natives. |
| Mode d'utilisation | Applications web, automatisation, Remote MCP, API REST et SDK |
| Modèle de prix | Snapshot gratuit, Blueprint à 5000 dollars, devis sur mesure pour la plateforme |
| Plateforme gratuite | La page d’achat public actuelle ne considère pas le Snapshot comme équivalent à une plateforme complète, permanente et gratuite. |
| Soutien en chinois | Le site officiel et les documents sont principalement en anglais ; aucune documentation officielle complète en chinois n’a été trouvée. |
| API | Fournir une API REST |
| MCP | Fournir un hébergement pour le serveur Remote MCP |
| SDK | TypeScript et Python s’installent publiquement, l’état de PHP et Go doit être vérifié. |
| Est-ce open source | La plateforme n’est pas open source ; le paquet SDK Python est sous licence MIT. |
Indice de recommandation
Le score de recommandation est de 4,2 sur 5. La valeur majeure de Boost.space réside dans le fait de structurer d’abord les produits, les commandes et les données clients en une base de données typée, liée et synchronisable, avant de permettre aux agents IA internes ou externes de fonctionner au sein du même système d’autorisation.
Il convient mieux aux équipes e-commerce disposant de données multi-canaux, d’indicateurs métier clairs et de capacités de gouvernance, et n’est pas un outil de chat léger qui permet de résoudre gratuitement tous les problèmes de catalogue dès l’enregistrement. Les achats sur mesure, le calcul des volumes utilisés, la qualité des données ainsi que les risques liés à l’écriture bidirectionnelle doivent être testés lors de la phase pilote.
Questions fréquentes
Quel outil est Boost.space ?
Il s’agit d’une plateforme commerciale qui combine des données structurées, la synchronisation des applications, l’automatisation et des agents IA, axée actuellement sur la gestion des produits pour les e-commerçants, les détaillants et les marques.
Boost.space est-il gratuit ?
La page d’achats publics actuelle propose un diagnostic gratuit via le magasin Snapshot, mais cela ne signifie pas que toute la plateforme soit gratuite de manière permanente. Le déploiement de la plateforme s’accompagne d’une offre sur mesure ; il convient de vérifier au moment de l’inscription si les anciens forfaits autonomes ou la période d’essai de 14 jours sont encore applicables aux nouveaux comptes.
Qu’est-ce que Snapshot livrera ?
La description du site officiel est établie par l’équipe en environ 24 heures, qui effectue une vérification du magasin et fournit un rapport d’environ 2 à 3 pages couvrant les problèmes de visibilité pour l’IA et les problèmes de catalogue. L’utilisateur n’a qu’à soumettre d’abord les informations du magasin ; il ne s’agit pas d’un abonnement logiciel.
Pourquoi Blueprint facture-t-il 5000 dollars ?
Blueprint est un projet de diagnostic et de conception d’environ quatre semaines, dont la livraison finale comprend un rapport de 25 à 40 pages, un cahier des charges avec des preuves au niveau SKU et une feuille de route. Il sert à quantifier les opportunités et à définir l’étendue de la mise en œuvre ultérieure par un intermédiaire, plutôt que simplement d’acquérir un compte.
Faut-il acheter Platform après Blueprint ?
La réponse aux questions publiques actuelle indique qu’il n’y a aucune obligation d’achat ; le client peut conserver les livrables Blueprint. Si le déploiement se poursuit, la portée de la plateforme et le prix seront déterminés en fonction du type d’agent, de la quantité de données, du canal, du marché et des indicateurs de performance.
Combien d’intégrations d’applications sont prises en charge ?
Le site officiel affiche actuellement 2675 intégrations natives, et la documentation officielle liste également de nombreuses applications tierces. Les différentes intégrations peuvent être prêtes à l’emploi, nécessiter des paramétrages supplémentaires ou exiger un contact avec le support ; il ne faut donc pas se fier uniquement au nombre total pour évaluer leur disponibilité.
Comment Boost.space évite-t-il les enregistrements redondants ?
L’administrateur peut définir des champs clés pour l’espace, afin que les données importées mettent à jour les enregistrements existants lorsqu’elles correspondent à ces champs. Si les champs clés ne sont pas stables ou si la correspondance est erronée, cela peut encore provoquer des doublons ou des écrasements ; il est donc nécessaire de procéder d’abord à des tests avec des échantillons.
Peut-il modifier automatiquement les prix des produits ?
La plateforme offre un agent de tarification dynamique et une capacité d’écriture bidirectionnelle, mais le fait qu’elle soit présentée publiquement ne signifie pas que tous les clients doivent voir leurs prix modifier automatiquement. Avant une utilisation officielle, il convient de définir les limites de prix, les procédures d’approbation, la détection des anomalies et des mécanismes de révocation rapide.
Comment est facturé le fonctionnement de l’IA ?
Les opérations telles que les champs d’IA, le traitement de texte, la conversion et la validation consomment des crédits d’IA ; les scénarios automatisés consomment en plus des operations. La page de tarification actuelle des entreprises ne précise pas de manière unifiée et publique les montants exacts, il convient donc de demander un devis indiquant clairement les quantités et les règles en cas de dépassement.
Fournit-on une API et un MCP ?
Fourni. L’API REST convient à l’intégration programmée, tandis que Remote MCP permet à ChatGPT, Claude, Cursor et d’autres clients compatibles d’accéder aux données métier dans le cadre des droits accordés.
Quels SDK sont pris en charge ?
L’aperçu officiel liste TypeScript, Python, PHP et Go, mais les informations d’installation publiques montrent que TypeScript et Python sont les plus clairement définis ; l’état de publication de PHP et Go doit être vérifié au moment de la connexion. Le paquet Python exige une version 3.11 ou supérieure et est marqué comme Beta.
Boost.space est-il open source ?
La plateforme elle-même n’est pas open source. Le paquet SDK Python est soumis à la licence MIT, mais le SDK ne sert qu’à appeler la plateforme commerciale ; il ne permet donc pas de qualifier les bases de données, les agents d’IA ou les services hébergés comme étant open source.
Les données seront-elles utilisées pour entraîner un modèle d’IA ?
La déclaration de confidentialité publique offre l’engagement que les données spécifiques des API Google ne seront pas utilisées pour entraîner des modèles généraux, mais cette disposition ne peut être interprétée de manière étendue à toutes les données des clients et à tous les clients d’IA externes. Les entreprises doivent définir dans les contrats et les conditions de chaque fournisseur de modèles les mécanismes d’entraînement, de conservation et de retrait.
Quelle est la préparation la plus importante avant le lancement ?
Il convient d’abord de mettre en place un modèle de données stable, des champs clés, des droits d’accès et des processus d’audit, puis de commencer par une tâche proxy à faible risque et mesurable. Sans données fiables et sans validation manuelle, l’automatisation ne fera qu’accélérer la propagation des erreurs.
Outils similaires à Boost.space




 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164