




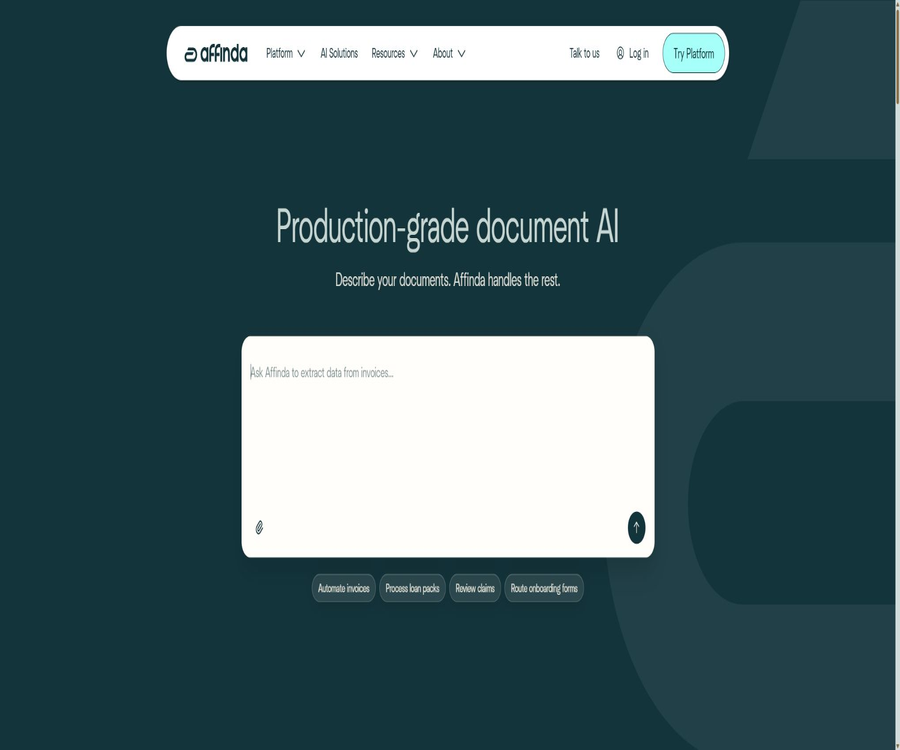
Affinda
Affinda, outil intelligent axé sur les agents IA
Étiquettes :AI AgentAffinda est une plateforme d’IA pour documents destinée aux entreprises, capable de transformer les factures, les CV, les documents de sinistre, les dossiers de prêt et les documents logistiques en données structurées. Elle met l’accent sur la vérifiabilité, le traçage et l’intégration dans les processus métier, et pas seulement sur une simple reconnaissance OCR.
La plateforme permet aux équipes de créer des types de documents personnalisés, d’extraire des champs et des tableaux, et d’améliorer la fiabilité des résultats grâce à la validation par règles, à la correspondance des données maîtresses et à une vérification manuelle. Les utilisateurs peuvent également, avec Affinda Agent, configurer les espaces de travail et les processus de traitement en langage naturel.
Qu’est-ce que Affinda ?
Affinda est conçue comme une plateforme de traitement intelligent de documents de niveau professionnel. Ses processus clés comprennent la réception des fichiers, la reconnaissance des documents, le découpage et la classification, l’extraction des données, la validation des résultats et l’export vers les systèmes métier. Elle est adaptée au traitement de documents d’entreprise aux formats variés, en grand nombre, et nécessitant des traces d’audit.
- Identifier le texte et les informations de mise en page à partir de PDF, de scans et d’images
- Découper le paquet de fichiers mixtes en documents indépendants et les classer automatiquement
- Extraction de champs, tableaux complexes, signatures, cases à cocher et contenu manuscrit
- Utiliser les règles, la confiance et la correspondance des données principales pour valider les résultats
- Traiter les éléments à faible confiance ou anormaux par une vérification manuelle de la file d’attente
- Se connecter aux systèmes existants grâce à des API, des Webhook, des e-mails et des interfaces intégrées
Fonctionnalités clés
Type de document personnalisé
L’équipe peut créer des types de documents et des schémas de champs adaptés à ses propres fichiers, sans être limitée aux modèles prédéfinis par la plateforme. Les champs peuvent inclure du texte, des dates, des montants, des adresses, des entités, des listes et des données imbriquées.
- Définir des structures de données indépendantes pour différents documents métier
- Définir les champs obligatoires, les types de données et les descriptions des champs
- Gérer les variations de fournisseurs ou de formats dans des documents similaires
- Gérer plusieurs types de documents dans une zone de travail
Séparation et classification des documents
Lorsqu’un PDF contient plusieurs documents, Affinda peut identifier les limites, séparer les fichiers et déterminer le type de document pour chaque partie. Cette fonctionnalité est adaptée aux dossiers de prêt, aux dossiers de sinistre, aux documents d’embauche et aux archives scannées en masse.
- Identifier les pages de début et de fin dans un paquet de fichiers multi-documents
- Acheminement automatique vers le modèle d’extraction ou la file de travail correspondante
- Le modèle de classification peut fonctionner seul, sans avoir besoin d’extraire tous les champs.
- Il est possible de définir une étape de confirmation manuelle pour les résultats incertains.
OCR et compréhension de la mise en page
La plateforme traite en même temps le texte imprimé par machine, le contenu scanné et une partie des informations manuscrites, tout en conservant la position du texte et la structure de la page. Les tableaux, les paires clé-valeur et le layout visuel peuvent servir de critères pour identifier les champs.
- Identifier les PDF scannés et les fichiers d’images courants
- Extraction de contenu continu à partir de documents multi-pages
- Prend en charge les tableaux complexes, les cases à cocher, les signatures et les informations de format
- Couvrant plus de 50 langues, y compris le chinois simplifié et le chinois traditionnel
Extraction de champs et de tableaux complexes
Affinda ne renvoie pas seulement du texte brut, mais peut également mapper les informations clés à des champs prédéfinis. Pour les fichiers contenant plusieurs lignes de produits, de frais ou d’entrées d’historique, il est possible de générer des tableaux et des arrays structurés.
- Extraire le nom, le numéro, la date, le montant et l’adresse
- Identifier les détails multi-lignes sur les factures et les commandes
- Analyser l’expérience professionnelle, la formation et les compétences dans le CV
- Formater, normaliser et convertir le texte des résultats
Vérifier que les règles correspondent aux données principales
Les utilisateurs peuvent définir des règles de vérification en langage naturel pour contrôler les relations de montants, les plages de dates, la complétude des champs et les conditions métier. Les valeurs extraites peuvent également être mises en correspondance avec les données maîtresses des fournisseurs, des clients ou des produits, afin de réduire les erreurs causées par les différences de noms.
- Vérifier que le solde partiel, la taxe et le montant total sont cohérents.
- Vérifier la date de validité des pièces d’identité, des polices d’assurance ou des contrats
- Mappage des noms non standard vers les enregistrements de données principales internes
- Champs manquants, en conflit ou non conformes aux règles
Vérification manuelle et contrôle qualité
Les champs à faible niveau de confiance et les anomalies de règles peuvent être transférés sur l’interface de révision manuelle, où le personnel métier peut les corriger en se référant au texte original. La plateforme enregistre le niveau de confiance, le temps de traitement et le parcours des opérations, ce qui facilite l’analyse de la qualité et les audits.
- Attribuer les documents à vérifier par file d’attente
- Voir et corriger les champs à côté de la page originale
- Utiliser les droits de rôle pour contrôler la portée de la consultation et des actions
- Conserver les journaux d’audit et les enregistrements des changements d’état
Affinda Agent
Affinda Agent est l’assistant de configuration en langage naturel de la plateforme. Les utilisateurs peuvent décrire les documents et champs à traiter, et l’Agent les aide à créer des espaces de travail, des types de documents, à extraire des champs ainsi qu’à définir des règles de validation.
- Expliquer en langage naturel les objectifs du traitement de documents
- Selon les champs recommandés et la structure des données du fichier d’exemple
- Aider à établir les règles de validation et le format de sortie
- Réduire les opérations redondantes dans la configuration initiale
Les configurations générées par l’agent doivent encore être vérifiées par des personnes familières avec les règles métier. Pour les processus de régulation, financiers ou de traitement des sinistres, on ne peut pas se fier uniquement aux suggestions automatiques pour déterminer les champs finaux et la logique de validation.
Flux de travail et automatisation
Une fois le document entré sur la plateforme, il peut être soumis successivement à une classification, à un extrait, à une vérification selon des règles et à une révision manuelle, avant d’être envoyé vers les systèmes ultérieurs. Le mécanisme de file d’attente permet de traiter séparément les fichiers de différentes priorités, appartenant à différents clients ou types d’activités.
- Acheminement automatique par type de document ou état du résultat
- Créer une branche de révision manuelle pour les résultats à faible confiance
- Utiliser un Webhook pour déclencher des actions ultérieures en cas de changement d’état
- Écrire des données structurées dans un ERP, un ATS, un CRM ou un système personnalisé
API et méthodes d’intégration
Affinda propose une API REST, des bibliothèques clients et des Webhooks, permettant aux équipes de développement de soumettre des documents dans l’application, de lire les résultats et de suivre l’état du traitement. Les personnes non chargées du développement peuvent également participer au processus en téléchargeant des fichiers par e-mail ou via une interface de vérification intégrée.
| Mode d’intégration | Utilisation principale | Adéquat pour les utilisateurs |
|---|---|---|
| REST API | Soumettre des documents, lire des résultats structurés et gérer des ressources | Équipe de développement |
| Bibliothèque client | Appeler les capacités de la plateforme avec des langages de programmation courants | Développeur d’applications |
| Webhook | Recevoir des notifications lorsque le document est terminé ou que son état change | Processus automatisés |
| Téléchargement par e-mail | Recevoir et traiter les pièces jointes en spécifiant une adresse e-mail | Équipes opérationnelles et financières |
| Interface de vérification intégrée | Vérifier les résultats de reconnaissance dans l’application existante | Fournisseur de logiciels |
| Affinda Agent | Créer une configuration de traitement en langage naturel | Personnel opérationnel et de mise en œuvre |
Types de documents pris en charge
La plateforme permet de créer des types de documents personnalisés, de sorte que son champ d’application n’est pas limité à des modèles prédéfinis. Voici les approches les plus courantes pour le traitement des documents d’entreprise.
| Catégorie | Exemple de document | Contenus d’extraction courants |
|---|---|---|
| Achat financier | Factures, reçus, commandes d’achat | Fournisseur, date, montant, taxe, ligne |
| Recrutement du personnel | Curriculum vitæ, formulaire de demande, certificats | Informations personnelles, expérience, formation, compétences |
| Assurance | Formulaire de demande d’indemnisation, police d’assurance, documents justificatifs | Numéro de police d’assurance, demandeur, éléments de perte, montant |
| Prêt financier | Formulaire de demande, extrait bancaire, dossier de prêt | Demandeur, compte, revenus, informations sur le risque |
| Commerce logistique | Connaissement, liste d’emballage, documents de dédouanement | Marchandises, quantité, port, transporteur |
| Identité et conformité | Passeport, pièce d’identité, documents de conformité | Nom, numéro d’identité, date d’expiration |
| Droit et contrats | Contrats, accords et annexes | Parties, dates, clauses, entités clés |
Scénarios d’application
- L’équipe financière enregistre automatiquement les factures, les reçus et les commandes d’achat.
- Plateforme de recrutement qui analyse en masse les CV et les enregistre dans le système des candidats
- L’assureur organise le dossier de sinistre et vérifie l’intégralité des documents.
- Les banques et les entreprises de fintech traitent les dossiers de demande de prêt
- Les entreprises de logistique récupèrent les connaissements, les listes d’emballage et les données de dédouanement
- Les fournisseurs de logiciels intègrent la reconnaissance de documents et la révision manuelle dans leurs produits.
- L’équipe de conformité traite les documents sensibles dans un environnement de déploiement régional
À qui s’adresse-t-il
- Les grandes entreprises qui doivent gérer un grand nombre de documents répétitifs
- Équipes de développement logiciel souhaitant intégrer des capacités d’IA pour la documentation via une API
- Départements métier nécessitant des champs personnalisés, des règles et des flux de travail
- Organisations réglementées qui accordent de l’importance aux droits d’accès, aux journaux d’audit et au déploiement régional
- Équipe internationale pour la gestion de documents multilingues et d’opérations transrégionales
Commencer à utiliser le tutoriel
- Inscrivez-vous pour un compte d’essai et créez une organisation ainsi qu’un espace de travail.
- Sélectionnez un type de document prédéfini, ou créez un type personnalisé en fonction des documents d’entreprise.
- Téléchargez des fichiers d’exemple représentatifs pour définir les champs et les tableaux à extraire.
- Vérifier les résultats de la première identification et compléter les descriptions des champs, ainsi que les règles de conversion et de validation.
- Définir la file d’attente pour la révision manuelle, les droits des rôles et les conditions de validation des résultats.
- Se connecter aux systèmes d’entreprise via une API, un Webhook, un e-mail ou une interface intégrée.
- Effectuer des tests à petite échelle à l’aide de documents réels pour calculer le taux de précision, le taux d’anomalies et le coût par page.
- Augmenter le volume de traitement une fois la qualité et le budget confirmés, et effectuer des contrôles aléatoires continus des résultats.
Créer un modèle de document personnalisé
- Collecter des documents d’exemple couvrant les formats, langues et cas exceptionnels courants.
- Créer les types de documents et choisir la structure de données appropriée pour chaque champ cible.
- Indiquez clairement le nom, la signification et le format attendu pour chaque champ, afin d’éviter les chevauchements sémantiques.
- Vérifier l’efficacité du extraction des tableaux de test, de la écriture manuscrite, des cases à cocher et des champs sur plusieurs pages.
- Montant de l’ajout, date, champs obligatoires et règles de correspondance des données principales.
- Envoyer les champs à faible niveau de confiance pour une vérification manuelle et enregistrer la cause de l’erreur.
- Itérer sur la configuration en fonction des résultats de la révision, jusqu’à atteindre les critères d’acceptation métier.
Guide d’intégration API
- Créez dans le compte une clé API dont la portée des droits est appropriée.
- Vérifier la zone de travail cible et l’identifiant du type de document.
- Soumettez les fichiers via une connexion sécurisée et enregistrez l’identifiant du document retourné.
- Poller l’état ou la signature de configuration pour recevoir des notifications de fin de réception du webhook.
- Lire les valeurs des champs, le degré de confiance, le numéro de page et les résultats de validation.
- Les résultats anormaux sont envoyés dans le processus de révision, tandis que les résultats normaux sont enregistrés dans le système métier.
- Enregistrer les demandes, le temps de traitement et la consommation de points, et définir des tentatives de réessai pour les demandes échouées.
Méthodes d’évaluation des effets
Pour déterminer si l’IA de traitement de documents peut être mise en ligne, il ne suffit pas de se baser sur un petit nombre de fichiers de démonstration. Il est recommandé de calculer séparément le taux de précision des champs, le taux de réussite des documents, le pourcentage de révision manuelle, le temps de traitement et le coût réel en points.
| Indicateur | Points clés de l’évaluation | Pratique recommandée |
|---|---|---|
| Précision du champ | Les champs clés sont-ils corrects ? | Vérification par échantillonnage selon le type de champ |
| Taux de complétude | Y a-t-il des champs obligatoires manquants ? | Statistiques des valeurs manquantes et du pourcentage non identifié |
| Taux de précision de classification | Le document est-il acheminé selon la bonne procédure ? | Tester avec un paquet de fichiers mixtes |
| Taux de précision de segmentation | Les limites de page sont-elles correctement déterminées ? | Tester différentes longueurs et séquences de balayage |
| Taux de révision manuelle | Combien d’efforts la automatisation peut-elle économiser | Enregistrer la faible confiance et les anomalies de règle |
| Délai de traitement | Peut-on répondre aux délais commerciaux | Tester séparément les lots normaux et les lots en période de pointe |
| Coût par document unique | Somme des points et des coûts de main-d’œuvre | Calculé sur la base du nombre moyen réel de pages |
Tarification de la plateforme Affinda
La plateforme Affinda utilise un modèle de facturation basé sur le nombre de pages traitées, sans limitation spécifique par poste ou module pour ses fonctionnalités principales. Aucun prix unique par page n’est indiqué pour les pages publiques ; le tarif réel est déterminé en fonction du volume de traitement, du mode de déploiement, des services de support et des éléments supplémentaires.
| Plan | Mode de facturation | Adéquat pour la situation | Explication principale |
|---|---|---|---|
| Essai gratuit | 200 Crédits en 2 semaines | Vérification fonctionnelle et tests à petite échelle | Permet de tester la capacité de traitement des documents clés |
| Consommation mensuelle | Abonnement payant mensuel | Volume de traitement incertain ou avec des fluctuations importantes | Facturation en fonction de la consommation réelle de pages du mois |
| Engagement annuel | Fixer à l’avance la consommation annuelle | Le volume de traitement est stable et prévisible | La partie excédentaire est calculée au taux convenu. |
| Solution sur mesure | Contacter le service des devis | Haute capacité, déploiement spécial ou besoins en support | Le prix dépend de la taille, du déploiement et des services supplémentaires. |
Les crédits non utilisés dans l’engagement annuel ne sont généralement pas reportés automatiquement ; par conséquent, les entreprises doivent estimer les quantités à acquérir en fonction du nombre moyen réel de pages et des fluctuations d’activité. La mise en œuvre, la formation, la maintenance par intégration continue, l’infrastructure sur mesure ainsi que le soutien à la conformité spécifique peuvent être facturés en tant que services supplémentaires.
Analyse du CV – Prix du produit
Les documents de recrutement d’Affinda disposent d’un système de tarification indépendant, avec un paiement par page utilisée ou une acquisition en fonction du volume annuel de documents. Les prix de référence ci-dessous correspondent aux offres publiques ; les prix finaux et les avantages dépendent du compte ou du contrat.
| Nombre de documents de planification ou annuels | Prix de référence | Explication |
|---|---|---|
| Payant à l’usage | 0,20 dollar par page | Aucune engagement annuel, 200 pages d’essai incluses les 14 premiers jours |
| 66 000 exemplaires/an | 3 600 dollars/an | Plan de lancement annuel |
| 132 000 exemplaires/an | 6 000 dollars/an | Taux document unique convenu pour les excédents |
| 240 000 exemplaires/an | 9 000 dollars/an | Adapté aux plateformes de recrutement de taille moyenne |
| 420 000 exemplaires/an | 12 000 dollars/an | Adapté à un volume de traitement élevé |
| 600 000 exemplaires/an | 15 000 dollars/an | Adapté à l’analyse à grande échelle |
| 780 000 exemplaires/an | 18 000 dollars/an | Des devis personnalisés sont disponibles pour des quantités plus élevées. |
Crédits et règles de facturation
- La plupart des produits d’IA pour documents consomment des Page Credits en fonction du nombre de pages traitées.
- Les produits de recrutement sont généralement calculés en crédits documentaires
- Dans le mode de classification uniquement, chaque document consomme au maximum 3 crédits.
- Il est possible de configurer une plage de numéros de page continue ; les pages non traitées ne sont pas prises en compte dans la consommation.
- Les comptes payants permettent d’acheter des crédits et de définir des recharges automatiques.
- Les plans mensuels sont généralement facturés après leur utilisation réelle.
- Les clients à forte consommation peuvent demander des forfaits personnalisés et un règlement par facture.
Limites de traitement
La plateforme ne fixe pas de limite maximale globale pour la soumission de documents, mais la vitesse de la file d’attente, le nombre de pages par document et les paramètres du compte influencent le débit réel. La file à haute priorité indiquée dans les documents publics permet 20 documents par minute, avec une limite par défaut de 20 pages par document.
| Projet | Règles publiques | Précautions à prendre |
|---|---|---|
| Quantité totale soumise | Aucun plafond global uniforme n’a été fixé | Encore affecté par le plafond du compte et la vitesse de la file d’attente |
| File à haute priorité | 20 documents par minute | Les tâches en surcharge peuvent utiliser une file à faible priorité |
| Nombre de pages par défaut | Un seul document de 20 pages | Vous pouvez contacter la plateforme pour demander une augmentation. |
| Mode dédié à la classification | Jusqu’à 3 crédits par portion | Seulement la classification, sans extraction complète des champs |
| Page sélective | Il est possible de spécifier une plage de numéros de page consécutifs | Exclure les pages qui ne sont ni traitées ni facturées |
Sécurité et déploiement
Affinda propose des droits d’accès par rôle, une authentification à plusieurs facteurs, des journaux d’audit et des services de localisation, et affirme ouvertement respecter les exigences de contrôle liées à ISO 27001 et SOC 2. Les entreprises doivent néanmoins examiner les contrats, la conservation des données, les transferts transfrontaliers et les arrangements avec les sous-traitants en fonction des réglementations de leur secteur d’activité.
- Utiliser les permissions des rôles pour restreindre l’accès aux espaces de travail et aux fonctionnalités
- Prend en charge l’authentification multifacteur par e-mail ou par authentificateur
- Les clés API permettent de contrôler l’étendue des droits en fonction de leur usage
- Enregistrements d’audit des opérations de conservation et des états de traitement
- On peut discuter du déploiement régional et des solutions d’autogestion.
- Une évaluation de la sécurité de l’entreprise doit être effectuée avant d’accéder aux documents sensibles.
Auto-hébergement et logiciel open source
Affinda a rendu publiques les configurations et les documents d’installation pour le déploiement auto-hébergé, mais le service de résolution central, les conteneurs et les modèles ne sont pas pour autant devenus du logiciel open source. Obtenir des images auto-hébergées et les composants associés nécessite généralement une licence commerciale ainsi qu’une autorisation de la plateforme.
| Composant | État ouvert | Explication |
|---|---|---|
| Plateforme Affinda | Source fermée commerciale | Les services cloud fondamentaux et la plateforme de gestion ne sont pas open source. |
| Modèle d’analyse de documents | Source fermée commerciale | Les poids du modèle et le code d’entraînement ne sont pas publics. |
| Configuration auto-hébergée | Entrepôt public | Fournir des instructions de déploiement ; l’image principale doit être autorisée. |
| Bibliothèque client | Disponible publiquement | Utilisé pour appeler l’API, ce n’est pas équivalent à ouvrir le moteur principal. |
| API | Services commerciaux | Appel par compte, volume et droits contractuels |
Avantages du produit
- Prend en charge les types de documents personnalisés, sans être limité à un petit nombre de modèles prédéfinis
- Placer la classification, la segmentation, l’extraction, la validation et la révision sur la même plateforme
- Peut gérer des tableaux complexes, de l’écriture manuscrite, des signatures et des cases à cocher
- Fournir des agents en langage naturel pour réduire les barrières à la configuration initiale
- API, Webhook et interface de vérification intégrée relativement complètes
- Prend en charge plus de 50 langues, idéal pour les processus de documents transrégionaux
- Fournit des options de permissions, d’audit, de déploiement régional et d’autogestion
Restrictions d'utilisation et précautions
- Le produit phare de la plateforme n’est pas un logiciel open source, et l’hébergement auto-géré nécessite également une licence commerciale.
- La plateforme générale ne publie pas de prix unique et uniforme ; il est nécessaire d’obtenir un devis avant d’établir un budget.
- Le solde annuel non utilisé n’est généralement pas reporté, et une estimation trop élevée des quantités à acheter entraîne des gaspillages.
- Le nombre de pages par document par défaut et la vitesse de la file à haute priorité peuvent nécessiter une demande de modification.
- Les mises en page complexes, les scans de faible qualité et la écriture non standard peuvent encore nécessiter une vérification manuelle.
- Les agents de langage naturel peuvent aider à la configuration, mais ils ne peuvent pas remplacer l’examen des règles métier.
- Lorsque des décisions financières, d’assurance ou de conformité sont prises, une vérification manuelle doit être conservée.
- Le taux de précision varie en fonction du type de document et de la distribution des échantillons ; il convient de le tester avec des données réelles avant le déploiement.
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | Affinda |
| Type d’outil | Plateforme d’IA pour les documents d’entreprise et de traitement intelligent des documents |
| Capacité centrale | OCR, classification, segmentation, extraction de champs, validation et vérification manuelle |
| Documents courants | Factures, CV, documents de sinistre, dossiers de prêt et documents logistiques |
| Langues supportées | Plus de 50, y compris le chinois simplifié et le chinois traditionnel |
| Mode d’intégration | API REST, bibliothèques clients, Webhook, e-mail et interfaces intégrées |
| Mode de déploiement | Cloud, déploiement régional et autorisation d’autogestion |
| Essai gratuit | Plateforme : 200 Crédits par 2 semaines |
| Modèle de prix | Consommation par page, engagement annuel ou devis sur mesure |
| Est-ce open source | Le produit principal n’est pas open source ; certaines configurations et les bibliothèques clients sont publiées. |
Indice de recommandation
4,5 / 5. Affinda convient aux processus de documents nécessitant des champs personnalisés, des tableaux complexes, une validation par règles et l’intégration d’entreprises ; sa plateforme offre des fonctionnalités complètes ; cependant, avant une commande officielle, il convient de vérifier attentivement le nombre réel de pages, le taux de conversion, les limites de traitement et la proposition commerciale.
Questions fréquentes
Qu’est-ce que fait principalement Affinda ?
Il convertit les informations commerciales contenues dans des PDF, des scans et des images en données structurées, et offre des fonctionnalités de classification, de séparation, de vérification, de révision manuelle et d’intégration système.
Affinda est-il seulement un outil OCR ?
Non. L’OCR n’est qu’une étape de base ; la plateforme est également chargée de la classification des documents, de l’extraction des champs et des tableaux, de la vérification des règles métier, du matching des données maîtresses et de l’acheminement des workflows.
Affinda est-il gratuit ?
La plateforme propose une période d’essai de 2 semaines et 200 crédits ; l’utilisation régulière est facturée en fonction du nombre de pages, d’un engagement annuel ou d’un contrat sur mesure.
Affinda prend-il en charge le chinois ?
Soutien. Les documents officiels comptent le chinois simplifié et le chinois traditionnel parmi plus de 50 langues prises en charge, mais la précision des documents spécifiques doit néanmoins être testée à l’aide de ses propres échantillons.
Peut-il gérer la fusion de plusieurs documents PDF ?
Oui. La plateforme peut déterminer les limites des documents, séparer les fichiers multi-pages et classer les différents éléments dans les processus appropriés.
Est-il possible d’extraire des tableaux complexes ?
Oui, la plateforme prend en charge les tableaux complexes et les structures de données à plusieurs lignes, mais des vérifications manuelles peuvent être nécessaires en cas de grands changements de mise en page ou d’une mauvaise qualité de scan.
Affinda propose-t-elle une API ?
Fourni. Les développeurs peuvent soumettre des documents, lire des champs et leur niveau de confiance via l’API REST et des bibliothèques clients, et recevoir des notifications d’état par Webhook.
Affinda peut-il être déployé en mode privé ?
On peut discuter de l’autorisation pour des déploiements auto-hébergés et personnalisés, mais l’image principale, les modèles d’interprétation et la plateforme restent des produits commerciaux propriétaires ; il est nécessaire de contacter le service des ventes pour obtenir les droits d’accès.
Le plafond annuel d’Affinda est-il reporté ?
Les informations sur la tarification publique indiquent que les crédits annuels non utilisés ne sont généralement pas reportés et doivent être évalués en fonction du volume réel d’activité avant l’achat.
Affinda est-il open source ?
La plateforme principale et les modèles d’analyse ne sont pas open source. Les bibliothèques de client et les configurations de déploiement auto-hébergé ont été rendues publiques par l’éditeur, mais cela ne signifie pas que les services principaux peuvent être utilisés sans licence.
Outils similaires à Affinda




 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164