




Storm
Storm – ein intelligentes Tool, das sich auf KI-gestütztes Schreiben konzentriert.
Tags:KI-SchreibwerkzeugeWas ist STORM?
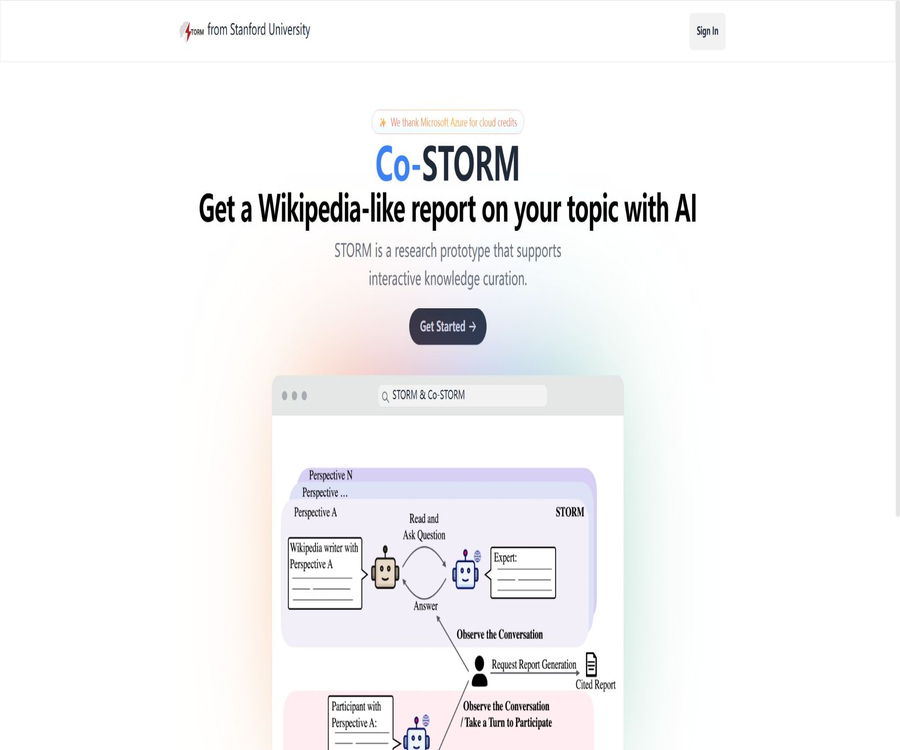
STORM steht für Synthesis of Topic Outlines through Retrieval and Multi-perspective Question Asking – es handelt sich um ein open-source-basiertes System zur Organisation von Wissen, das von dem Stanford OVAL-Team entwickelt wurde. Es sucht im Internet nach Informationen zu einem bestimmten Thema, stellt Fragen aus verschiedenen Perspektiven, erstellt Zusammenfassungen und verfasst ausführliche Berichte mit Quellenangaben.
STORM dient hauptsächlich der Forschung und der Vorarbeit zum Schreiben, anstatt direkt veröffentlichte Artikel zu liefern. Es wird ausdrücklich darauf hingewiesen, dass die erzeugten Ergebnisse in der Regel noch umfangreichen Bearbeitungen und Überprüfungen bedürfen.
Der Arbeitsablauf von STORM
- Empfangen des von dem Benutzer eingegebenen Forschungsthemas.
- Ähnliche Artikel zu dem Thema suchen und unterschiedliche Ansichten identifizieren.
- Lassen Sie die virtuellen Autoren Fragen aus verschiedenen Perspektiven stellen.
- Simulierte fortlaufende Interviews zwischen dem Autor und einem Experten für das Thema.
- Daten durch Suchmaschinen oder mit einem benutzerdefinierten Korpus abrufen.
- Ordnen Sie die gesammelten Beweise und erstellen Sie eine hierarchische Gliederung.
- Verfassen Sie einen vollständigen Artikel auf der Grundlage des Entwurfs und der Quellen.
- Ergänzende Zitate, Zusammenfassungen und Reduzierung von Wiederholungen.
Hauptfunktionen
- Automatische Durchführung mehrerer Runden von Netzwerkanalysen zu einem Thema.
- Erweitern Sie den Umfang der Problemanalyse durch die Perspektiven verschiedener Personen.
- Simulierte Interviews durchführen und aufgrund neuer Informationen weitere Fragen stellen.
- Sammeln von Webseiteninhalten und nachvollziehbaren Quellen.
- Ordnen Sie die Suchergebnisse in einen hierarchischen Artikelverzeichnis.
- Erstellen eines ausführlichen Berichts im Stil von Wikipedia.
- Trennen Sie die vier Module Forschung, Überblick, Schreiben und Überarbeiten.
- Es ist möglich, Sprachmodelle, Suchmaschinen und Vektorabfragesysteme auszutauschen.
- Unterstützung bei der Erstellung eines VectorRM-Korpus zur Suchfunktion mit eigenen Dokumenten des Benutzers.
- Es werden Python-Pakete, Beispiel-Skripte sowie eine leichte Streamlit-Oberfläche bereitgestellt.
Warum werden mehrfache Perspektiven bei der Stellung von Fragen verwendet?
Wenn das Modell nur direkt Fragen aufstellt, neigt es dazu, bei gängigen Konzepten und oberflächlichen Informationen zu verweilen. STORM prüft zunächst Artikel zu ähnlichen Themen sowie die Perspektiven verschiedener Personen, bevor es unterschiedlichen virtuellen Autoren überlässt, differenziertere Fragen zu stellen.
- Interessengruppen jenseits der vorherrschenden Erzählung identifizieren.
- Umfasst historische, technische, wirtschaftliche, ethische und soziale Auswirkungen.
- Verringerung der Beschränkung, dass nur nach der ursprünglichen Formulierung des Benutzers gesucht wird.
- Unbekannte Konzepte und Lücken in den Beweisen werden durch weitere Fragen geschlossen.
- Bieten Sie weitere mögliche Kapitel für den endgültigen Entwurf an.
Was ist Co-STORM?
Co-STORM ist ein kooperatives Wissensorganisierungsmodell, das auf STORM aufbaut. Es ermöglicht es Benutzern, mehreren KI-Experten sowie einem leitenden Agenten, gemeinsam über Themen zu diskutieren und dabei dynamische Gedankenlandkarten ständig zu aktualisieren.
| Charaktere | Hauptaufgaben |
|---|---|
| KI-Experten | Antworten auf Fragen oder stellen weiterer Fragen unter Verwendung externer Quellen |
| Intelligenter Moderator | Wichtige Informationen, die noch nicht besprochen wurden, aufdecken und anregende Fragen stellen. |
| Menschliche Benutzer | Beobachtungen diskutieren oder eigene Ansichten einbringen, um die Forschungsrichtung anzupassen |
| Dynamische Gedankenlandkarte | Die Diskussionsinhalte in einer hierarchischen Konzeptstruktur ordnen. |
Der Wert von Co-STORM
- Die Nutzer müssen nicht bis zum endgültigen Bericht warten, um zu erkennen, dass sich die Forschungsrichtung verschoben hat.
- Ziele, Einschränkungen und berufliche Hintergründe können im Rahmen der Diskussion hinzugefügt werden.
- Dynamische Mindmaps verringern die kognitive Belastung bei langen Diskussionen.
- Der Moderator-Antreiber hilft dabei, bereits gesuchte, aber noch nicht erörterte Kenntnisse zu entdecken.
- Der Endbericht kann auf der Grundlage eines gemeinsamen Erkundungsprozesses erstellt werden.
Vergleich von STORM und Co-STORM
| Dimensionen | STORM | Co-STORM |
|---|---|---|
| Arbeitsweise | Artikel nach automatischer Recherche erstellen | Menschen und mehrere intelligente Agenten erkunden gemeinsam |
| Benutzerbeteiligung | Bietet hauptsächlich Themen und Konfigurationen an | Man kann sich kontinuierlich in die Diskussion einbringen. |
| Wissensstruktur | Gliederung und Artikel | Dynamische Mind Maps, Diskussionen und Berichte |
| Für Aufgaben geeignet | Kurze Übersicht zu einem relativ klaren Thema | Komplexe, offene Fragen, die schrittweise geklärt werden müssen |
| Hauptausgabe | Wikipedia-artikel mit Zitaten | Kollaborativer Wissensraum und Endbericht |
| Komplexität | Niedriger | Mehr Agenten, mehr Aufrufe, höhere Kosten |
Anleitung zur Vorschau von Online-Forschungsarbeiten
- Zur Stanford STORM Research Preview.
- Lesen und die aktuellen Dienstbedingungen akzeptieren.
- Eindeutiger Eingabebereich für Forschungsthemen, die leicht recherchiert werden können.
- Ergänzen Sie die gewünschten Ziele und den Ausschlussbereich.
- Warten Sie, bis das System nachsucht, Interviews durchführt und ein Überblick erstellt.
- Prüfen Sie die Struktur des Berichts sowie jede Quelle der Zitate.
- Öffnen Sie die ursprüngliche Webseite, um Zahlen, Daten und den Kontext zu überprüfen.
- Die Ergebnisse werden als Entwurf der Forschungsarbeit exportiert und anschließend manuell überarbeitet.
Wie wählt man ein Forschungsthema aus
- Verwenden Sie konkrete Objekte, Zeitrahmen und Forschungsfragen.
- Vermeiden Sie es, nur ein allzu breit gefasstes Wort einzugeben.
- Beschreiben Sie die zu vergleichenden Technologien, Politiken, Personen oder Lösungen.
- Geben Sie an, ob Geschichte, der aktuelle Zustand, Streitpunkte oder zukünftige Trends benötigt werden.
- Für schnell sich ändernde Themen geben Sie das Datum des Informationsstandes an.
- Für Themen mit hohem Risiko ist die Verwendung primärer Quellen vorzuziehen.
- Große Probleme in mehrere, unabhängig voneinander überprüfbare Teilprobleme aufteilen.
Für welche Anwendungsszenarien geeignet
- Studenten entwickeln ein Forschungskonzept für Arbeiten und Kursaufgaben.
- Forscher erlernen schnell die Konzepte und Kontroversen in unbekannten Bereichen.
- Inhaltscreator sammeln Hintergrundinformationen und Artikelübersichten.
- Produktmanager untersuchen Markt-, Technologie- und Nutzerprobleme.
- Politiker und Berater sammeln Ansichten aus verschiedenen Quellen sowie öffentliche Beweise.
- Lehrkräfte erstellen Überblickskarten zu den Lektüren und Diskussionsfragen.
- Entwickler erstellen ein benutzerdefiniertes System für tiefgehende Forschung und Berichterstattung.
- Das Team erforscht gemeinsam komplexe Themen mithilfe von Co-STORM.
Aufgaben, die nicht direkt erledigt werden können
- Enzyklopädien oder formelle Abhandlungen, die ohne Bearbeitung veröffentlicht werden können.
- Systematische Übersichtsarbeiten und Meta-Analysen, die eine vollständige Durchsicht aller Literatur erfordern.
- Forschungen, die den Zugang zu kostenpflichtigen Datenbanken, internen Unterlagen oder nicht öffentlich zugänglichen Webseiten erfordern.
- Medizinische Diagnosen, rechtliche Beratung und individuelle Anlageberatung.
- Es muss sichergestellt werden, dass die Berichte mit hohem Risiko Satz für Satz vollständig mit den Aussagen übereinstimmen.
- Es wird die Überwachung von Echtzeit-Nachrichten in Sekundengenauigkeit oder vollständigen Social-Media-Daten gefordert.
- Ein automatisierter Inhalte-Veröffentlichungs-Prozess ohne manuelle Überprüfung.
Preise und Nutzungskosten
Stanford Online Research Preview gibt keinen offiziellen Preis für Mitglieder an; es handelt sich dabei um einen Service zur Vorabnutzung von Forschungsergebnissen. Es können Nutzungseinschränkungen, Wartezeiten sowie bestimmte Bedingungen gelten. Es handelt sich nicht um eine dauerhaft kostenlose Lösung im Sinne eines kommerziellen SaaS-Dienstes.
| Verwendungsmöglichkeiten | Software-Preise | Mögliche Kosten |
|---|---|---|
| Stanford Research Preview | Keine offiziellen Gebühren bekannt | Begrenzt durch die Kapazitäten und Bedingungen der Forschungsdienste |
| Knowledge-Storm Python-Paket | MIT Open Source kostenlos | Große Modelle, Suchfunktionen, Embeddings und Serverkosten |
| Quellcode wird selbst bereitgestellt | MIT Open Source kostenlos | GPU oder API, Vektorbibliotheken, Betriebs- und Sicherheitskosten |
| Lokale Modelle und lokales Korpus | Code kostenlos | Kosten für Hardware, Speicher, Energie und Wartung |
Eine umfassende Untersuchung erfordert mehrere Durchgänge von Suchvorgängen, Fragen und Antworten, Erstellung von Überblickskarten, Schreiben sowie Überarbeiten des Textes – die Kosten sind in der Regel höher als bei einem normalen Gespräch. Die mehragentigen Diskussionen sowie Gedankenströme in Co-STORM erhöhen zudem die Anzahl der Aufrufe.
Unterstützte Modelle und Suchmaschinen
Knowledge-Storm 1.1.0 verfügt nun über eine Integration in LiteLLM, wodurch es möglich ist, die von LiteLLM unterstützten Sprachmodelle sowie Embedding-Modelle zu nutzen. Für die verschiedenen Komponenten können unterschiedliche Modelle ausgewählt werden, um ein Gleichgewicht zwischen Qualität, Geschwindigkeit und Kosten zu erreichen.
| Komponenten | Aktuelle öffentlich verfügbare Unterstützungsbeispiele |
|---|---|
| Sprachmodelle | Modelle, die von LiteLLM unterstützt werden, OpenAI, Azure usw. |
| Eingebettetes Modell | Eingebettungsdienste, die von LiteLLM unterstützt werden |
| Suche/Abfrage | You.com, Bing, Serper, Brave, DuckDuckGo, Tavily, Google usw. |
| Selbstverwaltete Suche | SearXNG |
| Unternehmenssuche | Azure AI Search |
| Eigene Korpora | VectorRM und Vektor-Datenbanken |
Anleitung zur lokalen Installation
- Vorbereitung der Python 3.11-Umgebung.
- Installieren Sie das Knowledge-Storm-Paket oder klonen Sie den offiziellen Repository.
- Wählen Sie ein Sprachmodell, ein Embedding-Modell und einen Suchdienst aus.
- Speichern Sie den API-Schlüssel in der secrets-Konfiguration oder in sicheren Umgebungsvariablen.
- Führen Sie die offiziellen STORM- oder Co-STORM-Beispielskripte aus.
- Überprüfen Sie die Forschung, den Überblick und die Zitatenausgaben mit Themen niedrigen Risikos.
- Je nach Budget werden günstige Modelle sowie hochwertige Schreibmodelle eingesetzt.
- Vor der Produktionsnutzung werden Protokollierung, Beschränkungen, Maskierung und Fehlerbehandlung hinzugefügt.
Vorschläge zur Modellhierarchisierung
- Für die Abfragen zur Aufteilung sowie für das Simulieren von Dialogen können schnellere und günstigere Modelle verwendet werden.
- Die Erstellung eines Overviews erfordert starke strukturelle Fähigkeiten sowie ein umfassendes Verständnis.
- Für die Erstellung von Artikeln sollten Modelle gewählt werden, die sich an Zitierregeln halten und über bessere Fähigkeiten bei der Verarbeitung langer Texte verfügen.
- In der Überarbeitungsphase muss verhindert werden, dass das Modell Verweise löscht oder neue Fakten ohne Quelle hinzufügt.
- Alle Komponenten werden zunächst mit kleinen Stichproben bewertet, anschließend wird die Anzahl der Parallelverarbeitungen und Themen erhöht.
Eigene Dokumente und private Wissensdatenbanken
VectorRM ermöglicht es STORM, auf der Grundlage von vom Benutzer bereitgestellten Dokumenten zu suchen, anstatt sich vollständig auf öffentliche Suchmaschinen zu verlassen. Es eignet sich für interne Unterlagen, Sammlungen von Artikeln oder überprüftes Fachwissen.
- Ordnen Sie die zulässigen Dokumente und Metadaten.
- Entfernen Sie duplizierte, veraltete und unklar berechtigte Dateien.
- Teilen Sie den Text gemäß den Anforderungen des Projekts auf und erstellen Sie einen Vektorindex.
- Konfigurieren Sie eine VectorRM-Verbindung zur Vektor-Datenbank.
- Mit Fragen, bei denen die Antworten bekannt sind, wird die Recall-Rate getestet.
- Überprüfen Sie, ob die endgültige Verweisung auf den ursprünglichen Absatz führt.
- Einstellen von Dokumentrechten, Aufbewahrungsfristen und Löschprozessen.
Warum Zitate dennoch überprüft werden müssen
- Die Suchergebnisse können von Seiten niedriger Qualität oder veralteten Inhalts stammen.
- Die Website könnte die Auslesung verweigern, wodurch der Text nicht interpretiert werden kann.
- Die Zitierseite bedeutet nicht, dass sie alle darin enthaltenen Behauptungen unterstützt.
- Das Modell könnte Informationen aus mehreren Quellen fälschlicherweise zusammenfassen.
- Nach einem Update der Webseite können sich die zitierten Inhalte und Daten ändern.
- Zweitrangige Berichte können wissenschaftliche Arbeiten, Gesetze oder offizielle Daten falsch darstellen.
- Die Erstellung von Artikeln kann Gegenbeispiele und wichtige Kontroversen übergehen.
Faktenermittlungsprozess
- Faktische Aussagen, die extern überprüft werden können, sollen Abschnitt für Abschnitt markiert werden.
- Öffnen Sie die entsprechende Referenz und navigieren Sie zu dem direkt unterstützten Inhalt.
- Priorisieren Sie den Ersatz durch wissenschaftliche Arbeiten, offizielle Daten und Originaldokumente.
- Kreuzprüfung von Zahlen, Datumsangaben, Namen und Kausalbeziehungen.
- Suchen Sie nach Gegenbeweisen und zuverlässigen Quellen mit Widersprüchen.
- Entfernen Sie Schlussfolgerungen, die keine Quelle haben oder deren Quelle nicht unterstützt wird.
- Fristen für die Dokumentation und noch unklare Fragen.
Privatsphäre und Datensicherheit
Für die Online-Research-Preview müssen Thema und Interaktion an den von Stanford betriebenen Service übermittelt werden; die Nutzer sollten die aktuellen Dienstbedingungen lesen. Das Forschungsprojekt hat außerdem das aus den Prüfdaten erstellte WildSeek-Datensatz veröffentlicht, weshalb sensible Themen nicht für öffentliche Präsentationen eingereicht werden sollten.
- Geben Sie keine persönlichen Daten, Kundengeheimnisse oder unveröffentlichte Forschungsmaterialien ein.
- Schreiben Sie die API-Schlüssel nicht in den Code-Repository.
- Bei einer lokalen Implementierung muss auch die Datenpolitik des Modells sowie des Suchanbieters überprüft werden.
- Vor der Erstellung einer Vektordatenbank für eigene Dokumente müssen Berechtigungen und Desensibilisierung durchgeführt werden.
- Das Protokoll kann Abfragen, Webseiteninhalte und generierten Text enthalten.
- Einstellungen für die Speicherung, Löschung und Zugriffskontrolle der Forschungsdaten.
- Für hochsensible Projekte werden vorrangig zugelassene lokale Komponenten verwendet.
Vorteile des Produkts
- Verbinden Sie Suchen, mehrfache Fragestellung aus verschiedenen Perspektiven, Gliederung und Schreiben zu einem integrierten Prozess.
- Durch simuliertes Nachfragen lassen sich Wissenslücken leichter aufdecken als durch eine einzige Suche.
- Der endgültige Artikel enthält Quellenangaben, um zur ursprünglichen Webseite zurückzukehren und diese zu überprüfen.
- Die Module für Forschung, Strukturierung, Schreiben und Überarbeitung können separat konfiguriert werden.
- Co-STORM unterstützt die Benutzer dabei, den Forschungsprozess aktiv zu steuern.
- Dynamische Mindmaps eignen sich für komplexe und langfristige Diskussionen.
- Unterstützung für verschiedene Modelle, Suchmaschinen und eigenes Korpus.
- Die MIT-Lizenz erleichtert Forschung, Anpassung und Weiterentwicklung.
- Die Arbeiten, der Code, die Datensätze sowie die Unterlagen zu den Nachweisversuchen sind relativ vollständig.
Einsatzbeschränkungen und Hinweise
- Die Behörden machen klar, dass die Ergebnisse in der Regel nicht direkt veröffentlicht werden können.
- Das Zitieren bedeutet nicht, dass jede Aussage bereits überprüft wurde.
- Webseiten, die nicht abgerufen werden können, führen zu 403-Fehlern, Parsing-Fehlern oder einem Mangel an Informationen.
- Die Qualität der Forschung hängt stark von Suchmaschinen und Sprachmodellen ab.
- Mehrfache Abfragen und Erstellungen können hohe API-Kosten verursachen.
- Komplexe Themen können zu ausführlichen, wiederholenden oder vom Thema abweichenden Berichten führen.
- Die Online-Voransicht ist kein kommerzielles Produkt mit Serviceversprechen.
- Die Implementierung erfordert Programmierung, Schlüsselverwaltung und Infrastrukturkapazitäten.
- Dynamische Webseiten, Paywalls und die Abdeckung nicht-textueller Inhalte sind begrenzt.
- Gebiete mit hohem Risiko müssen von Fachleuten überprüft werden.
- Eine öffentliche Vorschau eignet sich nicht für sensible oder vertrauliche Themen.
- Die MIT-Code-Lizenz beinhaltet keine Gebühren oder Lizenzen für Drittanbieter-Modelle und Suchdienste.
GitHub und der Open-Source-Zustand
Die offiziellen Repositorien von STORM und Co-STORM werden von stanford-oval gepflegt und unterliegen der MIT-Lizenz. Das Projekt umfasst das Kernpaket knowledge_storm, Beispiele für STORM und Co-STORM, eine leichte Frontend-Schnittstelle sowie Datensätze und Materialien zur Reproduzierbarkeit.
Python-Pakete können direkt installiert werden, und der Quellcode kann ebenfalls geändert werden. Große Modelle Dritter, Suchmaschinen, eingebettete Dienste sowie die Extraktion von Inhalten unterliegen weiterhin ihren jeweiligen Bedingungen. Die Offenlegung des STORM-Code bedeutet nicht, dass diese Einschränkungen ignoriert werden können.
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | STORM / Co-STORM |
| Entwicklerteam | Stanford OVAL |
| Arten von Werkzeugen | Wissensorganisation, tiefgehende Forschung und Erstellung von ausführlichen Berichten |
| Kernmethode | Mehrperspektivische Fragen, simulierte Interviews, suchoptimierte Ergebnisse und automatische Auszüge |
| Online-Version | Research Preview |
| Python-Pakete | knowledge-storm |
| Open-Source-Lizenz | MIT |
| Preis | Der Code ist kostenlos, Ressourcen wie Modelle und Suchfunktionen werden separat berechnet. |
| Wird eine API bereitgestellt? | Es wird eine Python-Schnittstelle bereitgestellt, keine einheitlich verwaltete kommerzielle API. |
| Hauptausgabe | Mit zitierten ausführlichen Berichten, Diskussionen und dynamischen Mind Maps |
Empfehlungswert
4,7 / 5. STORM macht die Suche aus mehreren Perspektiven sowie das Verfassen langer Berichte zu einem untersuchbaren, erweiterbaren Open-Source-Prozess. Die mensch-maschinelle Zusammenarbeit bei Co-STORM ist ebenfalls wertvoll; doch Zitate und Fakten müssen weiterhin einzeln überprüft werden. Die Kosten sowie die Komplexität bei der eigentlichen Implementierung sind nicht gering.
Häufige Fragen
Kann STORM kostenlos verwendet werden?
Bei der Online-Research-Preview werden keine Kosten für Mitgliedschaften angegeben; der Quellcode wird unter der MIT-Lizenz bereitgestellt. Für die Implementierung müssen die Kosten für Modelle, Suchfunktionen, Einbettungen sowie Server und Speicherträger getragen werden.
Können die von STORM erstellten Artikel direkt veröffentlicht werden?
Es wird nicht empfohlen. Die Behörden machen klar, dass in der Regel umfangreiche Bearbeitungen erforderlich sind; Zitate, Fakten, Struktur und Formulierungen müssen von Hand überprüft werden.
Was ist der Unterschied zwischen STORM und Co-STORM?
STORM ist eher für automatische Forschung und Dokumentation gedacht, während Co-STORM es Benutzern, KI-Experten sowie leitenden Agenten ermöglicht, gemeinsam zu diskutieren und dynamische Mindmaps zu pflegen.
Kann man eigene Dokumente verwenden?
Ja. VectorRM ermöglicht es, Forschungen auf Dokumenten und Vektordatensätzen zu basieren, die vom Benutzer bereitgestellt werden.
Wird ein lokales Modell unterstützt?
Die Architektur ermöglicht den Austausch von Modulkomponenten, und LiteLLM erweitert außerdem den Kompatibilitätsumfang. Konkrete lokale Modelle müssen je nach Kontext, Qualität und Hardware einzeln getestet werden.
Warum tritt manchmal ein 403-Fehler auf?
Einige Webseiten weigern sich, gescannt zu werden, oder die Seitenanalyse schlägt fehl. STORM protokolliert die Fehler und überspringt den entsprechenden Inhalt, was zu Lücken in den Verweisen und Informationen führen kann.
Bietet STORM eine kommerzielle API an?
Das Projekt bietet Python-Klassen und Modul-Schnittstellen, verfügt jedoch über kein einheitliches kommerzielles API-Paket zur Verwaltung. Entwickler müssen die Modelle sowie die Suchdienste selbst anschließen.
Ist STORM Open Source?
Open Source. Das offizielle GitHub-Repositorium sowie der Knowledge-Storm-Code sind unter der MIT-Lizenz verfügbar.
Werkzeuge, die Storm ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164