




FormX.ai
FormX.ai – eine intelligente Tool für Dokumente mit KI-Technologie
Tags:KI-DokumentenwerkzeugeEine kurze Beschreibung
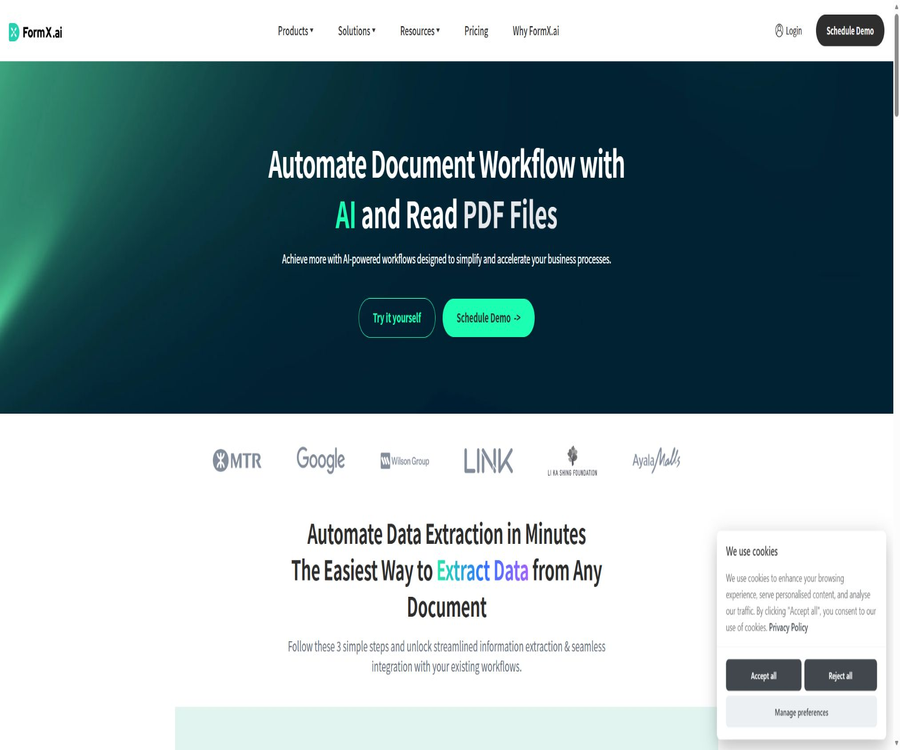
FormX.ai ist eine intelligente Plattform für die Verarbeitung von Dokumenten. Mithilfe von vortrainierten oder anpassbaren Extraktoren kann sie Rechnungen, Quittungen, Bankauszüge, Ausweise, Verträge sowie andere Geschäftsunterlagen erkennen und diese in strukturiertem JSON-Format an Finanz-, Betriebs- oder Entwicklungsysteme liefern.
Einführung in die Tools
FormX wird von SkyMakers Digital Limited betrieben. Die Produkte umfassen den Upload von Dokumenten, die Überprüfung der Bildqualität, die Klassifizierung und Aufteilung von Inhalten, das Extrahieren von Feldern, die Erkennung von Tabellen, Korrekturvorschläge sowie API- und Mobile-Scanning-Funktionen. Das Ziel ist es nicht nur, Bilder in Text umzuwandeln, sondern vielmehr Datenpipelines zu schaffen, die in den Produktionsprozess integriert werden können.
Die Benutzer können entweder vorkonfigurierte Extraktoren wählen oder eigene Beispiele hochladen und die erforderlichen Felder definieren, um eine maßgeschneiderte Konfiguration für ein bestimmtes Format oder einen Händler zu erstellen. Die Plattform ermöglicht außerdem die Wahl zwischen visuellen Modellen und großen Sprachmodellen sowie die Reduzierung instabiler Ausgaben mithilfe von Geschäftsregeln und Beispielen.
Hauptfunktionen
Vortrainierter Dokumentextraktor
Die Plattform bietet die Möglichkeit, gängige Dokumente wie Rechnungen, Quittungen und Ausweisdokumente vorzutrainieren – geeignet für Aufgaben mit relativ standardisierten Feldern. Die Benutzer müssen keine großen Mengen an Beispielen von Grund auf annotieren, sollten jedoch den Umfang der Unterstützung für Sprachen, Formatierungen sowie regionale Ausweisdokumente überprüfen.
Custom-Extractor
Benutzer können repräsentative Beispiele hochladen, Rechnungsnummern, Daten, Beträge sowie Felder für Lieferanten oder interne Unternehmensdaten definieren und diese durch Rückmeldungen kontinuierlich anpassen. Die individuelle Konfiguration eignet sich für Dokumente mit fester Struktur, bei denen die Bedeutung der Felder speziell ist oder bei denen das Standardmodell zu Verwirrung führt.
Dokumentenklassifizierung und -Aufteilung
Split & Classify kann die Dokumenttypen in gemischten Chargen erkennen und mehrere Dateien in Einheiten für die weitere Verarbeitung aufteilen. Es eignet sich für E-Mail-Anhänge, gescannte Dateien sowie PDFs mit mehreren Dokumenten. Für abweichende Seiten und unbekannte Typen muss jedoch eine manuelle Warteschlange erstellt werden.
Erweiterte Tabellenextraktion
Die fortgeschrittene Tabellenextraktion ist für Rechnungsdetails, Bankauszüge und andere tabellarische Strukturen geeignet und kann eine Liste der Einträge liefern, anstatt nur die Überschrifffelder zu erkennen. Überschriften über mehrere Seiten, zusammengeführte Zellen, handschriftliche Änderungen sowie schlecht scanierte Dokumente können weiterhin die Ergebnisse beeinträchtigen.
Feldprüfung und Accuracy Center
Das Accuracy Center dient zum Batch-Management von Datensätzen, zur Überprüfung der Ergebnisse sowie zur Rückgabe korrekter Werte an das Modell. Produktionsdaten können dem Extraktor dabei helfen, sich schrittweise an echte Dokumente anzupassen, wobei der Feedback-Prozess durch Berechtigungsverwaltung, Maskierung und Überprüfung gesteuert werden sollte.
AI Code Mapping
Durch die AI-Code-Mapping-Funktion kann der erkannte Text mit internen Codes, Kategorien oder Standardwerten des Unternehmens abgeglichen werden, wodurch manuelle Abgleiche reduziert werden. Wenn sich die Geschäftsdaten ändern, müssen die Zuordnungsregeln entsprechend aktualisiert werden, und es sollten weiterhin Optionen für manuelle Überprüfungen bei unklaren Fällen vorhanden sein.
Betrug und AI-basierte Bilderkennung
Die Liste der Starter- und Unternehmensfunktionen umfasst die Erkennung von Betrug sowie künstlichen Bildern, die als Risikosignale für Prozesse wie Rechnungsstellung, Ansprüche oder Dokumentenerstellung dienen können. Sie sollte nicht als endgültige Entscheidung bezüglich eines Betrugs angesehen werden; wichtige Entscheidungen erfordern die Berücksichtigung der ursprünglichen Unterlagen, Geschäftsunterlagen sowie einer manuellen Prüfung.
Überprüfung der Bildqualität
Die Funktionen für mobile Scannung und AI-Scanning ermöglichen es, vor dem Hochladen Unklarheiten, Lichtverhältnisse, unkorrekte Schnitte oder Probleme an den Rändern der Dokumente zu überprüfen – dadurch wird die Menge an minderwertigen Eingaben verringert. Die Qualität eines Dokuments bedeutet jedoch nicht automatisch, dass alle Felder korrekt sind; daher müssen für wichtige Betrags- und Identifikationsfelder immer noch Schwellenwerte für die Zuverlässigkeit festgelegt werden.
Kombination von visuellen Modellen und großen Sprachmodellen
FormX ermöglicht es, je nach Dokumenttyp, Verzögerungszeiten und Genauigkeitsanforderungen zwischen visuellen Modellen und großen Sprachmodellen zu wechseln oder diese zu kombinieren, wobei der Fokus auf der Reduzierung von Illusionen durch Einschränkungen liegt. Die konkreten zugrunde liegenden Modelle, die Verfügbarkeit in bestimmten Regionen sowie die Kosten können je nach Projektkonfiguration variieren.
Großangelegte PDF-Verarbeitung
Im Jahr 2026 werden neue Upload-Schnittstellen sowie Arbeitsabläufe für große Dateien hinzugefügt, mit denen Dokumente von bis zu 500 MB und 1.000 Seiten verarbeitet werden können. Die herkömmliche Schnittstelle zur Extraktion einzelner Bilder hat weiterhin eine Grenze von 10 MB für den Anfrageinhalt; diese beiden Schnittstellen unterliegen nicht derselben Beschränkung.
Verarbeitbare Dokumente
| Dokumentkategorie | Repräsentative Dokumente | Häufige Felder | Anwendungsfallen |
|---|---|---|---|
| Finanzdokumente | Rechnungen, Quittungen, Steuerdokumente | Nummer, Datum, Lieferant, Steuerbetrag, Gesamtbetrag | Forderungen, Abrechnungen und Prüfungen |
| Banken und Buchhaltung | Bankauszüge, Jahresberichte | Konto, Transaktionsdatum, Zusammenfassung, Betrag des Geliehens und Desolventen | Abrechnung, Cashflow und Buchführung |
| Identität und Qualifikationen | Personalausweis, Reisepass, Genehmigungen, Zertifikate | Name, Nummer, Gültigkeitsdauer, Ausstellungsstelle | Kontoeinrichtung, Einstellung und Konformitätsprüfung |
| Einkauf und Logistik | Bestellformulare, Lieferbescheinigungen, Frachtunterlagen | Bestellnummer, Material, Menge, Adresse, Status | Bestände, Lieferung und Lieferkette |
| Personalressourcen | Lebenslauf, Antragsformulare, Arbeitsvertrag, Lohnaufzeichnungen | Mitarbeiter, Erfahrungen, Positionen, Daten, Beträge | Rekrutierung, Einstellung und Aktenverwaltung |
| Recht und Geschäft | Verträge, Vertraulichkeitsabkommen, Geschäftslizenzen | Subjekt, Bestimmungen, Fristen, Verpflichtungen und Nummern | Vertragsregistrierung und Ablaufhinweise |
| Kundenservice | Garantieverfahren, Support-Anfragen, Serviceverträge | Kunden, Produkte, Probleme und Bearbeitungsstatus | Anspruchs- und Serviceautomatisierung |
Vollständiger Arbeitsablauf
- Wählen Sie Beispieldokumente aus, die das tatsächliche Layout, die Sprache, die Qualität sowie Ausreißer abdecken.
- Wählen Sie im Arbeitsbereich einen vorgefertigten Extraktor aus oder erstellen Sie einen benutzerdefinierten Extraktor und definieren Sie die Felder.
- Laden Sie ein Beispiel hoch, markieren Sie die korrekten Werte, die Tabellenaufbau sowie den Inhalt, der ignoriert werden soll.
- Nutzen Sie den Testdatensatz, um die Genauigkeit auf Feldebene zu bewerten – schauen Sie sich nicht nur eine kleine Anzahl an erfolgreichen Beispielen an.
- Konfiguration von Klassifizierung, Aufteilung, Überprüfung, Code-Abgleich, Vertrauensschwellenwerten und manueller Überprüfung.
- Dateien werden über die Arbeitsbereich oder API zugänglich gemacht, und strukturiertes JSON wird an das Geschäftssystem übermittelt.
- Regelmäßige Erfassung von Fehlfällen und Feedbacks, Überwachung von Layout-Abweichungen, Verzögerungen, Kosten und Ausfallraten.
Leitfaden zur Erstellung eines benutzerdefinierten Extraktors
- Registrieren Sie ein Konto und erstellen Sie ein Projekt; wählen Sie gemäß den Compliance-Anforderungen den Verarbeitungsbereich in den USA, Taiwan oder Singapur aus.
- Erstellen Sie einen neuen Extraktor für ein Geschäftsdokument, um zu vermeiden, dass Dateien mit zu großen Unterschieden in derselben Konfiguration abgelegt werden.
- Definieren Sie den Feldnamen, den Datentyp, ob das Feld erforderlich ist und die zulässigen Formate.
- Laden Sie repräsentative Beispiele hoch und überprüfen Sie den Umfang, in dem die Plattform diese Trainingsdateien speichert.
- Jedes Feld und jede Tabelle wird einzeln korrigiert, um Unklarheiten, Rotationen, leere Werte, Überschreiten von Seiten sowie unterschiedliche Formatierungen der Lieferanten zu beseitigen.
- Berechnen Sie mit einem unabhängigen Testdatensatz die Genauigkeit, die Fehlerrate bei Auslassungen und die Fehlerrate bei Fehlern für jedes Feld.
- Nach Erreichen des Geschäfts-Schwellenwerts wird die Konfiguration veröffentlicht, wobei Rückroll- und manuelle Überprüfungspläne beibehalten werden.
API-Anbindungstutorial
- Erstellen Sie einen Extraktor in der Web-Arbeitsbereich und holen Sie sich vom Dashboard die Identifikationsdaten sowie den Zugriffstoken für den Extraktor.
- Wählen Sie je nach Dateigröße und Dauer den Synchronisierungsmodus, den Asynchronmodus oder die Übertragungsmethode für große Dateien.
- Geben Sie die Anfrage über eine Datei oder die Adresse einer kontrollierten Datei ein und geben Sie die richtige Extraktor-Identifikation an.
- Synchronanfragen lesen die Ergebnisse direkt ab; asynchrone Anfragen speichern die Aufgabenidentifikation und prüfen in Abständen den Status der Ergebnisse.
- Analyse der Felder, Tabellen, Zuverlässigkeitswerte und Fehlermeldungen im JSON und anschließende Zuordnung zum Geschäftsdatenmodell.
- Fügen Sie Zeitüberschreitung, Idempotenz, verzögerte Wiederholungsversuche, Quotenverwaltung, Log-Demaskierung und eine Fehlerwarteschlange hinzu.
- Vor dem Go-Live werden Genauigkeit, Verzögerung, Durchsatz und Kosten pro Seite der echten Dateien gemessen.
Umfassende Anleitung zur Verarbeitung von PDF-Dateien
- Zuerst prüfen Sie die Anzahl der Seiten des Dokuments, die Dateigröße, ob es verschlüsselt ist und ob die Seite mehrere Dokumente enthält.
- Für Dateien mit einer Größe von bis zu 500 MB oder 1.000 Seiten wird der Prozess zum Hochladen großer Dateien verwendet – es sollte nicht der Request-Body für einzelne Bilder mit 10 MB verwendet werden.
- Aktivieren Sie Klassifizierung und Aufteilung, um gemischte Dokumente an die entsprechenden Extraktoren zuzuweisen.
- Verwenden Sie asynchrone Aufgaben, um lange Anfragen vor Ablauf der Frist zu vermeiden, und speichern Sie die Aufgabenerkennung, um Abfragen wieder aufzunehmen.
- Überprüfen Sie nach Seite und Dokument auf fehlende Seiten, falsche Reihenfolge, wiederholte Seiten, Tabellen, die über Seiten gehen, sowie fehlerhafte Seiten.
- Nachdem bestätigt wurde, dass die Ergebnisse in das eigene System gespeichert wurden, sollten die Dateien der Arbeitsumgebung gemäß der Datensicherheitsrichtlinien gelöscht werden.
Dateien, Größen und Anschlussbeschränkungen
| Eingang oder Projekt | Offene Einschränkungen oder Empfehlungen | Geeignete Situationen | Hinweise |
|---|---|---|---|
| Übertragung eines traditionellen Anfragekörpers | Einzelne Bilddateien bis zu 10 MB | Einzelbild oder kleines PDF | Wenn die Grenze überschritten wird, sollte eine andere Methode zum Hochladen verwendet werden. |
| Eingabe der Datei-Adresse | Laut dem Dokument gibt es keine ähnlichen Beschränkungen hinsichtlich der Dateigröße. | Es gibt bereits kontrollierte Objektspeicherung. | Die Berechtigungen für Links sowie ihre Gültigkeitsdauer müssen kontrolliert werden. |
| Großer Upload-Prozess | Maximal 500 MB, 1.000 Seiten | Ausführliche Berichte und Massenscannen von PDFs | Zu den neuen Eingängen im Jahr 2026 |
| Bildgröße | Einzelseite nicht mehr als 10.000 Pixel | Hochauflösende Fotos und Scans | Die Gesamtzahl der Pixel muss unter 75 M liegen. |
| Empfohlene Auflösung | Eindeutig 1.000 bis 2.000 Pixel oder mindestens 100 DPI | Allgemeine Belege und Formulare | Der Text muss lesbar sein. |
| Häufige Formate | JPEG, PNG, PDF | Bilder und Dokumente | Die vollständige Formatliste richtet sich nach der Arbeitsumgebung. |
| Asynchroner Modus | Ergebnisse nach Rückkehr der Aufgabe abrufen | Längere Dauer oder Batch-Verarbeitung | Nach Erhalt des Ergebnisses werden die Dateien gemäß den Regeln gelöscht. |
Für welche Benutzer geeignet
- Finanz- und Buchhaltungsteam: Masseneingabe von Rechnungen, Quittungen, Bankauszügen und Steuerdokumenten.
- Vertrieb- und Betriebsteam: Bearbeitung von Einkaufsaufträgen, Lagerbestandsaufzeichnungen, Lieferbescheinigungen und Ladenergebnisse.
- Logistikunternehmen: Extrahieren von Schlüsselfeldern aus Frachtpapieren, Adressnachweisen und Lieferdokumenten.
- Personalabteilung: Organisation von Lebensläufen, Antragsformularen, Lohnunterlagen und Ausweisdokumenten.
- Rechts- und Compliance-Team: Erstellung eines strukturierten Index für Verträge, Lizenzen und Gültigkeitsdaten.
- Softwareentwickler: Über APIs wird die Dokumentenerkennung in CRM-, ERP-Systeme oder eigene Workflows integriert.
- Mobile-App-Team: Einbetten von Dokumentenscannern in Android-, iOS- oder Flutter-Apps.
Typische Anwendungsszenarien
- Konvertieren Sie die von der E-Mail-Adresse oder dem Upload-Portal eingegangenen Rechnungen der Lieferanten in Daten zu Forderungen.
- Die Transaktionsdetails werden aus den Bankabrechnungen extrahiert und anschließend dem Abgleichs- und Klassifizierungsprozess zugeführt.
- Identifizieren Sie die Rechnungen für Rückerstattungen und kontrollieren Sie das Risiko durch Anzeichen von Betrug, Betragsregeln sowie manuelle Überprüfungen.
- In den Apps für die Eröffnung eines Kontos oder der Arbeitsaufnahme leitet man die Nutzer an, Ausweisdokumente aufzunehmen und die Bildqualität zu überprüfen.
- Teilen Sie das lange PDF in verschiedene Dokumenttypen auf und extrahieren Sie jeweils Felder und Tabellen.
- Verbinden Sie Cloud-Speicher, E-Mails, Workbenches sowie weitere Geschäftssoftware über Zapier oder n8n.
- Verwenden Sie interne Codes, um Lieferanten, Konten, Produkt- oder Filialnamen zu standardisieren.
Vorteile des Produkts
- Gleichzeitig werden vortrainierte Modelle, benutzerdefinierte Extraktoren und kontinuierliche Rückmeldungen bereitgestellt, nicht beschränkt auf allgemeine OCR-Texte.
- Von der Qualitätskontrolle und Klassifizierung über die Aufteilung bis hin zu strukturiertem JSON sowie einer umfassenden Code-Übersetzung – ein recht vollständiger Prozesspfad.
- Das Pay-as-you-go-Modell hat keine Mindestverpflichtung und eignet sich, um zunächst mit echten Proben zu testen.
- Der Starter enthält offiziell 3.000 Seiten, 20 Smart-Learning-Beispiele sowie fortgeschrittene Funktionen.
- Unterstützt Synchronisierung, Asynchronisierung sowie große Dateipfade; kann Einzelbildern und langen PDF-Dateien verarbeiten.
- Es werden Verarbeitungsbereiche in den USA, Taiwan und Singapur bereitgestellt, und es wird die Abstimmung von Unternehmens-Private-Cloud-Lösungen unterstützt.
- Verfügt über API sowie mobile Scann-Komponenten für Android, iOS und Flutter.
- Die Plattform behauptet, die Zertifizierungen ISO 27001 und SOC 2 Type II zu besitzen.
Einsatzbeschränkungen und Hinweise
- Die Genauigkeit der Erkennung hängt von der Qualität des Dokuments, der Formatierung, der Definition der Felder sowie der Sprache ab. Marketing-Kennzahlen sollten nicht als Zusagen angesehen werden.
- Laut offiziellen Beispielen können die Anteile der regulären Felder in hochwertigen Bildern über 90 % betragen, doch es handelt sich dabei nicht um einen einheitlichen SLA.
- Die einfache Pay-as-you-go-Lösung beinhaltet keine fortgeschrittenen Funktionen; Kategorisierung, Tabellen, Code-Übersetzungen usw. erfordern die Starter- oder Unternehmenslösung.
- Auf der Preisseite werden sowohl die Angaben pro Seite als auch die Angaben pro Aufruf verwendet; die Abrechnungseinheit für große, mehrseitige Dokumente muss vorher schriftlich festgelegt werden.
- Die Größenbeschränkungen für traditionelle Schnittstellen und große Upload-Portale unterscheiden sich, daher muss beim Integrieren der richtige Pfad gewählt werden.
- Synchronisierte Dateien werden nicht dauerhaft gespeichert, asynchrone Dateien werden vorübergehend verschlüsselt aufbewahrt; das Hauptdokument sowie die Trainingsbeispiele werden gespeichert.
- Dass der Verarbeitungsbereich optional ist, bedeutet nicht, dass alle Unterverarbeiter und Modellaufrufe notwendigerweise im selben Gebiet angesiedelt sind.
- Die Dienste dürfen nicht direkt für automatische Entscheidungen verwendet werden, die ein Risiko für Leben, die Umwelt oder wichtige Infrastrukturen darstellen können.
- Beta-, kostenlose Test-, Vorschau- und nicht-produktive Schlüsselumgebungen sind nicht durch eine gebührenpflichtige SLA abgesichert.
- Die API-Ausgaben müssen einer manuellen Überprüfung sowie einer betriebsinternen Validierung unterzogen werden, insbesondere bei den Feldern für Beträge, Identitätsdaten und Vertragsinformationen.
Preise und Pakete
| Plan | Preis | Abrechnungszeitraum | Limit und Vorteile | Für Nutzer geeignet |
|---|---|---|---|---|
| Kostenloser Probemonat | Die ersten 100 Seiten sind kostenlos. | Einmalige Testnutzung | Für den Einsatz in Arbeitsbereichen oder zur Testung von APIs; Seitenaufrufe werden bis zu 100 Mal kostenlos angeboten. | Konzeptvalidierung und Probentests |
| Pay-as-you-go | Ab 0,30 US-Dollar pro Seite | Nach Bedarf | Keine Mindestverpflichtung, ohne erweiterte Funktionen | Niedrigfrequenter oder einmaliger Prozess |
| Starter | 299 US-Dollar/Monat/Extraktor | Monatsgebühr | 3.000 Seiten pro Monat; für jede zusätzliche Seite fallen 0,10 US-Dollar an. 20 Smart-Learning-Beispiele sowie fortgeschrittene Funktionen. | Kleine Unternehmen und stabile Prozesse |
| Enterprise | Individuelle Kostenschätzung | Vertragsvereinbarungen | Alle Funktionen von Starter, maßgeschneiderte SLAs, Kundenservice, Betriebsunterstützung und Private Cloud | Hohe Durchsatzrate, Konformität und komplexe Implementierung |
Das Datum der Preisüberprüfung ist der 22. August 2026. Der angegebene Preis beinhaltet keine Steuern und Abgaben. Die Kosten für die Dienstleistungen können mit 30 Tagen Vorlaufzeit geändert werden; die Abonnementverlängerung erfolgt standardmäßig automatisch. Eine Kündigung wird in der Regel am Ende der aktuellen Laufzeit wirksam. Für bereits bezahlte Laufzeiten wird grundsätzlich kein Rückzahlung gewährt.
Vergleich der Funktionen der Pakete
| Fähigkeiten | Nach Bedarf | Starter | Enterprise |
|---|---|---|---|
| Probelauf der ersten 100 Seiten | Unterstützung | Man kann es erst einmal ausprobieren. | Kann durch Demonstration oder Vertrag überprüft werden |
| Mindestverpflichtung | Keines | 299 US-Dollar/Monat/Extraktor | Gemäß Vertrag |
| Anzahl der Seiten | Nach tatsächlicher Bearbeitung | 3.000 Seiten/Monat | Maßanfertigung |
| Überhöhter Einzelpreis | Ab 0,30 US-Dollar pro Seite | 0,10 US-Dollar/Seite | Maßanfertigung |
| Erweiterte Tabellen, Aufteilen und Klassifizieren | Nicht enthalten | Enthält | Enthält |
| AI-Code-Mapping und Betrugserkennung | Nicht enthalten | Enthält | Enthält |
| Accuracy Center | Nicht enthalten | Enthält | Enthält |
| Unterstützung | Übliche Ressourcen | Community-Forum | Kundenservice und Support im Betrieb |
| SLA | Keine Anpassungsversprechen | Bezahlte allgemeine SLA | Anpassbar |
| Private Cloud | Nicht verfügbar | Nicht aufgeführt | Verhandelbar |
Durchsatz, Verzögerung und Genauigkeit
| Indikatoren | Öffentliche Referenzen | Art der Verpflichtung | Empfehlungen zur Verwendung |
|---|---|---|---|
| Übliche Geschäftsbelastung | Ohne Produktdetails mindestens 180 Mal pro Minute | Preisfragen dienen als Referenz für Geschäftspläne, es gibt kein SLA. | Mit echtem parallelem Belastungstest |
| Durchsatz mit Produktdetails | Mindestens 30 Mal pro Minute | Keine SLA-Zusagen | Bewertungstabelle und Komplexität der Zeileinträge |
| Verzögerung bei der Bearbeitung der Quittungen | In der Regel 4 bis 8 Sekunden, ohne Hochladen | Nicht SLA | Messung der Dateigröße und des regionalen Netzwerks |
| Allgemeine Genauigkeit der Felder | Kundenreferenzen von mindestens etwa 70% | Nicht einheitliche Garantien | Messung nach Feldern und Stichprobenmengen |
| Häufige Felder für hochwertige Bilder | Datum, Zeit und Betrag können 90 % überschreiten. | Referenzen zu Kundenfeedback | Nicht auf alle Felder übertragen möglich |
| Monatliche Verfügbarkeit gegen Bezahlung | 99.95% | Allgemeine SLA | Es gibt viele Ausschlusskriterien und man muss aktiv Punkte beantragen. |
Die Genauigkeit muss nach Geschäftsfeldern, Dokumentenkanälen und den Kosten für Fehler definiert werden. Der Durchschnittswert kann eine geringe Genauigkeit bei wichtigen Feldern wie Rechnungsnummern, Beträgen oder Personalausweisnummern verbergen; daher sollten jeweils Schwellenwerte festgelegt sowie eine manuelle Überprüfung durchgeführt werden.
SLA und Servicepunkte
Das Pay-as-you-go-Plan bietet eine SLA-Garantie von 99,95 % Verfügbarkeit pro Monat. Wartungsarbeiten werden in der Regel 48 Stunden im Voraus angekündigt; pro Jahr dürfen insgesamt maximal 12 Stunden für Wartungsarbeiten eingesetzt werden. Wenn diese Ziele nicht erreicht werden, muss der Kunde einen Antrag stellen – in diesem Fall beträgt der Betrag 10 % der monatlichen Gebühren.
| Projekt | Regeln | Einschränkungen |
|---|---|---|
| Monatliche Verfügbarkeit | 99.95% | Ohne geplante Wartungsarbeiten und Störbehebungen |
| Planmäßige Wartungshinweise | 48 Stunden im Voraus | Jährlich sind maximal 12 Stunden Wartungsarbeiten geplant. |
| Entschädigung bei Nichterfüllung der Vorgaben | 10% Service-Punkte für die Kosten des Monats | Nicht bar, der Kunde muss einen Antrag stellen. |
| Testen und Beta | Kein SLA gültig | Kostenlos, Vorschau und Early Access sind ausgeschlossen. |
| Nicht-produktive Schlüssel | Kein SLA gültig | Ausklammern von Sandbox- oder Nicht-Produktionsumgebungen |
| Unternehmensversprechen | Anpassbar | Es muss ein Angebot oder Vertrag erstellt werden. |
API und strukturierte Ausgabe
Die Extraktions-Schnittstelle wird über ein Zugriffstoken authentifiziert und verwendet einen Extraktor-Identifikator zur Auswahl der Erkennungskonfiguration. Das erfolgreiche Ergebnis wird als JSON zurückgegeben, was eine Zuordnung zu ERP-, CRM-, Datenbank-, Genehmigungssystemen oder Automatisierungsplattformen ermöglicht.
Für zeitaufwändige Aufgaben kann der asynchrone Modus aktiviert werden: Das System gibt zunächst die Identifikation der Aufgabe zurück, und der Client fragt anschließend nach den Ergebnissen. Bei der Integration in die Produktion müssen Quoten, Ablaufdaten der Aufgaben, mehrfache Einreichungen, lokale Fehler sowie Änderungen bei den Ergebnisversionen berücksichtigt werden.
Mobile SDK
| Komponenten | Plattform | Mindestanforderungen oder Zustände | Hauptverwendungszweck |
|---|---|---|---|
| Ursprüngliches FormX SDK | Android und iOS | Es gibt offene Referenzen und Beispiele. | Dokumentenerkennung, Fotografieren und mobile Scannung |
| Flutter SDK | Android | SDK 26 und höher | Die native Kameravorschau in plattformübergreifenden Anwendungen |
| Flutter SDK | iOS | iOS 14 und neuer | Anrufung der Scannfunktionen von iOS in Flutter |
| Flutter Desktop und Web | macOS, Windows, Linux, Web | Derzeit nicht unterstützt. | Man darf nicht annehmen, dass mobile Pakete direkt auf diese Plattformen übertragen werden können. |
| Beispielanwendung für AI-Scanning | Android | Offene Anwendungspräsentation | Erleben Sie das Fotografieren von Quittungen, deren Erkennung sowie den Austausch der Ergebnisse. |
Das Mobile SDK löst hauptsächlich die Probleme im Zusammenhang mit der Kamerabetrachtung, der Erkennung von Dokumenten sowie der Erfassung von Inhalten. Die tatsächliche Extraktion der Daten hängt weiterhin von den FormX-Diensten sowie der Konfiguration des Projekts ab. Bei der Anforderung von Zugriffsrechten auf die Kamera muss eine klare Beschreibung des Zwecks angegeben werden. Zudem sollte man vermeiden, Zugriffstoken direkt im Client zu kodieren.
Integrationsschema
| Methode | Passende Szenarien | Ausgabe oder Verbindung | Hinweise |
|---|---|---|---|
| Web-Arbeitsbereich | Personalbesetzung und Testing der Geschäftsprozesse | Visualisierte Ergebnisse und Datensätze | Die Hauptdokumente und die Trainingsbeispiele können gespeichert werden. |
| Synchronisierungs-API | Einzelseiten- und Prozesse mit geringer Verzögerung | Sofort in JSON zurückkehren | Eingeschränkt durch die Anfragezeit und den 10 MB großen Anfrageinhalt |
| Asynchrone API | Lange Aufgaben und Batchverarbeitung | Aufgabenidentifikation und Ergebnisabfrage | Es müssen abgelaufene Aufgaben bearbeitet und Versuche wiederholt werden. |
| Große Upload-API | Maximal 500 MB, 1.000 Seiten | Strukturierte Ergebnisse für mehrseitige Dokumente | Die Gebühren nach Seitenanzahl müssen bestätigt werden. |
| Mobile SDK | Mobile Erfassung und Qualitätskontrolle | Foto oder Scan-Ergebnis | Android, iOS und Flutter haben unterschiedliche Unterstützungsgebiete. |
| Zapier und n8n | Low-Code-Werkflüsse | Verbindung von Dateikanälen und Unternehmensanwendungen | Zertifikate, Wiederholungsversuche und sensible Daten müssen kontrolliert werden. |
Privatsphäre, Dateispeicherung und Training
| Datentypen | Speicherregeln | Training oder Nutzung | Benutzermaßnahmen |
|---|---|---|---|
| Synchronisierte API zum Extrahieren von Dateien | Nicht in die permanente Speicherung aufnehmen | Zur Durchführung dieser Extraktion verwendet. | Sensible Felder und Protokolle sollten weiterhin kontrolliert werden. |
| Asynchrone API-Dateien | Verschlüsselte vorübergehende Speicherung, Ergebnisse werden abgerufen oder gelöscht, wenn die Aufgabe abläuft | Zur Ausführung asynchroner Aufgaben | Ergebnisse rechtzeitig abrufen und Ablaufdatum überprüfen |
| Hauptdokument des Arbeitsbereichs | Wird gespeichert | Zur Konfiguration und Bedienung durch Benutzer | Klare Löschprozesse und Aufbewahrungsfristen |
| Anpassung von Trainingsbeispielen für Modelle | Wird gespeichert | Kundenspezifische Modelle für Anfragen der Kunden | Desensibilisierung und Beschränkung der Teamrechte |
| Kontoinformationen und Teaminformationen | Bevor das Konto gelöscht wird, wird es aufbewahrt. | Anmelden, Abrechnung, Support und Betrieb | Bei Löschung des Kontos wird der geteilte Inhalt separat behandelt. |
| Verwendung von Aktivitäten und Metadaten | Nach der notwendigen Frist aufbewahren | Produktverbesserung, Analyse und Sicherheit | Anforderungen an Unternehmensprotokolle und Aufbewahrungsanweisungen |
| Training generativer Modelle | Im Prinzip wird es nicht für die Schulung anderer Kunden verwendet. | Nur mit schriftlicher Zustimmung, zur Erbringung von Dienstleistungen für diese Kunden oder aufgrund gesetzlicher Anforderungen usw. – Ausnahmen. | Bestätigung von Ausnahmen und Anonymisierung in der DPA |
Die Daten können in den Regionen USA, Taiwan oder Singapur gehostet und verarbeitet werden. Die Plattform nutzt außerdem Dienstleister für Cloud-Hosting, KI-Berechnungen, Zahlungen, Überwachung und Analyse. Bevor man eine Region für die Speicherung der Daten auswählt, sollte man den DPA, den Standort der Dienstleister sowie die Mechanismen für die grenzüberschreitende Übertragung prüfen.
- Führen Sie Synchronisation, Asynchronisation, die Hauptdokumente der Arbeitsbereiche sowie die Trainingsbeispiele getrennt in die Datenklassifizierung ein.
- Laden Sie nur die Seiten und Felder hoch, die für die Erledigung der Aufgabe erforderlich sind. Wenn eine Maskierung möglich ist, sollte diese zuerst durchgeführt werden.
- Verwenden Sie die geringsten Berechtigungen für das Team und räumen Sie regelmäßig ausscheidende Mitglieder sowie abgelaufene Zugriffstoken auf.
- FormX speichert die Originaldateien sowie die endgültigen Daten in seinem eigenen System; es übernimmt keine Verantwortung für das Backup oder die Archivierung.
- Unterschreiben Sie eine DPA für personenbezogene Daten und überprüfen Sie den Unterauftragnehmer, die Region, die Verschlüsselung sowie den Löschnachweis.
- Verwenden Sie den Service nicht für Entscheidungen im Bereich Medizin, Lebenssicherheit oder kritische Infrastrukturen, bei denen keine menschliche Überprüfung erforderlich ist.
Sicherheit und Konformität
FormX behauptet, den Anforderungen von ISO 27001 sowie SOC 2 Type II zu entsprechen, und bietet seinen zahlenden Kunden allgemeine SLA-Bedingungen an. Unternehmen sollten bei ihren Einkäufen weiterhin Berichte über die Gültigkeitsdauer, Zusammenfassungen der Penetrationstests, Unterlagen zur Geschäftskontinuität sowie Bestimmungen bezüglich der Meldung von Sicherheitsvorfällen anfordern.
Die Bestimmungen definieren den Kunden als Kontrolleur personenbezogener Daten und FormX als Verarbeiter, und sie beziehen sich auf die DPA sowie die Liste der Unterauftragsverarbeiter. Ein Zertifikat kann den Zugriffskontrollmechanismus, die Minimierung von Daten sowie die manuelle Überprüfung in konkreten Projekten nicht ersetzen.
API, GitHub und Open Source
FormX bietet offizielle API-Dokumentationen, Referenzmaterialien für Android und iOS SDK sowie eine Flutter-Abstraktionsschicht. Das Flutter SDK im Oursky-Repository wird unter der MIT-Lizenz bereitgestellt und unterstützt Android SDK ab Version 26 sowie iOS ab Version 14; es gibt außerdem ein Repository mit Dokumentationen für die nativen SDKs sowie ein Archiv mit älteren Hilfedokumenten.
Die Veröffentlichung von SDKs und Dokumentationen bedeutet nicht, dass die FormX-Identifizierungsplattform open source ist. OCR, Modellrouting, kundenspezifisches Training, Accuracy Center, Cloud-Extraktion sowie die Unternehmensarbeitsbereiche bleiben weiterhin als proprietäre Dienste verfügbar; zur Nutzung des SDKs ist weiterhin ein Zugang zu einer kommerziellen Plattform erforderlich.
| Projekt | Offener Status | Lizenz oder Anleitung |
|---|---|---|
| FormX-Cloud-Plattform | Closed Source | Wirtschaftliche Hosting-Dienste |
| API abrufen | Offene Dokumente | Konto, Zugriffstoken und Zahlungslimit erforderlich |
| Eigene Mobile SDK | Offene Lager und Referenzen | Der Lagerbereich wird in dem öffentlichen Überblick nicht mit der allgemeinen Lizenz der Plattform dargestellt. |
| Flutter SDK | Offener Quellcode | MIT-Lizenz |
| Alte Hilfedokumentation | Öffentlich, aber archiviert | Ab 18. April 2024 nur Lesen |
| Benutzerdefinierte Modelle und Arbeitsbereiche | Closed Source | Kann nicht eigenständig offline bereitgestellt werden |
Grundlegende Informationen
| Projekt | Inhalt |
|---|---|
| Name des Tools | FormX.ai |
| Betreibende Stelle | SkyMakers Digital Limited |
| Registrierungsort | England und Wales in Großbritannien |
| Arten von Werkzeugen | Intelligente Dokumentverarbeitung, OCR und Extraktion strukturierter Daten |
| Kern-Eingabe | Bilder, PDFs, Scans und Dokumente von Mobilgeräten |
| Kernausgabe | JSON, das aus Feldern, Tabellen und Metadaten besteht |
| Preismuster | 100 Seiten als Testversion, Abrechnung pro Seite, Monatsabonnement und Unternehmenskonditionen |
| Ist eine Registrierung erforderlich? | Konfiguration, API und kostenpflichtige Nutzung erfordern ein Konto. |
| Chinesische Unterstützung | Die Verarbeitungskapazität muss anhand von Messungen im Dokument ermittelt werden; Verwaltung und Dokumente sind hauptsächlich auf Englisch. |
| Verarbeitungsgebiet | USA, Taiwan, Singapur |
| Hauptplattformen | Web-Arbeitsbereich, API, Android, iOS und Flutter |
| Offene API | Anbieten |
| Offizielles SDK | Android, iOS und Flutter |
| Ist das Produkt open source? | Nicht open source |
| Open-Source-Bereich | Das Flutter SDK verwendet die MIT-Lizenz. |
| Mindestalter | 18 Jahre alt |
| Datum der Preisüberprüfung | 22. August 2026 |
Empfehlungswert
Empfehlungswert: 4,3 / 5. FormX.ai bietet eine recht umfassende Produktionskette – von der Dokumentqualität über die Klassifizierung und Trennung der Inhalte bis hin zur Extraktion von Feldern und Tabellen sowie zur Rückmeldung an den Benutzer. Zudem sind die Preise sowie die Anleitungen zur Datenverarbeitung genauer angegeben als bei vielen anderen OCR-Diensten.
Der Hauptmangel besteht darin, dass Starter nach dem Extractor abgerechnet wird; komplexe Anwendungen erfordern möglicherweise mehrere Konfigurationen. Bei großen Dateien gibt es erhebliche Unterschiede zu den Beschränkungen der normalen Schnittstellen. Auch die Abrechnung pro Seite und pro Aufruf muss noch bestätigt werden. Die Schlüsselfelder müssen weiterhin anhand echter Beispiele, durch manuelle Überprüfung sowie unter Berücksichtigung der vertraglichen SLA-Kriterien überprüft werden.
Häufige Fragen
Was macht FormX.ai?
Es extrahiert Felder und Tabellen aus Rechnungen, Quittungen, Auszügen, Dokumenten, Verträgen und anderen Unterlagen und liefert sie in strukturierter JSON-Form an Workflows oder Geschäftsunternehmen.
Ist FormX.ai nur OCR?
Nein. OCR ist nur die Grundlage für die Texterkennung. FormX bietet zudem Dokumentenklassifizierung, Aufteilung von Dokumenten, benutzerdefinierte Felder, Tabellen, Code-Übersetzung, Feedback sowie Integration in Geschäftsprozesse.
Ist FormX.ai kostenlos?
Die ersten 100 Seiten können kostenlos getestet werden; auch die Anzahl der Abfragen ist in den ersten 100 Fällen kostenlos. Wie bei Dokumenten mit mehr Seiten berechnet wird, muss vor dem Beginn der Massenverarbeitung geklärt werden.
Wie viel kostet die Nutzung nach Verbrauch?
Das Preismodell beginnt bei 0,30 US-Dollar pro Seite; es gibt keine Mindestvertragslaufzeit, doch es sind keine fortgeschrittenen Funktionen enthalten. Die Preise können sich ändern, Steuern und die tatsächliche Rechnung richten sich nach der endgültigen Abrechnung.
Was enthält der Starter?
Der Starter kostet 299 US-Dollar pro Monat und pro Extraktor – dabei sind 3.000 Seiten inbegriffen. Für jede weitere Seite fallen 0,10 US-Dollar an. Zudem sind 20 Smart Learning-Beispiele, ein Accuracy Center, Funktionen zur Klassifizierung, Code-Mapping sowie fortgeschrittene Tabellen enthalten.
Welche Größe von PDFs wird unterstützt?
Der neue, verbesserte Upload-Prozess unterstützt Dateien mit einer Größe von bis zu 500 MB sowie bis zu 1.000 Seiten. Der Upload über den herkömmlichen Anfrage-Formaten ist weiterhin auf 10 MB beschränkt; diese Einschränkung gilt nicht für alle Upload-Möglichkeiten.
Welche Dateiformate werden unterstützt?
In den offiziellen Dokumenten werden die gängigen Formate wie JPEG, PNG und PDF ausdrücklich aufgeführt. Andere Formate, verschlüsselte PDFs sowie spezielle Kodierungen sollten im Projekt getestet werden.
In welcher Formatierung werden die Extraktionsergebnisse geliefert?
Die Felder, Tabellen und relevanten Informationen werden hauptsächlich im JSON-Format zurückgegeben, was das Einfügen in Datenbanken, ERP-Systeme, CRM-Systeme oder automatisierte Workflows erleichtert.
Wird die Datei gespeichert?
Synchron abgerufene Dateien werden nicht in der dauerhaften Speicherung gespeichert; asynchrone Dateien werden vorübergehend verschlüsselt aufbewahrt und nach der Rückgabe der Ergebnisse oder Ablauf der Frist gelöscht. Die Hauptdokumente des Arbeitsbereichs sowie die benutzerdefinierten Trainingsbeispiele werden gespeichert.
Wird das Dokument zur Schulung von öffentlichen Modellen verwendet?
Laut den Bedingungen werden die Inhalte der Kunden nicht verwendet, um generative Modelle für andere Kunden oder Dritte zu trainieren, es sei denn, es gibt vorherige schriftliche Zustimmung des Kunden, dies ist zur Erbringung und Verbesserung der Dienstleistungen für diesen Kunden notwendig, oder es besteht eine gesetzliche Verpflichtung.
Wo werden die Daten verarbeitet?
Beim Erstellen eines Projekts kann man zwischen den Regionen USA, Taiwan oder Singapur wählen; für die Infrastruktur werden GCP und Azure verwendet. Dennoch sollte man die Übertragungswege für KI-Berechnungen sowie andere Verarbeitungsdienste über Grenzen hinweg überprüfen.
Wie hoch ist die Genauigkeit der Erkennung?
Es gibt keine einheitliche Genauigkeitsrate, die für alle Dokumente gilt. Laut offiziellen Angaben liegt die Genauigkeit bei den üblichen Feldern in der Regel bei über 70 %. Bei hochwertigen Quittungen können die Angaben zu Datum, Zeit und Betrag sogar über 90 % liegen – doch das sind keine verbindlichen Zahlen.
Wie lange dauert es, eine Quittung zu bearbeiten?
Die durchschnittliche Verzögerung liegt in der Regel bei 4 bis 8 Sekunden – dabei ist die Zeit zum Hochladen nicht einbezogen, und es handelt sich auch nicht um eine SLA. Die Dateigröße, das Netzwerk, der Extraktor sowie die Komplexität der Tabellen beeinflussen alle die Verzögerung.
Wird eine API bereitgestellt?
Zur Verfügung gestellt. Entwickler verwenden Zugriffstoken und Extraktoren, um Dokumente einzureichen, und können zwischen synchroner, asynchroner oder Prozessen für große Dateien wählen.
Wird die Anbindung von mobilen Apps unterstützt?
Es wird Android, iOS und das Flutter SDK unterstützt; es ist möglich, Kamerabilder, Dokumentenerkennung sowie Aufnahmefunktionen einzubinden. Flutter unterstützt derzeit weder Web- noch Desktop-Plattformen.
Ist FormX.ai open source?
Die Plattform selbst ist nicht open source. Das Flutter SDK wird unter der MIT-Lizenz bereitgestellt; einige SDKs sowie Dokumentationsräume sind öffentlich zugänglich, doch die Cloud-basierte Erkennung, das Training sowie die Arbeitsumgebung bleiben kommerzielle Dienste.
Gibt es ein SLA für die Verfügbarkeit?
Der allgemeine SLA für die Pay-as-you-go-Pläne beträgt 99,95 % pro Monat. Falls diese Marke nicht erreicht wird, kann man 10 % der Kosten für den jeweiligen Monat in Servicepunkte umwandeln lassen. Testumgebungen, Beta-Versionen, Vorabversionen sowie Nicht-Produktionsumgebungen fallen nicht unter die Garantiebedingungen.
Eignet es sich für Entscheidungen im Bereich der Medizin oder zur Sicherung des Lebens?
Es eignet sich nicht für die direkte Anwendung in Situationen mit hohem Risiko, die zum Tod, zu Verletzungen oder zu Störungen in der kritischen Infrastruktur führen können. In solchen Fällen ist im Voraus eine gesonderte schriftliche Vereinbarung erforderlich.
Zusammenfassung
FormX.ai eignet sich für Teams, die Rechnungen, Ausweise, Verträge sowie lange PDF-Dateien in strukturierte Geschäftsdaten umwandeln möchten – insbesondere für Projekte, bei denen angepasste Felder, Tabellen, mobile Scannfunktionen sowie API-Integrationen erforderlich sind. Ein Probelauf nach Gebrauch ermöglicht es, zunächst mit echten Dokumenten eine genaue Basis für Genauigkeit und Kosten zu ermitteln.
Vor dem Go-Live müssen die Dateilimits sowie die Abrechnungseinheiten für jede Art von Eingang klar festgelegt werden. Zudem muss unterschieden werden, wie Synchronisierungs-, Asynchronisierungs-Verfahren sowie die Speicherung der Hauptdokumente und Trainingsbeispiele ablaufen. Außerdem sollen Schwellenwerte für wichtige Felder, manuelle Überprüfungen, Verarbeitungsbereiche, Unterauftragnehmer sowie Durchsatz und SLA in den Umsetzungsplan oder Vertrag aufgenommen werden.
Werkzeuge, die dem FormX.ai ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164