




RAGFlow
Open-Source-RAG-Engine, die Dokumentverständnis und nachvollziehbare Suche betont
Tags:AI AgentWas ist RAGFlow?
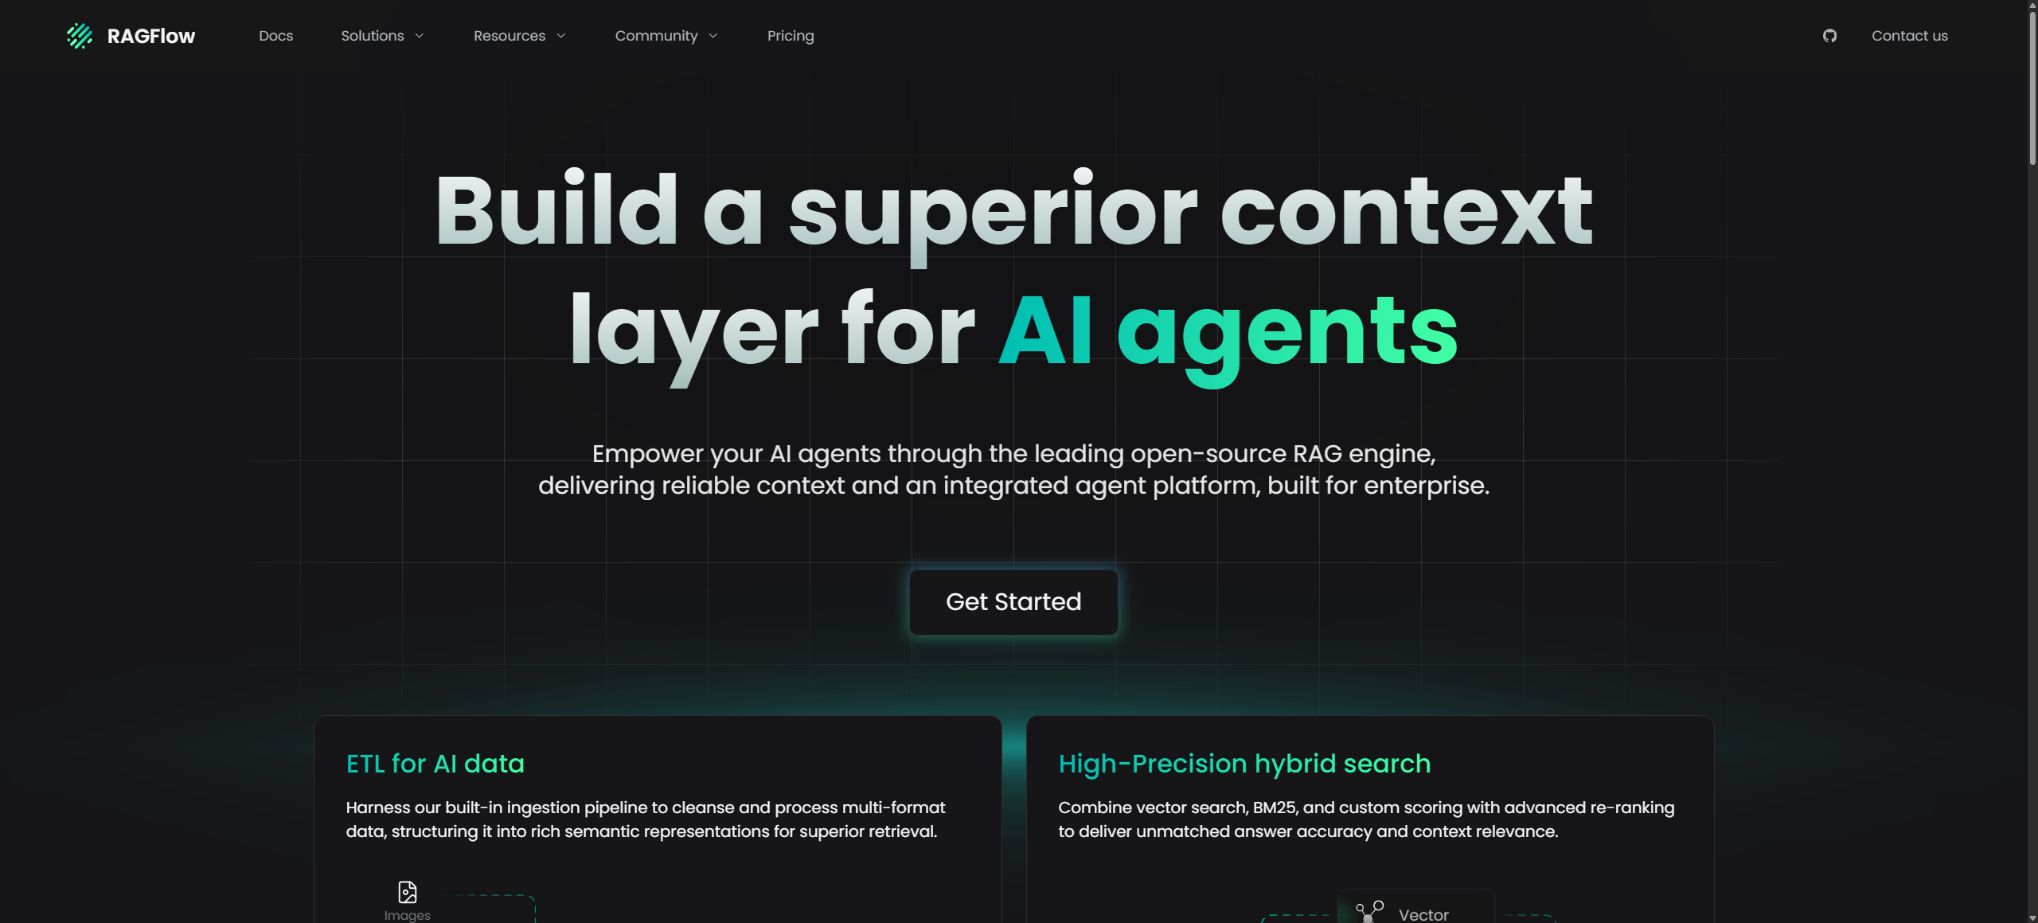
RAGFlow ist eine von dem Team von InfiniFlow entwickelte Open-Source-Plattform für die Erweiterung der Suchfunktionen sowie für KI-Agenten. Sie bündelt Dokumentenerfassung, Verständnis der Dokumentstruktur, Aufteilung in Blöcke, Vektorisierung, Volltextsuche, Umordnung von Inhalten, Fragen beantworten sowie Agentenworkflows und APIs in einem einzigen System zusammen. Ziel ist es, für große Sprachmodelle eine nachvollziehbare und verwaltbare Kontextschicht zu schaffen.
Im Gegensatz zu einfachen Wissensdatenbanken, die nur reinen Text in feste Längen aufteilen, legt RAGFlow mehr Wert auf die komplexe Struktur von Dokumenten. Es erkennt Überschriften, Absätze, Tabellen, Bilder sowie die Seitenstruktur und ermöglicht es den Nutzern, jeden „Chunk“ sowie seine Position anzusehen und zu ändern. Dies eignet sich besonders für Verträge, Finanzberichte, wissenschaftliche Arbeiten, Bedienungsanleitungen, gescannte Dokumente sowie Office-Dateien mit komplexer Struktur.
Kernfunktionen
1. Tiefgehendes Verständnis von Dokumenten
Integrierte DeepDoc-Technologie sowie ein anpassbarer Ingestion-Pipeline dienen zur Verarbeitung von Dokumenten in den Formaten Word, Slides, Excel, TXT, Bildern, Scans, strukturierten Daten sowie Webseiten. Das System kann mithilfe von OCR-, Layout-Analyse- und multimodalen Modellen die Inhalte von Texten, Tabellen und Bildern extrahieren und dabei die Positionen der Dokumente sowie die Metadaten beibehalten.
In der neuen Version kann man außerdem zwischen verschiedenen Parsing-Backend-Optionen wie MinerU, Docling und OpenDataLoader wählen. Die Leistung der verschiedenen Parser bei der Verarbeitung von Scans, Artikeln mit zwei Spalten, Formeln, komplexen Tabellen sowie großen Dateien unterscheidet sich erheblich. Vor der endgültigen Aufnahme sollten daher Proben der bearbeiteten Inhalte überprüft werden – anstatt davon auszugehen, dass jeder PDF fehlerfrei konvertiert werden kann.
2. Modulare Aufteilung in Blöcke
RAGFlow bietet je nach Dokumenttyp verschiedene Chunk-Vorlagen an, wie z. B. allgemeine Dokumente, Bücher, wissenschaftliche Arbeiten, Rechtsdokumente, Fragen und Antworten, Tabellen, Bilder und Wissensgraphen usw. Die Vorlagen berücksichtigen die Titelhierarchie, Absatzgrenzen und Layout-Informationen. Der Benutzer kann die Ergebnisse der Aufteilung in der Benutzeroberfläche ansehen und sie manuell ändern.
Die Blockgröße bestimmt die Granularität der Suche. Zu kleine Blöcke führen zum Verlust des Kontexts, zu große hingegen erhöhen den Rausch und die Kosten für Tokens.
Jedes Template sollte mit realen Problemen getestet werden, und die Trenner, Blockgrößen, Überschneidungen sowie Metadaten sollten entsprechend den verfügbaren Daten angepasst werden.
3. Vektoren, BM25 und gemischte Suche
Die Suchschicht unterstützt sowohl die vektorbasierte semantische Suche als auch die BM25- Volltextsuche. Es ist möglich, den Gewichtungen beider Methoden eine bestimmte Bedeutung zu geben sowie die Ergebnisse aus mehreren Quellen miteinander zu verbinden. Vektoren eignen sich für sinngleiche Ausdrücke, während BM25 besser geeignet ist für Nummern, Personennamen, Produktmodelle und präzise Begriffe.
Das Umordnungsmodell bewertet erneut die Relevanz des Kandidatensegments zum Problem.
Standardmäßig kann Elasticsearch zur Speicherung von Volltexten und Vektoren verwendet werden; es ist auch möglich, auf den open-source-basierten Dokumentenmotor Infinity von InfiniFlow umzustellen. Der Wechsel des Dokumentenmotors erfordert die Neuerrichtung der Daten – manchmal sogar das Löschen der vorhandenen Daten. Migrationsbefehle können in einer Produktumgebung ohne Backup nicht direkt ausgeführt werden.
4. Nachvollziehbare Fragen und Zitate
Der Chat-Assistent zeigt die Dokumentabschnitte und Zitate an, auf denen die Antwort beruht, sodass der Benutzer schnell zum Originaltext zurückkehren kann, um diesen zu überprüfen. Auf der Suchtestseite können die gefundenen Ergebnisse, die Ähnlichkeit sowie die Sortierung getrennt betrachtet werden, um zu unterscheiden, ob „keine richtigen Informationen gefunden wurden“ oder ob „das Modell zwar Informationen gelesen hat, aber die Antwort falsch war“.
Eine Zitierung beweist lediglich, dass das System einen bestimmten Abschnitt verwendet hat; sie garantiert jedoch nicht, dass die Schlussfolgerungen vollständig oder korrekt sind. Rechtliche, medizinische, finanzielle sowie Berichtstexte müssen weiterhin von Hand gelesen werden, um Daten, Versionen, Einheiten in Tabellen sowie Ausnahmeregeln zu überprüfen.
5. RAPTOR,PageIndex und Wissensgraphen
RAPTOR führt eine hierarchische Clustering- und Zusammenfassung von Dokumenten oder Datensätzen durch, sodass das System sowohl auf Details zugreifen als auch übergeordnete Themen zwischen den Abschnitten identifizieren kann. Die neue Version bietet die Modi GMM und AHC; AHC erweitert die semantische Organisation auf den gesamten Datensatz.
PageIndex nutzt Verzeichnis- und Hierarchieinformationen, um den Inhalt langatmiger Dokumente zu lokalisieren.
Die Analyse von Wissensgraphen ermöglicht es, Entitäten und Beziehungen zu extrahieren, um für mehrstufige Probleme strukturierte Verbindungen bereitzustellen. Diese fortgeschrittenen Indizes erhöhen die Analysezeit, die Aufrufe des Modells sowie den Speicherbedarf und können zu fehlerhaften Zusammenfassungen oder falschen Entitäten führen. Sie sollten erst nach Überprüfung der Vorteile anhand von Evaluierungsdaten aktiviert werden.
6. Verbindung zu Datenquellen und Synchronisierung
Neben dem lokalen Hochladen kann RAGFlow mit Datenquellen wie S3, Google Drive, Notion, Confluence, Discord, GitHub, GitLab, Bitbucket, Gmail, IMAP, Zendesk, RSS, Seafile, Airtable, Asana, Moodle, DingTalk AI-Tabellen sowie allgemeinen REST-APIs verbunden werden.
Einige Anschlüsse unterstützen inkrementelle Synchronisierung und Synchronisierung bei entfernten Löschvorgängen.
Der Datenquellen-Connector benötigt einen Zugriffstoken oder ein Servicekonto. Es sollten nur Leseberechtigungen mit minimalem Umfang verwendet werden, die Synchronisierungsverzeichnisse eingeschränkt werden und die Löschregeln überprüft werden.
Nach der Aktualisierung des entfernten Dokuments kann eine erneute Analyse die Chunk-IDs und Referenzen ändern; Produktanwendungen müssen Indexfenster sowie Regressionstests einplanen.
7. KI-Agenten und visuelle Orchestrierung
Das Agent-Canvas kann Wissensdatenbanken, Modelle, Tools, Codeausführung, Browser, Dokumentenerstellung, Suchfunktionen sowie weitere Agenten zu Workflows zusammenführen. Offiziell werden Vorlagen für Szenarien wie Datenanalyse, Unternehmensanalysen, Rechtsfallanalysen sowie Wartungsarbeiten in der Fertigung bereitgestellt. Zudem wird die Zusammenarbeit mehrerer Agenten, die eigenständige Planung sowie eine langfristige Speicherung von Informationen auf Benutzerebene unterstützt.
Browserkomponenten ermöglichen es der KI, Webseiten zu navigieren und zu verarbeiten; Python- und JavaScript-Executor können Diagramme erstellen und Dateien verarbeiten.
Solche Funktionen müssen in einer Sandbox untergebracht werden, um das Netzwerk, die Dateien sowie die Ausführungsdauer einzuschränken.
Wenn das Modell selbstständig Webseiten oder Code verarbeitet, sollte bei wichtigen Schritten wie Anmeldung, Zahlung, Versand und Löschung eine manuelle Bestätigung erforderlich sein.
8. MCP und Tools
RAGFlow kann in Workflows MCP-Dienste nutzen und auch eigene MCP-Server starten, um Funktionen wie das Abrufen von Datensätzen oder das Chatten für Clienten bereitzustellen, die MCP unterstützen. Die neue Version bietet außerdem leichte Python-Tool-Decorator, die Entwicklern dabei helfen, Funktionen zu registrieren.
MCP befindet sich in einer Phase schnellen Wandels; Felder, Authentifizierungsmechanismen sowie die von den Tools zurückgegebenen Daten können zwischen den Versionen variieren. Vor der Einbindung in den Produktionsagent sollte eine bestimmte Version festgelegt werden, Fehlerbehandlungen getestet sowie nur minimale Berechtigungen gewährt werden. Dritte MCP-Tools sollten nicht als bereits durch offizielle Sicherheitsaudits geprüft angesehen werden.
9. REST API und SDK
Entwickler können mithilfe der REST-API und des offiziellen Python-SDK Datensätze, Dokumente, Chunks, Chat-Assistenten, Sessions, Agenten sowie Suchfunktionen verwalten. Die Chat-Interface ist mit den gängigen Streaming-Aufrufmethoden kompatibel, wodurch RAGFlow leicht in Websites, Kundenservice-Systeme, interne Systeme und automatisierte Aufgaben integriert werden kann.
API-Schlüssel sollten nur auf der Serverseite gespeichert werden, um Ressourcen nach Tenant zu isolieren, die Anfruffrequenz zu begrenzen und Audits durchzuführen. Die kostenlose Version der offiziellen Cloud bietet keine API-Schlüssel; nur die Versionen Starter und Pro verfügen über diese Funktion.
10. Mehrfach-Modellunterstützung
Die Plattform kann mehrere Sprachmodell-Anbieter, Embedding-, Reranking-, Sprach-, Visualisierungs- und Bildgenerierungs-Dienste konfigurieren sowie lokale Modellservices verbinden. Ab Version 0.22 sind Embedding-Modelle nicht mehr im eigenen Image enthalten; es ist daher notwendig, externe oder lokale Modellendpunkte zu konfigurieren.
Die Kosten für die Cloud-Modelle werden getrennt von den Kosten für das RAGFlow-Software berechnet. Wenn ein Vektormodell ausgetauscht wird, muss der Index neu erstellt werden.
Für lokale große Modelle und OCR-Beschleunigung sind zusätzliche GPU-Ressourcen erforderlich.
11. Mehrkanalige Veröffentlichung
Chats, Agenten und Suchseiten können auf Drittanbieter-Websites eingebettet werden. Die neuen eingebetteten Seiten sind für Mobilgeräte geeignet und unterstützen Chat-Plattformen wie Feishu, Discord, Telegram und Line. Vor der Veröffentlichung sollten Identitäten, Sitzungsisolation, Quoten, Inhaltssicherheit sowie Rechte zur Herunterladung von Referenzen konfiguriert werden.
Preise für Cloud-Dienste
Der offizielle Cloud-Dienst von RAGFlow bietet derzeit drei Monatsbeitragsoptionen in US-Dollar an. Auf der Seite wird außerdem der ursprüngliche Preis angezeigt; hier werden die aktuellen Rabattpreise verwendet:
| Paket oder Version | Preise, Limits und Kernvorteile |
|---|---|
| Free | 0 Dollar/Monat, 5 Apps, 1 Teammitglied, 0,1 GB Speicherplatz für Datensätze, 500 Credits pro Monat – keine API-Keys bereitgestellt. |
| Starter | 29 US-Dollar pro Monat, 50 Apps, 5 Mitglieder, 5 GB Speicherplatz für Daten, 5000 Credits pro Monat, API-Schlüssel inklusive; der ursprüngliche Preis betrug 59 US-Dollar pro Monat. |
| Pro | 129 US-Dollar pro Monat, unbegrenzte Anzahl an Apps, 20 Mitglieder, 50 GB Speicherplatz für Daten, 20.000 Credits pro Monat sowie eine API-Key. Der ursprüngliche Preis betrug 259 US-Dollar pro Monat. |
Der genaue Verbrauch von Credits hängt vom Modell, der Analyse sowie den Ausführungsaufgaben ab. Die Preise für Pakete, Angebote sowie Ressourcenbeschränkungen können sich ändern – es sollten daher die Angaben auf der Rechnelseite herangezogen werden. Für höhere Kapazitäten bei großen Unternehmen, Unterstützung bei der privaten Implementierung sowie SLAs ist es notwendig, sich direkt an den Anbieter zu wenden.
Selbstverwaltung und Hardwareanforderungen
RAGFlow kann über Docker Compose privat bereitgestellt werden. Die offiziellen Mindestanforderungen sind 4 Kerne CPU, 16 GB RAM, 50 GB Speicherplatz, Docker 24.0 oder neuer sowie Docker Compose 2.26.1 oder neuer. Für die Entwicklung der Quellcodeversionen ist Python 3.13 oder neuer erforderlich.
Für die Ausführung im Code-Sandbox ist auch gVisor erforderlich.
Die offiziellen vorkompilierten Images sind derzeit für die x86-Plattform erhältlich; Images für ARM64 werden nicht direkt bereitgestellt, weshalb ARM64-Nutzer sie selbst erstellen müssen. Ab Version 0.22 werden nur kompakte Images im Umfang von etwa 2 GB veröffentlicht, die keine Embedding-Modelle enthalten.
Nach dem Ausführen der Image-Entpackung beträgt die Größe etwa 7 GB; Dokumente, Indizes, Protokolle und Datenbanken führen zu einer weiteren Erhöhung der Festplattennutzung.
Die Standard-Abhängigkeiten umfassen in der Regel MySQL, MinIO, Redis sowie Elasticsearch oder Infinity. Für Elasticsearch ist eine virtuelle Speichermenge des Hosts von mindestens 262144 erforderlich.
In der Produktionsumgebung sind außerdem HTTPS, persistente Volumes, Datenbank- und Objektspeicher-Backups, Überwachung, Schlüsselwechsel sowie Rollback-Möglichkeiten für Updates erforderlich.
GitHub und Open-Source-Lizenzen
Der Quellcode von RAGFlow wird im offiziellen GitHub-Repositorium von InfiniFlow gehostet und unter der Apache License 2.0 lizenziert, was die Nutzung, Änderung, Verbreitung und kommerzielle Nutzung unter den Bedingungen der Lizenz sowie des NOTICE-Dokuments erlaubt. Das offizielle Python SDK folgt ebenfalls der Apache 2.0-Lizenz.
Stand dieser Überprüfung werden in den offiziellen Dokumenten sowie in der Standard-Docker-Konfiguration die stabile Version 0.26.4 verwendet. Das Projekt befindet sich noch in der 0.x-Phase und wird häufig aktualisiert; daher können sich die API, die Datenbanken sowie die Anbindungen ändern.
Bei der Bereitstellung sollten Image und Code auf derselben Version festgelegt werden, und man sollte die Upgrade-Skripte sowie die Veröffentlichungsanleitungen lesen.
Daten Sicherheit und Betrieb
Eine private Implementierung ermöglicht es, Dateien, Indizes und Sessions in der eigenen Umgebung zu speichern. Wenn jedoch externe LLMs, Embeddings, Reranking-Verfahren, OCR-Tools oder Suchdienste verwendet werden, werden die entsprechenden Texte und Abschnitte dennoch an Dritte übermittelt. Für sensible Dokumente sollten die Richtlinien des Anbieters bezüglich der Datenspeicherung, der Trainingsprozesse sowie der geografischen Einschränkungen überprüft werden; falls nötig, sollten ausschließlich lokale Modelle verwendet werden.
Code-Ausführung, Browser, Connector und MCP erweitern das Angriffsprofil. Es sollten Sandboxes, minimale Berechtigungen, eine Netzwerk-Whitelist, Beschränkungen hinsichtlich Dateigröße und -typ, Schutz vor Prompt-Injection, Maskierung von Logs sowie Patch-Management aktiviert werden.
Die Standardpasswörter für Datenbanken und Objektspeicher im Konfigurationsprofil müssen geändert werden.
RAGFlow-Anleitung
Eine grundlegende Aufgabe erledigen
- Registrieren Sie RAGFlow und erstellen Sie einen API-Schlüssel, der ausschließlich für die Testumgebung verwendet wird;
- Wählen Sie das Modell entsprechend der Eingabetypen, des Kontexts, der Qualität, der Geschwindigkeit und des Preises aus;
- Zuerst wird die tiefe Dokumentverständnis-Funktion aufgerufen, um die minimale Anfrage abzuschließen und die zurückgegebene Struktur zu überprüfen;
- Testen Sie anschließend die fließende Ausgabe, Parameter sowie die Reaktion auf Fehler mithilfe von vordefinierten Testblöcken;
- Protokollieren Sie Tokens, Anrufanzahl, Verzögerung, Fehlerrate und Kosten pro Aufruf;
- Tragen Sie den Schlüssel in den Server-basierten Schlüsselmanager ein, bevor Sie die eigentliche Anwendung anschließen;
Erstellung wiederverwendbarer professioneller Workflows
- Für die Entwicklungs-, Test- und Produktionsumgebungen werden unterschiedliche Schlüssel und Limits verwendet;
- Auf der Grundlage eines tiefen Verständnisses von Dokumenten, durch Template-basierte Aufteilung in Blöcke sowie Vektoren, werden mit BM25 und gemischten Suchverfahren repräsentative Bewertungssätze erstellt.
- Einstellen von Timeout, Konkurrenz, Wiederholungsversuchen, Limitierung sowie Budgetobergrenzen;
- Durchführung von Überprüfungen hinsichtlich Fakten, Sicherheit, Formatierung und sensibler Informationen am Ausgangsinhalt;
- Überwachung von Änderungen bei Modellversionen, Preisen, Verzögerungen und Ausfallraten;
- Vorbereitung von Plänen für die Herabstufung des Modells, Schutzmaßnahmen sowie manuelle Übernahme.
Für welche Nutzer geeignet?
- Unternehmen, die Finanzberichte, wissenschaftliche Arbeiten, Verträge, Handbücher sowie gescannte Dokumente analysieren müssen;
- RAG-Projekte, die der Struktur von Tabellen, Bildern und Dokumenten große Bedeutung beimessen;
- Es werden Entwicklerteams für gemischte Suchverfahren, Umordnung, RAPTOR und Wissensgraphen benötigt;
- Organisationen, die eine Verbindung zu zahlreichen Cloud-Speichern, Kooperationsplattformen und Geschäftsdatenquellen herstellen möchten;
- Entwickler, die Workflows für Agenten, Code, einen Browser sowie MCP-Tools benötigen;
- Teams, die den Suchkontext über API oder SDK in bestehende Produkte integrieren möchten.
Vorteile des Produkts
- Die Analyse und Visualisierung komplexer Dokumente in Blöcken ist eine zentrale Besonderheit;
- Vektoren, BM25, mehrfache Rückholung sowie Umordnung – alles ist vollständig integriert.
- Zitate sind nachvollziehbar, was die Lokalisierung und manuelle Korrektur von Wissensfragmenten erleichtert;
- Unterstützung für fortgeschrittene Indizes wie RAPTOR, PageIndex und Wissensgraphen;
- Datensource-Connector, Agenten, MCP, API und SDK bieten umfassende Abdeckung;
- Die Apache 2.0-Lizenz ist für kommerzielle Integrationen freundlich.
- Gleichzeitig werden offizielle Cloud-Dienste sowie vollständige Lösungen für eine private Implementierung angeboten.
Einschränkungen und Hinweise
- Die RAGFlow-Komponenten sind zahlreich, verbrauchen viele Ressourcen und weisen im Allgemeinen eine höhere Wartungskomplexität auf als leichte Wissensdatenbanken.
- Die offiziell empfohlene Mindestmenge an RAM von 16 GB reicht nur für den Einstieg aus. Für große Mengen an Dokumenten, hohe Konkurrenzbelastung, OCR-Funktionen sowie lokale Modelle sind höhere Anforderungen sowie eine sorgfältige Clusterplanung notwendig.
- Eine detaillierte Analyse garantiert auch nicht, dass alle Dateien korrekt sind;
- Nach dem Hochladen müssen Texte, Tabellen, Bilder, Chunks und Zitate stichprobenartig überprüft werden;
- Hochrangige Indizes erhöhen die Kosten und die Wartezeiten;
- Die Updates der Version 0.x erfolgen schnell, in der Produktionsumgebung sollten daher keine nightly-Images verwendet werden;
Häufige Fragen
Ist RAGFlow kostenlos?
Die selbst gehostete Open-Source-Version ist kostenlos, die Kosten für Server und Modelle müssen jedoch selbst getragen werden; bei den offiziellen Cloud-Diensten gibt es eine kostenlose Version, Starter kostet 29 Dollar pro Monat und Pro 129 Dollar pro Monat.
Unterstützt RAGFlow Chinesisch?
Unterstützung für die chinesische Benutzeroberfläche, Dokumentanalyse, Suchfunktionen sowie verschiedene chinesische Modelle. Die Qualität der tatsächlichen OCR-Verarbeitung, der Worttrennung und der Antworten hängt von der Konfiguration des Analysewerkzeugs, der Embeddings, der Reranking-Methoden sowie des LLM ab.
Welche Server sind mindestens erforderlich?
Die offiziellen Mindestanforderungen sind ein CPU mit 4 Kernen, 16 GB RAM sowie 50 GB Speicherplatz. Für die Ausführung des Codes ist gVisor erforderlich. Eine GPU ist zwar nicht zwingend notwendig, kann aber die Leistung von DeepDoc sowie lokalen Modellen beschleunigen.
Wird ARM-Server unterstützt?
Die offiziell bereitgestellten vorkompilierten Docker-Images sind für x86 ausgelegt; Images für ARM64 werden nicht angeboten. ARM-Nutzer müssen die Images selbst gemäß der Dokumentation erstellen, und einige Infinity-Kombinationen werden noch nicht offiziell unterstützt.
Bietet RAGFlow eine API?
Es werden REST-APIs, ein Python-SDK sowie MCP-Server bereitgestellt. Das offizielle Cloud-Free-Paket bietet keine API-Schlüssel, während diese im Starter- und Pro-Paket vorhanden sind.
Kann RAGFlow kommerziell genutzt werden?
Es kann unter der Apache 2.0-Lizenz verwendet, verändert und verbreitet werden, wobei die Lizenz sowie die entsprechenden Angaben beibehalten werden müssen, und zudem sind die Lizenzbedingungen für die verwendeten Modelle, Daten sowie Drittanbieterkomponenten einzuhalten.
Tools, die dem RAGFlow ähneln




 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164