




書生浦語InternLM是什麼?
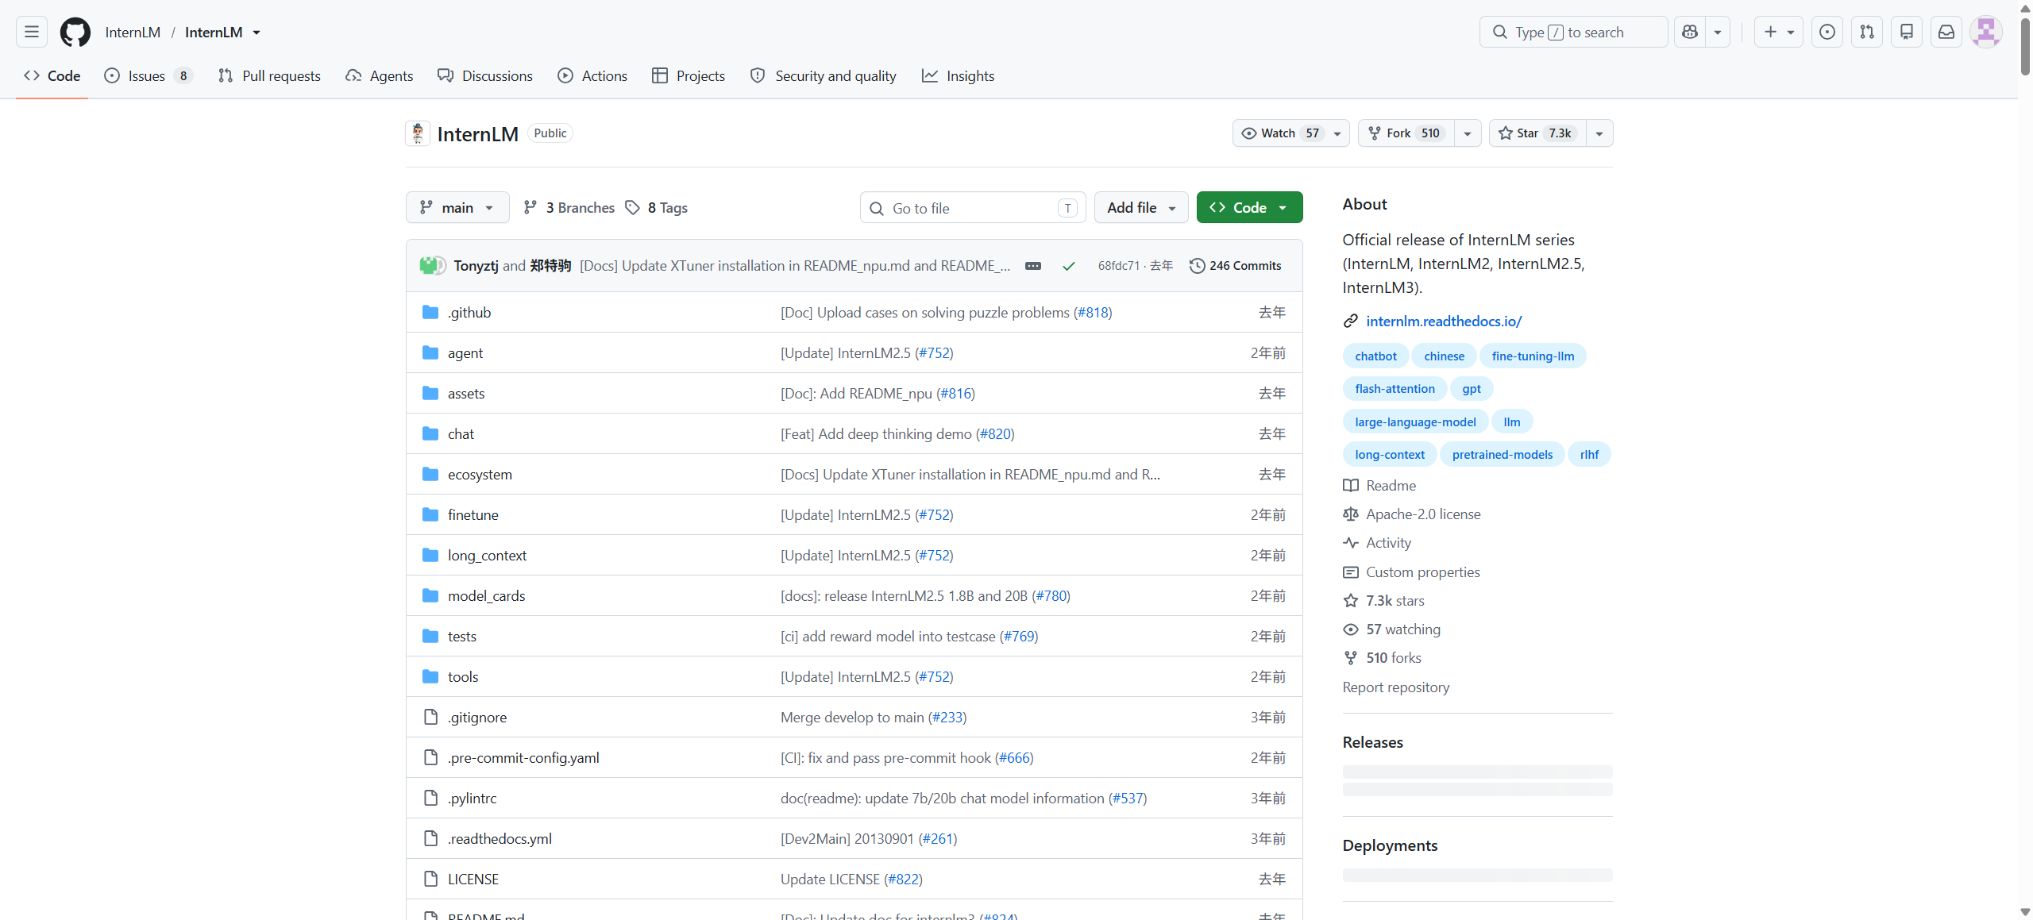
書生·浦語InternLM是上海人工智能實驗室推出的開源大模型與工具體系,面向中文與英文問答、推理、代碼、長文本、多模態理解、科學研究和Agent開發。它不僅提供在線聊天體驗,還開放模型權重、訓練與微調框架、部署引擎、智能體框架和評測工具。
書生浦語的定位更接近「開放模型基座與開發生態」,而非以個人會員訂閱為核心的商業聊天產品。一般用戶可透過官方Chat Web來體驗,而開發者則通常在Hugging Face、ModelScope或OpenXLab上下載模型並自行部署。
主要模型
1. InternLM3
InternLM3是書生浦語第三代通用語言模型,官方開放了InternLM3-8B-Instruct版本。它支援普通對話和深度思考兩種模式,適用於知識、數學、邏輯、程式碼以及複雜指令等任務。
8B規模適合單機GPU部署,官方說明4bit量化約需8GB顯存,但實際還會受到上下文長度、推理框架、KV Cache和併發影響。低顯存部署應先測量峰值佔用,不能只看權重檔案大小。
2. InternLM2.5
InternLM2.5包含1.8B、7B和20B等尺寸,以及Chat、數學、獎勵模型和長上下文版本。其中7B Chat 1M支持百萬級上下文,適合超長文档實驗,但長上下文會顯著增加顯存、預填充時間和注意力成本。
3. Intern-S科學多模態模型
Intern-S系列是為AI在科學領域的應用而設計的。Intern-S1在具備一般文本及視覺處理能力的基礎上,還能處理化學、材料、生命科學和地球科學相關的數據,因而能夠理解分子式、蛋白質序列、化學結構以及各種科學圖像。
Intern-S1-mini提供輕量版本。
2026年的Intern-S1-Pro將擴展至具有數兆個參數的MoE科學推理系統,而Intern-S2 Preview則致力於開發具有較少參數但效率更高的科學模型。這些科學模型可輔助資料搜尋、解釋以及候選方案的產生,但無法取代實驗、同行評審、臨床判斷或專業的安全流程。
4. InternLM-XComposer
XComposer系列用於圖文理解、自由圖文創作以及長時段的視頻音頻互動,能夠處理高解析度的圖像、文件、網頁以及多模態輸入資料。該系列的授權條款與通用InternLM倉庫的授權條款並不完全相同,若要商業使用,必須詳細查閱相關模型的授權規定及申請要求。
線上體驗
官方Chat Web允許用戶直接與模型對話,適合體驗中文問答、推理和代碼能力。在線服務的模型版本、並發、歷史記錄和免費額度可能更新,官網沒有公開固定的個人會員價格表。
因此工具目錄適合標記為“免費在線體驗+開源自部署”,不應虛構月費或承諾永久免費。在線API入口及活動算力也可能需要申請或依託OpenXLab等平台。
XTuner訓練與微調
XTuner是書生生態的開源訓練引擎,可用於大模型預訓練、指令微調、多模態訓練和強化學習。新版XTuner V1面向超大MoE模型,支援長序列、FSDP、DeepSpeed Ulysses以及GPU和昇騰NPU,並可接入LMDeploy、vLLM和SGLang。
個人開發者可利用LoRA或QLoRA來減少微調所需的資源,但微調數據的品質、格式、版權以及隱私問題,比參數設定更重要。在訓練之前,應先劃分驗證集,並記錄基礎模型及相關的版本資訊,如此才能避免只關注訓練損失。
LMDeploy推理部署
LMDeploy用於壓縮、量化、推理以及API服務,支援InternLM、Intern-S以及多種第三方模型。它具有高效能的推理引擎、KV Cache管理功能、量化處理能力,還有相容的介面,適合將模型部署為本地或伺服器服務。
吞吐量取決於GPU、精確度、上下文、批次處理以及並發數量。在實際部署時,還需要實現身份驗證、流量限制、內容安全保障、監控功能、日誌脫敏以及模型回滾等功能,絕不能將示範服務直接暴露在公網上。
Lagent智能體框架
Lagent是一個輕量級的LLM Agent框架,支援工具調用、程式碼解釋器、搜尋、記憶功能,以及單Agent與多Agent的工作流程。開發者可以更換本地的模型或外部API,並透過統一的訊息結構來組合各種工具和代理。
代碼解釋器、網頁存取以及外部工具都可能產生實際的副作用。應該將其執行環境隔離開來,限制其對網路和檔案的存取權限,並且對刪除、付款、發送訊息以及操作資料庫等動作進行人為審核。
OpenCompass評測
OpenCompass是上海人工智能實驗室開源的大模型評測平台,可用於在知識、語言、推理、理解、代碼以及多模態數據集上比較各種模型。InternLM的官方性能表也是透過OpenCompass來進行評測的。
公開基準容易受提示模板、採樣參數、資料汙染和版本影響。模型選型應增加自己的真實文件、語言、延遲、成本、安全與人工評分,而不是只按總榜排名。
其他生態工具
- InternStudio:提供書生浦語課程、算力與實戰教程;
- HuixiangDou:面向群聊和知識庫的領域問答助手;
- MindSearch:用於多步網路搜尋和報告式回答;
- InternEvo:面向大規模預訓練的訓練系統;
- OpenXLab:提供模型、數據和開放算力相關服務。
不同專案維護狀態和適配模型不同,安裝時應使用官方當前文件,並固定依賴版本。
下載與本地部署
InternLM模型通常以Hugging Face Transformers格式提供,亦可從ModelScope和OpenXLab獲取。可使用Transformers、LMDeploy、vLLM等工具來運行它,經過量化處理後,還適用於消費級GPU。
在下載模型之前,應先評估硬碟容量、顯存、記憶體、頻寬以及授權狀況。若啟用 trust_remote_code 功能,就會執行儲存庫中的自訂 Python 代碼,此時應先檢查其來源、提交版本以及檔案內容,並在隔離環境中加以執行。
API與價格
InternLM官方倉庫提供Chat Web與API入口,但官網目前沒有像商業MaaS平台那樣公開統一的按百萬tokens價格表。公開體驗、OpenXLab算力以及合作API的申請、額度與計費可能有所不同。
自部署模型本身沒有按token平台費用,但需要承擔GPU、雲伺服器、電力、儲存、頻寬、運維和併發成本。企業使用前應同時比較自建成本和第三方託管價格。
開源與商業許可
InternLM3主倉庫明確寫明,其代碼與模型權重採用Apache 2.0許可證,允許使用者進行使用、修改、散布及商業應用,但必須保留許可證與版權聲明,並遵守相關法律。
XTuner、Lagent以及多個工具同樣採用Apache 2.0授權。Intern-S1專案目前也標示為Apache 2.0授權。
不同的多模態專案可能會有額外條件,例如XComposer的代碼是使用Apache 2.0授權,但在模型權重的商業使用說明中,仍要求查看相關資料或提交商業申請。
第三方基礎模型、資料集以及相關的許可證,都不會受到 InternLM 專案許可證的約束。商業產品必須逐一檢查其權重、程式碼、訓練資料以及外部組件,而不能僅憑 GitHub 頁面頂端的許可證標籤來判斷。
數據與安全
開源權重可以在本地處理敏感數據,有利於控制數據邊界,但安全責任也轉移給部署者。組織需要修補依賴項目、控制模型介面、記錄訪問記錄、過濾提示注入並防止模型洩露系統資訊。
模型可能輸出偏見、有害內容、錯誤代碼和虛構事實。官方也明確提示機率生成無法完全避免意外輸出,發布者應進行內容審核和人工複核。
書生浦語InternLM使用教學
完成一次基礎任務
- 註冊書生浦語InternLM並創建僅用於測試環境的API Key;
- 根據輸入類型、上下文、品質、速度和價格選擇模型;
- 先調用主要模型完成最小請求並檢查返回結構;
- 再用在線體驗測試流式輸出、參數和異常響應;
- 記錄Tokens、呼叫次數、延遲、錯誤率及單次成本;
- 把密鑰移入服務端密鑰管理器後再接入正式應用;
建立可重複使用的專業工作流
- 為開發、測試與生產環境使用不同密鑰與額度;
- 按主要模型、在線體驗和XTuner訓練與微調建立代表性評測集;
- 設定超時、併發、重試、限流和預算上限;
- 對輸出執行事實、安全、格式和敏感資訊檢查;
- 監控模型版本、價格、延遲和失敗率變化;
- 準備降級模型、熔斷和人工接管方案;
適合哪些用戶?
- 需要中文開源語言模型和本地部署的開發者;
- 學習微調、推理、量化及Agent開發的學生;
- 使用科學多模態模型研究化學、材料與生命科學的團隊;
- 需要百萬上下文及私有文件進行實驗的組織;
- 使用XTuner、LMDeploy和Lagent搭建全鏈路應用的工程團隊;
- 希望獲得Apache 2.0通用模型權重用於商業產品的公司。
限制與注意事項
- 8B模型成本較低,但在複雜事實、代碼倉庫、長程Agent及專業領域中不一定達到大型閉源模型的效果;
- 科學模型的輸出也不是實驗結果或專業認證;
- 百萬上下文並不表示模型會準確記住全部內容,實際性能受位置、檢索和注意力稀釋影響;
- 應結合RAG、分塊、引用和人工審閱,而非一次塞入全部資料;
常見問題
書生浦語免費嗎?
官方提供免費的線上體驗,以及可免費下載的開源模型。自行部署時需自行承擔硬體與運維成本,且線上服務的額度可能會有所調整。
最新通用模型是什麼?
InternLM主倉庫目前的重點是InternLM3-8B-Instruct;在科學多模態領域,則有Intern-S1、S1-Pro和S2 Preview等新版本推出。
可以商用嗎?
InternLM3的代碼與權重採用Apache 2.0授權,可依據該許可證用於商業用途。至於XComposer等其他專案,則必須另行查閱其模型權重及商業使用相關條款。
需要多少顯存?
官方示範稱InternLM3 8B使用4bit約需8GB顯存,實際還要為上下文、緩存和框架預留空間。
提供API嗎?
官方有線上API相關入口及自部署範例,但沒有統一公開固定的token價格。開發者也可使用LMDeploy或vLLM來部署自己所使用的相容API。
書生浦語開源嗎?
是開源模型和工具體系。主模型、訓練、部署、Agent與評測均有官方倉庫,但每個項目和第三方組件仍需分別核對許可證。
類似於書生浦語的工具


 桂公網安備45132202000164號