




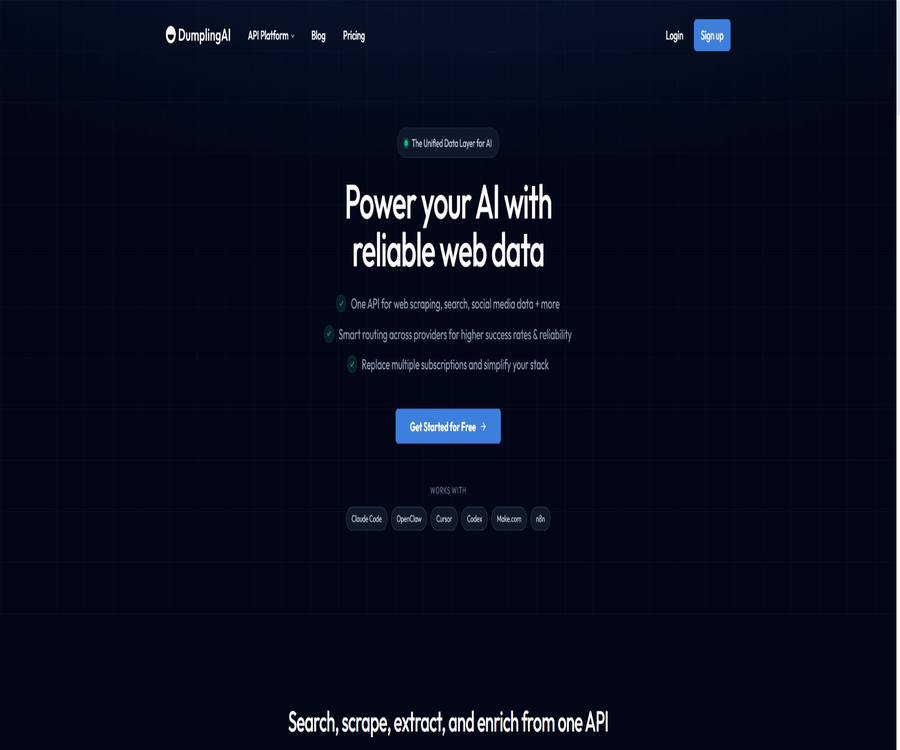
一句話介紹
DumplingAI是一個面向AI Agent、開發者及自動化團隊的統一資料API平台,可透過同一帳戶來調用即時搜尋、網頁抓取、社交資料、文件與媒體提取、圖像生成、知識庫以及雲端程式碼執行等功能。
工具簡介
DumplingAI將原本分散在搜尋、爬蟲、YouTube、TikTok、LinkedIn、PDF以及模型服務中的各項功能,整合到一個統一的積分體系中。使用者可選擇直接使用API、無代碼自動化方式、MCP、CLI,或是內容自動化平台來進行操作。
官網稱該平台擁有50多種數據處理能力,目前公開的目錄中顯示有35個API端點。能力數量與端點數量的定義並不相同,一個端點可能支援多種模型、通道或處理參數。
接入方式
| 方式 | 認證 | 適合場景 | 主要特點 |
|---|---|---|---|
| Unified API v2 | Bearer API金鑰 | 新建數據集成與統一調用 | 按能力或供應商端點運行,官方推薦新專案優先使用 |
| Direct API v1 | Bearer API金鑰 | 相容現有直接端點 | 保留具體請求結構和舊自動化流程 |
| 遠端MCP v2 | OAuth登入 | Claude、Codex、Cursor、ChatGPT等Agent客戶端 | 無需把API密鑰貼到用戶端 |
| 開源MCP伺服器 | DumplingAI API金鑰 | 本地命令或自管MCP進程 | MIT許可,可透過npm或容器運行 |
| CLI | OAuth登入 | 終端探索能力與運行任務 | 適合檢索目錄、查看輸入輸出與快速測試 |
| 無代碼平台 | API密鑰連接憑證 | Make、n8n、Zapier等 | 適合無需自建後端的工作流 |
主要能力
即時搜尋與發現
搜尋功能涵蓋網頁、新聞、地圖、地點、搜尋建議以及 Google 評論。網頁搜尋可依國家、地點、語言和時間範圍進行過濾,並可選擇是否取得前幾個結果。
網頁抓取、爬取與結構化提取
平台可抓取單頁、遞歸爬取站點、截取網頁截圖,並根據用戶給定的指令和結構模式提取字段。動態頁面渲染、自動滾動和等待參數可能會增加成本。
YouTube數據
可獲取影片字幕、影片詳情、頻道資訊、頻道影片、Shorts、評論及搜尋結果。公開數據可用於研究與內容工作流程,但仍需遵守平台條款與內容權利。
TikTok與LinkedIn數據
目錄列出了TikTok用戶、影片、評論、關注關係、字幕以及用戶搜尋內容,同時也提供LinkedIn個人及公司資訊的提取功能。個人資料的使用涉及隱私問題、使用限制以及地區法律規定,因此不應該無差別地大量收集。
文件與PDF處理
API可將文件轉換為文字或PDF格式、合併PDF檔案、讀寫PDF的元資料,並從文件中提取結構化內容。不同的請求會根據次數、頁數或輸出檔案的大小來消耗積分。
圖片、音頻與影片提取
平台可從圖片提取文字或對象,從音頻生成轉錄與分析,並從影片中提取字幕、場景或對象。音頻依時長計算,影片則依秒數計算,因此長型媒體的成本會上升得比較快。
影片裁剪
影片裁剪可依起始與結束時間來產生片段,並可設定輸出品質與幀率。計費是依輸出影片的分鐘數向上取整,進行批次處理前應先計算預算。
AI圖像生成
圖像API支援FLUX.1 schnell、dev、pro、1.1 pro、Kontext pro和Recraft v3等模型,可設定提示詞、比例、數量、品質以及模型專屬參數。每張圖片的成本會因模型而有所不同。
AI Agent與知識庫
平台提供Agent Completion、知識庫搜尋及內容寫入功能,可將外部數據交給模型回答,或作為檢索的上下文。Agent的產生費用是根據輸入與輸出的總令牌數來計算的。
雲端Python與JavaScript執行
開發者工具可在受控的雲端環境中執行 Python 或 JavaScript,並可根據需求指定依賴項目、超時時間以及輸出檔案。外部輸入的內容無法直接被視為可信的程式碼來執行,因此必須限制其依賴項目、執行時間以及資料存取權限。
能力目錄
| 類別 | 代表能力 | 常見用途 |
|---|---|---|
| 網頁與數據 | 抓取、爬取、截圖、AI結構化提取 | RAG採集、監測和資訊結構化 |
| 搜尋與地點 | 網頁、新聞、地圖、地點、建議、評論 | 即時研究、本地商業和趨勢發現 |
| YouTube | 字幕、影片、頻道、Shorts、評論和搜尋 | 內容分析、再利用和頻道研究 |
| TikTok | 用戶、影片、評論、關注和字幕 | 短影片研究與公開數據分析 |
| 個人與公司數據 | 企業研究與資料豐富 | |
| 文件與PDF | 轉文本、轉PDF、合併、元數據和提取 | 文件流水線與知識入庫 |
| 媒體 | 圖片、音頻、影片提取與影片裁剪 | 轉錄、視覺分析與內容剪輯 |
| AI | Agent、知識庫與圖像生成 | 智慧應用與內容生成 |
| 代碼 | Python與JavaScript雲端運行 | 資料轉換與自訂邏輯 |
v1、v2與MCP的差異
| 項目 | v1直接端點 | v2統一平台 | MCP v2 |
|---|---|---|---|
| 定位 | 現有端點目錄 | 新項目推薦的能力優先接口 | 讓AI客戶端直接使用工具 |
| 路徑組織 | 每項功能有直接請求結構 | 統一運行入口與能力標識 | 遠端MCP工具協議 |
| 認證 | API密鑰 | API密鑰 | OAuth |
| 適合用戶 | 已有集成和特定端點 | 開發者與無代碼自動化 | Claude、Codex、Cursor和ChatGPT用戶 |
| 帳號關係 | 與v2共用帳號和API密鑰 | 與v1共用帳號和API密鑰 | 連接到同一DumplingAI服務 |
v1和v2可以同存在於同一個帳戶中,不必立即將所有的舊工作流程都遷移過去。對於新功能以及長期整合的需求,應優先考慮使用v2;而那些已經穩定的端點,則可以在驗證其等價性之後,再逐步進行遷移。
使用教學
用v2 API完成第一次呼叫
- 註冊DumplingAI帳號,在儀表板建立API金鑰並儲存到安全的金鑰管理工具中。
- 打開Workbench,搜尋所需的能力並確認輸入欄位、輸出結構和積分成本。
- 使用統一運行入口,指定能力類型、能力識別碼和輸入參數。
- 在Authorization請求頭中使用Bearer金鑰,不要把金鑰寫進瀏覽器前端。
- 先用最小結果數、短檔案或單頁請求測試返回結構。
- 讀取成功結果中的積分用量,並處理參數錯誤、限流和服務錯誤。
- 上線時加入金鑰輪換、預算上限、退避重試、緩存和日誌脫敏。
連接遠端MCP
- 確認所用AI客戶端支援遠端MCP和OAuth連接。
- 在客戶端添加DumplingAI遠端MCP服務,並發起授權。
- 使用DumplingAI帳號登入,只批准當前工作所需的訪問範圍。
- 連接後查看暴露的搜尋、抓取、文件、媒體和程式碼工具。
- 先執行低成本查詢,確認工具輸出和積分扣除符合預期。
- 為網頁抓取、個人資料和代碼執行設定人工確認與調用邊界。
- 不再使用時從帳號中撤銷OAuth連接。
在無代碼平台中創建數據工作流
- 在DumplingAI創建專用於該工作流的API密鑰。
- 在 Make、n8n、Zapier 或其他平台中將金鑰儲存為連線憑證。
- 選擇搜尋、抓取、社交數據或文件處理作為工作流程步驟。
- 用樣例輸入檢查欄位對應、分頁、空結果和錯誤分支。
- 在將結果寫入表格、資料庫或內容系統之前,先執行去重與格式校驗。
- 設定每次運行的頁數、檔案長度和最大積分預算。
- 監控執行歷史,避免定時任務因循環或重複觸發快速耗盡積分。
搜尋與抓取流程
搜尋請求可返回自然結果、精選摘要、相關問題與相關搜尋,也可選擇抓取排名靠前的頁面。抓取結果數量最多10個,若未指定通常預設抓取3個。
- 搜尋基礎成本按結果頁計算,繼續抓取頁面會額外扣除抓取積分。
- 國家、地點、語言和日期範圍應與研究目標一致。
- 抓取輸出可選擇Markdown、HTML或截圖,並設定是否清理。
- 動態渲染和等待時間會增加運行時間,截圖也可能增加積分。
- 結果排名和頁面內容會變化,關鍵事實應保存時間並交叉核驗。
- 目標站點的訪問條款、robots規則以及個人資料限制仍適用。
文件與媒體處理
| 能力 | 基礎積分 | 附加計費 |
|---|---|---|
| 文件轉文本 | 20/次 | 以當前端點參數為準 |
| 轉換為PDF | 50/每100MB輸出 | 按輸出PDF大小 |
| 合併PDF | 50/每100MB輸出 | 按輸出PDF大小 |
| 讀取PDF元資料 | 10/次 | 無公開附加項 |
| 寫入PDF元數據 | 50/每100MB輸出 | 按輸出PDF大小 |
| 提取文件 | 100/次 | 每處理一頁另加10 |
| 提取圖片 | 100/次 | 每張圖片另加10 |
| 提取音頻 | 100/次 | 每分鐘另加20,向上取整 |
| 提取影片 | 100/次 | 每秒影片另加10 |
| 裁剪影片 | 每輸出分鐘200 | 按分鐘向上取整 |
長影片的提取是按秒計費的,其成本可能遠高於字幕或搜尋功能的成本。對於批量處理的任務,應先取得短樣本來估算所需成本,再決定影片的長度、檔案數量以及失敗後的重試次數上限。
常用數據端點積分
| 功能 | 當前積分成本 | 說明 |
|---|---|---|
| 網頁抓取 | 10/次 | 動態參數可能影響實際處理 |
| 網站爬取 | 每個頁面10 | 隨返回頁數增加 |
| 網頁截圖 | 20/次 | 自動滾動或非零等待分別加10 |
| AI結構化提取 | 250/次 | 按結構指令處理網頁 |
| YouTube影片或頻道數據 | 10/次 | 不同端點分別計費 |
| YouTube字幕 | 20/次 | 按當前文件計價 |
| TikTok與LinkedIn常用端點 | 10/次 | 以具體端點說明為準 |
| 網頁搜尋 | 每頁30 | 抓取結果另行扣費 |
| 地圖搜尋 | 每頁100 | 地點和普通搜尋價格不同 |
| 地點或新聞搜尋 | 每頁30 | 翻頁繼續扣費 |
| Google評論 | 每10條50 | 不足或超過按10條向上取整 |
| 運行Python或JavaScript | 50/次 | 外部依賴和資源仍受限制 |
AI能力積分
| AI能力 | 積分成本 | 關鍵說明 |
|---|---|---|
| Agent Completion | 每1000總令牌10 | 輸入與輸出合計 |
| FLUX.1 schnell | 每張30 | 快速圖像生成 |
| FLUX.1 dev | 每張150 | 支援較豐富參數 |
| FLUX.1 pro | 每張300 | 高階模型 |
| FLUX.1.1 pro | 每張500 | 當前列表中成本較高 |
| FLUX.1 Kontext pro | 每張200 | 支援參考圖編輯 |
| Recraft v3 | 每張200 | 支援多種尺寸與風格 |
| Perplexity搜尋工具 | 每1000令牌50 | 作為Agent工具使用 |
價格與套餐
截至2026年8月22日,官網公開了三種按年結算的套餐。頁面上顯示的是年付後的月均價格,全年的使用額度也會一次性列明,最終的稅費及結算金額則以購買頁面所示為準。
| 套餐 | 月均顯示 | 年度支付參考 | 年度積分 | 請求速率 | 支持 |
|---|---|---|---|---|---|
| Starter | 40美元/月 | 480美元/年 | 120萬 | 30次/分鐘 | 基礎支援 |
| Pro | 124美元/月 | 1488美元/年 | 420萬 | 60次/分鐘 | 標準支援 |
| Business | 249美元/月 | 2988美元/年 | 960萬 | 120次/分鐘 | 優先支援 |
積分規則
- 一個餘額可用於平台的50多種數據與AI能力。
- 不同動作和參數每次消耗一個到多個積分,不能只按請求次數估算。
- 訂閱計劃積分不會結轉到下個週期。
- 單獨購買的積分包不會過期,並在訂閱積分用完後使用。
- 失敗請求不扣積分,只有成功請求收費。
- 可以啟用Auto Recharge,在餘額低於閾值時自動購買積分包。
- 持續高於公開套餐的用量可以聯繫官方商談大額方案。
積分口徑變更
官方在2025年11月19日調整了積分面額,新積分相當於舊積分的十分之一成本口徑。對賬舊記錄時需把歷史數值乘以10後再與現行表格比較,不能直接引用舊部落格中的積分數量。
MCP與CLI
| 項目 | 遠端MCP v2 | 官方開源MCP伺服器 | CLI |
|---|---|---|---|
| 運行位置 | DumplingAI託管 | 用戶本地或自管環境 | 本地終端 |
| 認證 | OAuth | 環境變數中的API金鑰 | OAuth |
| 安裝 | 客戶端添加遠端服務 | npm、Smithery或容器 | npx運行 |
| 主要用途 | AI用戶端直接調用能力 | 傳統本地MCP集成 | 搜尋目錄、查看詳情和運行能力 |
| 源碼 | 託管服務未開源 | MIT許可倉庫 | 完整源碼狀態需按專案確認 |
API認證與工程實踐
- API密鑰只放在服務端密鑰管理中,不提交到Git、日誌或前端代碼。
- 按開發、測試和生產環境分開密鑰,並設定輪換和撤銷流程。
- 讀取速率限制回應欄位,使用指數退避而非無上限重試。
- 為分頁、媒體時長和爬取頁數設定硬上限。
- 成功回應也應校驗結構、渠道、空值和積分用量。
- 對搜尋與抓取結果使用緩存,避免重複請求和資料來源壓力。
- 遠端MCP不再使用時撤銷OAuth授權,本地MCP則及時輪換API密鑰。
適合哪些用戶
- AI Agent開發者:需要搜尋、網頁、社交、文件和代碼等統一工具。
- 自動化工程師:在Make、n8n或Zapier中組合多種資料處理步驟。
- 內容團隊:提取影片字幕、評論和文件內容並進入發布流程。
- 研究與監測團隊:獲取即時網頁、新聞、地點及公開社交數據。
- SaaS開發者:透過統一的API來降低維護多個資料供應商連線的成本。
- MCP用戶:讓Claude、Codex、Cursor或ChatGPT直接調用外部數據能力。
典型使用場景
- 讓研究Agent先搜尋新聞,再抓取頁面並輸出結構化摘要。
- 定期獲取YouTube字幕和評論,形成選題與用戶反饋資料庫。
- 從PDF、圖片、音頻和影片中提取內容並寫入知識庫。
- 抓取網站產品資訊並按固定結構輸出到表格或CRM。
- 根據公開企業頁面豐富公司記錄,但對個人數據設定合規邊界。
- 在雲端運行短Python或JavaScript邏輯清洗API結果。
- 透過MCP將搜尋、文件和媒體工具交給AI用戶端按需調用。
隱私與資料處理
隱私政策說明,使用者可以將資料提供給DumplingAI,以協助「訓練」AI,其中部分資料可能會被儲存在系統中,用於改善服務品質。在處理敏感的、屬於客戶或受合約保護的資料之前,應先向官方確認具體的資料範圍、選擇退出的方式以及資料的保存期限。
該平台使用 PostHog 和 Google 來進行網頁及產品分析,Stripe 則負責處理支付業務,而一些任務則可能由 OpenAI、Anthropic、Perplexity、Groq 等模型供應商來處理。根據其政策,不會公開分享使用者資料,但出於法律要求或需要第三方協助時則為例外。
隱私與合規建議
- 不要把API密鑰、密碼、私有倉庫內容及未脫敏的客戶資料交給公開任務。
- 處理個人資料時記錄合法用途、最小字段、保留週期和刪除流程。
- LinkedIn、TikTok、YouTube以及網頁抓取也受到目標平台的規則約束。
- 使用雲端代碼執行時禁止把不可信網頁內容直接拼接為代碼。
- 對媒體檔案和生成資產確認臨時或永久儲存選項。
- 歐洲及其他地區的使用者可申請存取或刪除個人資訊。
- 企業採購前應補充資料處理協議、子處理商和安全控制核驗。
內容、版權與數據許可
- API能夠獲取公開數據並不代表使用者自動擁有複製、再發布或商業銷售權。
- 搜尋結果、社交資料、評論、字幕、圖片和文件各有不同的權利渠道。
- 網站條款中的臨時瀏覽許可不能簡單等同API結果的無限商業許可。
- 抓取受登入、付費或訪問限制的內容可能違反目標服務規則。
- AI圖像仍應檢查品牌、角色、人物肖像和訓練數據相關風險。
- 對外發布的資料集應保存渠道、抓取時間、欄位用途和刪除機制。
API、SDK與開源情況
| 項目 | 核驗結果 | 說明 |
|---|---|---|
| 公開API | 提供 | v1直接端點與v2統一平台並存 |
| 認證 | Bearer API金鑰 | v1與v2共用帳號和密鑰 |
| 遠端MCP | 提供 | v2使用OAuth,不要求貼上API密鑰 |
| 官方CLI | 提供 | 透過npx運行並使用OAuth |
| 官方MCP倉庫 | 開源 | JavaScript實現,MIT許可證 |
| 官方通用SDK | 未發現 | 可直接調用API或使用MCP與CLI |
| 平台本身 | 不開源 | MCP連接器開源並不代表託管數據服務開源 |
產品優勢
- 一個帳號和積分餘額覆蓋搜尋、抓取、社交、文件、媒體、AI和代碼。
- v2統一API減少不同能力之間的認證與調用差異。
- v1與v2並存,方便現有集成逐步遷移。
- 同時支援API、無代碼、遠端MCP、本地MCP和CLI。
- 信用成本文件細化到頁、分鐘、秒、圖片和模型,便於預算。
- 失敗請求不扣積分,額外積分包不過期,可應對短期峰值。
- 官方MCP伺服器使用MIT許可證,可檢查和擴展連接器代碼。
使用限制與注意事項
- 公開套餐全部按年結算,頁面月價只是年付折算。
- 訂閱積分不結轉,低使用月份可能產生餘額浪費。
- 每項能力成本不同,長影片、地圖和結構化提取可能快速消耗積分。
- 服務聚合多個外部供應商,穩定性、覆蓋範圍及資料結構可能隨渠道變化。
- 社交與個人資料介面存在隱私、平台規則和數據準確性風險。
- 隱私政策允許部分訓練或改進用途,敏感數據必須額外確認。
- 開源MCP伺服器只是連接器,實際資料處理仍依賴收費雲端API。
- 沒有發現官方通用語言SDK,開發團隊需自行封裝重試、分頁和類型。
基本資訊
| 項目 | 內容 |
|---|---|
| 工具名稱 | DumplingAI |
| 工具類型 | 統一數據API、自動化與AI Agent工具平台 |
| 能力規模 | 50多種能力,公開目錄展示35個API端點 |
| 主要類別 | 搜尋、抓取、社交、文件、媒體、AI與代碼 |
| API版本 | v1直接端點與v2統一平台 |
| MCP | 遠端OAuth MCP與官方開源本地伺服器 |
| CLI | 提供 |
| 最低公開套餐 | Starter年付折算40美元/月 |
| 積分規則 | 訂閱積分不結轉,積分包不過期,成功請求才收費 |
| 請求速率 | 30、60或120次/分鐘,按套餐區分 |
| 官方SDK | 未發現通用語言SDK |
| 開源狀態 | 平台不開源;官方MCP伺服器為MIT許可證 |
推薦指數
推薦指數:4.5 / 5。DumplingAI的能力覆蓋廣、接入方式完整、成本文件詳細,並透過v2、MCP和CLI適配現代AI Agent工作流。
主要門檻是年付起點、複雜的積分機制以及跨資料來源的合規要求。這種方式適合那些能夠設定預算、管理緩存、處理資料並解決錯誤的開發團隊,但不適合將抓取功能與個人資料介面視為可隨時使用的資料來源。
常見問題
DumplingAI免費嗎?
目前,公開的價格頁面中沒有固定的免費套餐,最低的方案是Starter年付版,折算下來為每月40美元。一旦通過Creator Program的申請,就可以獲得每月最多1萬點的免費積分,但這並非所有使用者都能自動享有此免費服務。
Starter實際一年多少錢?
頁面顯示為每月40美元,按年結算,全年的費用為480美元,其中包含120萬的年度積分。稅金及最終金額請以結算頁面所示為準。
積分會結轉嗎?
訂閱計劃的積分不會結轉,單獨購買的積分包則不會過期。積分包可用於在訂閱積分用盡之後使用。
失敗請求扣積分嗎?
不扣費,官網說明只有成功請求才會收費。開發者仍應限制重試次數,避免錯誤恢復後產生大量成功呼叫。
v1和v2有什麼區別?
v1保留現有的直接端點結構,v2則依功能統一調用,並建議用於新整合。兩者可在同一帳戶中共存,並共享API金鑰。
DumplingAI支援MCP嗎?
支持,遠端MCP v2使用OAuth,也提供需要API密鑰的官方開源MCP伺服器。兩種接入方式不要混淆。
可以在Codex或ChatGPT中使用嗎?
官方文件列出了Codex、ChatGPT、Claude和Cursor等MCP用戶端。是否能夠連線,則取決於用戶端版本、組織權限以及連接器設定。
提供API SDK嗎?
提供完整的 API、CLI 和 MCP,但沒有發現面向多語言的官方通用 SDK。開發者可以依照 v2 文件自行封裝。
DumplingAI是開源的嗎?
託管平台本身並非開源,官方的MCP伺服器則採用MIT許可證。開源連接器仍需調用DumplingAI雲端API,並會消耗帳戶積分。
數據會用於訓練嗎?
隱私政策表示,部分用戶提供的資料可能會被儲存,並用於改進人工智慧系統。對於敏感或屬於客戶的資料,在提交之前應先向相關單位確認有關訓練、使用、保留及刪除的細節。
搜尋和抓取結果能直接商用嗎?
不能一概而論,API訪問能力不會自動轉移目標內容的版權、資料庫權或平台許可。需要按數據來源、地區和用途分別審查。
總結
DumplingAI將外部資料、文件處理、媒體提取、AI功能以及程式碼執行等功能整合為一個適用於各種Agent的統一基礎架構。透過v2、MCP、CLI以及無程式碼連接等方式,不同技術水準的使用者都能輕鬆接入該系統。
正式部署前應先建立每項能力的積分預算、緩存、合規邊界和故障處理。使用短樣本驗證成本與輸出結構,再逐步擴大頁數、媒體時長和自動化頻率。
類似於DumplingAI的工具

 桂公網安備45132202000164號