




一句話介紹
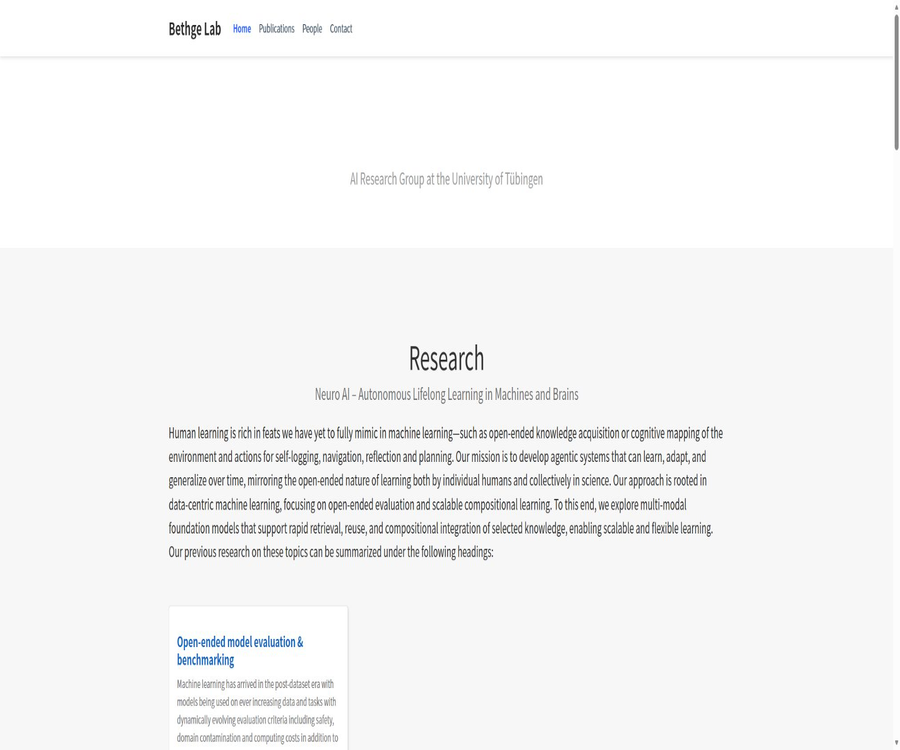
Bethge Lab是圖賓根大學的AI與計算神經科學研究團隊,其官網主要介紹研究方向、團隊成員、論文、資料集以及開源代碼,並不提供線上聊天或內容生成服務。
實驗室簡介
Bethge實驗室由Matthias Bethge領導,其研究領域涵蓋機器學習、計算神經科學、視覺科學以及自主終身學習。該實驗室的目標是了解生物大腦的推理與學習機制,並探索那些能夠持續適應、整合知識且具有泛化能力的機器系統。
馬蒂亞斯·貝特格是圖賓根大學的計算神經科學與機器學習教授,同時也是圖賓根AI中心的負責人。他的實驗室與當地的大學、馬克斯·普朗克研究機構、ELLIS以及其他學術網絡保持合作關係。
它不是普通AI工具
- 沒有面向公眾的提示詞輸入框或通用AI聊天界面。
- 不提供按月訂閱的寫作、搜尋或辦公軟體。
- 官網主要用於了解課題、閱讀論文、查找成員以及申請職位。
- 真正可操作的資源通常位於論文附錄、代碼倉庫和數據集頁面。
- 不同研究項目具有不同依賴、許可證、維護狀態和復現難度。
當前核心研究方向
開放式模型評測與基準
實驗室關注模型進入數據集時代後的評測問題,包括任務不斷變化、安全性、資料汙染、計算成本以及評測的民主化。相關研究試圖將靜態排行榜擴展為可持續、可組合且以樣本為基礎的開放式評估。
語言模型智能體
該方向研究能夠推理、交流和自主執行任務的語言模型智能體。公開課題包括定理證明、科學發現自動化、科學引用檢索,以及對不確定未來事件的資訊聚合。
終身組合與目標中心學習
實驗室認為,持續學習不僅是為了避免災難性的遺忘,更是為了讓過去的經驗成為未來可重複使用的模組。該研究將泛化能力、以目標為中心的表徵方式、多模態預訓練,以及可擴展的終身學習方式結合在一起。
神經表徵與機制可解釋性
研究團隊運用機器學習來分析神經數據,探討生物神經元群體是如何進行推理與學習的。相關工作包括視網膜、視覺皮層的數位孿生模型、神經表徵的比較,以及根據需求進行細化處理的腦區模型。
人類與機器的注意力
該領域的研究內容包括圖像、影片、虛擬現實中的顯著性、掃視路徑以及眼動,並比較人類的注意力機制與機器視覺的機制。其目標之一,就是將更符合人類行為特性的注意力模型應用於視覺及行為研究之中。
AI科學創業
實驗室也注重如何將機器學習的研究成果轉化為具有長期實際價值的解決方案,並與相關的創業企業進行合作。網站上列出的創業及合作內容,並不代表實驗室會向公眾銷售統一的商業產品。
研究方向對照
| 研究方向 | 主要問題 | 典型資源 | 適合讀者 |
|---|---|---|---|
| 開放式評測 | 如何持續評價快速變化的模型 | 評測框架、基準和資料集 | 模型評測與治理研究者 |
| 語言模型智能體 | 如何提高推理、引用和任務協作能力 | 論文、基準和實驗代碼 | NLP與智能體研究者 |
| 終身組合學習 | 如何重複運用知識並減少遺忘 | 持續學習與多模態專案 | 機器學習研究者 |
| 神經表徵 | 神經群體如何計算與學習 | 神經數據模型和分析代碼 | 計算神經科學研究者 |
| 人機注意力 | 人類眼動與機器注意力如何比較 | 顯著性模型、眼動數據和基準 | 視覺與認知科學研究者 |
| 科學創業 | 研究成果如何轉化為可行方案 | 合作項目與衍生企業資訊 | 研究創業者 |
官網可用資源
- 研究概覽:快速了解團隊目前的任務與主要課題。
- 論文目錄:可依年份及出版類型瀏覽論文、預印本與會議文章。
- 專案附件:部分論文提供PDF、代碼、資料集、專案頁面、影片或投影片。
- 成員頁面:查看負責人、博士後、博士生、碩士生、行政人員及校友。
- 申請頁面:瞭解博士後、博士、實習、輪轉及學位論文機會。
- 新聞與合作:查看實驗室活動、學術合作及社會影響計畫。
代表性論文主題
論文目錄涵蓋視覺注意力、神經數據建模、持續學習、組合泛化、多模態模型以及大語言模型評測。目錄中的論文狀態可能包括正式發表、會議論文和預印本,引用時應核對版本。
- 開放式能力的樣本級模型評測。
- 科學主張與文獻引用匹配能力。
- 多模態模型的持續預訓練與合併。
- 視覺語言模型的概念頻率與零樣本表現。
- 目標中心學習與組合泛化。
- 持續測試時適應和分布外泛化。
- 人類視覺注視、顯著性及掃視路徑預測。
- 視網膜與視覺皮層的功能建模。
GitHub開源資源
與實驗室同名,且其主頁指向官方網站的 GitHub 組織,目前擁有數十個公開倉庫,這些倉庫主要用來儲存論文的實作代碼、測試標準、資料處理工具以及實驗相關的程式碼。這些倉庫並非統一的軟體套件,因此在使用之前,必須逐一查看每個倉庫的說明與授權條款。
Foolbox
Foolbox是一個用於構建神經網路對抗樣本的Python工具箱,可與PyTorch、TensorFlow和JAX一起使用。它適用於研究模型的穩定性及進行模型評估,不應被用於對真實系統進行未經授權的攻擊。
imagecorruptions
imagecorruptions提供了用Python為圖像添加各種常見損壞效果的機能,可用於測試模型在面對雜訊、模糊、天氣條件以及數位失真時的穩定性。該程式庫採用Apache 2.0授權協議,但輸入的資料和模型本身可能還需要另行取得授權。
model-vs-human
model-vs-human用於在分佈外數據上比較模型與人工行為。該項目適合研究機器視覺是否依賴與人類不同的線索,目前倉庫沒有在元資料中明確展示標準許可證。
CiteME與ONEBench
CiteME關注語言模型能否找回科學文本所引用的論文,ONEBench則關注開放能力的樣本級基準。兩者可用於評測研究,但數據、代碼及評測結果需依照各自倉庫的說明來解讀。
近年研究倉庫
該組織還公開了終身模型評測、多模態預訓練、強化學習、神經表徵以及語言基準等項目。倉庫的更新時間與論文發表的節奏並不同,因此不能將最近推送的內容直接視為穩定版本。
開源專案對比
| 項目 | 用途 | 主要語言 | 許可證狀態 | 注意事項 |
|---|---|---|---|---|
| Foolbox | 對抗樣本與魯棒性評測 | Python | MIT | 僅用於授權研究與測試 |
| imagecorruptions | 圖像腐蝕與魯棒性測試 | Python | Apache 2.0 | 核對數據和模型授權 |
| model-vs-human | 模型與人類行為比較 | Python | 倉庫元資料未明確 | 使用前閱讀專案檔案 |
| CiteME | 科學引用檢索評測 | Python | 非標準聲明 | 分別檢查數據與代碼條款 |
| ONEBench | 開放能力樣本級評測 | Python | MIT | 結果依賴樣本與評測配置 |
| frequency_determines_performance | 多模態預訓練頻率研究 | Notebook | MIT | 復現可能需要較大數據和算力 |
如何查找合適的論文
- 先從研究概覽確定主題屬於評測、智能體、終身學習、神經表徵還是注意力。
- 進入論文目錄,按年份、會議或論文類型縮小範圍。
- 閱讀標題和摘要,確認任務、數據、方法及評價指標是否匹配需求。
- 檢查論文頁面是否提供代碼、資料集、專案頁或幻燈片。
- 優先引用最終發表版本,並核對作者、會議、年份和數字對象識別符。
- 記錄論文版本、代碼提交和數據版本,保證後續可以重現。
如何使用研究代碼
- 從論文頁面找到對應倉庫,確認倉庫確實由作者或實驗室維護。
- 閱讀說明文件、論文、許可證、依賴版本和已知問題。
- 建立隔離的Python環境,不要直接安裝到生產系統。
- 先運行官方最小示例或測試,再嘗試完整數據和訓練任務。
- 固定代碼提交、隨機種子、資料版本和硬體環境。
- 比較自己的結果與論文指標,並記錄無法重現的差異。
- 發布衍生作品時需依照許可證及學術規範進行引用。
論文重現流程
- 明確要復現的是訓練結果、評測結果、圖表還是定性案例。
- 核對原始數據是否公開、是否需要申請以及是否允許重新分發。
- 記錄軟體環境、驅動、框架、顯卡和隨機種子。
- 先在小型樣本上驗證數據讀取和損失計算。
- 按論文附錄檢查超參數、預處理、資料劃分和評測協議。
- 至少運行多次並報告均值、方差和失敗情況。
- 區分完全復現、近似復現和概念驗證,不要誇大一致性。
申請加入實驗室
官網分別說明了博士後、博士生、實習生、實驗室輪轉以及本科或碩士論文的申請流程。團隊明確表示,由於申請人數眾多,應使用指定的申請表,而非直接將完整的申請資料寄送至一般電子郵箱。
- 閱讀目前的研討方向,選擇與個人經歷最匹配的課題。
- 準備簡歷、研究陳述、代表性專案以及可驗證的代碼或論文。
- 說明希望解決的問題,而不是只表達對AI的泛泛興趣。
- 請依照博士後、博士課程或學生課程所指定的管道來提交。
- 核對申請截止日期、材料要求及推薦信安排。
- 等待正式通知,不要把自動確認當作錄取或面試。
適合哪些用戶
- 機器學習研究人員:尋找持續學習、多模態和模型評測工作。
- 計算神經科學研究人員:查找視覺系統與神經表徵模型。
- 博士與碩士生:尋找論文、數據、重現專案及申請機會。
- 工程師:評估Foolbox、imagecorruptions等研究工具。
- 模型安全團隊:研究對抗魯棒性與開放式評測。
- 視覺與認知科學人員:使用顯著性、眼動和行為比較資源。
- 科學創業者:了解研究成果轉化與實驗室衍生專案。
典型使用場景
- 為持續學習或組合泛化課題建立文獻起點。
- 復現論文並比較新方法與實驗室公開基線。
- 使用對抗樣本工具評估視覺模型的魯棒性。
- 使用圖像腐蝕測試模型在分布變化下的表現。
- 研究語言模型的科學引用和開放能力評測。
- 比較機器視覺預測與人類眼動或行為數據。
- 查找博士後、博士和學生研究機會。
資源優勢
- 將機器學習與計算神經科學置於同一研究框架中。
- 論文目錄的時間跨度長,並提供較完整的作者與出版資訊。
- 不少論文頁面同時提供代碼、數據或專案附件。
- GitHub組織包含成熟工具和近年論文實現。
- 研究方向覆蓋模型評測、智能體、多模態、視覺和神經數據。
- 部分倉庫採用MIT或Apache 2.0等清晰許可證。
- 官網明確展示團隊、合作網絡與申請方式。
使用限制與注意事項
- Bethge Lab是一個研究團隊,而非能直接執行日常任務的SaaS工具。
- 官網內容主要以英文為主,論文需要機器學習或神經科學基礎。
- 部分代碼屬於論文重現材料,未必具備生產級穩定性。
- 不同倉庫的許可證各不相同,有些項目沒有明確的標準許可證。
- 論文代碼可能依賴舊版框架、專用硬體或大規模數據。
- 公開模型和基準可能含數據偏差、污染或評測洩漏問題。
- 對抗樣本專案只能用於授權測試、教學和防禦研究。
- 預印本和會議版本可能與最終發表內容存在差異。
- 倉庫星標、提交頻率和論文引用不能單獨證明方法可靠。
- 申請頁面和人員資訊會變化,應以提交時官網狀態為準。
價格與使用成本
Bethge Lab的官方網站、論文目錄以及公開的GitHub儲存庫並不採用商業訂閱服務。閱讀網頁內容通常是免費的,但論文的完整內容、資料存取權、訓練所需的運算能力,以及第三方雲端服務則可能需要額外的費用。
| 資源 | 公開價格 | 可能成本 | 說明 |
|---|---|---|---|
| 實驗室官網 | 免費訪問 | 網路與時間成本 | 無需購買會員 |
| 論文目錄 | 免費瀏覽 | 部分出版物可能受期刊訪問限制 | 優先查找開放版本 |
| GitHub代碼 | 公開訪問 | 算力、儲存和工程維護 | 遵守各倉庫許可證 |
| 資料集 | 因項目而異 | 申請、下載、儲存和合規成本 | 查看數據使用協議 |
| 申請項目 | 官網未列服務費 | 教育、簽證和生活成本另計 | 錄取規則由具體項目決定 |
平台與訪問方式
| 平台 | 支持情況 | 用途 |
|---|---|---|
| Web官網 | 支持 | 研究概覽、論文、成員和申請資訊 |
| GitHub | 支持 | 代碼、數據說明、問題與版本記錄 |
| Windows | 依項目而定 | 透過瀏覽器或本地研究環境使用 |
| macOS | 依項目而定 | 透過瀏覽器或本地研究環境使用 |
| Linux | 多數研究代碼優先 | 訓練、評測和復現 |
| 移動端 | 瀏覽網頁 | 不等於提供獨立行動應用 |
API、SDK與開源狀態
Bethge Lab沒有統一的商業API、帳戶控制台或通用SDK。其開源功能是以個別的研究儲存庫為單位,使用者需根據相關論文來選擇適合的專案,並遵守該儲存庫及其所包含的資料、模型和依賴項目的許可證規定。
實驗室本身並非一種可以整體安裝的開源產品,但有大量的研究代碼是公開的。因此,將其歸類為「開源」比較恰當,應標示為「部分研究代碼為開源」,而不應簡單地認為所有成果都採用相同的授權條款。
安全與研究倫理
- 對抗樣本和模型攻擊只能用於獲得授權的系統。
- 神經、行為和眼動數據可能涉及人體研究與隱私限制。
- 下載數據前檢查倫理審批、同意範圍和再分發條件。
- 大模型評測應記錄提示詞、模型版本、溫度及數據汙染風險。
- 科研代碼應在隔離環境中運行,並檢查依賴與檔案操作。
- 生成或評測結果不能代替同行評審與獨立複核。
基本資訊
| 字段 | 內容 |
|---|---|
| 名稱 | Bethge Lab |
| 性質 | 大學機器學習與計算神經科學研究團隊 |
| 負責人 | Matthias Bethge |
| 所屬機構 | 圖賓根大學 |
| 主要方向 | 終身學習、模型評測、智能體、神經表徵與視覺注意力 |
| 價格模式 | 官網和公開代碼免費訪問,無商業訂閱 |
| 是否需要註冊 | 瀏覽官網不需要,第三方資源可能需要 |
| 統一API | 沒有 |
| 統一SDK | 沒有 |
| GitHub | 有同名組織和數十個公開倉庫 |
| 開源狀態 | 研究代碼部分開源,許可證因倉庫而異 |
| 主要語言 | 英文 |
推薦指數
綜合推薦指數為4.4分,滿分為5分。對於從事機器學習、計算神經科學以及模型評估研究的學者而言,Bethge Lab提供了具有連續主題脈絡的論文目錄,以及豐富的程式碼資源。
它不適合那些需要一鍵式AI搜尋、寫作或辦公服務的普通用戶。此外,研究人員還必須承擔論文篩選、環境設定、許可證核驗以及重複實驗等相關成本。
常見問題
Bethge Lab是什麼?
它是圖賓根大學的AI與計算神經科學研究團隊,不是商業AI應用。
Bethge Lab可以直接線上使用嗎?
可以瀏覽研究與論文,但沒有統一的線上生成工具。實際操作通常需要進入對應的代碼倉庫並配置研究環境。
訪問官網需要付費嗎?
官網和公開代碼無需訂閱,論文出版物、雲運算力及部分數據可能產生其他費用。
有哪些主要研究方向?
包括開放式模型評測、語言模型智能體、終身組合學習、神經表徵、人機注意力及AI科學創業。
Bethge Lab是開源的嗎?
雖然無法將整個實驗室視為一個開源產品,但其GitHub頁面上公開了大量的研究代碼。
所有倉庫都可以商用嗎?
不可以一概而論,每個倉庫、資料集、模型和依賴都必須分別檢查許可證與使用條款。
Foolbox適合什麼用途?
適合在授權環境中生成對抗樣本並評估神經網路的魯棒性。
是否提供統一API?
沒有,公開資源以獨立論文專案、Python套件、Notebook和資料集為主。
支援中文嗎?
官網及大多數論文以英文為主,部分程式碼可用於多語言研究,但沒有中文介面的承諾。
如何找到論文對應代碼?
在論文目錄或論文詳情頁檢查Code、Dataset和Project等附件,再核對倉庫作者與論文資訊。
可以申請加入實驗室嗎?
可以透過官網提供的博士後、博士及學生計劃通道申請,具體的開放狀態與截止日期會有所變動。
適合初學者嗎?
官網適合了解研究方向,但多數論文和復現專案需要Python、深度學習、統計或神經科學基礎。
類似於Bethge Lab的工具

 桂公網安備45132202000164號