




Arena AI是什麼
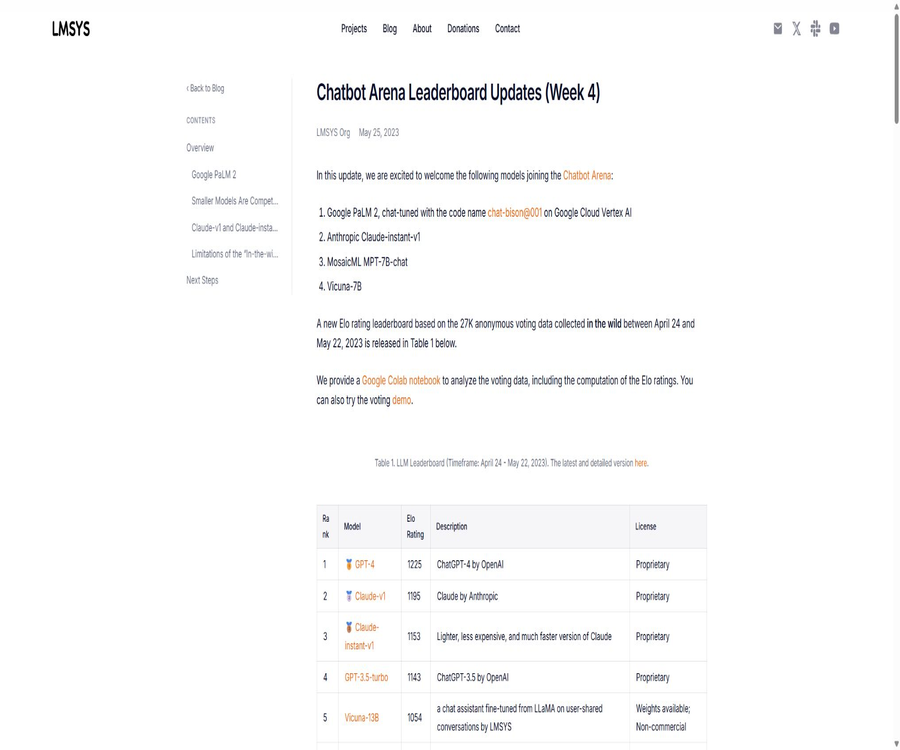
Arena AI是一個透過真實用戶的匿名比較來評估生成式AI模型的平台,其前身為Chatbot Arena和LMArena。用戶輸入相同的提示後,會看到兩個身份隱藏的模型所給出的回答,然後透過投票來選出更好的結果。
該專案最初是由 LMSYS 與加州大學伯克利分校的研究人員所推出,後來發展成為一個獨立的平台。現在,其正式品牌名稱已簡化為 Arena;而舊的 LMSYS 博客頁面僅適用於了解相關歷史資訊,不應再作為主要的使用入口。
Chatbot Arena、LMArena與Arena的關係
| 名稱 | 階段與含義 | 當前使用建議 |
|---|---|---|
| Chatbot Arena | 2023年開始的原始研究項目名稱 | 用於論文、歷史介紹和早期開源代碼 |
| LMArena | 獨立站點和公司階段的品牌名稱 | 仍被大量媒體和用戶使用 |
| Arena | 當前統一品牌 | 官網、排行榜和產品介紹優先使用 |
| LMSYS | 發起早期研究的學術組織 | 不能與當前Arena公司和全部產品完全等同 |
Arena如何工作
- 選擇文本、圖片、影片、代碼或其他適合任務的競技場。
- 輸入一個能夠區分模型能力的真實提示。
- 平台隨機提供兩個匿名模型,並同時生成結果。
- 從準確性、幫助程度、風格和任務完成度比較兩邊輸出。
- 選擇A更好、B更好、平局或兩者都差。
- 提交投票後查看模型真實身份。
- 繼續對話或開啟新一輪,讓偏好數據進入公開評測體系。
核心功能
1. 匿名模型對戰
Battle模式在投票前會隱藏模型名稱,以此減少品牌知名度以及用戶先入為主的影響。不過,回答本身仍可能暴露模型的風格,因此匿名機制只能降低偏見,無法完全消除它。
2. 人類偏好投票
平台並不依賴固定的標準答案,而是讓真實的使用者來判斷哪個結果更有用。它特別適用於評估那些難以用單一分數來衡量的任務,例如寫作、對話、圖片以及開放式創作等。
3. 多賽道排行榜
Arena已從純文字聊天擴展到圖片、影片、代碼、視覺內容以及其他專業領域。不同排行榜的輸入方式、模型庫以及評分標準各不相同,因此無法直接將不同領域的排名進行比較。
4. 直接模式
除匿名對戰外,用戶還可以直接選擇已知模型進行測試。Direct模式適合驗證特定模型,但只有符合匿名評測規則的投票才應影響排行榜。
5. 公開研究與資料集
Arena 發布研究論文、分析結果以及經過處理的人類偏好資料集,用於研究模型評估、對抗攻擊、過度拒絕問題以及搜尋能力。這些公開的資料有其自身的隱私處理與使用許可規定,不能視為完整的原始平台資料。
主要功能一覽
- 讓兩個匿名AI模型回答同一個提示並排比較。
- 支持勝負、平局和兩者都差等投票選擇。
- 投票後揭示模型身份,減少投票前的品牌偏見。
- 提供持續更新的文本、圖像、影片和代碼排行榜。
- 按類別、語言或任務查看更細分的模型表現。
- 直接選擇具體模型進行體驗和結果驗證。
- 測試尚未正式發布或以代號出現的預覽模型。
- 公開部分人類偏好數據、論文和評測方法。
- 把社區回饋匯總後用於幫助模型開發者改進產品。
排行榜分數怎麼理解
Arena會將大量的成對勝負關係彙總為相對能力排名,目前常用的方法是 Bradley-Terry 等成對比較統計模型,並結合重採樣來估計不確定性。使用者通常將這些結果稱為 Elo 分數,但具體的計算方法應以排行榜上的說明為準。
| 指標或概念 | 代表什麼 | 不能說明什麼 |
|---|---|---|
| Arena Score | 模型在當前投票數據中的相對偏好強度 | 不是絕對正確率或通用智力分數 |
| Rank | 在指定榜單與統計規則下的位置 | 不能保證真實業務中一定更好 |
| 置信區間 | 排名與分數的不確定範圍 | 區間重疊時不宜強調細小名次差異 |
| 投票數量 | 可用於估計的對戰樣本規模 | 數量多不等於樣本沒有偏差 |
| 分類榜單 | 模型在特定任務或語言中的相對表現 | 不能替代組織自己的任務測試 |
如何設計有效的對比提示
- 從自己的真實任務中選擇一個具體問題,而不是只問常識。
- 給出必要背景、輸入數據、限制和期望輸出格式。
- 避免包含個人資訊、商業機密和未公開材料。
- 讓兩個模型完成相同任務,不在中途改變評價標準。
- 先獨立檢查事實、推理和指令遵循,再比較表達風格。
- 難以判斷時選擇平局或兩者都差,不必強行分勝負。
- 對關鍵任務重複多個不同樣本,不憑一次對戰選型。
適合哪些用戶
- 希望體驗不同前沿模型的普通AI用戶。
- 需要初步比較模型寫作、推理、代碼和視覺能力的開發者。
- 研究人類偏好評測和模型排序方法的學術人員。
- 追蹤新模型與預覽模型相對表現的業界觀察者。
- 需要為模型選型收集外部參考的產品和技術團隊。
- 希望用真實使用者回饋改進模型的實驗室與廠商。
- 研究排行榜攻擊、偏見和統計可靠性的評測人員。
不同競技場與應用場景
- 文本對話:比較知識、推理、創作和指令遵循。
- 代碼:比較代碼生成、修復、介面實作與工具使用。
- 圖像:比較文字生成圖片、編輯和提示詞遵循。
- 影片:比較文本或圖片生成影片的品質與一致性。
- 視覺理解:比較圖像問答、圖表、OCR和多模態推理。
- 搜尋與研究:比較檢索、引用、時效及綜合回答。
- 特定語言:觀察模型在中文及其他語言中的相對偏好。
免費與帳號要求
Arena 為公眾提供免費的模型對戰及排行榜查詢服務,並未為一般用戶推出付費方案。不同的模型可能存在排隊時間、處理速度、地區限制、登入次數或每日使用次數的限制,平台也可能根據負載情況進行調整。
| 功能 | 價格 | 帳號與限制 |
|---|---|---|
| 查看排行榜 | 免費 | 通常可直接瀏覽 |
| 匿名模型對戰 | 免費 | 可能需要登入並受速率或容量限制 |
| Direct模型體驗 | 免費 | 可用模型和次數可能變化 |
| 研究資料集 | 按對應頁面開放 | 需遵守資料集許可與使用條款 |
| 模型廠商評測合作 | 未公開統一價格 | 由Arena與合作方單獨協調 |
如何正確使用排行榜選模型
- 先選擇與業務最接近的賽道、語言和類別榜單。
- 觀察分數與置信區間,不只看第一名和細小名次差。
- 確認排行榜中的模型版本與實際可採購版本一致。
- 結合成本、延遲、上下文、數據政策及部署方式篩選。
- 建立包含真實業務輸入的內部評測集。
- 對事實、代碼、安全、工具調用和結構化輸出分別測試。
- 上線後持續監控模型更新和業務反饋。
排行榜的優勢
- 使用真實用戶的開放式提示,比靜態考試更接近日常體驗。
- 匿名展示降低了部分品牌偏見和模型聲譽影響。
- 成對比較比要求用戶給絕對分數更容易判斷。
- 模型與投票持續更新,可以快速反映新版本表現。
- 覆蓋文本、圖片、影片、代碼和多模態賽道。
- 公開研究、方法和部分數據,有利於外部複核。
- 允許小型實驗室與大型廠商在相同機制下接受用戶評價。
使用限制與方法偏差
- 投票者與提示詞來自自選用戶,無法代表所有國家、行業和人群。
- 使用者可能偏好更長、更自信或更有風格的回答,而非更準確的答案。
- 匿名模型仍可能透過措辭、格式和拒答風格被識別。
- 排行榜是相對排序,模型池和對戰分佈變化會影響分數。
- 細小名次差可能沒有統計意義,應結合置信區間解讀。
- 預覽模型與公開發布版本可能在提示、採樣或配置上不同。
- 惡意投票、協調攻擊和資料汙染需要持續防護。
- 通用人類偏好不能替代醫療、法律、安全和企业任務評測。
隱私與內容提交
官方說明,用戶提交的意見會被收集起來,用於確保評測的公平性與公開性,且部分回饋可能會被分享給模型開發者。用戶應將 Arena視為一個公共的研究與評測環境,而非用來處理機密資料的私人聊天工具。
- 不要提交姓名、聯絡方式、帳號、密碼和身份資訊。
- 不要貼上公司內部代碼、客戶資料或未公開的文件。
- 圖片和影片只能使用自己擁有或獲授權的素材。
- 敏感行業問題應使用合成或脫敏樣本。
- 投票前檢查回答是否洩露輸入中的敏感內容。
- 使用公開資料集時遵守隱私過濾、許可及再分發規則。
開源專案與資料集
早期的 Chatbot Arena 是以 LMSYS FastChat 為基礎所建構的,FastChat 采用 Apache-2.0 授權協議,並提供多種模型服務、網頁介面以及用於評測的相關程式碼。目前,Arena 平台已發展出更多專用的競賽項目,也具備了商業運作能力,因此無法以早期的版本來完整呈現其現狀。
- FastChat包含模型服務、對話界面和早期Arena實現。
- Arena在Hugging Face等平台發布處理後的人類偏好數據。
- 相關論文介紹匿名成對投票與排序方法。
- 視覺、搜尋、過度拒絕和排行榜攻擊均有專門研究。
- 開源代碼、研究數據和在線平台是三個不同範圍。
- 資料庫原有的StableLM GitHub連結與Arena專案無關,不應作為官方源碼。
為什麼不能只看Arena排名
- 業務成本和延遲不進入通用偏好分數。
- 資料駐留、隱私、合規性以及供應商條款需要分別評估。
- 結構化輸出、工具調用和長時間穩定性可能缺少充分樣本。
- 中文細分行業的提示數量可能低於通用英語任務。
- 模型更新後,排行榜版本與實際API版本可能短暫錯位。
- 高風險任務更需要可重複測試和專家審核。
平台與開源狀態
| 項目 | 當前情況 |
|---|---|
| 當前名稱 | Arena AI,歷史名稱LMArena與Chatbot Arena |
| 產品形式 | 網頁模型對戰、Direct體驗和公開排行榜 |
| 價格 | 公眾功能免費,無普通用戶付費套餐 |
| 開發者API | 未提供面向普通用戶的統一模型推理API |
| 早期開源專案 | LMSYS FastChat,Apache-2.0許可證 |
| 公開數據 | 發布處理後的人類偏好數據集與研究論文 |
| 是否整體開源 | 否,現行完整平台不等於早期FastChat倉庫 |
基本資訊
| 字段 | 內容 |
|---|---|
| 工具名稱 | Arena AI |
| 歷史名稱 | LMArena、Chatbot Arena |
| 起源 | LMSYS與加州大學伯克利研究項目 |
| 工具類型 | AI模型盲測、排行榜與人類偏好看測平台 |
| 核心機制 | 匿名成對對戰與用戶投票 |
| 覆蓋模態 | 文本、圖像、影片、代碼和多模態 |
| 價格模式 | 免費 |
| 是否提供推理API | 否 |
| 是否開源 | 早期FastChat開源;目前平台不整體開源 |
推薦指數
4.7 / 5。Arena AI 是觀察模型真實用戶偏好及體驗前沿模型的重要參考,匿名對戰與公開研究具有獨特價值;但排行榜並不等同於客觀的全能分數,模型選型必須結合內部任務、成本、安全及部署要求。
常見問題
LMArena和Chatbot Arena是同一個平台嗎?
它們屬於同一專案的不同發展階段,目前的品牌名稱為Arena。Chatbot Arena是最初的名稱,而LMArena則是後來獨立出來的品牌。
Arena AI免費嗎?
公眾對戰、Direct體驗和排行榜目前免費,但模型可用性、排隊和使用次數可能根據容量調整。
投票前能看到模型名稱嗎?
Battle模式不會顯示,提交投票後才揭示身份。Direct模式則允許用戶直接選擇已知模型。
排行榜第一名就是最好的模型嗎?
不一定。排名反映特定用戶和提示分配下的相對偏好,實際選擇還要考慮任務準確率、成本、延遲、隱私和部署。
Arena提供模型API嗎?
沒有面向普通開發者提供統一的生产推理API。它主要用於體驗、對戰和評測,不是模型聚合調用平台。
Arena是開源的嗎?
早期FastChat與部分研究數據開放,但目前完整的Arena網站、全部賽道和運營系統不能視為整體開源。
類似於Chatbot Arena Leaderboard的工具


 桂公網安備45132202000164號