




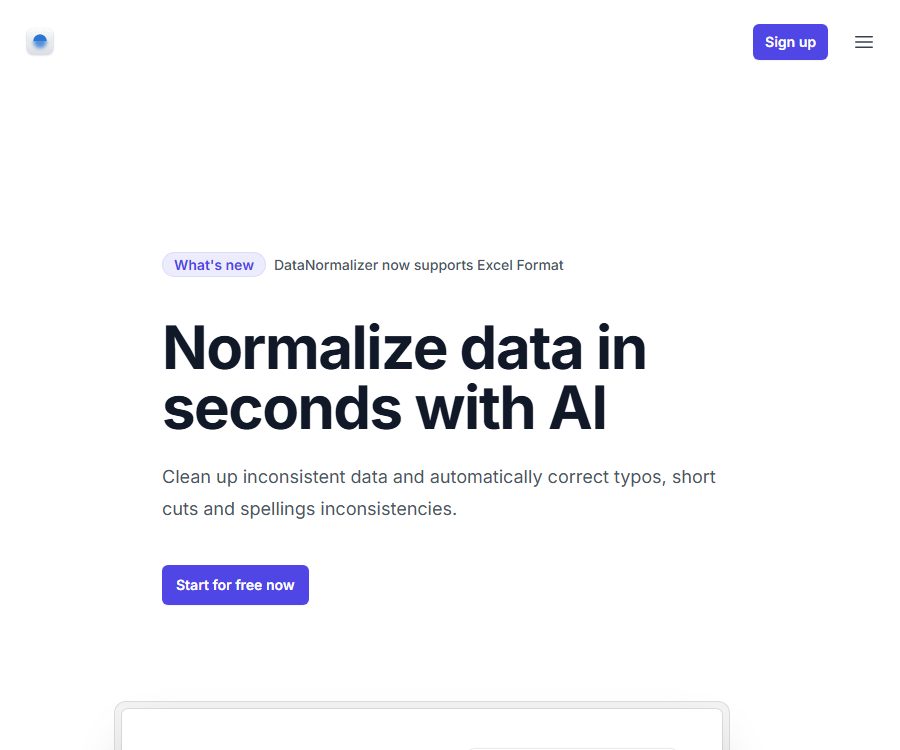
DataNormalizer 是什么
DataNormalizer 是一款网页端 AI 数据清洗工具,用于把表格中含义相同但写法不同的值统一成较一致的形式。
它主要处理人工录入导致的拼写、缩写、大小写、同义词和数字格式差异,不是用于设计数据库第一范式、第二范式或第三范式的建模工具。
主要功能
- 拼写纠错:识别单词中的常见错字,并尝试把错误写法修正为标准拼写。
- 缩写统一:把 Limited 与 Ltd. 等表达归为一致形式,便于分组、去重和统计。
- 大小写规范:处理 Apple 与 APPLE 一类仅大小写不同的值,减少重复类别。
- 同义词归一:识别 Attorney 与 Lawyer 等语义接近的表达,并输出统一名称。
- 格式一致化:处理 Coop 与 Co-op 一类标点或书写方式差异。
- 数字表达统一:识别 1,000、1000 与 1k 等不同数字写法,减少分析时的类型和分组问题。
- CSV 与 Excel:免费层列出 CSV,付费积分包同时支持 CSV 和 Excel 文件。
- 错误免费重跑:付费积分权益包括处理错误时免费重新运行,但错误认定、申请方式和次数上限暂未公开。
适合处理的输入与结果
| 数据问题 | 输入示例 | 预期处理结果 | 适合场景 |
|---|---|---|---|
| 拼写错误 | 手工输入的错别字或字母错误 | 修正为较规范的拼写 | 客户名单、产品分类、供应商表 |
| 缩写差异 | 公司类型、职位或地区的全称与缩写 | 统一为同一种表达 | CRM 去重和分组统计 |
| 大小写差异 | 同一名称的全大写、首字母大写或小写 | 一致的大小写形式 | 品牌、部门和标签字段 |
| 同义词差异 | 含义接近但词形不同的类别 | 归并到同一规范值 | 职业、行业和主题分类 |
| 数字格式差异 | 千位分隔符、简写和普通数字 | 统一数字表达 | 规模、销量和金额字段预处理 |
AI 对“标准值”的选择不一定符合企业内部字典。处理后应保留原文件,并重点抽查品牌名、专业术语、编号和多语言内容。
使用流程
- 先复制原始数据作为备份,删除不需要上传的个人信息、密钥和受监管字段。
- 把待整理数据保存为 CSV;如需 Excel 格式,应确认已购买支持该格式的积分包。
- 创建账户并进入处理器,按页面提示提交待清洗文件。
- 运行标准化任务,等待系统处理拼写、缩写、大小写、同义词和数字格式。
- 取得处理结果后,与原始文件逐列比较,检查是否错误合并了不同实体。
- 在验证通过后再导入 CRM、分析工具或生产数据库,必要时利用错误重跑权益重新处理。
价格与积分
DataNormalizer 以每行一个积分计算付费处理量。官网没有说明积分包有效期、是否自动续费和税费,购买时应以账户结算信息为准。
| 套餐或版本 | 价格 | 计费周期 | 核心权益或额度 | 适合用户 |
|---|---|---|---|---|
| Free | 0 美元 | 免费测试 | 每个文件最多 25 行、低处理优先级、CSV 格式 | 用少量样本验证效果 |
| 1000 积分 | 12 美元 | 积分包,周期暂未公开 | 1000 行;不限单文件行数、最快处理、CSV 与 Excel、错误免费重跑 | 小型名单和一次性任务 |
| 5000 积分 | 29 美元 | 积分包,周期暂未公开 | 5000 行,付费通用权益 | 定期整理小型业务表 |
| 10000 积分 | 49 美元 | 积分包,周期暂未公开 | 10000 行,付费通用权益 | 中等规模表格清洗 |
| 25000 积分 | 99 美元 | 积分包,周期暂未公开 | 25000 行,付费通用权益 | 较大的 CRM 或目录数据 |
| 100000 积分 | 249 美元 | 积分包,周期暂未公开 | 100000 行,付费通用权益 | 高频批量处理团队 |
| 1000000 积分 | 990 美元 | 积分包,周期暂未公开 | 1000000 行,付费通用权益 | 大规模企业清洗项目 |
| Enterprise | 联系销售 | 定制报价 | 具体容量、协作、安全和支持内容暂未公开 | 需要合同与大量处理的企业 |
| 学生折扣 | 联系服务方 | 资格和周期暂未公开 | 面向符合条件的学生,折扣幅度未披露 | 教育和学习用途 |
积分与退款注意事项
- 一行消耗一个积分,因此文件列数不直接决定积分量,行数才是主要计费单位。
- 付费方案写有不限行数,结合一行一积分规则,应理解为不限制单个文件的行数,而不是无限免费处理。
- 官网未公开积分是否过期、能否跨账户转移、任务失败如何扣除和未使用积分退款规则。
- 错误免费重跑不能等同于退款承诺;涉及大额购买时应先取得书面规则。
适合用户与典型场景
- 销售与运营团队:统一 CRM 中的公司名、职位、行业和地区写法。
- 电商与采购团队:整理商品分类、供应商名称和人工录入的规格字段。
- 市场研究人员:合并问卷或名单中的同义答案,减少图表中的重复类别。
- 数据分析人员:在透视、分组、去重和导入数据库之前清理文本字段。
- 学生和小型团队:先用 25 行免费额度测试自己的语言与字段是否适配。
优势与能力边界
- 优势是无需编写清洗脚本即可处理多种常见值差异,并按行购买容量,成本较容易估算。
- 它更适合值级别的文本和数字表达统一,不应替代数据库结构设计、主数据管理或完整 ETL 系统。
- 同义词并不总能安全合并,例如品牌、法律实体、医学术语和产品型号只差少量字符也可能代表不同对象。
- 免费版每个文件只处理 25 行,适合试验而非完整生产数据。
- 公开页面没有说明支持语言、最大文件大小、列数、并发任务、准确率或服务级别。
平台、API 与开源状态
| 项目 | 当前确认状态 | 说明 |
|---|---|---|
| 网页端 | 已确认 | 注册后进入处理器,使用 Google 或邮箱账户 |
| CSV | 已确认 | 免费和付费方案均列出 |
| Excel | 已确认 | 付费积分包列出支持 |
| API、SDK、集成 | 暂未公开 | 未找到官方开发文档或连接器 |
| GitHub 与开源许可证 | 暂未公开 | 不能认定产品开源 |
| iOS、Android、桌面端、浏览器扩展 | 暂未公开 | 当前以网页端为主 |
隐私、安全与商用注意事项
- 本次未找到可核验的隐私政策、服务条款、安全说明、数据保存期限或删除流程。
- 官方未说明上传文件是否用于模型训练、是否与 AI 供应商共享、处理地区、加密方式或任务结束后的删除时间。
- 退款、积分有效期、错误重跑条件、输出权利和商业使用授权也未完整公开。
- 运营公司名称和注册主体暂未公开,企业采购前应索取合同、数据处理协议、子处理商清单和支持承诺。
- 在上述事项得到确认前,不宜上传身份证件、医疗记录、财务数据、客户秘密或其他敏感信息。
常见问题
DataNormalizer 可以免费使用吗?
可以免费测试,每个文件最多 25 行,处理优先级较低并仅列出 CSV 格式。
一个积分可以处理多少数据?
官网按一行一个积分计算。文件列数并未列为积分计算单位。
DataNormalizer 支持 Excel 吗?
支持,但 Excel 列在付费积分包权益中;免费版只列出 CSV。
它可以完成数据库范式设计吗?
不能按已确认功能这样理解。它用于统一表格字段中的值,不负责关系数据库表结构设计。
是否提供 API 或开源代码?
本次未确认官方 API、SDK、GitHub 或开源许可证,因此不能认定支持程序化接入或产品开源。
上传敏感数据安全吗?
官方暂未公开足够的隐私、安全和数据保留说明。敏感或受监管数据应在取得书面合同和处理规则后再考虑上传。
©️版权声明:若无特殊声明,本站所有文章版权均归AI工具分享原创和所有,未经许可,任何个人、媒体、网站、团体不得转载、抄袭或以其他方式复制发表本站内容,或在非我站所属的服务器上建立镜像。否则,我站将依法保留追究相关法律责任的权利。
类似于DataNormalizer的工具



AI工具盒导航收录了国内外数百个不同类型的AI工具,每日更新和添加最新AI工具,AI工具盒还推荐了AI学习开发的常用网站、框架和模型,帮助你加入人工智能浪潮,自动化高效完成任务!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。
 桂公网安备45132202000164号