




Krut AI
Krut AI, outil intelligent spécialisé dans les prompts d’IA
Étiquettes :Instructions de suggestion pour l’IAUne phrase pour présenter
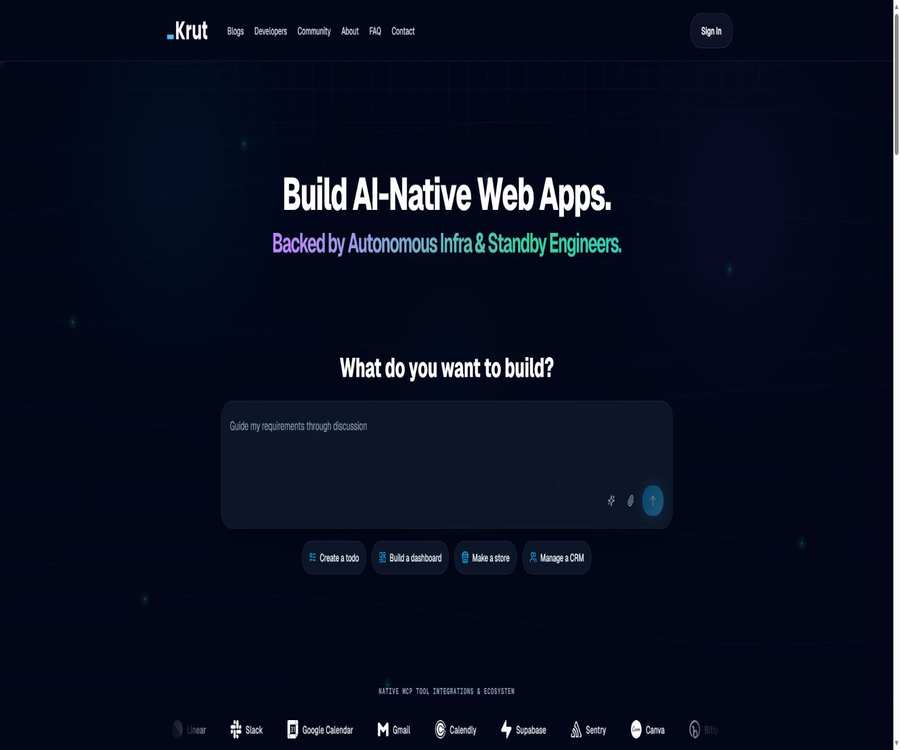
Krut AI est une plateforme de construction d’applications full-stack conversationnelles : après que l’utilisateur a décrit ses besoins, le système génère l’interface utilisateur, le backend, la base de données, les capacités d’IA ainsi que l’environnement de déploiement, et offre une assistance d’ingénieurs humains pour les problèmes complexes.
Présentation des outils
Krut AI est actuellement positionné comme une plateforme d’applications et d’infrastructures natives pour l’IA, et non plus comme un outil axé principalement sur la génération d’images pour le e-commerce mentionné dans les documents initiaux. Il convient à la création de solutions de traitement de documents OCR, d’applications vocales, de back-ends métier, de CRM, de boutiques, ainsi que d’applications web intégrant une logique d’agent.
La plateforme intègre la génération de code, les images de conteneur, les bases de données, le cache, les files d’attente asynchrones et l’hébergement dans une même zone de travail. Les utilisateurs doivent toujours définir clairement leurs besoins, tester les résultats et évaluer les risques en production ; ils ne peuvent pas considérer la construction automatique comme une absence d’ingénierie logicielle.
Trois compétences clés
| Capacité centrale | Contenu inclus | Valeur principale | Limites clés |
|---|---|---|---|
| Moteur natif d’IA | OCR, transcription vocale, synthèse vocale, voix en temps réel et logique LLM | Combinaison rapide d’applications multimodales | La précision, le délai et le coût du modèle doivent être testés. |
| Infrastructure d’automatisation | Images Docker, PostgreSQL, Redis, files d’attente, Workers et hébergement | Réduire la configuration manuelle dans le cloud | L’architecture, l’échellement et la récupération en cas de panne doivent encore être validés. |
| Ingénieurs artificiels à l’aide | Vérifier les journaux, résoudre les erreurs de construction répétées et les cas de limites complexes | Continuer à avancer lorsque l’IA est bloquée | La portée, le temps de réponse et les normes de livraison ne sont pas quantifiés publiquement. |
Fonction principale
Application full-stack de génération de langage naturel
Les utilisateurs peuvent décrire les fonctionnalités, les pages, les données et les flux de travail en langage courant, et Krut génère l’application en fonction de cela. La plateforme ne fournit pas seulement des fragments de code, mais aussi un espace de travail, une prévisualisation en temps réel, une publication hébergée et des intégrations tierces optionnelles.
OCR et analyse de documents
Krut peut ajouter à une application l’OCR pour les PDF et les documents scannés, et transmettre les résultats aux processus métier suivants. Les tableaux, l’écriture manuscrite, les images en basse résolution et les maquettes complexes nécessitent encore des tests avec des documents réels.
Entrée/sortie vocale
La plateforme prend en charge la transcription vocale en texte, la synthèse vocale à partir de texte, ainsi que des pipelines vocaux en temps réel, et peut être utilisée pour les assistants vocaux, le service client et les scénarios d’accessibilité. Le bruit, l’accent, le retard, les interruptions et l’accord pour l’appel peuvent affecter l’expérience réelle.
Logique des LLM multi-modèles
Les applications peuvent relier la vision, la voix et plusieurs LLM en un flux de travail, et effectuer des appels entre l’interface utilisateur et le backend. Le nom du modèle, les méthodes de routage, la consommation et les détails BYOK ne sont pas listés en détail sur la page publique.
Construction d’image Docker
Le système génère des images Docker personnalisées en fonction des dépendances du projet, sans que l’utilisateur n’ait à écrire manuellement la configuration du conteneur. La création de l’image nécessite néanmoins une vérification de l’image de base, des paquets logiciels, des vulnérabilités, de l’utilisateur de exécution et de la reproductibilité de la construction.
Bases de données et migration
La plateforme peut créer des bases de données PostgreSQL isolées, gérer les pools de connexions, la persistance et les migrations de schéma. Lorsque des données en production sont impliquées, il convient de vérifier les sauvegardes, la restauration, les index, la concurrence et le retrait.
Redis et files d’attente asynchrones
Le traitement par l’IA sur de longues périodes, les tâches audio/vidéo ou l’envoi d’e-mails peuvent être acheminés vers les files d’attente Redis et BullMQ, gérées par des pools de workers indépendants. Ces files d’attente nécessitent des fonctionnalités d’idempotence, de tentative de réessai, de messages morts, de délais d’expiration et de limitations de concurrence.
Hébergement et échelle automatique
Les applications générées peuvent être publiées sur des adresses en temps réel, avec un hébergement de conteneurs qui s’adapte en fonction de la charge. Les informations publiques ne listent pas complètement les régions, les SLA, le mode veille, la bande passante, les noms de domaine et les limites de ressources.
Intégration de MCP avec des tiers
Présentation des produits Notion, Linear, Slack, Google Calendar, Gmail, Supabase, Sentry, GitHub, Stripe et divers services de développement. Les fonctionnalités pratiques, les permissions et le niveau de maturité de chaque intégration doivent être vérifiés un par un dans le projet.
Ingénieurs artificiels en dernier recours
Lorsque la construction du conteneur échoue de manière répétée ou que les exigences sont floues, les ingénieurs humains peuvent consulter l’espace de travail et corriger les problèmes liés aux limites. L’accès manuel signifie que le code du projet et les données peuvent être consultés par des personnes autorisées ; pour les projets sensibles, il convient d’obtenir au préalable l’approbation de l’accès ainsi que des dispositions de confidentialité.
Applications adaptées à la création
- Outil OCR pour extraire des champs à partir de factures, de contrats ou de formulaires scannés.
- Application avec saisie vocale, transcription, lecture à voix haute et dialogue en temps réel.
- Agent interne qui relie le LLM aux règles métier.
- Back-office métier avec utilisateurs, permissions, formulaires et tableaux de bord.
- Prototype de boutique avec intégration de produits, de commandes et de paiements.
- CRM utilisant PostgreSQL pour stocker des données structurées.
- Plateforme de traitement nécessitant un Worker en arrière-plan pour exécuter des tâches longues.
- Automatisation de la connexion aux calendriers, aux e-mails, aux outils de collaboration ou aux systèmes de surveillance.
- Un prototype full-stack nécessitant un déploiement containerisé et une migration de base de données.
Les applications ne doivent pas être mises en ligne directement après avoir été créées.
- Systèmes de paiement, financiers et de transfert d’argent non soumis à une vérification de sécurité.
- Aucun outil de diagnostic médical ou de prise de décision thérapeutique sans vérification professionnelle.
- Systèmes traitant des identités hautement sensibles, des enfants ou des données d’identification biométrique.
- Back-office de production d’entreprise sans contrôle d’accès ni audit.
- Applications qui utilisent l’IA pour prendre directement des décisions en matière de recrutement, de crédit ou de droit.
- Service en temps réel à forte concurrence sans test de charge.
- Systèmes qui dépendent d’interfaces tierces non vérifiées pour effectuer des transactions critiques.
- Outils de traitement de voix ou de documents sans autorisation d’enregistrement et de contenu.
Du besoin à la mise en ligne : le processus
- Définir le public cible, les problèmes clés et la fonctionnalité minimale vérifiable.
- Listez les pages, les rôles, les entités de données, les intégrations externes et les exigences de sécurité.
- Décrire la première petite version en langage naturel, sans ajouter toutes les fonctionnalités d’un coup.
- Vérifier l’interface, les structures de données et les processus métier générés par Krut.
- Téléchargez des données de test anonymes pour valider les capacités d’OCR, de reconnaissance vocale ou de LLM.
- Vérifier les dépendances du conteneur, la migration de la base de données, ainsi que la configuration des files d’attente et des workers.
- Accordez uniquement les permissions minimales lors de la connexion à des services tiers.
- Tester les erreurs, les permissions, la concurrence et le redémarrage en cas d’anomalie dans l’environnement de prévisualisation.
- Laissez les ingénieurs humains gérer les problèmes aux limites que la plateforme ne peut pas résoudre.
- Publier en version finale uniquement après avoir achevé les validations en matière de sécurité, de confidentialité, de performance et d’opérations.
- Surveillez les journaux de connexion, les coûts, la qualité des modèles et les retours des utilisateurs une fois en ligne.
Comment bien rédiger une exigence
Krut peut commencer par une phrase, mais les applications en production nécessitent des conditions d’acceptation plus précises. Une exigence de haute qualité doit décrire les rôles des utilisateurs, les opérations clés, les règles de données, le comportement en cas d’échec et les actions inexécutables.
| Section des besoins | Il faut indiquer clairement ce qui doit être écrit. | Direction d’exemple |
|---|---|---|
| utilisateur | Rôles, méthodes de connexion et limites des permissions | Les administrateurs peuvent importer, les membres ordinaires ne peuvent que consulter. |
| Entrée | Fichiers, champs, langues, taille et vérification | PDF et images, limite le nombre de pages et refuse les fichiers exécutables |
| traitement | Ordre de l’OCR, de la reconnaissance vocale, des modèles et des règles métier | D’abord extraire les champs, puis les vérifier manuellement, enfin les enregistrer dans la base de données. |
| Sortie | Pages, téléchargements, notifications et format de structure | Créer des tableaux editables tout en conservant la position originale |
| Données | Structure de tableau, conservation, suppression et exportation | Nettoyage des projets et des pièces jointes après suppression du compte |
| Anomalie | Délai dépassé, échec, tentative de réessai et recul | Échec du OCR : passage à l’intervention humaine, pas de débit répété |
| Sécurité | Authentification, autorisation, audit et clés | Confirmation secondaire pour les opérations sensibles et enregistrement |
| Acceptation | Précision, délai et conditions de succès | Le taux de précision des champs du jeu d’exemples atteint le seuil convenu |
Précautions à prendre pour les applications OCR
- Utiliser des échantillons réels avec différentes qualités de scan, rotations et éclairages.
- Tester séparément le texte imprimé, la écriture manuscrite et les langues multiples.
- Tester séparément les tableaux, les cachets, les signatures et les formats à plusieurs colonnes.
- Conserver l’emplacement de l’image originale facilite la vérification manuelle.
- Les champs à faible niveau de confiance doivent faire l’objet d’une confirmation manuelle.
- Ne pas utiliser les résultats d’OCR directement pour des paiements ou des conclusions juridiques.
- Les documents sensibles doivent disposer d’une courte durée de conservation et de journaux d’accès.
- Vérifier si le modèle visuel tiers conserve le document.
Précautions pour les applications vocales
- Préciser les indications d’enregistrement et le consentement des participants.
- Test de mandarin standard, de dialectes, d’accent et de jargon professionnel.
- Effectuer des tests de charge sur le bruit, les échos et les fluctuations du réseau.
- Concevoir la gestion des interruptions, du silence et des délais d’expiration.
- Aligner la transcription avec l’audio original afin de la vérifier.
- Fournir des indications d’identité claires lors de la diffusion de la voix IA à l’extérieur.
- Ne lancez pas d’instructions vocales à haut risque sans confirmation humaine.
- Définir des règles de conservation, de téléchargement et de suppression audio.
Tâches en arrière-plan et files d’attente
La conversion audio/vidéo, les documents en masse, les e-mails et les appels de modèles longs ne conviennent pas pour bloquer les requêtes de page web ; Krut peut créer des files d’attente et des workers pour ces tâches. L’architecture de file d’attente doit néanmoins être conçue pour gérer les échecs et les exécutions répétées.
| Élément de file d’attente | Nécessite une configuration | Risques courants |
|---|---|---|
| ID de tâche | Unique au niveau global et état consultable | Soumissions répétées et confusion des résultats |
| Équivalence | Une même demande de service ne produit qu’un seul résultat valide. | La réessai entraîne des e-mails duplicats ou des débits. |
| Réessayer | Nombre de tentatives, intervalle et erreurs reproductibles | Boucle infinie et dépenses hors contrôle |
| Délai dépassé | Tâche unique et limite globale du processus | Occupation prolongée par le travailleur |
| concurrentiel | Nombre de Workers par type de tâche | Surcharge de la base de données, du modèle ou de l’interface externe |
| Lettre sans destinataire | Sauvegarder séparément les tâches échouées en continu | L’erreur est supprimée en silence. |
| Surveillance | Durée d’attente, taux de réussite et coût | Retard non détecté à temps |
| Annuler | Permettre aux utilisateurs d’arrêter les tâches non démarrées ou susceptibles d’être arrêtées | Continuer à consommer des ressources et des points |
Bases de données et persistance
La création automatique de bases de données peut réduire le temps de développement du prototype, mais la structure des tables et les migrations nécessitent une gestion technique une fois que des données réelles d’utilisateurs y sont stockées. Les schémas générés doivent vérifier les clés primaires, les clés étrangères, les contraintes d’unicité, les index et les zones horaires.
- Distinguer les bases de données de développement, de test et de production.
- Faire une sauvegarde automatique avant le transfert et vérifier la restauration.
- Définir des contraintes et des champs d’audit pour les tables clés.
- Les comptes de base de données utilisent les droits minimums.
- Restreindre l’accès direct des applications publiques à la base de données.
- Définir des tâches de suppression et de conservation pour les données personnelles.
- Surveiller le pool de connexions, les requêtes lentes, la capacité et les verrous.
- Vérifier l’intégrité des données et le codage avant d’exporter.
Soutien des ingénieurs artificiels
Les ingénieurs artificiels sont décrits comme un filet de sécurité pour gérer les erreurs de compilation répétées, les exigences floues et les cas limites complexes. La page publique ne précise pas le nombre d’heures de travail par compte, le temps de réponse, le nombre de modifications, les fuseaux horaires pris en charge ou les frais de mise à niveau.
| Il faut confirmer | Pourquoi c’est important |
|---|---|
| Conditions de déclenchement | Déterminer quand passer d’un processus automatisé par l’IA à un traitement manuel |
| Temps de réponse | Décider si le projet peut respecter la date de publication |
| Inclut les heures de travail | Éviter de confondre l’assistance avec des services de développement illimités |
| Portée de la visite | Les ingénieurs peuvent examiner le code, les journaux et les données du projet. |
| Vérification du code | Vérifier si les modifications ont été examinées et testées par une deuxième personne |
| Normes de livraison | Définir ce qu’est une tâche terminée, disponible ou prête à la production |
| Maintenance ultérieure | Une réparation ne revient pas à une maintenance continue. |
| Confidentialité et propriété intellectuelle | Protéger le code client et les besoins commerciaux |
La page utilise des expressions telles que « livraison garantie », mais les conditions du service indiquent en même temps que les résultats générés par l’IA peuvent être erronés ou incomplets, que le service est fourni tel quel sans aucune garantie de continuité. Lors de l’achat, il convient d’énoncer dans un contrat distinct la portée de la livraison et les critères d’acceptation, et de ne pas se fier uniquement aux textes publicitaires.
Publication et hébergement
L’application générée peut être publiée à une adresse publique, et son contenu devient visible pour les visiteurs. Avant la mise en ligne, il convient de vérifier que les variables d’environnement, les pages de débogage, les comptes par défaut, les ports de base de données, les piles d’erreurs et les données de test ne sont pas exposés.
- Créer un environnement de prévisualisation séparé de la production.
- Supprimer les utilisateurs d’exemple, les clés de test et les interfaces de débogage.
- Activer l’authentification, l’autorisation, la validation des entrées et le throttling des requêtes.
- Scannage des images de conteneur, des dépendances et des ports publics.
- Effectuer des exercices de sauvegarde et de restauration de la base de données.
- Définir les journaux, les indicateurs, les alertes d’erreurs et les processus de garde.
- Tester le débit maximal, l’accumulation de Workers et les pannes des interfaces externes.
- Vérifier la politique de confidentialité, les conditions d’utilisation et les consentements nécessaires.
- Ouvrir progressivement aux utilisateurs réels et se préparer à revenir en arrière.
MCP et intégration
| Catégories intégrées | Outil de représentation | Utilisations courantes | Risques principaux |
|---|---|---|---|
| Collaboration | Notion, Linear et Slack | Documents, tâches et notifications | Lecture hors limites et écriture erronée |
| Services Google | Calendrier et Gmail | Planification et automatisation des e-mails | Largeurs de droits OAuth et contenus sensibles |
| Données | Supabase, PostgreSQL et Redis | Comptes, données et cache | Exposition de la base de données et configuration des droits d’accès |
| Développement | GitHub, Docker et Vercel | Code, images et déploiement | Clés de production, chaîne d’approvisionnement et publication automatique |
| Surveillance | Sentry | Suivi des erreurs et de la performance | Le journal contient des données personnelles ou sensibles. |
| Conception | Canva et Figma | Collaboration entre matériaux et interface | Droits d’auteur et accès aux documents |
| Modèle d’IA | Anthropic et OpenAI | Texte, visuel et logique d’agent | Frais de token, erreurs de conservation et d’exportation |
| Paiement | Stripe | Commandes et abonnements | Opérations de fonds, sécurité PCI et Webhook |
Le fait qu’une icône apparaisse dans l’écosystème du produit ne signifie pas que chaque fonctionnalité offre déjà des opérations bidirectionnelles complètes. L’utilisateur doit vérifier dans le projet réel les méthodes d’authentification, les actions disponibles, la gestion des erreurs et les restrictions des forfaits.
Prix et points
Les informations sur les prix ont été vérifiées le 23 août 2026 ; les montants réels, les taxes, les taux de change et les remises peuvent varier. Les données finales seront celles affichées sur la page de paiement.
Krut utilise des points prépayés, ne facture pas de frais de abonnement périodique fixe, et ne comporte pas d’abonnement automatique à annuler. Les points sont consommés lors de la génération d’applications par l’IA, du lancement de conteneurs et du maintien des applications déjà publiées.
| Projet | Prix ou règles actuels | Mode de facturation | Précautions à prendre |
|---|---|---|---|
| Inscription au compte | Tarif non encore divulgué | Créer un compte | La mise à disposition de points initiaux dépend du compte. |
| Recharge par points | Les niveaux spécifiques ne sont pas encore divulgués. | Prépaiement via Razorpay | Le règlement peut entraîner des frais supplémentaires tels que la TVA indienne. |
| Génération par applications d’IA | Consommation selon les points | Utiliser pour la génération et la modification | Les tarifs pour différents modèles et niveaux de complexité des tâches ne sont pas divulgués. |
| Exécution de conteneurs | Consommation selon les points | Utilisation continue pendant le fonctionnement | Les spécifications des ressources, le mode veille et le tarif par unité ne sont pas divulgués. |
| Applications publiées | Consommation selon les points | Maintenir l’application en ligne | Il faut vérifier si les applications à faible consommation de données entrent en veille. |
| Aide à l’ingénierie humaine | Prix individuel non encore divulgué | Selon la plateforme ou le projet | Les heures de travail et les frais supplémentaires doivent être confirmés. |
| Services de tiers | Décidé par chaque fournisseur | Modèles, e-mails, paiements ou API externes | Peut ne pas être inclus dans l’intégrale de Krut |
La page publique ne liste pas le montant du rechargement, le nombre de points, les tarifs des modèles, les spécifications du conteneur, la bande passante, la base de données, le stockage et le temps de travail des ingénieurs. Le budget ne peut être confirmé que sur la page Billing après connexion ou lors de communications commerciales ; on ne peut pas en déduire que les coûts d’utilisation sont faibles en raison de l’absence de abonnement.
Règles de remboursement
- Les points consommés ne sont pas remboursables.
- Les points d’achat non utilisés peuvent faire l’objet d’un remboursement dans les 7 jours suivant l’achat.
- L’approbation du remboursement déduira les frais de paiement et les taxes irrécupérables.
- Les points offerts dans le cadre de promotions ou en cadeau n’ont aucune valeur monétaire et ne sont pas remboursables.
- Un remboursement intégral peut être demandé en cas de prélèvements répétés.
- Si le paiement a réussi mais que les points n’ont pas été crédités en 24 heures, vous pouvez demander une nouvelle attribution de points ou un remboursement intégral.
- Les paiements échoués sont généralement remboursés par la banque ou Razorpay en 5 à 7 jours ouvrés.
- Un remboursement approuvé met généralement de 5 à 7 jours ouvrés pour arriver sur le compte.
- La demande de remboursement doit être soumise depuis l’adresse e-mail d’inscription, en indiquant le numéro de paiement, la date et la raison.
Propriété et usage commercial
L’utilisateur conserve la propriété des prompts, des données et des fichiers soumis, ainsi que de l’application générée dans la mesure permise par la loi. L’utilisateur autorise Krut à héberger, traiter et afficher le contenu des projets aux fins du fonctionnement et de l’amélioration du service.
- Le code généré peut être similaire à celui des autres utilisateurs.
- L’utilisateur est responsable de vérifier les licences relatives au code tiers, aux éléments et aux résultats des modèles.
- La publication d’une application doit respecter la loi et les droits de tiers.
- La création de logiciels malveillants, de pages de phishing et d’outils de spam est interdite.
- Les services Krut ne peuvent être revendus ou sous-licenciés sans accord écrit.
- Avant utilisation commerciale, il convient de vérifier les licences de dépendance et les droits sur les éléments générés.
- Les applications métier critiques nécessitent une audit et des tests de code indépendants.
Confidentialité et traitement des données
Krut gère les informations de compte, les prompts, les fichiers téléchargés, le code d’application, les données du projet, les informations de transaction, les journaux d’utilisation et les informations du dispositif. Lors de la connexion à des services tels que Gmail ou Calendar, il enregistre également les tokens OAuth ainsi que les données minimales nécessaires pour effectuer l’intégration.
Le contenu des projets sera envoyé à des fournisseurs de modèles d’IA tiers tels que Google afin de générer du code et des applications. Krut affirme qu’il ne vendra pas ce contenu, ni n’utilisera le contenu de projets privés pour entraîner ses propres modèles. Il faudra consulter les conditions spécifiques du service choisi pour savoir si les modèles tiers sont conservés ou entraînés.
| Élément de données | Méthode de traitement public | Conseils d'utilisation |
|---|---|---|
| Mots-clés et fichiers | Utilisé pour la génération par IA et le fonctionnement des projets | Ne téléchargez pas de données confidentielles ou personnelles auxquelles vous n’avez pas accès. |
| Génération d’applications et de code | Sauvegardé dans l’espace de travail du projet | Nettoyer les secrets, les données de test et les journaux avant la publication |
| Traitement du modèle | Envoyer le contenu nécessaire aux modèles tiers sur demande | Vérifier le modèle, la région, les politiques de réserve et d’entraînement |
| Token intégré | Enregistrer selon la portée des autorisations | Autorisation minimale, révocation périodique et vérification des anomalies |
| Paiement | Les identifiants de paiement complets sont gérés par Razorpay. | Krut enregistre le montant, l’état et l’identifiant de la transaction |
| Application publique | L’adresse de publication peut être consultée par tous les visiteurs. | Ne doit pas contenir de clés internes ni de données confidentielles. |
| Comptes et projets | Conserver pendant la période de validité du compte ou la durée nécessaire au service | La demande de suppression peut faire l’objet d’exceptions liées à des obligations légales. |
| Transmission internationale | Le fournisseur peut se trouver dans d’autres pays. | Les entreprises sensibles doivent évaluer le DPA et la région des données |
Vérification de sécurité
- Utilisez un mot de passe fort et distinct ainsi qu’un accès sécurisé pour le compte Krut.
- L’intégration avec des tiers n’accorde que les permissions nécessaires au projet.
- Toutes les clés sont stockées dans des variables d’environnement ou dans un service de clés contrôlé.
- Ne mettez pas de clés réelles dans les prompts, les dépôts de code ou l’incorporation frontale.
- Définir l’authentification, la limitation du débit et la validation des entrées pour les interfaces publiques.
- Le scan génère des dépendances et des vulnérabilités dans les images de conteneur.
- Restreindre les types, la taille et les ressources à analyser pour les fichiers téléchargés.
- Le paiement par Webhook nécessite une vérification par signature et l’idempotence.
- La base de données de production interdit l’utilisation des mots de passe par défaut et des ports publics.
- Vérifier la portée des accès et les enregistrements des opérations effectuées par les ingénieurs humains.
- Exporter régulièrement le projet et tester la sortie de la migration.
API, SDK et GitHub
La navigation comprend des documents pour les développeurs et une entrée vers l’API, mais la page dédiée aux développeurs indique clairement que les références API et le guide SDK sont encore en préparation. Il n’est donc pas possible d’affirmer qu’il existe déjà des interfaces de développement stables, publiques et assorties d’engagements de version.
| Projet | État actuel | Comprendre correctement |
|---|---|---|
| Documentation pour les développeurs | En préparation | Aucune documentation complète d’interface publique disponible |
| Référence API | En préparation | L’authentification, la limitation du débit et les engagements de version ne sont pas divulgués. |
| SDK | En préparation | Il est interdit de fournir des paquets d’installation ou des exemples de code non vérifiés. |
| Écosystème MCP | Soutien à la présentation des produits | Les serveurs spécifiques, les actions et les permissions doivent être vérifiés au sein du projet. |
| GitHub officiel principal | Pas de vérification possible | Ne peut pas être marqué comme plateforme de construction d’applications open source |
| Générer le code du projet | Générable dans la zone de travail de l’utilisateur | Le code du projet disponible n’est pas équivalent à l’open source de la plateforme Krut |
| Plateforme auto-hébergée | Pas encore rendu public | La construction d’une application Docker ne signifie pas que Krut lui-même peut être privatisé |
À qui s’adresse-t-il
- Entrepreneurs qui souhaitent créer rapidement des prototypes full-stack en langage naturel.
- Équipes de produits nécessitant une application combinée d’OCR, de reconnaissance vocale et de LLM.
- Les utilisateurs qui ne souhaitent pas configurer manuellement Docker, la base de données et la file d’attente des tâches.
- Équipes de applications web qui ont besoin d’un Worker en arrière-plan pour traiter des tâches longues.
- Clients qui souhaitent obtenir l’aide d’un ingénieur humain en cas de blocage de l’IA.
- Équipe disposée à recharger en fonction de l’utilisation et capable de gérer les contrôles de production.
- Les entreprises qui ont besoin de valider rapidement leurs outils internes, leur CRM et leur back-office métier.
Avantages du produit
- De la couverture des besoins en langage naturel à l’interface utilisateur, au backend et à l’hébergement.
- Combinaison native de l’OCR, de la reconnaissance vocale et de la logique métier des LLM.
- Création automatique d’images Docker et d’environnements de exécution de conteneurs.
- Configuration automatique de PostgreSQL, Redis et des travailleurs asynchrones.
- Les tâches longues et les applications multimodales sont plus performantes que les générateurs de pages simples.
- Les ingénieurs artificiels peuvent gérer les échecs répétés et les frontières complexes.
- Prend en charge diverses activités, le développement, l’IA et l’intégration des paiements.
- Pas de abonnement fixe, utilisation selon des points prépayés.
- L’utilisateur conserve le droit sur le contenu du projet et sur l’application générée.
Principales restrictions
- La page publique ne fournit pas les options de rechargement de points ni les tarifs complets.
- Les modèles, les conteneurs, le stockage, la bande passante et les quotas de base de données ne sont pas transparents.
- Les ingénieurs artificiels incluent des heures de travail et des délais de réponse non quantifiés.
- La publicité relative aux garanties de livraison et aux services selon les termes « tel que vu » nécessite des clarifications contractuelles.
- Le code généré par l’IA peut contenir des erreurs, des incomplétudes ou des vulnérabilités de sécurité.
- Les capacités multimodales dépendent de modèles tiers et de services externes.
- La documentation de l’API et du SDK pour les développeurs est encore en préparation.
- Aucune plateforme centrale open source officielle ou version auto-hébergée n’a été identifiée.
- Les informations publiques sur la maturité des connecteurs et les droits spécifiques sont limitées.
- Les applications publiques peuvent exposer par accident les données du projet et les clés.
- Les points prépayés sont également consommés de manière continue par la gestion.
- Les applications de production nécessitent encore des tests, un suivi, des sauvegardes et une maintenance.
Liste de contrôle avant mise en ligne
- Découper les exigences en pages, données et règles métier vérifiables.
- Tester les fonctionnalités natives de l’IA à l’aide de données réelles mais anonymisées.
- Vérifier tous les rôles d’utilisateurs et les chemins d’accès non autorisés.
- L’audit génère du code, des dépendances, des images et des interfaces publiques.
- Vérifier la migration, la sauvegarde, la restauration et la suppression de la base de données.
- Tester l’identité, la réessai, le délai d’expiration et l’accumulation dans la file d’attente.
- Vérifier l’accès aux données des modèles, de l’intégration et des ingénieurs manuels.
- Tester les pannes des interfaces tierces, la limitation du débit et les plafonds de frais.
- Obtenir les taux de tarification complets et l’estimation du budget mensuel.
- Vérifier que les noms de domaine, les données et le code peuvent être exportés pour la migration.
- Préparer une politique de confidentialité, des conditions d’utilisation et des procédures de support pour l’application.
- Publier en faible volume et conserver un plan de rollback rapide.
Questions fréquentes
Que fait Krut AI actuellement ?
Il s’agit désormais d’une plateforme de développement d’applications full-stack interactives, axée sur les capacités natives de l’IA, une infrastructure de conteneurs automatisés et l’assistance d’ingénieurs humains, sans plus se concentrer principalement sur la génération d’images pour le e-commerce.
Krut AI est-il un outil sans code ?
L’utilisateur peut commencer en langage naturel, mais la plateforme génère une application complète comprenant du code, des bases de données et des conteneurs. Pour une utilisation en production, il reste nécessaire de comprendre les exigences, de tester, de garantir la sécurité et d’assurer l’exploitation.
Quelles capacités d’IA Krut AI prend-il en charge ?
Les capacités listées publiquement comprennent l’analyse de documents OCR, la transcription vocale, la synthèse vocale, la communication vocale en temps réel ainsi que la logique métier pour les LLM multimodèles. Les modèles spécifiques et les tarifs doivent être confirmés dans le compte.
Comment Krut AI facture-t-il ?
Plutôt que d’une abonnement fixe, des points prépayés sont utilisés ; la création d’applications et l’exécution de conteneurs hébergés consomment des points. Les différents forfaits de rechargement et les tarifs par unité ne sont pas divulgués.
Est-il possible d’obtenir un remboursement pour des points non utilisés ?
Vous pouvez demander le remboursement des points non utilisés dans les 7 jours suivant l’achat. Une fois approuvé, les frais de traitement et les taxes irréversibles seront déduits. Les points déjà utilisés ou ceux provenant de promotions ne sont pas remboursables.
Un ingénieur en IA va-t-il m’aider à terminer la demande ?
La plateforme indique que les ingénieurs peuvent gérer les échecs de construction répétés et les cas de limites complexes, mais les coûts en heures de travail, les délais de réponse et les normes de livraison ne sont pas divulgués. Pour les projets importants, le périmètre des services doit être confirmé par écrit avant le paiement.
Krut AI est-il open source ?
Aucun code source officiel public ni licence open source pour la plateforme principale n’a été identifié. Les utilisateurs peuvent créer leur propre code de projet, mais cela ne signifie pas que le service de construction d’applications Krut soit lui-même open source.
Des API et SDK sont-ils fournis ?
L’entrée pour les développeurs est disponible, mais les informations de la page actuelle concernant la référence API et le guide SDK sont encore en préparation. Les projets nécessitant des interfaces stables doivent attendre la documentation officielle ou obtenir une promesse écrite de l’équipe.
Résumé
Krut AI convient aux équipes qui souhaitent développer rapidement des applications full-stack pour l’OCR, la reconnaissance vocale, les LLM et les tâches en arrière-plan grâce à des dialogues. Grâce au Docker automatique, à PostgreSQL, aux files d’attente Redis, aux workers et à l’aide d’ingénieurs humains, son champ d’application dépasse la simple génération de pages web.
Ses principales incertitudes résident dans les tarifs d’intégration, les ressources de fonctionnement, la portée des services manuels, les interfaces de développement et le manque de transparence concernant l’état open source. Avant son utilisation en production, il est nécessaire de procéder à une validation complète du code généré, des flux de données, des coûts de hébergement continu, des modèles tiers et des voies de retrait en ligne.
Outils similaires à Krut AI

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164