




DeepInfra
DeepInfra : permet à l’IA d’apprendre pour un travail plus efficace et plus simple
Étiquettes :Site d’apprentissage de l’IAQu’est-ce que DeepInfra ?
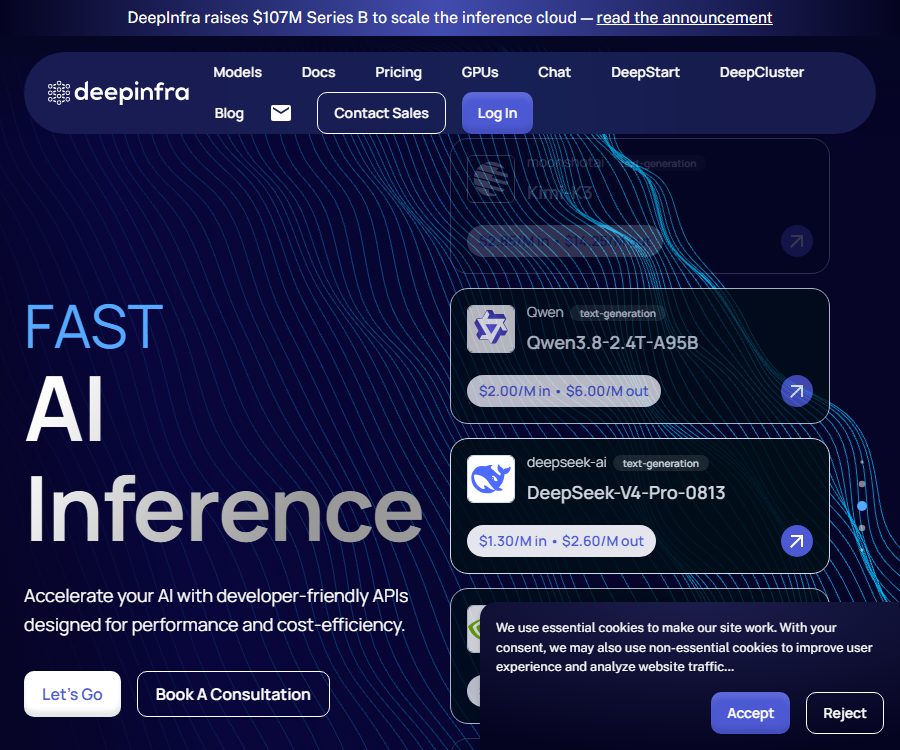
DeepInfra est un cloud d’inférence IA géré par l’américain Deep Infra Inc., destiné aux développeurs et entreprises qui souhaitent intégrer du langage, des images, de la voix, de la vidéo ainsi que des modèles de machine learning traditionnels dans leurs produits.
La plateforme propose en même temps une inférence Serverless partagée, du traitement par lots, un déploiement de modèles privés, des instances GPU, des sandbox de code et des agents hébergés. Elle résout les problèmes liés au lancement des modèles, à l’élargissement ou à la réduction élastique de la capacité, à la compatibilité des interfaces et aux coûts d’inférence, plutôt que de se limiter à une simple page de chat.
Capacités principales
- Inference de modèles partagés : sélectionnez un modèle de langue, d’embedding, de réarrangement, d’image, de vidéo, de voix ou de classification dans le catalogue des modèles ; la facturation s’effectue en fonction du nombre réel de tokens ou d’opérations exécutées, sans nécessité de gérer soi-même les GPU.
- Interface compatible OpenAI : chat, complétion de texte, embedding et génération d’images – on peut réutiliser le SDK OpenAI en modifiant uniquement l’adresse de base, le nom du modèle et la clé.
- Interface multimodale native : couvre des tâches non prises en charge par les interfaces compatibles telles que la génération d’images, la reconnaissance vocale, la détection d’objets, la classification d’images, la classification sans échantillon, la reconnaissance d’entités et le remplissage de masques.
- Traitement par lots : soumettre un grand nombre de requêtes non en temps réel sous forme de fichiers et de lots de manière asynchrone, ce qui convient aux évaluations hors ligne, au traitement de contenu et à l’étiquetage des données. L’étiquetage de documents publics est 20 % moins coûteux que le raisonnement en temps réel.
- Modèles privés : Déployez des modèles Hugging Face, des poids personnalisés, LoRA linguistiques ou LoRA d’images sur des GPU dédiés, ce qui offre des endpoints isolés, une échelle automatique et des délais plus prévisibles.
- Instance GPU : louez un conteneur B200 pour exécuter des tâches d’entraînement, de fine-tuning, de déduction ou des charges de travail personnalisées via SSH, facturation selon le temps d’exécution.
- Sandboxes : Démarrage sur demande de machines virtuelles Linux isolées, permettant aux agents d’exécuter du code, de lire et d’écrire des fichiers dans l’espace de travail ainsi que d’accéder à Internet ; aucun frais de calcul n’est facturé une fois arrêtées.
Tâches de modèle prises en charge
| Catégorie de tâche | Entrée typique | Sortie principale | Scénarios adaptés |
|---|---|---|---|
| Chat et raisonnement | Messages, instructions système, définitions d’outils, images | Texte, données structurées, appels d’outils | Service client, assistant de connaissances, agents intelligents et applications de code |
| Insertion et réarrangement | Requêtes et collections de documents | Score vectoriel ou de corrélation | Recherche sémantique, RAG et tri de recherche |
| Images et vidéos | Mots-clés, images et paramètres de génération | Images, résultats d’édition ou tâches vidéo | Matières visuelles, prototypes et production de contenu |
| Voix | Audio ou texte | Transcription, traduction ou synthèse vocale | Transcription de réunions, sous-titres et interaction vocale |
| Classification visuelle et textuelle | Images, texte ou étiquettes candidates | Catégorie, boîte, entité ou probabilité | Vérification, extraction d’informations et annotation automatique |
Différences entre les deux ensembles d’API
| Type d’interface | Capacité de couverture | Avantages principaux | Adéquat pour les utilisateurs |
|---|---|---|---|
| Interface compatible OpenAI | Chat, complétion, insertion, images, etc. | Réutilisation du client OpenAI existant et de la structure d’appel | Migrer des applications existantes ou créer des prototypes rapidement |
| Interface native DeepInfra | Tous les types de modèles fournis par la plateforme | Prend en charge davantage de tâches visuelles, vocales et de classification, ainsi que des fonctions de rappel. | Projets nécessitant un catalogue complet de modèles et des paramètres à faible résolution |
Toutes les interfaces utilisent un jeton Bearer pour l’authentification. Les paramètres des différents modèles, la longueur du contexte, la sortie en flux, les appels d’outils, la sortie structurée et le support multimodal ne sont pas uniformes ; il est donc impossible de supposer que le comportement reste identique simplement en remplaçant le nom du modèle.
Processus d’accès rapide
- Inscrivez-vous, créez un token API dans la console, et utilisez des clés différentes pour les environnements de développement, de test et de production.
- Sélectionnez le modèle dans le répertoire des modèles, et vérifiez la licence, le contexte, le type d’entrée, le format de sortie, le prix unitaire, les limites de débit et les exceptions de traitement des données.
- L’interface compatible permet de continuer à utiliser le SDK d’OpenAI ; pour les tâches spéciales, on utilise l’interface native et on construit les requêtes selon le schéma du modèle.
- Testez d’abord le délai de timeout, la réponse en flux, les appels d’outils, la réessai en cas d’erreur et la qualité de la sortie avec un faible débit, puis définez les limites de concurrence, de budget et de rechargement automatique.
- Une fois en ligne, surveillez les tokens, les hits de cache, les délais et le taux d’échecs en utilisant les données de consommation et les coûts des requêtes, afin d’éviter des tentatives répétées sans limite.
Mode de facturation pour l’inférence partagée
Les modèles de langage sont généralement facturés au prorata pour chaque million de tokens d’entrée et de sortie, et certains modèles offrent un tarif plus bas par token d’entrée en mémoire tampon. Les images, la voix, la vidéo et d’autres modèles peuvent être facturés en fonction du nombre d’images, de la durée audio, du nombre de secondes de génération ou du temps d’exécution de l’inference.
| Forfait ou version | Prix | Période de facturation | Droits ou crédit principal | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Llama 3.1 8B Turbo | Entrée : 0,02 dollar américain, sortie : 0,04 dollar américain | Par 1 million de tokens | Raisonnement textuel à faible coût avec contexte de 128K | Classification, résumé et assistant léger |
| Llama 3.3 70B Turbo | Entrée : 0,10 dollar, sortie : 0,32 dollar | Par 1 million de tokens | Chat et raisonnement généraux pour des modèles plus grands | Applications exigeant une qualité plus élevée |
| DeepSeek V4 Flash | Saisir 0,09 dollar, afficher 0,18 dollar | Par 1 million de tokens | Il existe également un prix unitaire d’entrée en cache encore plus bas | Contexte long et tâches à forte bande passante |
| Qwen 3.5 9B | Entrée : 0,10 dollar, sortie : 0,15 dollar | Par 1 million de tokens | Contexte 256K | Multilinguisme et raisonnement léger |
| Kimi K2.5 | Entrée : 0,45 dollar, sortie : 2,25 dollar | Par 1 million de tokens | Il y a également un prix d’entrée en mémoire tampon | Contexte long et tâches complexes |
Ce qui précède est un échantillon représentatif de la page des prix en temps réel ; il ne s’agit pas d’un forfait fixe ni d’une garantie de prix. Les modèles actifs ou inactifs, les versions, les règles de mise en cache et les prix unitaires peuvent varier. Une estimation officielle doit être obtenue en consultant la page du modèle sélectionné ainsi que les informations de facturation du compte.
Limite gratuite, rechargement et remboursement
- Aucun forfait API gratuit permanent ou quota mensuel gratuit valable pour tous les comptes n’a été confirmé pour le moment ; les crédits offerts lors de l’inscription et les promotions ne peuvent pas être considérés comme des avantages permanents.
- Le raisonnement partagé fonctionne selon un modèle de paiement à l’usage ; il est possible d’ajouter des fonds au compte et de configurer des recharges automatiques ; un solde insuffisant peut entraîner la suspension des requêtes, des sandbox ou des opérations d’instance.
- Les services d’entreprise permettent de fixer des délais de paiement, des niveaux de support et d’autres conditions via une commande de service ; aucune offre standardisée n’est disponible sur la page publique.
- Les dispositions en vigueur ne prévoient pas de garantie de remboursement générale applicable à tous les soldes prépayés et aux quantités consommées ; en cas de manquement au service et d’impossibilité de le rétablir, les dispositions considèrent le remboursement correspondant comme une mesure corrective spécifique.
Traitement par lots et optimisation des coûts
- Utilisez l’API Batch pour les tâches ne nécessitant pas de réponse immédiate : vous bénéficierez d’une remise de 20 % selon les indications du document, et la charge concurrentielle en temps réel sera réduite.
- Lors de la réutilisation d’un préfixe de suggestion long, on peut utiliser le cache des suggestions pour réduire le délai de pré-remplissage et les coûts de lecture du cache ; les options de conservation comprennent des durées courtes et une heure.
- Faites en sorte que la réponse ne génère que la longueur requise, et fixez des limites pour le token de sortie maximal, la concurrence et le nombre de tentatives.
- Traiter d’abord la classification, le routage et l’extraction avec un petit modèle, puis confier les rares requêtes complexes à un grand modèle, est généralement plus contrôlable que d’utiliser un modèle coûteux pour toutes les requêtes.
Modèles privés et déploiement exclusif
| Type de déploiement | Mode de facturation | Capacité centrale | Adéquat pour les utilisateurs |
|---|---|---|---|
| Serverless partagé | Par token ou par quantité de raisonnement | Pas de gestion d’instances, partage automatique de la capacité | Fluctuations du trafic et mise en ligne rapide |
| LLM privé | Par heure GPU | Poids personnalisé, points d’extrémité isolés, échelle automatique, interface compatible | Modèles personnalisés et délais stables |
| Déploiement de LoRA | Selon les ressources exclusives | Charger un adaptateur de langue ou d’image | Ajustement de domaine et style de marque |
| Instance GPU B200 | À partir de 3,69 $ de l’heure | SSH, conteneurs, 180 GB de mémoire vidéo, facturation par minute | Entraînement, affinage et personnalisation des programmes |
| Solution d’entreprise | Cotation sur mesure | Commandes de services, capacité, support et conditions commerciales | Besoins de conformité à grande échelle ou spéciaux |
Pour le déploiement privé, la facturation se poursuit même en l’absence de demande, tant que la GPU est en cours d’exécution. Les exemples dans la documentation indiquent qu’oublier de désactiver un déploiement à double GPU pendant 64 heures peut entraîner des frais d’environ 256 dollars ; il est donc nécessaire de définir des plafonds de budget et une réduction automatique des ressources.
Sandboxes sandbox de code
- Chaque sandbox est une machine virtuelle Linux indépendante qui peut exécuter des commandes et du Python, transférer des fichiers et accéder à Internet, mais ne reçoit pas de connexions entrantes et ne peut pas accéder aux autres sandboxes ou au réseau interne de DeepInfra.
- Tarification au second, sans durée minimale ; facturation pour les processus de création, de démarrage, d’exécution et d’arrêt ; aucune facturation en état d’arrêt.
- Seul le répertoire de l’espace de travail est conservé entre une arrêt normal et un redémarrage, pendant un maximum de 7 jours après l’arrêt ; l’état d’échec est supprimé en quelques minutes, et la restauration de l’espace de travail n’est pas garantie.
- Le délai de inactivité par défaut est de 1 heure ; l’exécution continue pendant 24 heures entraîne une arrêt automatique. Une seule commande peut durer au maximum 30 minutes, et chaque compte peut disposer de 5 sandbox en état non arrêté au maximum.
- La limite de lecture/écriture unique pour un fichier est de 100 Mo, et les résultats importants doivent être copiés rapidement sur un stockage externe.
Confidentialité des données et limite zéro conservation
- Les données d’entrée du raisonnement ordinaire ne restent en mémoire que pendant le traitement et ne sont pas écrites sur disque ; une fois les résultats retournés, elles sont supprimées de la mémoire, et la plateforme affirme ne pas utiliser ces données pour entraîner des modèles.
- Les résultats de génération d’images sont stockés temporairement pour permettre un accès, tandis que les traitements en lot peuvent chiffrer les données avant de les écrire sur le disque et de les supprimer peu de temps après la restitution des résultats.
- Lorsque l’on appelle les modèles Google ou Anthropic, les données sont transmises à l’endpoint correspondant du modèle, et la sauvegarde des résultats, les journaux ainsi que les règles d’entraînement suivent les politiques du fournisseur respectif.
- Les plateformes ne conservent généralement pas le corps de la requête, mais enregistrent des métadonnées telles que le numéro de la requête, le coût, les paramètres d’échantillonnage, etc., et conservent la possibilité d’enregistrer un petit nombre de requêtes en cas de besoins de débogage ou de sécurité.
- Les comptes, les communications, les équipements, l’utilisation, les adresses réseau et les informations de facturation sont traités conformément à la politique de confidentialité ; après la suppression d’un compte, les informations personnelles sont généralement supprimées au bout de 30 jours, sauf pour les archives légales, fiscales ou de sécurité.
Sécurité et conformité
DeepInfra affirme que ses mesures de sécurité sont conformes aux normes SOC 2 et ISO 27001, et qu’elle met en œuvre des mesures techniques et organisationnelles relatives au RGPD et à HIPAA. Les certifications et les contrôles ne garantissent pas automatiquement la conformité des applications des clients ; il reste nécessaire de vérifier les clauses contractuelles, le DPA, les modèles choisis ainsi que les exigences réglementaires selon la région avant de traiter des données sensibles liées à la santé, aux finances ou à d’autres domaines.
- Les tokens API doivent être stockés uniquement du côté serveur ou dans un système de gestion de clés, séparés par environnement et mis à jour régulièrement.
- Lors de la création d’un accès restreint pour les utilisateurs finaux, on peut utiliser des JWT avec une portée et une durée définies, afin d’éviter de délivrer un token de compte principal.
- Avant d’utiliser un modèle tiers, vérifiez où les données seront envoyées ; ne mettez pas en œuvre une règle de non-rétention universelle pour les exceptions explicitement énumérées.
- Définir des processus de contrôle d’accès et de suppression pour les journaux, les appels en retour et les fichiers par lots, afin d’éviter d’écrire des contenus sensibles des utilisateurs dans son propre système d’observabilité.
SDK, intégration et statut open source
- Le client officiel TypeScript deepinfra-node est sous licence MIT et prend en charge des interfaces natives pour le texte, les embeddings, les images, la voix et la classification.
- Le package Python deepinfra couvre l’inférence et les sandboxes ; la page README du dépôt actuel le décrit comme un SDK officiel, sous licence MIT.
- Le document fournit également des informations sur les moyens d’intégrer LangChain, LlamaIndex, le Vercel AI SDK, AutoGen, l’Anthropic SDK ainsi que divers frameworks d’agents.
- Ce qui est open source, c’est le client et une partie du code d’intégration ; cela ne signifie pas que la plateforme cloud DeepInfra, le système de planification ou les modèles hébergés soient tous open source ; chaque modèle tiers reste soumis à sa propre licence et à ses propres politiques d’utilisation.
Adéquation avec l’utilisateur et restrictions
- Développeur d’applications : accès rapide à plusieurs modèles tout en conservant des interfaces compatibles, mais nécessite des tests et des mécanismes de fallback en fonction des différences entre les modèles.
- RAG et équipes de recherche : combinaison d’incrustation, de réarrangement et de modèles de génération, avec optimisation des coûts par traitement par lots et mise en cache.
- Équipes avec des poids propres : l’utilisation de GPU privés offre isolation et latence stable, tout en entraînant des coûts de fonctionnement continus.
- Développeur d’agents : exécuter du code non fiable à l’aide de Sandbox, mais il faut intégrer dans la conception une durée de vie courte et des risques de perte de données.
- Les projets qui nécessitent une fixation absolue du comportement du modèle, des quotas gratuits permanents ou une absence totale de traitement par des tiers ne doivent pas se fier uniquement aux paramètres par défaut des dossiers partagés.
Questions fréquentes
DeepInfra dispose-t-elle d’une API gratuite permanente ?
Aucun forfait gratuit permanent ou limite mensuelle fixe valable pour tous les comptes n’a été confirmé pour le moment. Le solde promotionnel peut varier en fonction des offres et des comptes ; l’utilisation en production doit être estimée en fonction du prix unitaire en temps réel et de la facture réelle.
Peut-on utiliser directement l’SDK d’OpenAI ?
Oui, l’SDK OpenAI peut être réutilisé avec des interfaces compatibles pour la messagerie, le complétion de texte, l’incorporation de contenus et les images. Il reste cependant nécessaire de modifier l’adresse de base, le token DeepInfra et le nom du modèle, ainsi que de vérifier la compatibilité des paramètres.
DeepInfra conserve-t-il les prompts et les utilise-t-il pour l’entraînement ?
Les inférences ordinaires ne sont pas enregistrées, et les résultats sont supprimés après retour ; la plateforme affirme qu’elles ne sont pas utilisées pour l’entraînement. Il existe des exceptions pour les images, les traitements par lots ainsi que les modèles Google et Anthropic ; de faibles quantités de requêtes peuvent également être enregistrées dans des scénarios de débogage ou de sécurité.
Comment choisir entre l’inference partagée et le déploiement privé ?
En cas de fluctuations de trafic et lorsque le modèle est encore en phase d’évaluation, privilégiez le partage des inférences ; choisissez le déploiement privé lorsque des poids personnalisés, une isolation, des délais stables ou une capacité exclusive sont nécessaires, et surveillez en permanence les coûts de fonctionnement des GPU.
DeepInfra est-elle une plateforme open source ?
La plateforme cloud en tant que telle n’est pas un projet open source complet et public. Les clients officiels en Python et TypeScript, ainsi que certaines intégrations, sont soumis à des licences open source, tandis que les modèles hébergés respectent chacun leurs propres licences.
Pourquoi le traitement par lots est-il moins cher ?
Le traitement par lots permet à la plateforme d’planifier de manière asynchrone les requêtes non urgentes ; la documentation officielle indique une performance inférieure de 20 % par rapport au raisonnement en temps réel. Il n’est pas adapté aux réponses interactives et peut chiffrer temporairement les entrées et les résultats.
Résumé
L’avantage de DeepInfra réside dans le fait qu’un seul compte couvre les interfaces compatibles, les modèles multimodaux natifs, le traitement par lots, les poids privés, les GPU et les sandbox de code, tout en permettant de choisir la facturation en fonction de la charge de travail : par token, par volume d’exécution ou par heure GPU. Avant de mettre en production, il est essentiel de vérifier le prix et les licences par modèle, de définir des budgets et des plafonds de tentatives, ainsi que de gérer correctement les exceptions liées à l’absence de conservation des données.
Outils similaires à DeepInfra
 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164