




ResearchRabbit
Outil de recherche permettant de découvrir, d’organiser et de suivre la littérature académique à l’aide de diagrammes de relations
Étiquettes :Site d’apprentissage de l’IAQu’est-ce que ResearchRabbit ?
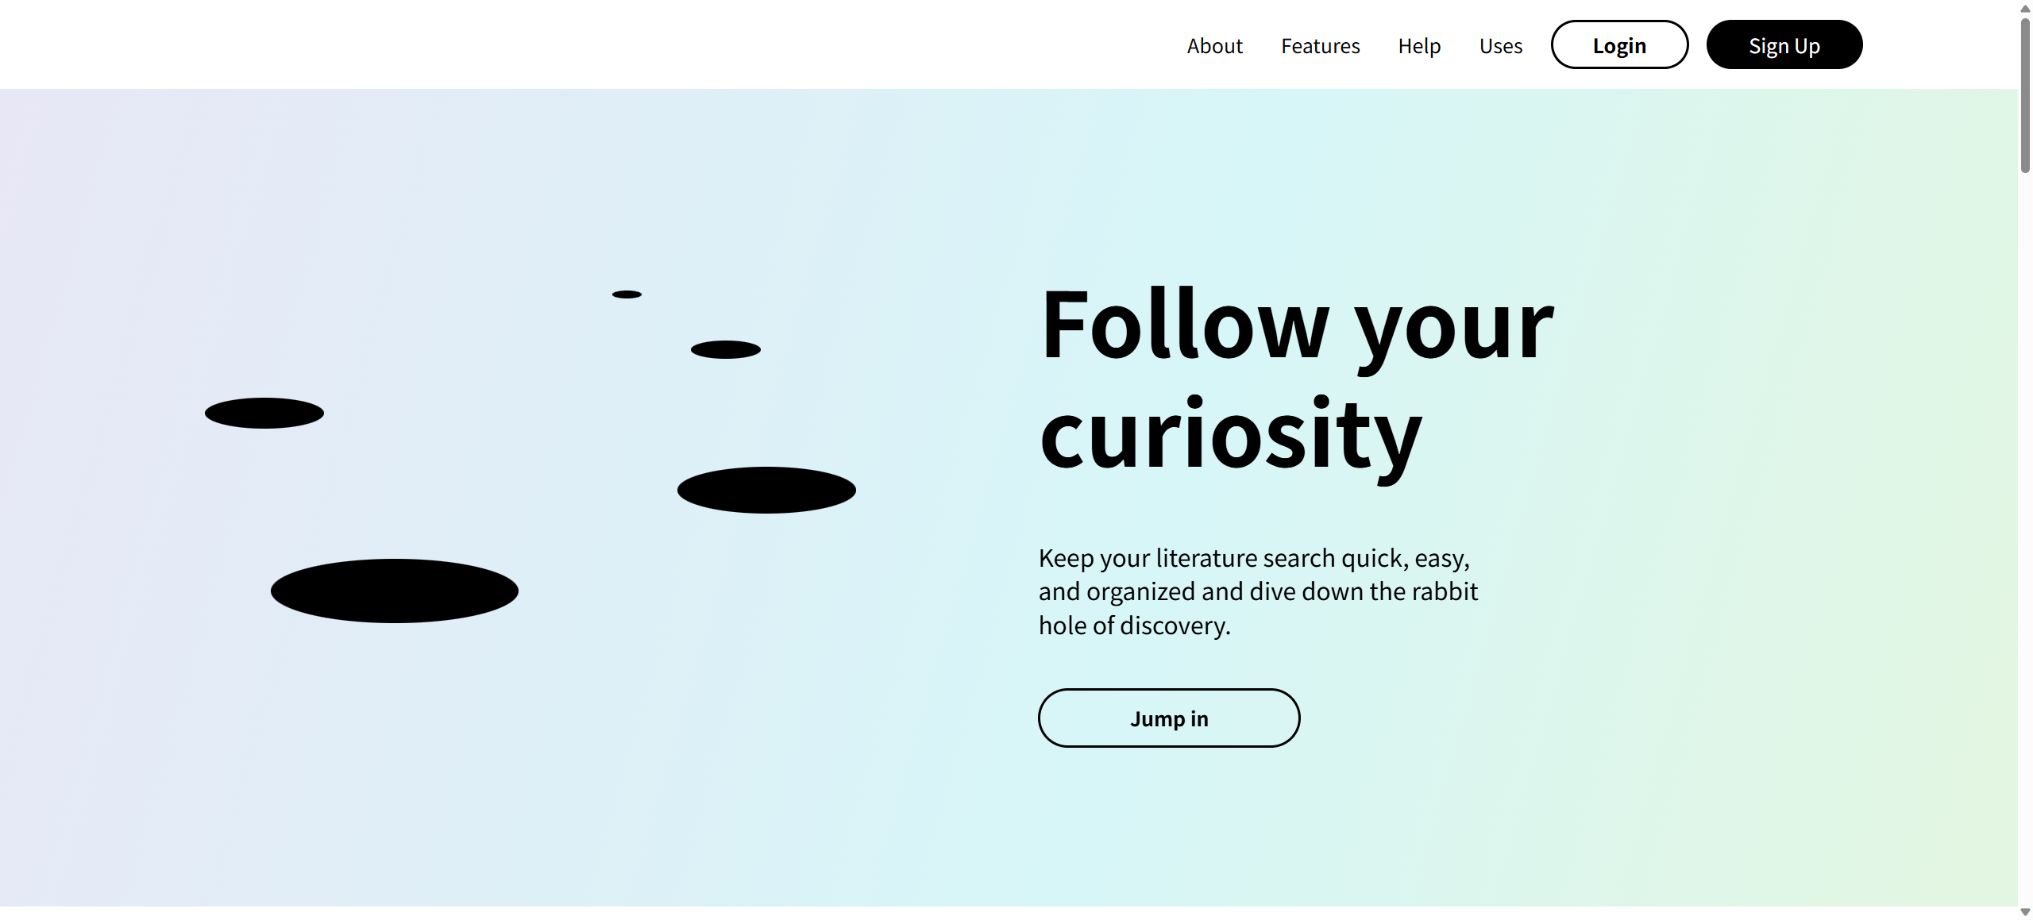
ResearchRabbit est un outil de découverte et de visualisation de la littérature académique destiné aux étudiants, aux chercheurs et aux équipes de revues systématiques. Il considère les articles comme un réseau de recherche interconnecté, permettant aux utilisateurs de partir d’un petit nombre d’articles connus pour s’étendre progressivement grâce aux citations, aux références, aux co-citations, aux auteurs et à des recherches similaires, au lieu de se limiter à une liste de résultats basée uniquement sur des mots-clés.
Il convient particulièrement à la phase de « boule de neige » après la recherche dans une base de données traditionnelle : il s’agit d’abord de trouver quelques articles de référence fiables, puis de retracer les recherches fondatrices antérieures, les articles qui les citent, les travaux sur des thèmes similaires et les auteurs clés, pour finalement conserver les résultats pertinents dans une collection et les exporter vers un logiciel de gestion bibliographique.
Comment ResearchRabbit utilise-t-il l’IA ?
Selon les explications officielles, l’algorithme de recommandation principal de ResearchRabbit ne dépend pas de modèles de langage de grande taille pour générer des réponses. La recherche par mots-clés, DOI et titre utilise des index précalculés ainsi que des méthodes graphiques, tandis que les recommandations ultérieures analysent les citations, les références, les co-citations, les citations partagées, ainsi que les relations entre auteurs et co-auteurs.
L’avantage de cette méthode est que les recommandations reposent sur des critères relativement transparents, et les résultats peuvent être vérifiés à partir des articles réels et de leurs relations en réseau, ce qui évite que les résumés génératifs n’inventent des articles ou des citations inexistantes. Elle utilise toujours des algorithmes pour apprendre le comportement d’exploration et de sauvegarde de l’utilisateur, mais son objectif principal est de découvrir la littérature, et non de remplacer le chercheur dans l’élaboration de ses conclusions.
Base de données de plus de 310 millions d’articles
Selon la documentation officielle actuelle, la base de données couvre plus de 310 millions d’articles académiques. Sa base de données comprend des sources de métadonnées académiques telles que Semantic Scholar, Crossref et OpenAlex, et son champ d’action est élargi grâce à une collaboration avec Litmaps.
Le grand nombre de bases de données ne signifie pas que toutes les entrées soient complètes. Certains articles peuvent manquer d’abstract, de références, de relations de citation ou d’informations normales sur les auteurs ; il peut également y avoir des erreurs de fusion entre auteurs portant le même nom.
ResearchRabbit fournit principalement des outils de découverte et des informations métadonnées, sans garantir que le texte intégral de chaque article soit téléchargeable.
Recherche par mots-clés, titre et DOI
Les utilisateurs peuvent entrer des mots-clés, des questions de recherche, des titres de articles ou des DOI pour commencer une recherche. Les résultats affichent des informations telles que le titre, l’auteur, l’année et le nombre de citations, ce qui permet de sélectionner en premier lieu de 1 à 3 articles fortement pertinents en tant que première série de références.
La recherche par mots-clés convient pour constituer un ensemble initial, mais la véritable valeur de ResearchRabbit réside dans l’exploration en ligne après avoir sélectionné des articles. Les revues systématiques devraient toujours concevoir des expressions booléennes reproductibles dans Web of Science, Scopus, PubMed, JSTOR ou des bases de données disciplinaires, puis utiliser ResearchRabbit pour compléter le suivi des citations.
Thèse de semence et découverte itérative
Les articles de référence constituent le point de départ pour les recommandations ultérieures. La version gratuite permet d’utiliser jusqu’à 50 articles de référence par utilisation, tandis que la version RR+ en permet jusqu’à 300 ; elle est adaptée à la recherche de sujets manquants, de thèmes transversaux et d’études marginales à l’aide d’un ensemble complet de filtrage initial.
La qualité des données de base influence directement les recommandations. Si l’on mélange des articles aux thèmes flous, aux méthodes différentes ou peu pertinents, les résultats peuvent s’éloigner du problème.
Une méthode plus fiable consiste à créer des ensembles de base petits et clairs par sous-thème, méthode ou question de recherche, à les examiner tour à tour et à les enregistrer.
Articles similaires
Similar Work recommande des travaux similaires en fonction des relations du corpus actuel au sein du réseau de recherche, permettant de découvrir des articles utilisant des termes différents mais ayant une structure de citation similaire. Pour la recherche interdisciplinaire, il complète souvent les documents manquants dus à une simple recherche par mots-clés.
La similitude ne signifie pas que les conclusions des études sont identiques. Les utilisateurs doivent encore consulter le résumé, les méthodes, l’échantillon, les sujets d’étude et le texte intégral ; ils ne peuvent pas considérer un article comme une preuve directement comparable simplement parce que ses diagrammes se trouvent à proximité.
Études initiales et études ultérieures
Early Work permet de retracer les travaux antérieurs cités dans une étude ainsi que les recherches fondatrices encore plus anciennes ; Later Work, quant à lui, examine les recherches qui ont cité cette étude par la suite.
Le suivi des citations forward et backward permet de comprendre comment les concepts se forment, comment les méthodes évoluent, et si une conclusion a par la suite été confirmée ou remise en question.
Les relations de citation pour les nouveaux articles nécessitent du temps pour se développer, et un faible nombre de citations peut simplement signifier qu’ils ont été publiés il y a peu. Lors de l’évaluation de l’influence, il convient de prendre en compte l’année de publication, les habitudes de citation dans le domaine, la revue ainsi que la qualité réelle de la recherche, et non pas de se baser uniquement sur le nombre de citations.
Graphique de références interactif
ResearchRabbit affiche les articles scientifiques en tant que nœuds, et les relations de citation en tant que liens, permettant ainsi de comprendre l’évolution de la recherche en fonction du temps et de son impact. Les utilisateurs peuvent observer des groupes thématiques, des articles de liaison, des auteurs clés et des lacunes dans la recherche, ce qui est plus intuitif que de naviguer article par article dans une longue liste.
Les cartes sont des outils d’exploration et de communication, et non des conclusions métriques strictes. La taille, la position des nœuds et le regroupement dépendent du choix actuel et de l’intégralité des données ;
Si l’image est intégrée dans un article, une affiche ou une présentation, il convient d’indiquer l’outil utilisé conformément aux exigences de l’éditeur.
Auteur et réseau de collaboration
En plus des liens entre articles, la plateforme permet également d’explorer les groupes de recherche en fonction des relations entre auteurs et co-auteurs, d’identifier les chercheurs clés qui publient régulièrement sur un sujet donné, et de consulter leurs travaux connexes. Cela est très utile pour trouver des mentors potentiels, des équipes de collaboration ou pour comprendre l’évolution d’un domaine.
La dédoublonnage des noms n’est pas toujours précis, en particulier pour les noms courants, les changements d’institution et les différentes orthographes. Lors de la citation formelle des travaux d’un auteur ou pour évaluer des recherches, il convient de vérifier à l’aide d’ORCID, de la page web de l’institution et du article original.
Collections et sous-ensembles
Les utilisateurs peuvent enregistrer les articles dans les Collections et les classer par théorie, méthode, expérience, chapitres à lire ou à écrire grâce aux Sous-collections. « Récemment trouvés » permet de conserver temporairement les articles découverts lors de la recherche, en attendant de les transférer dans des collections officielles après sélection.
Une collection n’est pas simplement un dossier de sauvegarde, elle peut également servir de critère de recherche. De bonnes limites de collection améliorent la qualité des recommandations ultérieures ;
Si un ensemble contient plusieurs sujets non liés, il est recommandé de le diviser et de rechercher séparément.
Notes, autocollants et couleurs
La plateforme permet de prendre des notes à côté des articles et d’établir un système de filtrage personnel à l’aide d’autocollants et de couleurs, par exemple pour marquer « inclure », « exclure », « nécessiter le texte intégral », « lié aux méthodes » ou « risque de biais ». Ces informations permettent de gagner du temps lors de la rélecture de l’article pendant l’étape d’écriture.
Les notes représentent les jugements de recherche personnels de l’utilisateur et ne remplacent pas les tableaux de extraction de données standardisés. La revue systématique doit également conserver les raisons d’exclusion, les dates de recherche, les bases de données, les expressions de recherche complètes ainsi que les enregistrements de traitement des doublons.
Partage de collections et collaboration d’équipe
La version gratuite permet d’inviter des collaborateurs, de définir des lecteurs ou des éditeurs, ainsi que de générer des liens d’accès public. La collection partagée inclut ses sous-collections et notes, ce qui la rend adaptée à la sélection collective par un groupe de travail, aux retours d’un tuteur ou au partage d’une liste de lectures avec des camarades.
Avant de partager, vérifiez que les notes ne contiennent pas d’idées non publiées, de contenu soumis à un examen par des pairs ou de données personnelles. Pour les projets sensibles, utilisez des invitations contrôlées et évitez de créer directement des liens publics.
Importation dans Zotero
ResearchRabbit propose un importateur Zotero. La première connexion nécessite une autorisation d’accès aux collections Zotero ; par la suite, il est possible de choisir des comptes, des collections et des articles spécifiques à importer dans ResearchRabbit, afin d’utiliser ces documents existants comme point de départ pour découvrir de nouveaux articles.
Selon les informations officielles actuelles, la connexion avec Zotero concerne principalement le processus d’importation ; ramener de nouvelles découvertes dans Zotero peut se faire par export en BibTeX.
La synchronisation bidirectionnelle fait toujours l’objet d’un développement continu ; il ne faut pas décrire les fonctionnalités existantes comme une synchronisation bidirectionnelle en temps réel.
Import/Export BibTeX, RIS et CSV
Les collections peuvent être exportées en BibTeX, RIS ou CSV, ce qui facilite leur migration vers Zotero, EndNote, Mendeley et d’autres outils de recherche. Les données d’EndNote et de Mendeley peuvent également être exportées en BibTeX avant d’être téléchargées sur ResearchRabbit.
Ce qui est exporté, ce sont les enregistrements bibliographiques et non le texte intégral protégé par le droit d’auteur. Après importation, il convient de vérifier le DOI, l’ordre des auteurs, les numéros de page, le volume et le numéro de la revue, ainsi que les caractères spéciaux, afin d’éviter que des métadonnées manquantes n’affectent la bibliographie finale.
Copier le format de citation
L’utilisateur peut choisir un style de citation dans le menu des articles et copier une citation formatée, afin de la partager rapidement ou d’en faire des notes temporaires. Pour les articles officiels, il est néanmoins recommandé de générer les citations de manière uniforme à l’aide d’un gestionnaire de références, puis de les vérifier en fonction des exigences de la revue et de la page de garde de l’article.
Utilisation de plusieurs langues
ResearchRabbit peut être utilisé pour rechercher des documents académiques dans différentes langues, et son interface offre également une option multilingue. Les utilisateurs chinois peuvent saisir des mots-clés en chinois ou importer des articles en chinois, mais la couverture réelle et le réseau de citations dépendent du fait que les fournisseurs de données incluent et fournissent des métadonnées normalisées.
Pour les revues chinoises de premier plan, les thèses et les données des bases de données locales, il convient d’utiliser en même temps des sources telles que CNKI, Wanfang, VIP ou les bases de données de l’établissement. ResearchRabbit ne peut pas remplacer une recherche complète dans les bases de données spécialisées en chinois.
Comparaison des prix et des versions
| Forfait ou version | Prix, plafonds et avantages clés |
|---|---|
| Qu’est-ce que la version gratuite comprend ? | Le prix de Free Forever est de 0 dollar et comprend actuellement des recherches illimitées, un accès illimité à des bases de données et des collections, la collaboration en temps réel, le téléchargement de documents dans les bases de données, la consultation de citations et d’articles similaires, des cartes de citations, des notes et des couleurs, ainsi que la recherche sur jusqu’à 50 articles de référence. La version gratuite suffit déjà pour effectuer une revue de littérature ciblée, et l’éditeur s’engage à maintenir cette version gratuite à long terme. Ses limitations résident principalement dans le nombre d’articles de référence pour les recherches volumineuses, dans les filtres avancés et dans la capacité d’isolation des projets, plutôt que dans le blocage des fonctionnalités clés des cartes. |
| Prix de ResearchRabbit+ | ResearchRabbit+ coûte 12,5 dollars par mois ou 120 dollars par an, soit 10 dollars par mois, ce qui représente une économie d’environ 20 % par rapport au paiement mensuel. Plus de 100 pays et régions, dont la Chine, peuvent obtenir des remises basées sur l’équivalence du pouvoir d’achat sur la page de mise à niveau ; les codes de réduction et les montants exacts doivent être consultés après connexion. RR+ est adapté aux grandes revues systématiques, aux projets de recherche parallèles multiples et aux utilisateurs ayant besoin d’un contrôle précis des recherches. Les frais de abonnement permettent de maintenir en fonctionnement la version gratuite, mais tous les chercheurs n’ont pas besoin de faire le passage à la version premium. |
Qu’est-ce que la version gratuite comprend ?
Le prix de Free Forever est de 0 dollar et comprend actuellement des recherches illimitées, un accès illimité à des bases de données et des collections, la collaboration en temps réel, le téléchargement de documents dans les bases de données, la consultation de citations et d’articles similaires, des cartes de citations, des notes et des couleurs, ainsi que la recherche sur jusqu’à 50 articles de référence.
La version gratuite est déjà suffisante pour effectuer une revue de littérature ciblée, et l’éditeur s’engage à conserver à long terme cette version gratuite. Ses limites résident principalement dans le nombre de points de départ pour les recherches volumineuses, les filtres avancés et la capacité d’isolation des projets, plutôt que dans le verrouillage des fonctionnalités fondamentales du graphe.
Prix de ResearchRabbit+
ResearchRabbit+ coûte 12,5 dollars par mois ou 120 dollars par an, soit 10 dollars par mois, ce qui représente une économie d’environ 20 % par rapport au paiement mensuel. Plus de 100 pays et régions, dont la Chine, peuvent bénéficier d’une remise basée sur l’équité de pouvoir d’achat sur la page de mise à niveau ; les codes de réduction spécifiques et les montants correspondants doivent être consultés après connexion.
RR+ convient aux grandes revues, aux projets de recherche parallèles multiples et aux utilisateurs qui ont besoin d’un contrôle précis de la recherche. La cotisation permet de maintenir en fonctionnement la version gratuite, mais tous les chercheurs n’ont pas besoin de passer à la version supérieure.
RR+Recherche avancée
La version payante offre un contrôle plus précis sur les mots-clés, les revues et les plages de dates, ce qui permet de rechercher des intersections thématiques, de se concentrer sur des domaines niche, d’exclure des branches non pertinentes et d’aider à vérifier les liens qui pourraient avoir été omis dans une revue systématique.
Le filtrage avancé améliore l’efficacité, mais ne peut pas prouver automatiquement que la recherche est complète. Une revue systématique doit toujours consigner toutes les conditions et le processus de filtrage, et au moins un chercheur doit vérifier les résultats clés.
RR+ plusieurs projets
Multiple Projects permet de gérer séparément les articles, les collections et les notes pour différents mémoires ou projets, évitant que les actions de sauvegarde d’un sujet n’affectent les recommandations d’un autre. Pour les utilisateurs qui rédigent plusieurs mémoires en même temps ou qui encadrent plusieurs projets, c’est plus clair que de stocker de nombreuses collections dans la même bibliothèque.
Étude des signaux d’intégrité et des rappels
La page de tarification RR+ liste les alertes Signals, destinées à fournir des informations relatives à l’intégrité de la recherche et à réduire le risque d’oublis. Ces signaux doivent servir de pistes pour des vérifications supplémentaires et ne peuvent pas remplacer directement les bases de données de retrait de publications, les notifications des revues ni l’évaluation manuelle de la qualité de la recherche.
Plan institutionnel
Institution propose des devis sur mesure, incluant les capacités RR+, des remises pour achats en gros, l’intégration avec les bibliothèques de recherche LibKey, la gestion des utilisateurs, des statistiques d’utilisation et un support exclusif. Lors des achats par des universités ou des instituts de recherche, il convient de vérifier les modalités d’authentification, les liens avec les collections, le traitement des données, le transfert des comptes et la portée de l’analyse d’utilisation.
La relation entre ResearchRabbit et la base de données
ResearchRabbit recommande officiellement son utilisation en combinaison avec les bases de données des bibliothèques. Les bases de données traditionnelles se distinguent par leur capacité à effectuer des recherches structurées, à indexer les disciplines, à fournir le texte intégral et à assurer des recherches reproductibles ;
ResearchRabbit excelle dans la découverte de réseaux, la visualisation et l’extension itérative à partir de articles existants.
Le flux de travail le plus fiable consiste d’abord à établir des recherches reproductibles dans une base de données spécialisée, puis à importer les articles pertinents ou clés dans ResearchRabbit pour effectuer des traçages avant-arrière, enfin à retourner sur les pages des collections de l’institution ou des éditeurs pour obtenir le texte intégral.
Est-il possible de télécharger le texte intégral de la thèse ?
ResearchRabbit affiche principalement les métadonnées des articles, les résumés et des liens d’accès externes ; ce n’est pas un téléchargeur de texte intégral permettant de contourner les barrières payantes. La disponibilité du texte intégral dépend de l’accès ouvert, de l’éditeur, de l’archivage de l’auteur ou d’une abonnement de l’institution à laquelle il appartient.
Lorsque l’on tombe sur un article payant, on peut le chercher à la bibliothèque de l’université, par prêt interbibliothécaire, via une version publique de l’auteur ou par des canaux légaux d’accès ouvert ; le fait que l’article soit retrouvé dans les résultats de recherche ne signifie pas pour autant qu’une autorisation d’accès au texte intégral a été obtenue.
Guide d’utilisation de ResearchRabbit
Terminer une tâche de base
- Définir le problème, la période, la région, la priorité des sources et le format de sortie ;
- Téléchargez des documents dont vous avez les droits d’utilisation ou saisissez une question de recherche dans ResearchRabbit ;
- Comment utiliser l’IA avec ResearchRabbit en premier lieu ? Créer un cadre, puis compléter par une base de données de plus d’un milliard d’articles scientifiques ;
- Il est nécessaire de distinguer les faits de source, les opinions de l’auteur et les inférences de l’IA ;
- Vérifier une par une les dates, les chiffres, l’emplacement dans le texte original et les preuves contradictoires ;
- Modifier manuellement les conclusions et enregistrer l’heure de vérification avant de les publier ;
Créer des flux de travail professionnels réutilisables
- Découper les sujets complexes en quatre catégories de questions : contexte, données, comparaisons et conclusions ;
- Comment ResearchRabbit utilise-t-il l’IA ? Une base de données de plus d’un milliard de articles, ainsi que la recherche par mots-clés, titres et DOI, forment des étapes de recherche standardisées.
- Privilégier les sites officiels, les articles scientifiques, les documents réglementaires et les données brutes ;
- Mettre en place une vérification par une deuxième personne pour les conclusions à haut risque ;
- Conserver les requêtes, les preuves, les versions et les problèmes non résolus ;
- Redémarrer après modification des données et mettre à jour les conclusions ;
Est-ce adapté à une revue systématique ?
- Il convient pour compléter le suivi des citations, détecter les omissions et comprendre les réseaux de recherche, mais ne doit pas servir de seule base de données pour une revue systématique ;
- Une dépendance exclusive aux algorithmes de réseau peut favoriser les recherches ayant un grand nombre de références, des métadonnées complètes ou des réseaux bien établis, tout en sous-estimant les travaux récemment publiés et la littérature provenant de régions peu connues.
- Une revue systématique doit s’accompagner d’un plan de pré-enregistrement, de plusieurs bases de données, de filtrages répétés, d’une évaluation de la qualité et d’un rapport PRISMA ;
- ResearchRabbit peut enregistrer le processus de découverte, mais il ne peut pas remplir automatiquement l’ensemble des exigences de conformité.
GitHub et l’état open source
La recherche principale de ResearchRabbit, les graphes, les applications Web et les algorithmes de recommandation ne sont pas des produits open source. L’organisation officielle GitHub ne met actuellement en ligne qu’une branche de client Python liée au service d’analyse Amplitude, sans publier le code source complet de la plateforme ResearchRabbit.
Les agents de recherche locaux, téléchargeurs et projets LangGraph nommés research-rabbit sur GitHub sont pour la plupart des produits tiers ou d’autres solutions, sans rapport avec cet outil de graphe d’ citations académiques. Le catalogue doit être marqué comme SaaS à code fermé ; on ne peut pas en déduire qu’il est possible de le déployer en mode privé à partir d’un dépôt du même nom.
À qui s’adresse-t-il ?
- Étudiants en train de préparer un mémoire de cours, une thèse de licence et une thèse de doctorat ;
- Les chercheurs qui mènent des revues narratives, des revues de portée ou des revues systématiques ;
- Il est nécessaire de trouver des articles fondateurs, les dernières publications et des équipes ayant des liens interdisciplinaires ;
- Utilisateurs qui gèrent leurs références avec Zotero, EndNote ou Mendeley ;
- Équipes de projet qui doivent partager la liste de lectures et les notes avec leurs mentors et collaborateurs ;
- Enseignants souhaitant présenter le fil conducteur de la recherche et le réseau des auteurs à l’aide de cartes.
Avantages du produit
- La version gratuite conserve toutes les fonctionnalités essentielles de découverte de documents et de cartographie ;
- Une base de données de plus de 310 millions d’articles couvrant un large éventail de sujets ;
- En citant Internet, on peut trouver différentes études pertinentes exprimant des mots-clés ;
- Les recommandations principales ne dépendent pas de la génération de contenu par des grands modèles de langage ;
- Prend en charge les collections, les notes, la collaboration et le partage public ;
- Intégration possible avec les flux de travail de recherche Zotero et BibTeX.
Restrictions et précautions
- Les métadonnées, les citations et la résolution des ambiguïtés concernant les auteurs peuvent être incomplètes, et les recommandations peuvent également être affectées par les biais des articles de référence ;
- Il ne peut pas garantir l’accès au texte intégral, l’intégrité de la recherche, la qualité des articles ou l’exactitude des citations ; les informations importantes doivent être vérifiées dans l’article original et dans les bases de données spécialisées.
- La version gratuite permet jusqu’à 50 semences par utilisation, et bien que RR+ ait été porté à 300 semences avec un filtrage supplémentaire, il ne s’agit toujours pas d’un outil d’analyse systématique automatique.
- Avant de partager publiquement la collection, il faut vérifier les notes et les informations de recherche non publiées ;
Questions fréquentes
ResearchRabbit est-il gratuit ?
Il existe une version gratuite permanente, comprenant des recherches illimitées, des collections illimitées, un atlas de citations, des fonctionnalités collaboratives et jusqu’à 50 articles de référence, suffisants pour mener à bien la plupart des recherches ciblées sur la littérature.
Combien pour RR+ ?
12,5 dollars par mois, 120 dollars par an, soit 10 dollars par mois en tarif annuel. Les pays et régions éligibles tels que la Chine peuvent consulter les remises sur la page de mise à niveau après s’être connectés.
ResearchRabbit utilise-t-il l’IA pour générer des résumés de articles ?
La recommandation principale est de ne pas utiliser de grands modèles de langage, mais de s’appuyer sur les citations, les co-citations, ainsi que les réseaux d’auteurs et de co-auteurs. Les résumés et les métadonnées proviennent de sources de données académiques, mais il reste nécessaire de vérifier le texte original.
Peut-on le synchroniser avec Zotero ?
Il est actuellement possible d’autoriser l’importation de collections Zotero, et d’importer les nouvelles découvertes dans Zotero via BibTeX ; une synchronisation bidirectionnelle complète, comme indiqué dans la documentation officielle, est encore en cours de développement.
Peut-il remplacer Google Scholar, PubMed ou Web of Science ?
Non. Il convient de l’utiliser pour compléter la découverte de ressources en ligne et le suivi des citations, et doit être associé aux bases de données bibliographiques et disciplinaires.
ResearchRabbit est-il open source ?
Pas de code source open source. GitHub officiel ne met pas en ligne le code source complet des fonctionnalités de recherche, de cartographie et de recommandation ; les dépôts tiers du même nom ne sont pas des produits officiels.
Outils similaires à ResearchRabbit
 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164