




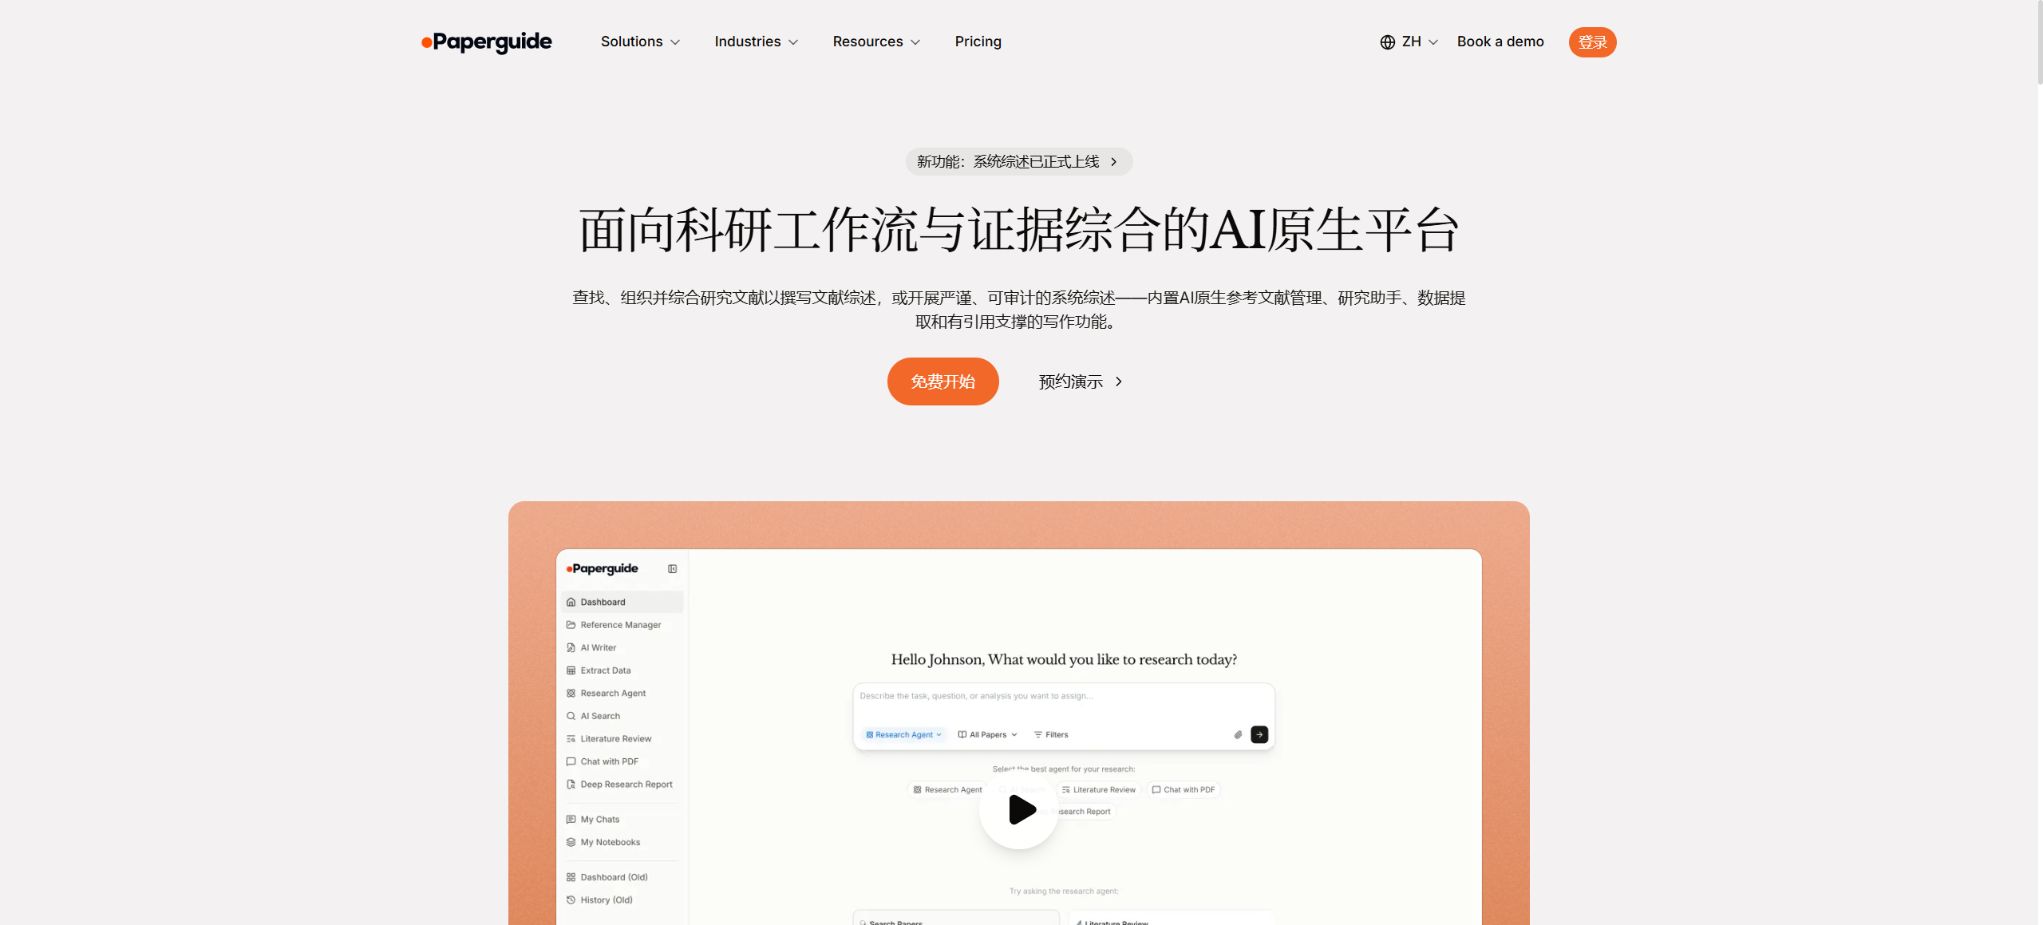
Paperguide
Tableau de travail d’IA pour la recherche sur les découvertes, la lecture, les notes, les citations et les revues systématiques
Étiquettes :Site d’apprentissage de l’IAQu’est-ce que Paperguide ?
Paperguide est une plateforme de recherche IA intégrée destinée aux étudiants, enseignants, chercheurs et équipes de R&D, qui regroupe la découverte d’articles, la lecture intégrale, la gestion des références, l’extraction de données, les revues systématiques et l’écriture académique dans une même zone de travail. Les utilisateurs peuvent soit effectuer des recherches parmi plus de 200 millions d’articles académiques, soit importer leurs propres PDF et références, pour ensuite utiliser Research Agent afin d’analyser, organiser et générer des résultats de recherche avec des citations.
Jusqu’à cette vérification, les fonctionnalités principales de Paperguide comprennent AI Search, Research Agent, Literature Review, Deep Research Report, Chat with PDF, Systematic Review, Extract Data, Reference Manager.
AI Writer, espaces de travail d’équipe, API de recherche et MCP.
Il s’agit d’un produit exclusif au cloud, et l’application principale ne dispose pas de version open source pouvant être déployée localement.
Fonctionnalités clés
1. Recherche de articles sur la recherche par IA
La recherche par IA permet de rechercher à l’aide de questions de recherche, de thèmes, de titres de articles ou de descriptions en langage naturel. Par défaut, elle recherche parmi plus de 200 millions d’articles provenant de sources telles que PubMed, arXiv, OpenAlex et Semantic Scholar, et il est également possible de se limiter à PubMed, arXiv ou à son propre Reference Manager.
Le résultat n’est pas simplement une liste de liens, mais une réponse avec des citations basée sur des articles hautement pertinents, ainsi que jusqu’à 20 documents de référence importants.
L’édition gratuite offre 20 recherches AI par mois, tandis que les versions Plus et supérieures en offrent un nombre illimité. AI Search ne recherche que dans des corpus académiques, et non sur des pages web ordinaires, des blogs ou Internet ouvert.
Lorsque des nouvelles du secteur, des annonces réglementaires ou des informations sur les entreprises sont nécessaires, il convient d’utiliser des bases de données appropriées ou des sources officielles.
2. Agent de recherche et revue de la littérature
L’Agent de recherche peut effectuer des recherches en plusieurs étapes autour d’une question, comparer les méthodes et les conclusions de recherche, et identifier des cohérences, des contradictions et des lacunes dans les preuves. Il peut travailler sur 200 millions d’articles, ou n’analyser que les documents situés dans l’espace de travail de l’utilisateur.
Chat with PDF et Literature Review partagent désormais une architecture d’Agent unifiée avec Research Agent, permettant aux utilisateurs de poursuivre leurs recherches, de lire des articles et de compiler des revues de littérature.
L’Agent d’analyse de la littérature peut d’abord définir un protocole, puis générer des synthèses thématiques et des citations à partir de jusqu’à 50 articles. Le Rapport de recherche approfondie convient aux tâches qui souhaitent observer et contrôler davantage d’étapes de recherche.
Les revues générées par l’IA restent des drafts de recherche ; il ne faut pas omettre de vérifier manuellement la conception de la recherche, le niveau de preuve, les échantillons répétés et l’exactitude des citations.
3. Chat with PDF
Après avoir téléchargé un PDF, l’utilisateur peut demander des informations sur les méthodes, des exemples, des résultats, des limites ou l’endroit où apparaît une phrase donnée. Le système propose un lecteur intégré et des références au niveau de chaque page, permettant une lecture approfondie d’un seul article ou une comparaison entre plusieurs articles.
En cas de questions du type « Où cela a-t-il été dit ? », l’endroit correspondant dans le texte original est renvoyé pour faciliter la vérification.
Les scans, les formulaires complexes, les formules, les pièces jointes supplémentaires et un OCR de faible qualité peuvent affecter l’analyse. Pour les données clés telles que l’amplitude de l’effet, les intervalles de confiance, la dose, les événements indésirables et la significativité statistique, il convient d’ouvrir la page originale pour vérification, et non de se contenter de copier les réponses du chat.
4. Extraction structurée des données
Extract Data permet de regrouper plusieurs articles en un livre de travail. Une fois que l’utilisateur définit les champs, l’IA peut extraire en masse le nombre d’échantillons, la conception de l’étude, l’intervention, les résultats, les effets et les limites, et associer les sources aux résultats.
La version gratuite traite un maximum de 10 documents par fois, avec 5 colonnes par tableau ; Plus et les versions supérieures permettent jusqu’à 100 documents et 50 colonnes par fois. Pro, Max et Enterprise prennent en charge en plus l’extraction d’images et de tableaux.
Les champs doivent être formulés comme des instructions précises, plutôt que se limiter à des étiquettes générales telles que « résultat » ou « méthode ». Il est préférable de définir séparément le point final, les points temporels, les unités et les règles pour les valeurs manquantes, afin que le chercheur puisse effectuer un échantillonnage ou une vérification item par item.
5. Revue systématique PRISMA
Paperguide propose une revue systématique complète en six étapes : Protocole, Articles, Filtrage des titres et résumés, Filtrage du texte intégral, Extraction des données et Rapport. L’IA élabore les critères d’inclusion et d’exclusion ainsi que les champs à extraire à partir de la question de recherche, effectue les recherches et le filtrage, fournit des preuves pour chaque critère, et génère un compte rendu des méthodes ainsi qu’un diagramme de flux PRISMA.
Chaque étape doit être vérifiée par une personne désignée avant de pouvoir passer à l’étape suivante.
Lors de l’étape de résumé du titre, on peut indiquer Include, Exclude ou Maybe ; lors de l’étape du texte complet, il est nécessaire de lire le PDF et de prendre une décision d’inclusion ou d’exclusion binaire. Les articles ne disposant pas du PDF seront marqués comme non obtenus et pris en compte dans l’évaluation des critères PRISMA.
Tous les jugements de l’IA, les corrections manuelles, les snapshots de protocole et les actions des membres laissent des traces d’audit ; un article peut être retracé depuis sa source d’ajout jusqu’au résultat final.
Plus permet un maximum de 1000 articles par revue systématique, Pro un maximum de 5000 articles, Max un maximum de 10000 articles, et Enterprise un maximum de 20000 articles ; Max et Enterprise offrent un filtrage par double évaluation de niveau PRISMA.
Le système permet d’exporter en BibTeX, RIS et CSV à différentes étapes ; les tableaux extraits peuvent être analysés plus en détail, et le rapport final peut être exporté en PDF et DOCX.
La faisabilité d’audit ne signifie pas qu’une publication est automatiquement assurée. Les chercheurs doivent encore pré-enregistrer leur protocole, concevoir des requêtes multi-bases de données, traiter la littérature grise, évaluer les risques de biais et la certitude des preuves, et valider manuellement chaque étape clé.
Les autorités ont également clairement qualifié le rapport final de brouillon à peaufiner, et non de thèse achevée.
6. Reference Manager
Le gestionnaire de références prend en charge les dossiers, les étiquettes, les notes et la collaboration ; il permet d’importer depuis Zotero, Mendeley ou DOI, et peut également enregistrer les résultats de recherche et des PDF. Les articles stockés dans la base de données peuvent être directement appelés par Agent, les outils d’extraction et AI Writer, ce qui réduit le besoin d’exporter fréquemment entre des logiciels de recherche, de chat et d’écriture.
La version gratuite offre 500 MB de stockage, tandis que les plans payants indiquent un stockage illimité des références, mais il convient néanmoins de respecter la politique d’utilisation raisonnée et les restrictions liées aux droits d’auteur. Paperguide ne doit pas être le seul système de sauvegarde ; les projets importants doivent être exportés régulièrement en format BibTeX, RIS, CSV et PDF original.
7. AI Writer et citations automatiques
L’AI Writer peut générer des brouillons en fonction d’une question de recherche ou d’un plan personnalisé, et il peut réécrire, développer, condenser, améliorer le style et vérifier la grammaire du texte sélectionné. Il peut citer des documents de l’espace de travail ou des articles de la plateforme, et passer entre plus de 1000 styles de citation, tout en gérant automatiquement les citations dans le corps du texte et la liste des références.
Le contenu généré appartient à l’utilisateur, mais les mentions académiques, la divulgation de l’IA et les règles de détection des doublons sont déterminées par l’établissement, la revue et les organismes de financement. Les références doivent être vérifiées une par une pour l’auteur, le titre, l’année, le DOI et les relations de soutien réelles ; on ne doit pas sauter cette vérification sous prétexte que le système affirme qu’il « n’invente pas de citations ».
8. Organisation d’équipe et Workspaces
La structure d’équipe mise en place en 2026 comprend l’Organisation, l’espace personnel, les espaces privés au sein de l’organisation et des espaces de travail partagés. Les équipes peuvent partager des bases de données, des documents collaboratifs, extraire des données ensemble et effectuer des revues systématiques, tout en contrôlant l’accès grâce aux rôles Owner, Admin, Member et aux permissions des espaces de travail.
Deux postes ou plus permettent de créer des espaces de travail organisés et collaboratifs, et l’administrateur peut consulter la consommation et gérer les postes.
9. Extensions Chrome et collections institutionnelles
Les extensions Chrome permettent de sauvegarder des documents provenant de revues, d’articles ou de pages web ordinaires dans Reference Manager, de sélectionner des dossiers et de poser des questions à l’IA. La page des prix cite également « l’accès aux articles des bibliothèques institutionnelles via une extension de navigateur » parmi les fonctionnalités de chaque option.
La possibilité d’accéder au texte intégral dépend toujours des abonnements de l’institution à laquelle appartient l’utilisateur, des paramètres d’agent et des droits du éditeur.
10. API de recherche et MCP
L’API de recherche offre une recherche mixte sémantique et par mots-clés, renvoyant l’auteur, le DOI, le résumé, BibTeX, des liens PDF et des données de citation, et prend en charge le filtrage par année, discipline, qualité de la revue et accès ouvert. Gratuit : 10 recherches par mois, 5 par minute ;
Plus : 100 fois par mois, 15 fois par minute ; Pro : 500 fois par mois, 30 fois par minute.
La page de tarification indique 1500 utilisations par mois pour Max.
Enterprise est facturé à l’usage ; la documentation officielle indique actuellement 0,01 dollar par opération, avec un maximum de 50 articles par fois.
MCP permet à des assistants IA externes de rechercher des articles et de lire leurs détails, en utilisant les AI Credits partagés du compte : 10 Credits par recherche, 2 Credits pour lire les détails d’un article ; aucune charge n’est facturée en cas d’échec de la requête. Les développeurs doivent placer la clé API du côté serveur, et ne pas l’inclure dans les pages web ou les applications mobiles.
Comment calculer les AI Credits ?
La revue systématique, la recherche approfondie, l’extraction de données, les conversations avec l’agent de recherche, la génération et l’édition par l’auteur, ainsi que MCP consomment tous des AI Credits. Le montant est renouvelé mensuellement à chaque date de facturation, et la consommation réelle dépend du nombre de documents, de la longueur du contenu, du nombre de champs et de la complexité de la tâche.
Selon les estimations officielles, 12 500 Credits de Plus permettent d’effectuer environ 15 à 17 revues de littérature par mois, ou d’extraire 10 champs à partir de 300 à 400 articles ; 50 000 Credits de Pro permettent d’en faire environ 60 à 70, ou d’extraire 1 200 à 1 600 articles de même ampleur.
Ce qui précède est un exemple et non une garantie ; pour un projet officiel, il convient d’abord d’estimer à l’aide d’un petit échantillon.
Prix et forfaits
Voici le prix en dollars par an affiché sur le site officiel lors de cette vérification, calculé par siège ; les options de paiement mensuel, les taxes et la monnaie locale sont indiqués sur la page de règlement.
| Forfait ou version | Prix, plafonds et avantages clés |
|---|---|
| Free | Gratuit, 1000 crédits AI par mois, 20 recherches AI, 500 MB d’espace de stockage pour les documents, extraction de 10 articles et 5 colonnes par opération, 10 appels à l’API de recherche ; inclut des questions-réponses en PDF, un éditeur AI, des rapports, l’importation depuis Zotero/Mendeley et plus de 1000 styles de citation. |
| Plus | Le paiement annuel équivaut à 17 dollars par siège et par mois, soit 204 dollars pour l’année ; 12 500 crédits par mois, 1 000 revues systématiques, recherche AI et stockage de documents illimités, extraction de 100 articles et de 50 colonnes à chaque fois, 100 appels API. |
| Pro | 39 dollars par siège et par mois, soit 468 dollars pour l’année ; 50 000 crédits par mois, 5 000 revues systématiques, extraction d’images et de tableaux, 500 appels API. |
| Max | 119 dollars par siège et par mois, soit 1428 dollars pour l’année ; 150 000 crédits par mois, 10 000 revues systématiques, filtrage par double évaluation, gestion d’équipe et 1 500 appels API. |
| Enterprise | Demande de prix ; crédits personnalisables, jusqu’à 20 000 revues systématiques, double évaluation, capacités d’équipe et de sécurité ainsi que quota API personnalisable. |
Les pages de tiers peuvent encore afficher des forfaits anciens tels que Starter, Advanced, 12 dollars ou 24 dollars, qui ne correspondent pas à la structure actuelle du site officiel : Free, Plus, Pro, Max. Lors de l’achat, il convient de se référer aux prix indiqués sur le site officiel et au montant final à payer.
Données, vie privée et propriété
Les conditions officielles stipulent que l’utilisateur conserve la propriété des fichiers, des indications et des documents qu’il télécharge ; Paperguide n’obtient qu’une autorisation limitée pour traiter, stocker et afficher ces contenus aux fins de fournir le service, ne vend pas les données des utilisateurs et ne les utilise pas pour entraîner des modèles d’IA publics ou généraux.
Les résumés, analyses et résultats générés par l’IA appartiennent à l’utilisateur.
Cela ne signifie pas que l’on peut télécharger des publications non autorisées, des données de patients ou des secrets commerciaux. Les utilisateurs institutionnels doivent toujours vérifier le lieu de stockage des données, les sous-traitants, la suppression et les sauvegardes, les certifications de sécurité ainsi que les clauses du contrat, et respecter les licences relatives à la base de données.
GitHub et l’état open source
L’audit effectué n’a pas révélé de dépôt GitHub open source officiel, clairement lié depuis le site web et capable de représenter l’ensemble du produit Paperguide. L’application Web principale, l’index des articles, Agent, Writer ainsi que la revue systématique sont tous des services propriétaires cloud, sans version communautaire auto-hébergée officielle.
Les projets du même nom sur GitHub, les bots de crawl ou les intégrations tierces ne peuvent pas être considérés comme des sources de code officielles.
Guide d’utilisation de Paperguide
Terminer une tâche de base
- Définir les tâches de codage à accomplir dans Paperguide, la portée du dépôt et les critères d’acceptation ;
- Connectez ou importez le projet de test, et faites d’abord une sauvegarde de la branche actuelle ;
- D’abord, utilisez la recherche par IA pour générer un plan de recherche de documents, puis vérifiez les fichiers à modifier ;
- Appliquer de légères modifications à l’aide de Research Agent et d’une revue de la littérature ;
- Exécuter des tests, des vérifications statiques et la compilation ; ne pas accepter directement de code non vérifié.
- Vérifier manuellement les droits, les clés, les dépendances et gérer les exceptions avant de fusionner ;
Créer des flux de travail professionnels réutilisables
- Choisir un projet réel à faible risque comme modèle ;
- Fixer l’ordre d’utilisation de la recherche de thèses par IA Search, du Research Agent et de la revue de littérature, ainsi que du Chat with PDF ;
- Enregistrer l’environnement, le modèle, les indications et les conditions d’échec ;
- Définir une approbation manuelle pour les actions d’écriture, de déploiement et de suppression ;
- Comparer la vitesse, le coût, le taux de réussite des tests et le volume de rétravail ;
- Vérifiez la stabilité avant de l’étendre à l’équipe ou à l’environnement de production ;
À qui s’adresse-t-il ?
- Étudiants et chercheurs qui doivent passer de la recherche à la rédaction de citations ;
- Équipe chargée de la revue de la littérature, de la revue de l’étendue et de la méta-analyse selon le système PRISMA ;
- Chercheurs en sciences médicales ou sociales qui extraient en masse les méthodes, les échantillons et les résultats des articles ;
- Utilisateurs souhaitant intégrer des données Zotero et Mendeley à une analyse par IA ;
- Laboratoires et institutions ayant besoin d’une bibliothèque de documents partagée, d’une rédaction collaborative et de registres d’audit ;
- Développeurs qui créent des flux de travail de recherche de thèses via API ou MCP.
Restrictions et précautions
- 200 millions d’articles représentent l’ampleur du corpus agrégé, ce qui ne signifie pas que tous les articles disposent d’un texte complet ;
- Les revues chinoises, les thèses, les bases de données payantes et la littérature grise pourraient être insuffisants ;
- Une revue formelle doit compléter les bases de données disciplinaires et conserver des requêtes reproductibles ;
- L’IA peut interpréter incorrectement les PDF, confondre les objets d’étude, omettre des mots négatifs ou produire des généralisations excessives ;
- Les décisions liées à l’IA dans la revue systématique doivent être vérifiées par un humain, et l’extraction des données doit reprendre le texte original ;
- Lors de la publication dans des domaines médicaux, politiques ou de recherche, il est également nécessaire d’évaluer les risques de biais, ainsi que le niveau statistique et la qualité des preuves ;
- AICredits, le nombre de revues systématiques et les requêtes API sont des limites distinctes ; il ne faut pas se fier uniquement à une « recherche illimitée ».
- Les projets à grande échelle sont également affectés par le temps de récupération et de traitement du PDF, les places disponibles pour l’équipe et les politiques d’utilisation raisonnée.
Questions fréquentes
Paperguide est-il gratuit ?
Il existe une version gratuite offrant 1000 crédits par mois, 20 recherches IA, 500 MB de stockage et 10 appels API, permettant d’essayer les fonctionnalités de Q&R PDF, d’écriture, de rapport et de gestion de documents.
Est-ce que c’est compatible avec le chinois ?
Le chinois mandarin est pris en charge comme langue générée par l’IA ; Writer, les questions-réponses PDF, la revue de littérature, la recherche IA et l’extraction de données peuvent générer du texte en chinois. La couverture des documents en chinois dépend toujours des sources d’indexation.
Peut-on faire une revue systématique ?
Oui, il couvre les protocoles, la collecte des articles, le filtrage des résumés et du texte intégral, l’extraction, la rédaction de rapports et le diagramme PRISMA, tout en conservant les vérifications manuelles et les traces d’audit. La version gratuite ne comprend pas une revue systématique complète ; elle est disponible en version Plus et supérieures.
Est-ce que cela prend en charge Zotero et Mendeley ?
Prend en charge l’importation, et permet également de créer une bibliothèque de documents via des DOI, des extensions de navigateur et les résultats de recherche.
Des API et MCP sont-ils disponibles ?
Fourni. L’API de recherche alloue des requêtes mensuelles et des débits selon le plan ;
MCP utilise le même pool d’AI Credits : 10 Credits pour la recherche, 2 Credits pour lire les détails.
Paperguide est-il open source ?
Pas de code source ouvert. Aucun code source officiel complet ni version auto-hébergée n’a été trouvé ; le produit est utilisé via des pages web en ligne, des extensions, des API et MCP.
Outils similaires à Paperguide
 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164