




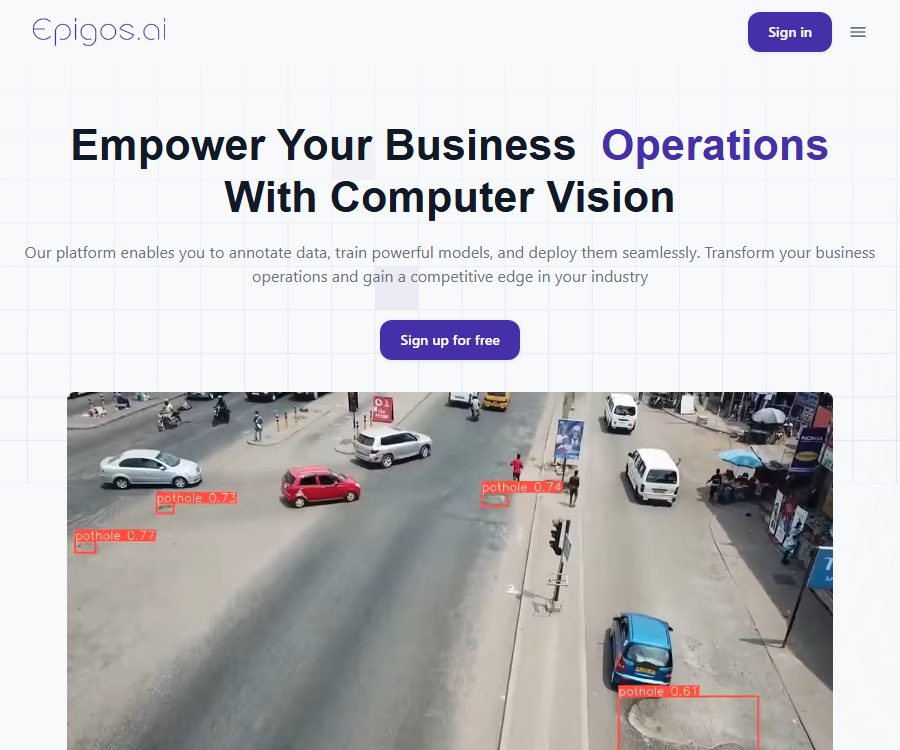
epigos.ai
epigos.ai, pour faire fonctionner les modèles d’IA de manière plus efficace et plus simple
Étiquettes :Modèle d’entraînement d’IAQu’est-ce que Epigos AI ?
Epigos AI est une plateforme de vision par ordinateur du début à la fin gérée par Epigos LTD, une entreprise enregistrée au Royaume-Uni. Elle aide les équipes à organiser des images brutes en ensembles de données étiquetés, à entraîner des modèles de classification d’images ou de détection d’objets, puis à les mettre en œuvre via des pages web, des API, des SDK ou des dispositifs edge.
Le produit s’adresse aux entreprises, développeurs et équipes de données qui souhaitent raccourcir le cycle de développement des projets de vision par ordinateur. La plateforme offre des GPU gérés et des workflows de visualisation, mais il reste nécessaire que l’utilisateur définit des étiquettes métier, prépare des exemples fiables et vérifie si le modèle répond aux exigences réelles.
Aperçu des fonctions principales
| Phase | Fonction principale | Entrée | Sortie |
|---|---|---|---|
| Préparation des données | Téléchargement, filtrage, séparation et gestion des versions | Fichiers d’image et définitions de labels | Version du jeu de données entraînable |
| Annotation des données | Classification, boîtes de délimitation, annotation automatique et révision | Images, catégories et descriptions des étiquettes | Étiquettes de catégorie ou boîtes cibles |
| Entraînement du modèle | Gestion de GPU, bibliothèque de modèles et tâches d’entraînement | Version du jeu de données et configuration d’entraînement | Modèles de classification ou de détection |
| Évaluation du modèle | Indicateurs, courbes d’entraînement et raisonnement par exemple | Résultats de l’entraînement et images de test | Précision, mAP, précision et rappel |
| Déploiement | Points d’entrée de gestion, pages web, SDK et téléchargement de modèles | Modèle entraîné | Résultats de prédiction ou fichiers de modèles déployables |
| Services professionnels | annotation de données artificielles et intégration sur mesure | Données du projet et exigences de qualité | Étiquettes ou plans de mise en œuvre examinés |
Espace de travail, projets et équipes
Après l’inscription, il est nécessaire de créer d’abord un espace de travail, puis de mettre en place un projet de vision par ordinateur à l’intérieur de cet espace. L’espace de travail sert à gérer de manière centralisée les membres, les projets, les clés API, les abonnements, la consommation des ressources et les droits d’accès.
- Inscrivez-vous par e-mail ou avec un compte Google et accédez au tableau de bord.
- Créer des projets indépendants pour différents équipes, clients ou scénarios commerciaux.
- Définir le nom du projet, son usage, le type de modèle, les étiquettes et les instructions d’annotation.
- Voir dans la zone de travail la consommation d’espace de stockage, d’entraînement, d’inference et d’autres quotas.
- Invitez des membres à collaborer selon un forfait, le nombre maximal de membres varie en fonction du plan.
Les projets d’une même zone de travail peuvent contenir des images de clients, des échantillons de production et des fichiers de modèles. L’administrateur doit attribuer aux membres des clés API avec les droits minimaux nécessaires, et révoquer l’accès en temps opportun en cas de départ ou de fin du projet.
Gestion des ensembles de données
Epigos AI permet aux utilisateurs de télécharger des lots d’images depuis leur ordinateur, puis de les visualiser, de les trier, de les filtrer et de les diviser. La documentation de démarrage rapide actuelle précise clairement que la fonction de téléchargement prend en charge les formats d’images ; par conséquent, d’autres types de médias mentionnés dans des articles marketing anciens ne doivent pas être considérés comme des formats d’entrée validés.
- Téléchargement par lots : Importer en groupe les images d’une même scène ou d’une même tâche de collecte.
- Filtrage des données : rechercher les échantillons en attente de traitement et ceux déjà étiquetés par état, tag ou lot.
- Séparation des données d’entraînement : diviser les données en sous-ensembles d’entraînement, de validation et de test pour réduire le fuitage de données d’évaluation.
- Contrôle de version : conserver des versions du jeu de données pour différentes annotations et séparations, afin de faciliter la reproductibilité des expériences.
- Vérification de la qualité : détection de labels manquants, erronés ou incohérents avant l’entraînement.
- Amélioration des données : augmentation des échantillons d’entraînement par des transformations, mais ces méthodes doivent correspondre à l’environnement de déploiement réel.
Tâches de modèle prises en charge
| Tâche | Mode de notation | Sortie du modèle | Scénarios adaptés |
|---|---|---|---|
| Classification d’images | Sélectionner une catégorie pour toute l’image | Catégorie de prédiction et niveau de confiance | Classification des produits, archivage d’images, reconnaissance d’état |
| Détection de cible | Dessiner une boîte de délimitation autour de la cible dans l’image et sélectionner la catégorie | Catégorie cible, confiance, position et taille | Détection de défauts, comptage, localisation d’objets et surveillance |
La segmentation sémantique, les points clés, le suivi vidéo et la vision 3D ne sont pas explicitement listés comme types de projets standard dans le document de création du projet actuel. Lorsque ces tâches sont nécessaires, il convient de consulter d’abord l’équipe ; il n’est pas approprié de faire des déductions en se basant uniquement sur le nom de la plateforme de vision par ordinateur.
Annotation d’images
L’interface de marquage affiche les images à traiter et les catégories prédéfinies ; une fois que l’utilisateur a sélectionné une catégorie ou tracé un cadre cible et soumis sa demande, le système passe automatiquement à l’image suivante. Des définitions de labels claires et des règles de délimitation sont plus importantes que simplement accélérer le processus de marquage.
- Définir dans le projet des catégories qui ne se chevauchent pas et qui ont une signification métier.
- Rédiger des descriptions annotées pour les cas positifs, négatifs, d’obstruction, de flou et de cas limites.
- Sélectionnez un lot à télécharger et lancez la tâche de annotation.
- Choisir une étiquette d’image entière pour les éléments de classification, et tracer des boîtes de délimitation pour les éléments de détection en leur attribuant une catégorie.
- Vérifier que la case à cocher correspond à l’objectif, que la catégorie est cohérente, puis soumettre l’étiquetage.
- Vérifier par échantillonnage les résultats de différents annotateurs, puis générer une version du jeu de données.
Marquage automatique et service manuel
L’étiquetage automatique peut d’abord générer des résultats candidats, qui sont ensuite corrigés manuellement ; il convient aux données pour lesquelles des modèles existants ou des régularités évidentes sont disponibles. Le forfait propose chaque mois un nombre différent de points d’étiquetage automatique ; le nombre d’images ou d’actions correspondant à un point est indiqué dans la description de votre compte.
L’équipe propose également des services professionnels d’annotation de données, permettant à des annotateurs humains de traiter les données conformément aux instructions du projet. Le prix de ce service, l’échantillonnage de validation, le travail de reprise, la confidentialité et le format de livraison doivent être confirmés séparément ; on ne peut pas supposer qu’ils sont inclus dans une abonnement standard.
Entraînement de modèles dans le cloud
Une fois l’ensemble de données terminé, l’utilisateur choisit la version des données et lance l’entraînement ; la plateforme alloue alors des GPU en arrière-plan et exécute la tâche. Le temps d’entraînement peut varier en fonction du nombre d’images, de la complexité de la tâche et de la file d’attente des ressources ; la fourchette courante indiquée pour un débutant est de 1 à 12 heures.
- Vérifier que l’ensemble de données a été entièrement annoté, examiné et divisé pour l’entraînement et la validation.
- Sélectionnez le modèle d’entraînement dans le projet et spécifiez la version du jeu de données.
- Vérifiez les paramètres disponibles tels que le nombre d’épisodes d’entraînement, la taille des lots, le taux d’apprentissage et l’architecture du modèle.
- Démarrer l’entraînement en arrière-plan et attendre la notification de fin ; ne pas modifier la version correspondante pendant son exécution.
- Ouvrez la page des détails du modèle pour visualiser les indicateurs, les courbes et les paramètres de configuration.
- Exécuter l’inférence à l’aide d’images de test non utilisées pour l’entraînement, puis décider s’il convient de les déployer.
« Entraînement en un clic » ne simplifie que les opérations d’infrastructure ; il ne corrige pas automatiquement les étiquettes erronées, les biais des échantillons ou une conception de catégories irréaliste. La création de modèles de production nécessite toujours une gouvernance des données, un suivi des expériences et une validation sur le terrain.
Résultats de l’entraînement et évaluation du modèle
| Indicateur | Explication | Précautions d'utilisation |
|---|---|---|
| Taux de précision de classification | Pourcentage d’images classées correctement | Lorsque les catégories ne sont pas équilibrées, il est impossible d’évaluer séparément la qualité du modèle. |
| mAP | Performance des détections selon différentes catégories et seuils de confiance | Il est nécessaire de confirmer le seuil de ratio de fusion et les paramètres de calcul. |
| Précision | Prédire combien des résultats cibles sont vrais | Se concentrer sur les tâches à coût élevé en cas de fausse alerte |
| Taux de rappel | Combien d’objectifs réels ont été trouvés par le modèle | Se concentrer sur les tâches à coût élevé en cas de détection manquée |
| Courbe de perte | Variation de la fonction objectif pendant le processus d’entraînement | Utilisé pour détecter des signes de non-convergence ou de surapprentissage |
| Raisonnement par exemple | Voir les boîtes de prédiction et le niveau de confiance sur la nouvelle image | Il faut couvrir les rayons lumineux réels, les angles, l’équipement et l’environnement. |
La médecine, le contrôle qualité industriel, la surveillance de la sécurité et la prise de décisions agricoles ne peuvent pas se fonder uniquement sur un indicateur moyen. Les équipes doivent définir des seuils en fonction du coût réel des erreurs, et examiner séparément les performances dans différentes catégories, lieux, équipements et conditions de population.
Méthode de déploiement du modèle
Une fois l’entraînement terminé, il est possible de télécharger des exemples de tests directement sur le tableau de bord, ou encore de créer une interface d’inférence hébergée ou une page web. Le produit propose également le téléchargement de modèles ainsi que diverses options pour les appareils edge ; les formats de conversion spécifiques, l’accélération matérielle et la fonctionnalité hors ligne dépendent du modèle et de la solution choisie.
| Mode de déploiement | Utilisations adaptées | Principales précautions à observer |
|---|---|---|
| Test du tableau de bord | Vérification rapide des prédictions pour nouvelles images | Conçu pour la validation, pas un système de production complet |
| UI Web de gestion | Permettre à l’expérimentateur de télécharger des images depuis la page | Ceux qui détiennent le lien peuvent y accéder, il convient de contrôler les modèles sensibles. |
| API REST de gestion | Accès aux sites web, services et systèmes d’entreprise | Sous les limites du quota de raisonnement, des délais de réseau et de la clé API |
| Python SDK | Science des données et applications backend | Vérification de la version, gestion des anomalies et licences |
| Node.js SDK | Services JavaScript et backend des pages web | La clé ne peut pas être intégrée dans le code front-end public. |
| Téléchargement du modèle | Auto-hébergement, hors ligne ou optimisation supplémentaire | Le format d’exportation et la compatibilité en temps de exécution doivent être vérifiés en pratique. |
| Équipements périphériques | Jetson, OAK, Raspberry Pi, mobile ou navigateur | Il peut être nécessaire de convertir, de quantifier et d’intégrer sur mesure. |
REST API et clé API
L’espace de travail permet de créer une clé API et de choisir le domaine Project ou Inference en fonction de l’usage. Le domaine Project permet de gérer les projets, de télécharger des données, d’entraîner et de faire des prédictions, tandis que le domaine Inference est principalement utilisé pour appeler des modèles déjà entraînés.
- Créez des clés distinctes pour le développement, les tests et la production ; ne partagez pas une seule clé à long terme.
- Seul le niveau de privilèges minimal nécessaire à l’appelant pour accomplir la tâche lui est accordé.
- Conservez le Secret dans un outil de gestion de clés sécurisé immédiatement après sa génération.
- Ne soumettez pas Secret à GitHub, aux paquets d’applications mobiles ou à l’interface frontale du navigateur.
- En cas de fuite de clé, supprimer et régénérer immédiatement à la fin du projet.
- Les applications de raisonnement public doivent également effectuer des appels via leur propre backend, afin d’éviter de exposer les clés de la plateforme aux visiteurs.
Processus d’intégration API
- Créer une clé API avec un champ d’application Inference dans les paramètres de l’espace de travail.
- Sélectionnez le modèle qui a été entraîné et validé, et enregistrez son identifiant et sa version.
- Appeler l’interface de raisonnement avec un petit nombre d’images de test pour vérifier les temps d’attente, le format, le degré de confiance et les réponses d’erreur.
- Ajouter dans le système d’entreprise une vérification de la taille du fichier, de son format et des droits d’accès.
- Définir des tentatives de réessai, des journaux, une limitation du débit et des alertes de quota pour éviter des requêtes répétées à l’infini.
- Enregistrer la version du modèle et l’heure de la prédiction afin de pouvoir faire un suivi en cas de problème.
SDK Python et Node.js
L’organisation GitHub officielle d’Epigos AI a été vérifiée via son nom de domaine, et les deux dépôts epigos-python et epigos-ts ont été rendus publics. Tous deux sont soumis à la licence MIT, ce qui permet de simplifier la gestion des modèles et les appels d’inférence.
- Le SDK Python convient aux pipelines de données, aux prédictions en batch, aux applications serveur et aux scripts d’expérimentation.
- Le SDK TypeScript est adapté aux backends Node.js et à l’intégration dans l’écosystème JavaScript.
- Le SDK n’est que du code client ; pour l’appeler, il faut toujours un compte Epigos, une clé API et les quotas correspondants.
- Le fait que le SDK soit open source ne signifie pas que la plateforme de formation hébergée, l’infrastructure des modèles ou le code serveur soient également open source.
- Avant de mettre à jour le SDK, il convient de vérifier les modifications, la compatibilité et la version verrouillée, afin d’éviter des changements soudains dans les interfaces de production.
Prix et forfaits
La page de tarification affiche actuellement les prix mensuels pour les forfaits Free, Starter et Teams, et propose le passage au paiement annuel, qui offre une économie de 20 %. Le montant total annuel, les taxes et les services supplémentaires doivent se référer à la page de facturation réelle ou à la proposition de vente.
| Forfait ou version | Prix | Période de facturation | Droits ou crédit principal | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Free | 0 dollar | Plan gratuit | 1 projet, 5 membres, 1000 images, 100 annotations automatiques par mois, 5 points d’entraînement, 100 points de raisonnement par mois | Personnel, pédagogie et validation conceptuelle |
| Starter | 150 dollars | Chaque mois | 5 projets, 10 membres, 10 000 images, 5 000 annotations automatiques par mois, 20 points d’entraînement, 10 000 points de raisonnement par mois | Petites entreprises et pilotes officiels |
| Teams | 350 dollars | Chaque mois | 20 projets, 50 membres, 50 000 images, 10 000 annotations automatiques par mois, 50 points d’entraînement, 50 000 points de raisonnement par mois | Équipe pluriprojet |
| Annuel | Se référer à la page de règlement. | Prépaiement annuel | L’indication de la page affiche une économie relative de 20 % par mois ; le montant réel et les avantages doivent être confirmés. | Utilisateurs stables à long terme |
| Marquage et déploiement personnalisé | Contacter le service des ventes | Projet ou contrat | Annotation manuelle, plus de ressources pour l’entraînement et l’inference, support dédié et intégration embarquée | Projets de production d’entreprise |
Comprendre le plafond
- La limite maximale d’images indique la capacité du dataset, mais la manière dont les suppressions, les archivages ou les copies de version sont comptabilisés doit être confirmée dans le compte.
- Les points de formation ne sont pas équivalents à des heures GPU fixes ; les règles de facturation en fonction de la taille du modèle et de la tâche de formation doivent être consultées sur la page d’utilisation.
- La manière dont l’intégration par déduction s’effectue, en fonction des appels ou des images, des lots ou du volume de calcul, n’est pas expliquée en détail sur la page des prix publics.
- Le plafond d’annotation automatique est mis à jour mensuellement ; il n’est pas encore indiqué si le solde inutilisé est reporté.
- La version gratuite comprend-elle le téléchargement des modèles, tous les formats de déploiement et le support technique ? La présentation sur la page est ambiguë ; il convient de se référer aux droits d’accès du compte.
Paiement, annulation et remboursement
La plateforme accepte les cartes de crédit et les cartes de débit via Stripe, et les documents prennent en charge le paiement mensuel ou annuel. Les utilisateurs peuvent résilier leur abonnement depuis les paramètres de leur compte ou en contactant le service client ; il est indiqué clairement que la résiliation ne comporte aucune frais caché ni pénalité.
Les modalités de prise d’effet de l’annulation, la possibilité de continuer à utiliser les périodes déjà payées, ce qu’il advient du crédit restant et l’éventualité d’un remboursement ne sont pas clairement expliqués sur la page publique. Avant l’achat, en particulier pour un abonnement annuel, une étiquetage manuel ou un déploiement personnalisé, il convient d’obtenir par écrit les conditions de remboursement et de livraison.
Adéquat pour les utilisateurs et les scénarios d’utilisation
- Entreprise de fabrication : Identifier les rayures, les fissures, les pièces manquantes et les anomalies d’emballage, ainsi que compter le nombre de produits.
- Équipe agricole : identification des cultures, du bétail, des taches pathogènes ou des objets dans les champs, afin d’aider aux inspections et à la classification.
- Logistique de stockage : classification ou localisation ciblée des marchandises, emballages et images d’inventaire.
- Équipe de vente au détail : analyse de l’aménagement des étagères, de la disponibilité des produits et des événements visuels en magasin.
- Recherche et développement médical : création de prototypes de recherche pour la classification ou la détection d’images, mais qui ne peuvent pas être utilisés pour le diagnostic clinique sans avoir été validés.
- Équipe de sécurité : détection d’objets spécifiques ou de zones anormales, tout en respectant les réglementations relatives à la vie privée, à la surveillance et aux données faciales.
- Équipe de développement d’IA : intégrer des modèles visuels personnalisés dans les produits existants à l’aide d’API et de SDK.
Confidentialité et sécurité des données
La plateforme collecte des informations relatives aux comptes et aux coordonnées, aux données de paiement, aux adresses IP, aux appareils, aux navigateurs, aux pages consultées et aux cookies, et les utilise pour la prestation des services, les paiements, la communication, ainsi que pour la recherche et l’analyse. Des prestataires tiers peuvent traiter ces informations à des fins définies, et des exigences légales peuvent également entraîner une divulgation.
- La politique de confidentialité indique que des protocoles de chiffrement sécurisés sont utilisés, et que l’accès aux données est restreint aux personnes autorisées.
- Les informations personnelles sont conservées selon les finalités visées et le temps nécessaire aux obligations légales, mais aucune date limite précise n’est communiquée.
- Les données peuvent être transmises et stockées en dehors de l’Espace économique européen, et les entreprises doivent évaluer les mécanismes transfrontaliers.
- Les utilisateurs peuvent demander à accéder, mettre à jour, corriger ou supprimer les informations personnelles qui ne sont plus nécessaires.
- Les documents publics ne mentionnent pas la liste complète des sous-traitants, les zones de centres de données, les cycles de sauvegarde ni les certifications de sécurité spécifiques.
- Avant la mise en ligne des images industrielles, des images médicales et des données de surveillance, un accord de traitement des données doit être signé et une évaluation des risques effectuée.
Droits de contenu et considérations commerciales
L’utilisateur doit s’assurer que les images, étiquettes et autres contenus téléchargés sont soumis à des droits d’utilisation légaux. Les conditions accordent à Epigos des droits mondiaux, sans redevance, transférables et susceptibles de sous-licence, non exclusifs, pour utiliser, copier, modifier, distribuer et afficher les contenus de l’utilisateur aux fins de la prestation du service.
- Les images impliquant des personnes, des patients, des employés ou des consommateurs nécessitent l’accord requis par la législation en vigueur ou une autre base légale.
- Les données médicales et biologiques doivent d’abord faire l’objet de déidentification, d’évaluations éthiques, de confidentialité et de contrôles transfrontaliers.
- Lorsque le client demande l’annotation, il convient de préciser la propriété des données originales, des résultats d’annotation et du modèle d’entraînement, ainsi que les exigences en matière de suppression.
- Les prédictions du modèle ne garantissent pas une précision ; des mécanismes de révision humaine et d’arrêt doivent être mis en place pour la sécurité, la qualité et les processus de diagnostic.
- Avant de le déployer sur une page web publique, il convient de vérifier le contrôle d’accès, car ceux qui possèdent le lien de partage pourraient soumettre des raisonnements.
Statut open source
| Composant | État | Licence ou instructions |
|---|---|---|
| Plateforme d’hébergement Epigos | Produits non open source | Les droits de propriété intellectuelle des plateformes et services appartiennent à Epigos. |
| Python SDK | Code open source | Licence MIT |
| TypeScript SDK | Code open source | Licence MIT |
| Entraîner le modèle par l’utilisateur | Pouvant être téléchargé en pack | L’exportation et les droits d’utilisation doivent être confirmés en fonction du compte et du contrat. |
| Le modèle de base utilisé par la plateforme | Pas encore entièrement rendu public | On ne peut pas en déduire à partir de l’ouverture du SDK que l’infrastructure d’entraînement est open source. |
Avantages principaux
- Couvre les données, l’étiquetage, l’entraînement, l’évaluation et le déploiement, réduisant ainsi le travail de mise en place manuelle de plusieurs outils.
- Il prend en charge deux tâches visuelles courantes : la classification d’images et la détection d’objets, avec une interface adaptée aux débutants non experts.
- Le hébergement de GPU élimine l’achat initial et la maintenance d’infrastructures de formation.
- Fournit une API de gestion, des téléchargements de modèles et des chemins pour les appareils edge, permettant de s’adapter à différentes conditions de production.
- SDK Python et TypeScript publics, facilitant l’intégration avec le serveur et les pipelines de données.
- Le forfait liste les projets, les membres, les images, les annotations automatiques, ainsi que les quotas de formation et d’inference, afin de faciliter une comparaison initiale.
Limites des capacités et risques
- La norme actuelle pour le téléchargement prévoit explicitement des images comme principal support, tandis que les tâches relatives aux vidéos, à la segmentation, à la posture et au 3D ne sont pas suffisamment définies.
- L’étiquetage automatique peut amplifier les biais des modèles existants et doit faire l’objet d’une vérification manuelle.
- Le prix public ne prend pas en compte l’ensemble du calcul des points ni le prix unitaire pour les excédents ; le coût réel doit être déterminé par des mesures pilotes.
- Le fait que le modèle se comporte bien sur l’ensemble de test ne signifie pas qu’il pourra s’adapter à de nouvelles caméras, à des conditions d’éclairage différentes, à de nouvelles régions ou à de nouvelles populations.
- L’inférence gérée dépend du réseau, de la disponibilité de la plateforme et des quotas, et n’est pas adaptée aux contrôles critiques non conçus pour être résilients.
- Le déploiement en périphérie peut nécessiter une quantification, une conversion et une optimisation matérielle ; il n’est pas toujours possible de le lancer directement après téléchargement.
- Les informations sur la confidentialité et la sécurité sont assez générales ; les secteurs sensibles nécessitent des documents complémentaires au niveau contractuel.
Recommandations pour le choix et le déploiement
- Choisir un scénario à faible risque, avec une catégorie bien définie et des valeurs réelles pouvant être collectées, pour la validation conceptuelle.
- Valider le processus de téléchargement, d’étiquetage, d’entraînement et de déduction à l’aide du plan Free, puis enregistrer la consommation de ressources pour chaque étape.
- Créer un ensemble de test indépendant et évaluer en le regroupant selon les appareils réels, les lieux et les conditions difficiles.
- Vérifier le format d’export du modèle, le délai de raisonnement, la compatibilité des appareils et la stratégie de connexion déconnectée.
- Définir des droits minimaux et des procédures de suppression pour les données, les annotations, les modèles, les clés API et les paramètres de partage.
- Vérifier le prix supplémentaire, le montant total annuel, les remboursements, le support technique et la portée du déploiement sur mesure avant de payer.
Questions fréquentes
Quelles tâches de vision par ordinateur Epigos AI prend-il en charge ?
Le document du projet actuel énumère clairement la classification d’images et la détection d’objets. D’autres tâches n’ont pas été pleinement reconnues comme types de projets standard et nécessitent une vérification auprès de l’équipe produit.
Est-ce que c’est gratuit ?
Oui. Le forfait Free ne nécessite pas de carte de crédit et comprend 1 projet, 5 membres, 1000 images de jeux de données, 5 points d’entraînement et 100 points de raisonnement par mois.
Faut-il se procurer sa propre GPU pour entraîner un modèle ?
Ce n’est pas nécessaire, la plateforme alloue les ressources de formation dans le cloud et fonctionne en arrière-plan. Le temps de formation et la consommation de points pour les projets complexes dépendent toujours de la quantité de données, des paramètres de configuration et des ressources disponibles.
Est-il possible de déployer le modèle sur son propre appareil ?
La plateforme propose le téléchargement de modèles et promeut Jetson, OAK, Raspberry Pi, les appareils mobiles, les navigateurs et les solutions cloud. Le format réel, la quantification, la vitesse et la compatibilité doivent être vérifiés sur le matériel cible.
Epigos AI propose-t-il des API et des SDK ?
Des API REST ainsi que des SDK en Python et TypeScript sont fournis. La clé API peut avoir un domaine d’application Project ou Inference, et les deux répertoires de SDK sont sous licence MIT.
Epigos AI est-il lui-même open source ?
La plateforme de gestion n’est pas un produit open source. Ce qui est open source, c’est le code SDK du client ; on ne peut pas en déduire que le serveur, le système d’entraînement ou la bibliothèque de modèles sont open source.
Quelles sont les règles de paiement annuel et de remboursement ?
La page de paiement annuel indique une économie de 20 % par rapport au paiement mensuel, mais le montant exact est indiqué sur la page de règlement. Il est possible d’annuler l’abonnement ; la page publique ne divulgue pas en détail les règles de remboursement et du solde restant, il convient donc de confirmer par écrit avant achat.
Peut-il être utilisé directement pour le diagnostic médical ?
Le modèle de plateforme ne doit pas être utilisé directement pour le diagnostic. Les scénarios médicaux nécessitent un anonymisation, une évaluation éthique et réglementaire, ainsi qu’une validation externe, une évaluation clinique et une révision manuelle.
Outils similaires à epigos.ai


 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164