




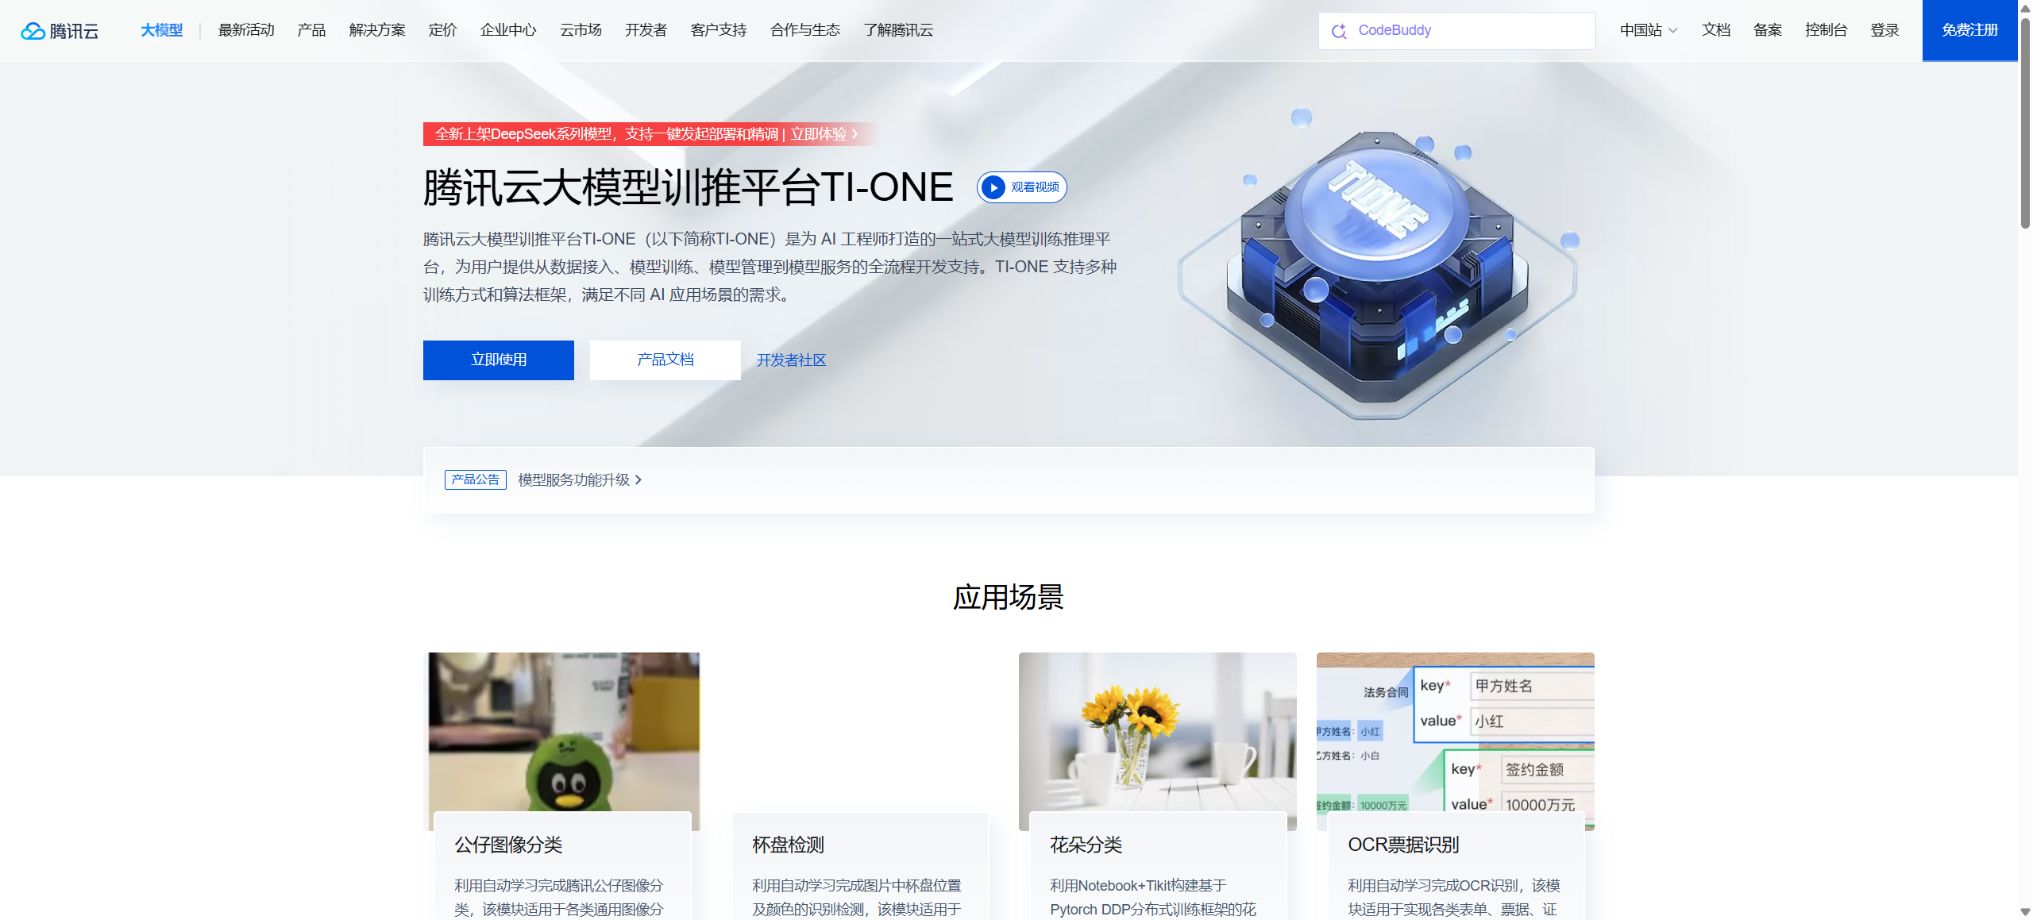
Plateforme TI de Tencent Cloud
Plateforme d’IA pour le développement de modèles, l’entraînement, l’inference et la gestion des ressources
Étiquettes :Modèle d’entraînement d’IAQu’est-ce que Tencent Cloud TI-ONE ?
La plateforme de formation et de déploiement de grands modèles de Tencent Cloud, TI-ONE, est une plateforme intégrée pour l’apprentissage automatique et le développement de grands modèles, couvrant la préparation des données, le développement dans le cloud, l’entraînement distribué, le fine-tuning, la gestion des modèles, l’évaluation, le déploiement de l’inference et l’exploitation des services. Elle s’adresse aux ingénieurs en algorithmes, aux équipes de plateforme et aux centres d’IA des entreprises, et n’est pas un simple chatbot.
TI-ONE s’appuie sur les GPU de Tencent Cloud, les ressources de calcul nationales, CVM, COS, CFS, GooseFS, les images, ainsi que les services de surveillance et de journalisation, pour regrouper le développement des modèles et leur déploiement en production dans un espace de travail unique.
Six modules clés
Le site officiel actuel divise la plateforme en six modules : centre de données, ateliers d’entraînement, flux de travail, gestion des modèles, services de modèles et place des grands modèles, et assure une gouvernance des ressources, quotas et droits grâce à la gestion d’entreprise et à la gestion de la plateforme.
Les entreprises peuvent créer des espaces de travail par équipe, isoler les données, les modèles et les ressources, tout en partageant un pool de ressources de calcul et des images publiques.
Centre de données
Les centres de données servent à créer des ensembles de données, à associer le stockage d’objets aux systèmes de fichiers, à gérer les versions et à effectuer l’étiquetage. Les tâches d’entraînement doivent être liées à une version de données précise, afin d’éviter que les données ne soient écrasées et ne puissent plus être reproduites.
Avant le téléchargement, il est nécessaire de procéder à la suppression des données sensibles, à l’autorisation et à un contrôle de qualité. Les informations personnelles sensibles, les données clients et les contenus protégés par le droit d’auteur doivent disposer d’une base légale.
Machine de développement cloud
Les machines de développement cloud offrent un environnement de développement interactif équipé d’une CPU ou d’une GPU, idéal pour les notebooks, le débogage de code, l’exploration de données et des expériences à petite échelle. Les utilisateurs peuvent choisir l’image, les spécifications des ressources et le stockage.
Le fonctionnement continu de la machine de développement engendre des frais permanents. Avant de partir, il convient de sauvegarder le code, d’arrêter l’instance et de vérifier le disque ainsi que les données montées.
Tâche d’entraînement
L’atelier de formation prend en charge la soumission de formations par tâches et la formation distribuée ; il est possible d’utiliser des images de plateforme ou des images personnalisées, ainsi que de configurer les nœuds, les variables d’environnement, les commandes de démarrage et les chemins de stockage.
Les tâches à grande échelle doivent disposer d’points d’arrêt, de points de contrôle et de mécanismes de récupération en cas d’échec, ainsi que enregistrer le code, les images, les données, les seeds aléatoires et les hyperparamètres.
Ajustement précis en un clic pour les grands modèles
La plateforme intègre des modèles open source majeurs pré-entraînés, ce qui réduit la configuration de l’environnement et des frameworks distribués. Il est possible d’effectuer un micro-entraînement à l’aide de ses propres données pour des scénarios tels que les questions-réponses sectorielles, le classement, la génération et le suivi d’instructions.
Avant un ajustement précis, il convient d’évaluer si les prompts, le renforcement par recherche ou les appels d’outils peuvent répondre aux besoins. Un entraînement complet et aveugle augmentera les coûts et le risque de surapprentissage.
Entraînement par apprentissage renforcé
Le TI-ONE prend en charge nativement le framework distribué Ray et intègre veRL, ce qui permet de lancer des tâches d’apprentissage par renforcement d’un seul clic, afin d’optimiser les préférences, les capacités de raisonnement et l’alignement du comportement.
L’apprentissage renforcé nécessite une conception fiable des récompenses, une évaluation de base et des exemples sûrs. Un biais dans le modèle de récompense peut entraîner du comportement spéculatif du modèle.
Place des grands modèles
La place des grands modèles intègre des modèles tels que Tencent Hunyuan, DeepSeek, Qwen, GLM, Kimi, etc. Les utilisateurs peuvent choisir une version et la publier en un clic en tant que service de raisonnement ; la plateforme recommande alors les spécifications des ressources.
« Déploiement en un clic » ne signifie pas qu’il n’est pas nécessaire d’évaluer les licences, le contexte, la mémoire vidéo, la concurrence et la sécurité. Les cartes de modèle et les licences doivent toujours être examinées séparément.
Gestion de modèles
Le dépôt de modèles stocke de manière centralisée les résultats d’entraînement, les versions, les sources et les historiques de déploiement, ce qui facilite le retrait en arrière et l’audit. L’équipe doit enregistrer pour chaque version les ensembles de données, les soumissions de code, les évaluations et les responsables.
Le téléchargement uniquement des poids sans le Tokenizer, les paramètres de configuration et le code d’inférence peut rendre impossible la reproduction ultérieure.
Service de raisonnement en ligne
Le service de modèles permet de déployer les modèles en tant qu’interfaces en ligne, en configurant des copies, des GPU, des images, des variables d’environnement, l’authentification et le réseau. La plateforme prend en charge l’état des services, les journaux, les métriques et les enregistrements de requêtes.
Avant le lancement, il est nécessaire de réaliser des tests de charge, de planifier la capacité, de définir les paramètres de délai d’expiration et de limitation du trafic, ainsi que de concevoir des plans de dégradation.
Déploiement séparé PD
La séparation PD place les étapes Prefill et Decode sur des nœuds distincts, permettant de configurer indépendamment les ressources de calcul et les copies. Selon la documentation officielle, cela peut réduire de manière significative le délai pour les premiers caractères et entre les paquets dans les scénarios appropriés.
Cette architecture convient mieux aux grands modèles nécessitant une haute concurrence et des contextes longs ; à petite échelle, elle peut augmenter la complexité réseau et de planification.
Accélération de l’inférence TACO
TACO est un moteur d’inférence développé par Tencent Cloud, qui prend en charge les LLM, les VLM et les DiT. Les benchmarks du site officiel montrent qu’il permet d’améliorer le débit par rapport à vLLM open source et de réduire le retard au premier caractère ; les effets concrets dépendent du modèle, du matériel, de la quantification et du volume de trafic.
Les chiffres de référence ne peuvent pas être directement équivalents à l’activité de l’utilisateur. Il convient d’utiliser la longueur réelle des entrées, la longueur des sorties et le nombre de connexions simultanées pour effectuer des tests de charge.
Paramètres de raisonnement
TI-ONE fournit aux modèles Hunyuan, DeepSeek et autres des paramètres d’environnement tels que la longueur du contexte, le nombre de tokens par lot, l’utilisation de la mémoire vidéo, la quantification, le cache de préfixes, la sortie de réflexion et la décodage spéculatif.
Augmenter le contexte et la concurrence augmente les besoins en mémoire vidéo. Activer la spéulation et la quantification peut modifier la cohérence des résultats, il est donc nécessaire de réaliser des tests de régression.
Échelle automatique
Le service de modèles prend en charge l’élargissement et le rétrécissement manuel, planifié et automatique via HPA, permettant d’ajuster le nombre de copies en fonction des pics d’activité. Le rétrécissement en période de faible activité permet d’économiser des coûts, tandis que l’élargissement en période de pic garantit un débit suffisant.
La vitesse d’expansion est influencée par l’image, le chargement des poids et les réserves de ressources. Les services essentiels doivent conserver au moins une copie et être préchauffés.
Mise en production en niveaux de gris et retrait
La plateforme prend en charge le déploiement progressif de plusieurs versions, un basculement fluide et un retour en arrière, ce qui est idéal pour valider de nouveaux modèles avec un faible volume de trafic. L’enregistrement complet des requêtes facilite l’audit et l’identification des problèmes.
Les journaux peuvent contenir des messages d’utilisateur et des informations sensibles, nécessitant un masquage, un contrôle d’accès et une durée de conservation.
Évaluation des grands modèles
Le TI-ONE intègre des ensembles de test open source, des ensembles de test personnalisés, une évaluation par modèle d’arbitrage et un graphique radar pour la comparaison de plusieurs modèles. Ces tests peuvent être utilisés pour le choix du modèle, le calibrage fin et les critères de mise en production.
La liste publique ne peut pas remplacer les tâches réelles de l’entreprise. Les modèles d’évaluation présentent également des biais et doivent faire l’objet d’une vérification manuelle aléatoire.
Orchestration de flux de travail
Le flux de travail par glisser-déposer relie le traitement des données, l’entraînement, l’évaluation et le déploiement en un pipeline reproductible, avec prise en charge du déclenchement planifié ou basé sur des événements. Il contribue à réduire les interventions manuelles et les différences d’environnement.
Les nœuds de flux de travail nécessitent des entrées/sorties et des versions fixes. L’environnement de production doit tester la réessai, l’idempotence et le nettoyage en cas d’échec.
Puissance de calcul hétérogène et GPU nationaux
La plateforme peut gérer de manière unifiée les puces de calcul nationales NVIDIA ainsi que Haiguang, KunlunXin, TianShu, Zixiao, etc., et fournit des pilotes, des frameworks, des outils de planification ainsi que des adaptations au niveau de la plateforme.
La compatibilité du modèle et ses performances dépendent toujours des opérateurs, de la précision et de la chaîne d’outils. Une vérification de la correction et du débit doit être effectuée avant la migration.
Virtualisation GPU
Le TI-ONE prend en charge la virtualisation et le partitionnement des GPU ; le site officiel indique que la taille minimale peut aller jusqu’à 0,01 carte, et améliore l’utilisation grâce aux groupes de ressources, aux quotas et aux spécifications prédéfinies.
Le partage à faible résolution convient au développement et à l’inférence à charge légère, mais n’est pas nécessairement adapté à l’entraînement sensible à la bande passante et à la mémoire vidéo.
Planification des déplacements marémotifs
Le planification des marées permet à l’inférence à haute priorité de prendre le pas sur l’entraînement à faible priorité, et prête les ressources libres à d’autres tâches, afin de fournir des services pendant la journée et d’entraîner la nuit.
L’entraînement en mode préemption doit prendre en charge les points de contrôle et la restauration, sinon l’économie de ressources informatiques pourrait entraîner une exécution répétée de la tâche.
Chaîne d’outils d’intelligence incarnée
Le site officiel présente actuellement des capacités en matière de simulation de modèles mondiaux, d’entraînement de grands modèles multimodaux et de développement d’intelligence incarnée, adaptées à la perception des robots, au contrôle et au traitement des données de simulation.
Ce type de projets concerne également les capteurs, les différences de simulation et la sécurité physique ; la capacité d’entraînement de la plateforme ne peut pas remplacer la validation sur site.
Gouvernance des droits d’accès des entreprises
Le système à deux niveaux de gestion d’entreprise et d’espace de travail permet de configurer les membres, les rôles, les groupes de ressources, les quotas et les permissions de modules, ce qui est adapté au partage de clusters GPU par plusieurs équipes.
Les administrateurs doivent respecter le principe du minimum de privilèges, séparer les rôles de développement, de déploiement et d’audit, et rotationner régulièrement les clés.
Comparaison des prix et des versions
| Forfait ou version | Prix, plafonds et avantages clés |
|---|---|
| Comment TI-ONE facture-t-il ? | Les frais de cloud public se composent de la puissance de calcul des nœuds et des frais de logiciel TI-ONE. Les machines peuvent être achetées directement auprès de TI-ONE ou associées à une CVM existante ; dans le premier cas, les frais couvrent la puissance de calcul et le logiciel, tandis que dans le second, seuls les frais de logiciel sont facturés en fonction du temps d’utilisation sur TI-ONE, la CVM elle-même étant facturée séparément. De plus, COS, CFS, GooseFS, TCR, la surveillance, les journaux, le load balancing et le réseau peuvent faire l’objet de facturation indépendante. |
| Exemple de prix de la puissance de calcul | En juin 2026, les fiches officielles indiquent de nombreuses spécifications. Par exemple, le tarif d’une carte T4 en quart est d’environ 3,72 yuans par heure, une carte T4 seule coûte environ 9,55 yuans par heure, une carte 4090d environ 12,97 yuans par heure, et une carte 4090 environ 16,51 yuans par heure ; les nœuds haut de gamme multi-cartes peuvent atteindre des centaines de yuans par heure. Il s’agit d’exemples de prix indicatifs ; la région, les promotions, les stocks et les frais de logiciel influencent le montant réel, il convient donc de se référer aux devis fournis par la console. |
Comment TI-ONE facture-t-il ?
Les coûts du cloud public se composent de la puissance de calcul des nœuds et des frais logiciels TI-ONE. Les machines peuvent être achetées directement auprès de TI-ONE ou associées à une CVM existante ;
Le premier facture en fonction de la puissance de calcul et des frais de logiciel, tandis que le second ne facture que les frais de logiciel en fonction du temps d’utilisation dans TI-ONE ; le CVM est quant à lui facturé séparément.
De plus, COS, CFS, GooseFS, TCR, la surveillance, les journaux, le chargement équilibré et le réseau peuvent tous faire l’objet d’une facturation indépendante.
À la demande et abonnement annuel
Pour acheter une machine chez TI-ONE, il est possible de choisir un abonnement payant à l’usage ou un abonnement mensuel. Dans le mode payant à l’usage, les moins d’une heure sont facturées au second, avec un règlement par heure.
Abonnement mensuel d’au moins un mois, adapté aux charges stables.
La documentation officielle indique que, pour l’achat à la demande, les frais sont gelés pendant 2 heures avant d’être libérés. Il convient de s’assurer d’un solde suffisant avant de créer.
Exemple de prix de la puissance de calcul
En juin 2026, les tableaux officiels ont indiqué de nombreuses spécifications. Par exemple, le coût d’une carte T4 à quart de puissance est d’environ 3,72 yuans par heure, celui d’une carte T4 entière d’environ 9,55 yuans par heure, celui d’une carte 4090d d’environ 12,97 yuans par heure, et celui d’une carte 4090 d’environ 16,51 yuans par heure.
Les nœuds haut de gamme à plusieurs cartes peuvent coûter des centaines de yuans par heure.
Ce sont des exemples de prix de catalogue ; la région, les événements, les stocks et les frais de logiciel peuvent influencer le montant réel, qui doit être confirmé via la console de demande de prix.
API et SDK
Tencent Cloud propose l’API TI-ONE, qui permet de gérer les ressources, d’entraîner des modèles, de gérer les services de modèles ainsi que les spécifications de facturation, et peut être appelée via le SDK de Tencent Cloud, la ligne de commande et API Explorer.
La clé API doit être stockée dans un gestionnaire de clés ou dans des variables d’environnement, et ne doit pas être écrite dans les notebooks ni dans le code public.
GitHub et l’état open source
La plateforme TI-ONE est elle-même un service cloud à source fermée. Tencent Cloud a rendu public le jeu d’exemples tione-examples, sous licence Apache 2.0 ;
L’organisation Tencent-Ti dispose également d’un outil de signature de demandes.
Le fait que les SDK de cas d’usage et de signature soient open source ne signifie pas que le serveur de la plateforme, le moteur TACO ou le système de planification soient tous open source.
Guide d'utilisation de Tencent Cloud TI-ONE
Terminer une tâche de base
- Installer et configurer Tencent Cloud TI-ONE, et créer un projet et un nom d’exécution distincts pour l’expérience ;
- Enregistrer les hyperparamètres, la version des données, la version du code et la graine aléatoire dans le script d’entraînement ;
- Initialiser la tâche à l’aide de six modules principaux et se connecter au service cloud ou privé approprié ;
- Enregistrer en continu les pertes, les indicateurs, les journaux et l’état du matériel au sein d’un centre de données ;
- Exécuter un entraînement à petite échelle pour vérifier que le nombre d’itérations, les unités, les courbes et les échantillons multimédias sont corrects ;
- Après achèvement, enregistrer le modèle, les paramètres, les résultats ainsi que la description de l’expérience reproductible ;
Créer des flux de travail professionnels réutilisables
- Unifier les normes de nommage des projets, des expériences, des indicateurs et des étiquettes ;
- Inclure les six modules principaux, le centre de données et les machines de développement cloud dans le modèle d’entraînement ;
- Établir des liens de version pour les ensembles de données, le code, l’environnement et les modèles ;
- Utiliser le même ensemble d’évaluation et les mêmes conditions expérimentales pour comparer, afin d’éviter de ne se baser que sur des courbes lissées ;
- Restreindre la portée du téléchargement des échantillons sensibles, des prompts et des sorties du modèle ;
- Définir les alertes d’anomalies, les stratégies de conservation et la révision manuelle avant de les déployer à l’équipe ;
À qui s’adresse-t-il ?
- Équipes algorithmiques d’entreprise chargées de l’entraînement, du ajustement et du déploiement de grands modèles ;
- Département de plateforme nécessitant une gestion unifiée des GPU et des ressources de calcul locales ;
- Entreprise qui développe des services de raisonnement en ligne à haute concurrence ;
- Équipe nécessitant des versions de modèle, des évaluations, du gris et de l’audit ;
- Organismes actifs dans l’autopilote, l’éducation, la robotique et l’IA industrielle.
Avantages du produit
- L’ensemble du cycle de données, d’entraînement, de modèles et de services ;
- Modèles majeurs intégrés et templates finement ajustés ;
- Séparation PD, TACO et ajustement automatique de la capacité ;
- Soutien à l’apprentissage renforcé et à l’évaluation des modèles ;
- Unifier la gestion de NVIDIA et des capacités de calcul nationales ;
- Les droits d’accès, les quotas et l’audit des entreprises sont assez complets.
Restrictions et précautions
- TI-ONE est destiné à la recherche et au développement professionnels, et exige une compréhension des ressources cloud, des conteneurs, de l’entraînement et du raisonnement distribués ;
- Les coûts concernent non seulement la GPU, mais aussi le logiciel, le stockage, les journaux et le réseau ;
- Le déploiement de grands modèles implique des licences, la sécurité des données, les journaux d’instructions, la sécurité du contenu et la gouvernance des coûts ; il ne suffit pas de se contenter d’un « lancement en un clic ».
Questions fréquentes
Le TI-ONE est-il gratuit ?
Ce n’est pas un produit gratuit à long terme. Il peut y avoir des essais ou des offres spéciales, mais le fonctionnement des machines de développement, de l’entraînement et des services est facturé en fonction de la puissance de calcul, du logiciel et des ressources cloud associées.
Peut-on déployer DeepSeek ?
Oui, la Place des grands modèles et le guide officiel de déduction couvrent plusieurs versions de DeepSeek, et fournissent des images optimisées ainsi que des paramètres.
Est-il possible de réutiliser des CVM existants ?
Oui. Lors de la réutilisation d’un CVM, TI-ONE facture une redevance pour le logiciel, tandis que les ressources du CVM continuent d’être facturées selon la commande initiale.
Prend-il en charge les GPU nationaux ?
Prend en charge diverses puces de calcul nationales telles que Haiguang, KunlunXin, TianShu, Zixiao ; la compatibilité avec les modèles et les régions spécifiques doit être vérifiée dans la console.
TI-ONE est-il open source ?
La plateforme n’est pas open source ; les exemples officiels et certains outils de signature le sont, mais les services cloud principaux et le moteur d’accélération ne sont pas entièrement rendus publics.
Outils similaires à la plateforme TI de Tencent Cloud


 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164