




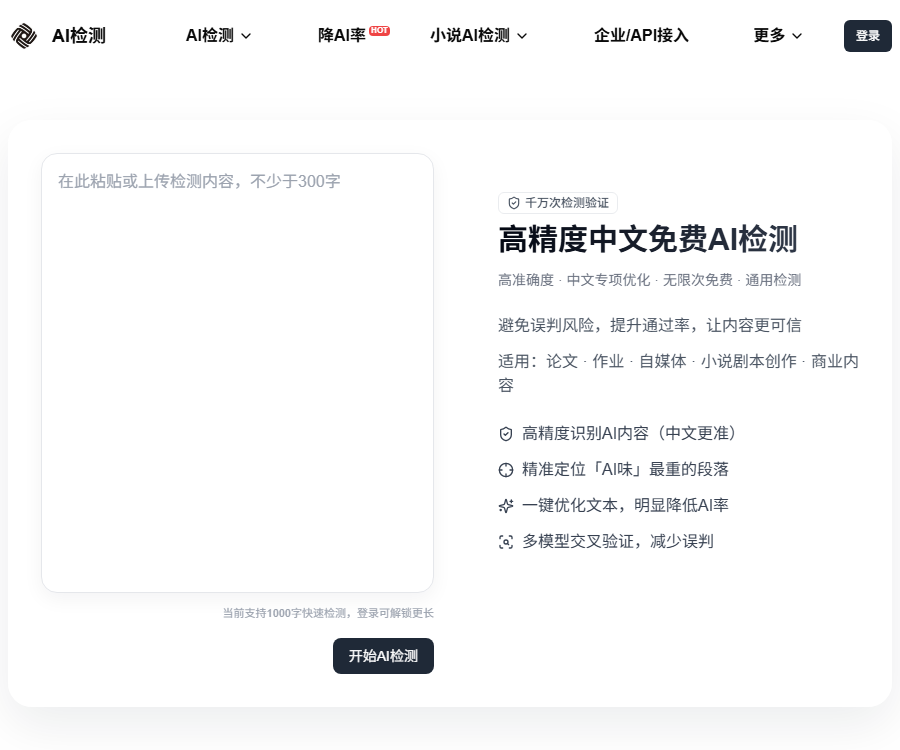
Détection par IA
Outil axé sur la détection de contenu généré par l’IA en chinois, conçu pour aider les utilisateurs à identifier avec précision si le texte a été généré par une intelligence artificielle. Cette plateforme a été spécialement optimisée pour le contenu chinois, réduisant efficacement le taux d’erreurs de détection, tout en mettant l’accent sur la protection de la vie privée des utilisateurs, sans stocker leurs données...
Étiquettes :Détection de contenu par IAQu’est-ce que la détection par IA ?
La détection par IA est un outil d’analyse des caractéristiques générées par l’IA, conçu pour les textes en chinois, qui fournit des probabilités et des tendances de risque.
Il convient pour l’auto-vérification du contenu et pour une révision auxiliaire, mais il ne peut pas prouver l’identité de l’auteur, ni remplacer un jugement humain.
Fonctionnalités clés
| Fonctionnalité | Rôle principal | Scénarios adaptés |
|---|---|---|
| Détection de la fréquence d’IA de base | Estimer le degré de similarité entre un texte et les caractéristiques générées par l’IA | Vérification personnelle de mémoires, de devoirs et d’articles |
| Positionnement du paragraphe de risque | Trouver les paragraphes présentant des caractéristiques d’IA marquées | Révision ciblée et édition |
| Carte thermique d’IA | Visualiser les risques de différents paragraphes | Vérification de textes longs et de rapports |
| Vérification multiplateforme | Comparer plusieurs résultats de test | Réduire le biais de l’outil unique |
| Détection de la crédibilité du contenu | Vérifier les faits, les citations et les risques logiques | Contrôle de qualité avant publication |
| Batch et API | Gérer plusieurs fichiers ou se connecter à un système d’entreprise | Écoles, plateformes et entreprises |
Comment l’IA détecte-t-elle le texte
Le système ne lit pas l’« identité de l’auteur », mais analyse le degré de similitude entre les caractéristiques linguistiques et les sorties des modèles courants.
- Niveau de confusion : mesure du degré auquel un texte est trop facile à prédire pour un modèle linguistique.
- Soudaineté : observer si la longueur des phrases, le rythme et les variations du vocabulaire présentent des fluctuations naturelles.
- Répétition de structures : identification d’une structure trop régulière et d’empilements de mots de liaison fixes.
- Lissage sémantique : analyser si le paragraphe est trop cohérent et manque de transitions naturelles.
- Continuité logique : Vérifier si l’expression présente un schéma stable courant dans le modèle.
- Empreinte chinoise : évaluation spécifique de la syntaxe, du contexte et des habitudes d’expression en chinois.
Quelles caractéristiques de modèle sont prises en charge
Les autorités affirment que la stratégie de détection prend en compte divers grands modèles populaires, mais les résultats ne permettent pas d’identifier avec précision l’origine du modèle spécifique.
- Modèles d’expression en chinois courants utilisés par DeepSeek pour générer du contenu.
- Caractéristiques des modèles nationaux tels que DouBao, QianWen et Kimi.
- Caractéristiques des modèles internationaux tels que ChatGPT, Claude et Gemini.
- Les différentes versions de modèles, les températures et les modifications manuelles modifient les caractéristiques détectables.
- « Couvrir un modèle » ne signifie pas pour autant que l’on peut prouver que le texte a été généré par ce modèle.
Textes et fichiers pris en charge
- Vous pouvez coller directement du texte chinois pour un test rapide.
- Supporte le téléchargement de fichiers DOCX et TXT.
- La page publique propose actuellement une détection rapide de 1000 caractères.
- Après connexion, vous pourrez déverrouiller du contenu plus long, avec une limite maximale de 20 000 caractères par fois.
- Un texte long peut être divisé en chapitres pour une analyse séparée, avant d’examiner la tendance globale.
- Le code, les tableaux, la poésie et le texte fortement formaté sont plus sujets à des erreurs.
Guide d'utilisation de la détection par IA
- Ouvrez la page de détection d’IA et préparez le texte de la version finale à analyser.
- Supprimer la couverture, le sommaire, les références et le format fixe non pertinent pour le texte principal.
- Coller du texte ou télécharger des fichiers DOCX et TXT pris en charge.
- Cliquez sur « Démarrer la détection » pour consulter le taux global d’IA et les avertissements de risque.
- Prêtez une attention particulière aux paragraphes à haut risque, plutôt que de ne regarder qu’un pourcentage.
- Vérification manuelle en comparant avec l’organigramme de rédaction, les notes de modification, les sources et les notes de l’auteur.
- Utiliser une autre méthode de détection pour la validation croisée si nécessaire.
- Conserver le temps de détection, la version du texte et les conclusions de révision, afin d’éviter que les résultats ne soient déconnectés du contexte.
Comment comprendre correctement le taux d’IA
Le taux d’IA indique le degré de similarité entre le texte et les caractéristiques générées par le modèle, et non la proportion de mots écrits par l’IA.
- Des scores élevés peuvent provenir d’un texte écrit de manière standardisée, riche en terminologie ou excessivement réglementé.
- Un faible score ne prouve pas non plus que le texte a été entièrement rédigé par un être humain de manière indépendante.
- Le même texte peut donner des résultats différents dans différentes outils en raison des seuils et des données d’entraînement.
- Les messages courts manquent de données, ce qui entraîne généralement des fluctuations plus importantes que pour les textes longs.
- La modification manuelle, la traduction et l’écriture hybride à plusieurs modèles augmentent encore l’incertitude.
- Les jugements importants doivent tenir compte des preuves processuelles, de la qualité du contenu et d’entretiens avec des personnes.
Scénarios de mauvaises interprétations courants
| Scène | Raisons de l’erreur de jugement | Revue des recommandations |
|---|---|---|
| Résumé académique | Normes syntaxiques, vocabulaire centralisé | Vérifier le processus de recherche et les données brutes |
| Avis officiel | Modèle fixe et expression unifiée | Modèle de système de contrôle et procès-verbal de rédaction |
| Document technique | Structure stable, formulation précise | Vérification des journaux de version et des faits techniques |
| Texte court | Échantillons caractéristiques insuffisants | Réessayer après avoir ajouté du contexte |
| Traduire le texte | Ton fluide, syntaxe cohérente | Voir le texte original et le processus de traduction |
| Basiques linguistiques faibles | Beaucoup de structures répétitives et de conjonctions | Éviter d’évaluer les capacités d’un auteur en fonction de son style |
Test gratuit et plateforme avancée homologue
Les sites de détection par IA offrent des services légers et gratuits, tandis que les textes plus longs et les fonctionnalités avancées sont gérés par la plateforme AI Rate de même origine.
- Le test de base n’est pas lié à une carte mensuelle et convient pour les auto-vérifications quotidiennes et les contrôles répétés.
- Aucun plafond strict de nombre de visites quotidiennes n’est fixé pour les pages gratuites.
- La plateforme avancée propose des cartes thermiques de paragraphe et des rapports téléchargeables.
- Permet la validation croisée sur plusieurs plateformes, ainsi que la détection de fichiers en masse et de contenus sur les réseaux sociaux.
- Des illusions d’IA, une fiabilité du contenu, ainsi que la détection des erreurs et de la grammaire sont également proposées.
- La fonction de réduction du taux d’IA relève de l’optimisation de l’expression et ne doit pas être utilisée pour tricher ou plagier.
Prix du pack de points
Au 30 août 2026, la plateforme Tongyuan AI propose les packs de points uniques suivants.
| Pack de points | Prix | Intégrale | Utilisations adaptées |
|---|---|---|---|
| Forfait d’essai en points | 9,9 yuans | 15 points | Devoir individuel ou publication unique |
| Pack d’intégration standard | 19,9 yuans | 40 points | Révision du mémoire et vérifications répétées |
| Paket de points professionnels | 39,9 yuans | 100 points | Création à haute fréquence et optimisation en masse |
Les prix, les offres et les règles de consommation peuvent être modifiés ; ce qui est valable est indiqué sur la page d’achat, la page de paiement et les conditions de service en vigueur.
Consommation de points pour les fonctionnalités avancées
| Fonctionnalité | Restrictions publiques | Consommation |
|---|---|---|
| Détection avancée par IA | Pas plus de 5000 caractères par fois | 2 points/essai |
| Détection multiplateforme | Pas plus de 3000 caractères par fois | 2 points/essai |
| Détection des illusions de l’IA | Pas plus de 3000 caractères par fois | 2 points/essai |
| Détection de fichiers en lot | Jusqu’à 10 fichiers à la fois | Se référer à la page de tâche. |
| Baisse du taux d’IA | Si la notation de la page n’est pas réduite, les points sont restitués. | En fonction du nombre de mots et de la tâche |
Avant soumission, il convient de vérifier le nombre de mots, les points estimés, les conditions de retour en cas d’échec et la manière de sauvegarder les résultats.
Cartes thermiques d’IA et validation multiplateforme
Les cartes thermiques servent à localiser les paragraphes à haut risque, tandis que la vérification sur plusieurs plateformes permet d’observer les différences entre les différents détecteurs.
- Commençons par examiner s’il existe des modèles de rédaction communs dans plusieurs paragraphes à haut risque.
- Vérifier en priorité les preuves du contenu, plutôt que de remplacer mécaniquement les synonymes.
- Lorsque les résultats varient fortement selon les plateformes, il ne faut pas choisir la note la plus basse comme conclusion.
- Il faut utiliser la même plage de texte et la même configuration de détection avant et après modification.
- Un rapport peut enregistrer les tendances, mais il ne peut pas servir de preuve de tricherie de l’auteur.
Illusions de l’IA et détection de la crédibilité du contenu
Les plateformes homologues peuvent également détecter des risques tels que des faits fictifs, des données, des citations, des sources et des logiques erronées.
- La détection d’illusions n’est pas adaptée aux romans, aux scripts et aux contenus de fiction artistique.
- Les résultats dans les domaines spécialisés nécessitent encore une vérification manuelle par des médecins, des avocats, des chercheurs, etc.
- Le test ne peut que signaler des risques, il ne remplace pas la vérification auprès de la source originale.
- La citation doit vérifier l’auteur, le titre, l’année, les numéros de page et le sens du texte original.
- Les données doivent être ramenées aux bases de données officielles, rapports ou registres d’expériences.
Confidentialité et traitement des données
Selon les informations officielles, le texte d’analyse n’est utilisé que pour l’analyse en cours, n’est pas conservé sur le long terme et n’est pas utilisé pour l’entraînement des modèles.
- Après rechargement de la page, le contenu complet du test et les résultats peuvent ne pas être restaurés.
- Les utilisateurs connectés peuvent voir un résumé de l’historique des opérations, mais ce résumé ne contient pas le texte complet.
- Le résumé peut inclure le titre, le nombre de mots, le type d’opération et des informations sur les résultats.
- Les thèses, les contributions de clients et les documents internes doivent être démasqués avant d’être téléchargés.
- Les projets privés doivent définir l’accord d’entreprise, la localisation des données et les mécanismes de suppression.
API et solutions d’entreprise
La plateforme avancée homologue offre des API standard, un traitement asynchrone en masse et des résultats de risque structurés.
- Les résultats peuvent inclure des scores de probabilité, un niveau de risque et une localisation par paragraphe.
- Prend en charge des scénarios à forte concurrence et des volumes de données quotidiens atteignant plusieurs millions de caractères.
- L’API standard est facturée en fonction du nombre d’appels et offre un niveau de service ainsi qu’une intégration technique.
- Les entreprises peuvent consulter des stratégies sectorielles, des modèles exclusifs et le renforcement des règles.
- Prend en charge le déploiement privé, les environnements indépendants et l’intégration des processus locaux.
- La page publique ne montre pas le prix unitaire uniforme de l’API ; il est nécessaire de contacter la plateforme pour confirmation.
Statut open source
- Aucun dépôt de code source officiel et public du site de détection d’IA n’a été trouvé.
- Aucun poids de modèle de détection, données d’entraînement ou licence open source n’a été trouvé.
- Une explication publique des principes ne signifie pas pour autant que la mise en œuvre algorithmique est déjà open source.
- Le déploiement privé par les entreprises relève de services commerciaux et ne signifie pas que les utilisateurs peuvent télécharger le code source.
- Le fait que l’API soit accessible ne signifie pas non plus l’acquisition de la propriété du modèle ou des données.
À qui s’adresse-t-il
- Élèves et enseignants : aide à la révision des mémoires, des devoirs et du processus d’écriture.
- Édition et médias personnels : définir des modèles et des expressions mécaniques avant la publication.
- Auteurs de romans et de scénarios : Vérifier les paragraphes à risque en termes de style dans le texte complet.
- Équipe du marché des entreprises : Vérification de la qualité du contenu avant la publication de contenus externes.
- Plateformes d’éducation et de contenu : filtrage initial en masse via API et vérification manuelle.
- Produits d’écriture par IA : fournissent aux utilisateurs des avertissements sur les risques liés à la génération.
Restrictions d'utilisation et précautions
- Aucun détecteur d’IA ne peut atteindre une précision de 100 % sur tous les textes.
- Les résultats des tests ne doivent pas servir de preuve unique pour des sanctions, le rejet d’un article ou des manquements académiques.
- Baisser le taux d’IA ne peut pas remplacer la recherche réelle, les idées originales et le processus d’écriture.
- Éviter délibérément les tests peut enfreindre les règles de l’école, de la plateforme ou de l’institution.
- Lors de plusieurs tests sur le même texte, il convient de conserver les versions afin d’éviter de comparer des ensembles de contenu différents.
- Lorsqu’il s’agit de droits et intérêts personnels, des voies de recours, de révision manuelle et de preuve du processus doivent être mises à disposition.
Questions fréquentes
Que peut faire principalement la détection par IA ?
Il peut estimer le degré de similarité entre un texte chinois et les caractéristiques générées par l’IA, et identifier les paragraphes nécessitant une révision manuelle.
Un taux d’IA peut-il prouver que l’article a été écrit par une IA ?
Non, le taux d’IA est une probabilité et une tendance, et non une preuve de l’identité de l’auteur, d’un fait de tricherie ou du nombre de mots générés.
L’analyse par IA est-elle gratuite ?
Les tests de base sont gratuits et il n’y a pas de limite stricte au nombre de fois par jour ; les fonctionnalités avancées telles que les cartes thermiques et les rapports nécessitent des points.
Jusqu’à quelle longueur de texte l’analyse par IA est-elle compatible ?
Vérification rapide sur la page publique pour 1000 mots ; un compte enregistré permet d’accéder à des textes plus longs, avec une limite maximale de 20000 mots par saisie.
Combien coûte le pack de points ?
La plateforme avancée homologue propose 15 points pour 9,9 yuans, 40 points pour 19,9 yuans et 100 points pour 39,9 yuans.
Le contenu du test sera-t-il enregistré ?
Selon les autorités, le texte principal est utilisé uniquement pour l’analyse en cours, sans être stocké ni utilisé pour l’entraînement ; le compte peut conserver un résumé des opérations sans le texte principal.
L’analyse par IA fournit-elle une API ou du code open source ?
La plateforme homologue propose des API commerciales et un déploiement privé, mais aucun code source public, poids de modèle ou licence open source n’a été trouvé.
Outils similaires à la détection par IA

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164