




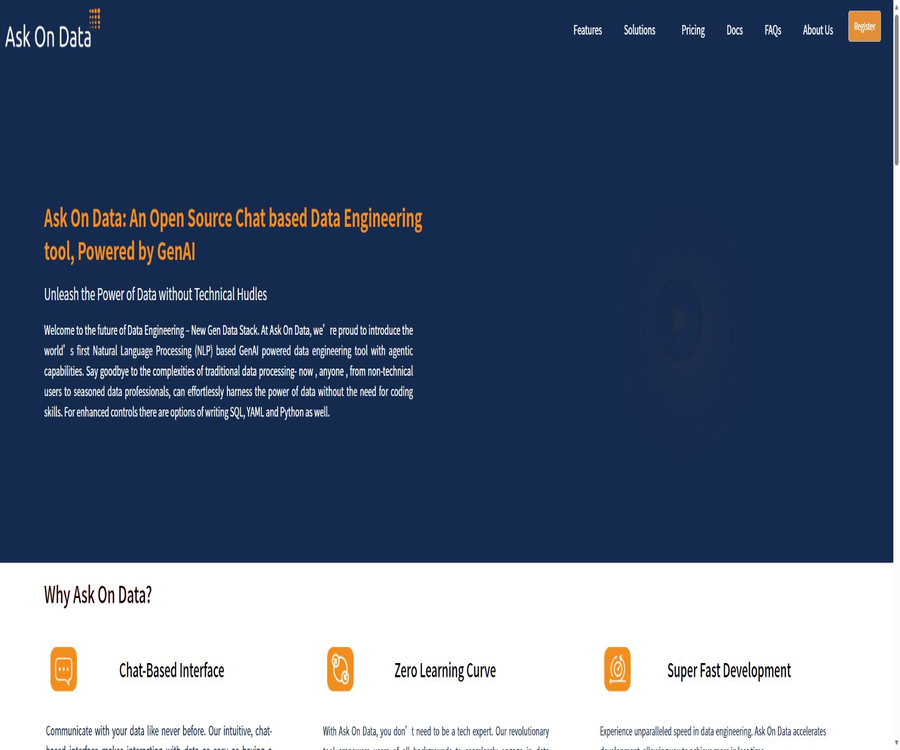
Ask On Data
Ask On Data, outil intelligent axé sur les frameworks de développement d’IA
Étiquettes :Framework de développement d’IAQu’est-ce que Ask On Data ?
Ask On Data est un outil d’ingénierie de données basé sur l’IA générative et fonctionnant par interaction en chat, permettant aux utilisateurs de décrire en langage naturel leurs besoins en matière de migration, de nettoyage, de connexion, de transformation et de planification des données. Il s’adresse aux ingénieurs en données, analystes, data scientists ainsi qu’aux utilisateurs métier souhaitant réduire le travail de codage.
Ce produit est positionné comme une plateforme ETL et de pipelines de données pilotée par l’IA, plutôt que comme un outil de question-réponse pour bases de données qui se contente de convertir le langage naturel en instructions de requête. La plateforme conserve en même temps des méthodes de contrôle spécialisées telles que SQL, Python et YAML, facilitant ainsi le travail des techniciens sur des logiques complexes et des cas limites.
Fonction principale
- Création de pipelines en langage naturel : décrire les besoins de traitement des données par le biais d’un dialogue en anglais, et le système génère alors les étapes correspondantes du pipeline de données.
- Intégration des données : prise en charge de la fusion, de la connexion, du transfert ainsi que du flux de données entre différentes sources.
- Nettoyage et organisation des données : traitement des valeurs manquantes, du format, des champs et d’autres problèmes de qualité des données.
- Conversion des données : Effectuer des calculs personnalisés, dériver des champs et convertir les règles métier.
- Aperçu en temps réel des données : visualiser un échantillon du résultat après chaque envoi d’une instruction de conversion, afin de vérifier croisément avant d’exécuter la tâche officielle.
- Historique des opérations et annulation : Consultez les actions antérieures dans le flux de travail et annulez les modifications en cas d’erreur.
- Planification et exécution des tâches : définir un chargement complet, un chargement incrémental ou un rechargement après vidage, et les exécuter à une fréquence spécifiée.
- Contrôle du code : lors d’un ajustement précis, il est possible d’écrire du SQL, du Python ou d’éditer des configurations YAML.
- Logique Spark personnalisée : intégrer du code Apache Spark pendant la phase de planification des tâches pour traiter des besoins spécifiques.
Sources de données prises en charge
Le site officiel indique que la plateforme peut gérer des sources telles que des bases de données, des entrepôts de données, des lacs de données, des interfaces, des fichiers plats et des journaux, et permet aux utilisateurs de soumettre des demandes pour des sources de données personnalisées. La gamme de sources de données réellement disponibles varie selon les forfaits.
| Source des données | Contenu adapté au traitement | Il est nécessaire de le vérifier avant utilisation. |
|---|---|---|
| Excel et CSV | Tableaux locaux, export de données et petits ensembles de données | La version gratuite dans le cloud ne prend en charge que ces deux types de fichiers et est soumise à une limite de capacité. |
| Base de données relationnelle | Base de données commerciales, base de données de commandes et base de données analytiques | Moteur, réseau, droits d’accès et plage de lecture/écriture |
| Entrepôt de données et lac de données | Données historiques et données d’analyse à grande échelle | Stratégie de connecteurs, de ressources de calcul et de tables cibles |
| API | Données de systèmes tiers et de services en ligne | Authentification, restrictions de fréquence et variations de champs |
| Journal et autres fichiers | Journal des applications et fichiers par lots | Analyse de format, codage et traitement des données d’exception |
Comment fonctionnent les pipelines de données
- Sélectionnez ou connectez-vous à une source de données, et définissez les identifiants d’accès ainsi que les permissions minimales nécessaires.
- Laissez la plateforme charger une prévisualisation des données pour vérifier d’abord que les champs, les types et les échantillons sont corrects.
- Décrire en langage naturel les étapes de connexion, de nettoyage, de calcul ou de transformation.
- Vérifiez progressivement l’aperçu des données et l’historique des opérations après chaque instruction.
- Vérifier et modifier la logique YAML, SQL ou Python générée si nécessaire.
- Déterminer la source de données cible, le mode d’écriture et les règles de gestion des échecs.
- Définissez un déclenchement manuel ou une tâche planifiée, et choisissez une stratégie complète ou incrémentale.
- Mettre en œuvre des tests à petite échelle, vérifier les résultats avant de traiter les données officielles.
Quels scénarios d'utilisation conviennent
- Migration des données : transférer des fichiers, des bases de données ou d’autres données provenant de systèmes vers la plateforme cible.
- Nettoyage des données : unification du format des champs, correction des valeurs anormales et préparation d’un ensemble de données analysable.
- Intégration des données : association des données de plusieurs systèmes métier par connexion ou fusion.
- Prétraitement des rapports : effectuer les conversions, agrégations et ajustements de définition avant d’accéder aux outils BI.
- Préparation de l’apprentissage automatique : génération de données nettoyées et traitées en fonctionnalités pour l’entraînement du modèle.
- Synchronisation programmée : exécution de tâches de mise à jour de données répétées toutes les heures, tous les jours ou à une autre fréquence.
- Prototype de tuyau : valider rapidement l’idée de conversion par chat, puis faire affiner les paramètres de production par des ingénieurs.
À qui s’adresse-t-il
- Ingénieur de données : générer rapidement une version préliminaire de pipeline, et exercer un contrôle précis par le biais de code et de configurations.
- Analyste de données : réduire les tâches simples de préparation des données pour consacrer plus de temps à l’analyse et à la validation.
- Scientifique des données : organiser soi-même les données d’entraînement, sans avoir à attendre un soutien technique distinct pour chaque prétraitement.
- Équipe BI : processus de nettoyage des données, d’intégration et de mise à jour périodique avant la création de rapports.
- Agent commercial : Dans le cadre des droits d’accès et des mécanismes de vérification, formuler des demandes de traitement de données de base en langage naturel.
- PME : Évaluer les processus d’ingénierie de données en mode conversationnel avec des versions auto-hébergées ou gratuites dans le cloud.
Avantages du produit
- L’entrée interactive abaisse le seuil d’expression pour les tâches courantes de traitement de données.
- Chaque étape permet de prévisualiser les données, ce qui aide à détecter les erreurs avant le lancement officiel.
- Préservez le contrôle YAML, SQL, Python et Spark, sans vous limiter à des opérations entièrement sans code.
- Prend en charge l’historique des opérations et l’annulation, ce qui facilite le suivi de la manière dont le flux de travail se forme.
- Il est possible d’organiser davantage les étapes de conversion et de les planifier en tâches exécutées de manière répétée.
- La solution self-hostée est affichée comme gratuite sur le site officiel, ce qui la rend adaptée aux équipes techniques pour des tests.
Restrictions d'utilisation
- L’interface de chat actuelle utilise principalement des instructions en anglais ; la qualité de la compréhension et de la génération en chinois doit être testée par vous-même.
- L’IA générative peut mal interpréter la signification des champs ou les règles métier ; l’aperçu ne correspond pas à une validation complète des données.
- Les opérations d’écriture, de suppression et de remplacement dans une base de données peuvent entraîner des pertes réelles ; il est donc nécessaire de limiter les droits d’accès et de créer des sauvegardes.
- La version gratuite en ligne ne prend en charge que Excel et CSV, avec une limite de taille de 5 MB par fichier.
- La version gratuite dans le cloud ne propose pas de planification de tâches et ne peut pas gérer directement des processus de production continus.
- La version entreprise n’a pas de prix fixe public ; les frais sont négociés en fonction du volume de données et de l’étendue réelle des services.
- Le site officiel prétend être open source, mais le répertoire GitHub officiel était vide au moment de la vérification, ce qui empêche de télécharger le code source complet pour une déploiement personnel.
- Les documents publics ne suffisent pas encore à confirmer tous les connecteurs de base de données, les exigences du système et les détails d’exploitation au niveau de production.
Comparaison des versions et des prix
Le site officiel d’Ask On Data propose trois options : hébergement auto-géré open source, cloud gratuit et cloud d’entreprise. La version d’entreprise est facturée en fonction du volume de données, mais aucun montant fixe n’a été communiqué.
| Version | Prix | Source de données | Planification | Hébergement et support |
|---|---|---|---|---|
| Open Source | Gratuit | Le site officiel indique qu’il prend en charge toutes les bases de données en tant que sources et cibles. | Soutien | Hébergement auto-géré, soutien communautaire, déploiement manuel de correctifs et mises à jour |
| Free | Gratuit | Seulement Excel et CSV, limite de taille du fichier : 5 MB | Non pris en charge | Hébergement officiel, soutien communautaire, mises à jour automatiques, sauvegardes et surveillance |
| Enterprise | Contacter pour une demande de prix | Le site officiel indique qu’il prend en charge toutes les bases de données en tant que sources et cibles. | Soutien | Hébergement officiel, support entreprise, mises à jour automatiques, sauvegardes et surveillance |
Les FAQ du site officiel indiquent également que l’hébergement auto-géré est disponible gratuitement, tandis que le prix de la version entreprise dépend de la quantité de données. Comme le dépôt de code officiel est actuellement vide, il faut encore vérifier avec l’équipe avant de pouvoir télécharger et déployer réellement une solution d’hébergement auto-géré.
Open source et statut GitHub
Sur le site officiel, Ask On Data est décrit à plusieurs reprises comme un produit open source, et la version auto-hébergée open source est présentée comme une solution gratuite. Un dépôt public du même nom a également été créé sous l’organisation GitHub officielle.
À la date de cette vérification, ce dépôt est affiché comme vide, sans code source, instructions d’installation, versions publiées ou fichiers de licence. Par conséquent, on ne peut pas conclure, sur la base uniquement des informations fournies sur le site officiel, qu’une version open source auditable et déployable est déjà disponible.
| Projets de vérification | État actuel | Conclusion |
|---|---|---|
| Description officielle du produit | Déclarer que le produit est open source | Appartient à la positionnement public du fabricant |
| Répertoire GitHub | Public mais vide | Aucun code disponible pour le moment |
| Licence | L’entrepôt n’est pas fourni | Impossible de confirmer la licence open source spécifique |
| Document d’installation | L’entrepôt n’est pas fourni | Impossible de terminer le déploiement autonome selon les étapes publiques. |
| Version et publication | Pas de version publique disponible | Impossible de vérifier la version stable et le historique des mises à jour |
Architecture technique
Selon les FAQ officielles, l’arrière-plan est basé sur Python, l’avant-plan utilise React, et le pipeline de données crée des tâches Apache Spark qui sont orchestrées. Le produit mentionne également des technologies telles que LangChain, Ollama et Airbyte.
- Python : Gère les services backend et la logique liée au traitement des données.
- React : Création d’interfaces interactives pour le web.
- Apache Spark : Exécution des tâches de traitement de données générées.
- LangChain : relie les grands modèles aux processus d’application.
- Ollama : fournit des fonctionnalités pour exécuter des modèles locaux ou gérés par l’utilisateur.
- Airbyte : utilisé pour les connexions de données et l’écosystème d’intégration.
Conseils pour une utilisation sécurisée
- Privilégiez l’utilisation de comptes en lecture seule pour valider les données sources, et utilisez des comptes indépendants à faibles privilèges pour écrire dans la base cible.
- Ne soumettez pas de mots de passe, de clés, d’informations personnelles sensibles ou de données de production non autorisées dans la boîte de chat.
- Examiner manuellement la logique de connexion, de filtrage, d’agrégation et de calcul générée.
- Exécutez d’abord sur la base de test et un petit échantillon, puis étendez l’échelle des données une fois les résultats confirmés.
- Créez des stratégies de snapshots, de sauvegardes et de versions réversibles pour la table cible.
- Enregistrer les prompts, les configurations, les modèles, les versions des pipelines et les résultats de chaque exécution.
- Vérifier avant l’achat officiel l’emplacement de sauvegarde des données, le chiffrement, les fonctions d’audit, la suppression et les procédures de réponse en cas d’incident.
Tutoriel d’essai pour les débutants
- Préparez d’abord un petit fichier de test Excel ou CSV sans informations sensibles.
- Inscrivez-vous à la version cloud gratuite et téléchargez des fichiers de moins de 5 MB.
- Vérifier les noms des champs, les types de données et les enregistrements d’échantillon identifiés par le système.
- Effectuer un filtrage ou un nettoyage de champs à l’aide d’instructions simples en anglais.
- Voir la prévisualisation en temps réel après conversion, et comparer manuellement avec les données originales.
- Ajouter une opération de connexion, de calcul ou de conversion de format.
- Vérifiez l’historique des opérations et testez pour voir si la fonction d’annulation fonctionne comme prévu.
- Exporter ou enregistrer les résultats, et noter la précision, le temps consacré et les étapes nécessitant une modification manuelle.
Guide d’évaluation d’entreprise
- Choisissez un pipeline de données dont les règles sont claires, le risque est faible et pour lequel des résultats manuels existent déjà.
- Organiser l’ampleur des données, leurs sources, leurs objectifs, leur fréquence de mise à jour et les exigences de conformité.
- Vérifier avec l’équipe produit le connecteur, le lieu de déploiement, la source du modèle et si les données sont transmises à l’extérieur.
- Il est demandé de démontrer la récupération en cas d’erreur, le suivi des tâches, le contrôle des permissions et les journaux d’audit.
- Utiliser des données masquées pour valider les connexions complexes, la synchronisation incrémentale et le traitement des exceptions.
- Comparer le temps de développement, les coûts d’exploitation, la précision et l’effort de maintenance des processus existants.
- Vérifier le traitement des données, les niveaux de support, la récupération en cas de panne et les mécanismes de sortie dans le contrat.
- Transférer les données de production et les tâches planifiées critiques une fois le seuil d’acceptation atteint.
Différences avec les outils de Q&R pour bases de données en langage naturel
| Dimensions de comparaison | Ask On Data | Outil de questions-réponses pour bases de données |
|---|---|---|
| Objectif principal | Créer, convertir et planifier des pipelines de données | Interroger et expliquer les données en langage naturel |
| Sortie principale | Flux de travail de traitement de données exécutable | SQL, réponses, graphiques ou résultats d’analyse |
| Changer les données ? | Transférable, convertible et écrivable vers la cible | Généralement axé sur la lecture et l’analyse |
| Techniques d’exécution | Tâches Spark et orchestration de pipelines | Moteur de requête de base de données |
| Risques principaux | Conversion erronée, écrasement ou migration de données | Recherche erronée ou interprétation des résultats |
Informations de base
| Projet | Contenu |
|---|---|
| Nom du produit | Ask On Data |
| Type de produit | Ingénierie de données d’IA générative et plateformes ETL |
| Mode d’interaction | Chat en langue naturelle anglaise, SQL, Python et YAML |
| Capacités principales | Intégration des données, nettoyage, transformation, aperçu, orchestration et planification |
| Cadre d’exécution | Apache Spark |
| Mode de gestion | Cloud gratuit, cloud d’entreprise et solution d’hébergement auto-géré annoncée sur le site officiel |
| Modèle de prix | Demande de prix gratuite auprès des entreprises |
| Est-ce open source | Le site officiel indique qu’il s’agit de logiciel open source, mais le répertoire officiel est actuellement vide et ne comporte pas de licence. |
| Adéquat pour les utilisateurs | Ingénieurs de données, analystes, scientifiques des données, équipes BI et équipes de données d’entreprise |
Indice de recommandation
L’indice de recommandation global est de 3,2 sur 5. Ask On Data combine le langage naturel, la prévisualisation des données, le contrôle du code et les pipelines Spark ; l’approche du produit est claire, mais les entrepôts vides, un manque de documentation et des prix d’entreprise peu transparents limitent sa vérifiabilité actuelle.
Questions fréquentes
À quoi sert principalement Ask On Data ?
Il est utilisé pour créer des pipelines de migration de données, de nettoyage, de connexion, de conversion et de planification via des chats.
Est-ce un outil de chat et de questions-réponses pour bases de données ?
Pas tout à fait, sa sortie principale est un flux de travail d’ingénierie de données exécutable, et non seulement des réponses à des requêtes.
Ask On Data est-il gratuit ?
Les versions auto-hébergées et la version cloud de base listées sur le site officiel sont gratuites, tandis que la version cloud pour entreprises nécessite une demande de prix.
Quelles sont les limitations de la version cloud gratuite ?
Il ne prend en charge que Excel et CSV, avec une limite de 5 MB par fichier, et il n’y a pas de planification de tâches.
Est-il possible de se connecter à une base de données ?
Le site officiel indique que les versions open source et entreprise prennent en charge les bases de données comme sources et destinations ; il convient de vérifier les connecteurs spécifiques avant utilisation.
Peut-on voir la logique de traitement générée par l’IA ?
Il est possible de visualiser et d’éditer le YAML, ainsi que d’utiliser SQL, Python et du code Spark pour la phase de planification afin d’améliorer le contrôle.
Ask On Data est-il vraiment open source ?
Le site officiel affirme être open source, mais le dépôt public officiel ne contient actuellement ni code ni licence, ce qui empêche pour l’instant de procéder à une audit indépendant et à un déploiement.
Les données seront-elles modifiées immédiatement ?
Lors de la création des pipelines, une prévisualisation est chargée en premier ; les données réelles ne sont traitées que lorsque la tâche est déclenchée manuellement ou exécutée selon le planning.
Est-il adapté pour traiter directement la base de données de production ?
Il n’est pas recommandé de l’utiliser directement sans test ; il convient d’abord d’utiliser un compte à faibles droits, des données de test, une vérification manuelle et des sauvegardes fiables.
Outils similaires à Ask On Data


 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164