




LLaMA Factory
Framework unifié open source pour le fine-tuning, l’évaluation et l’inférence des grands modèles
Étiquettes :Framework de développement d’IAQu’est-ce que LLaMA Factory ?
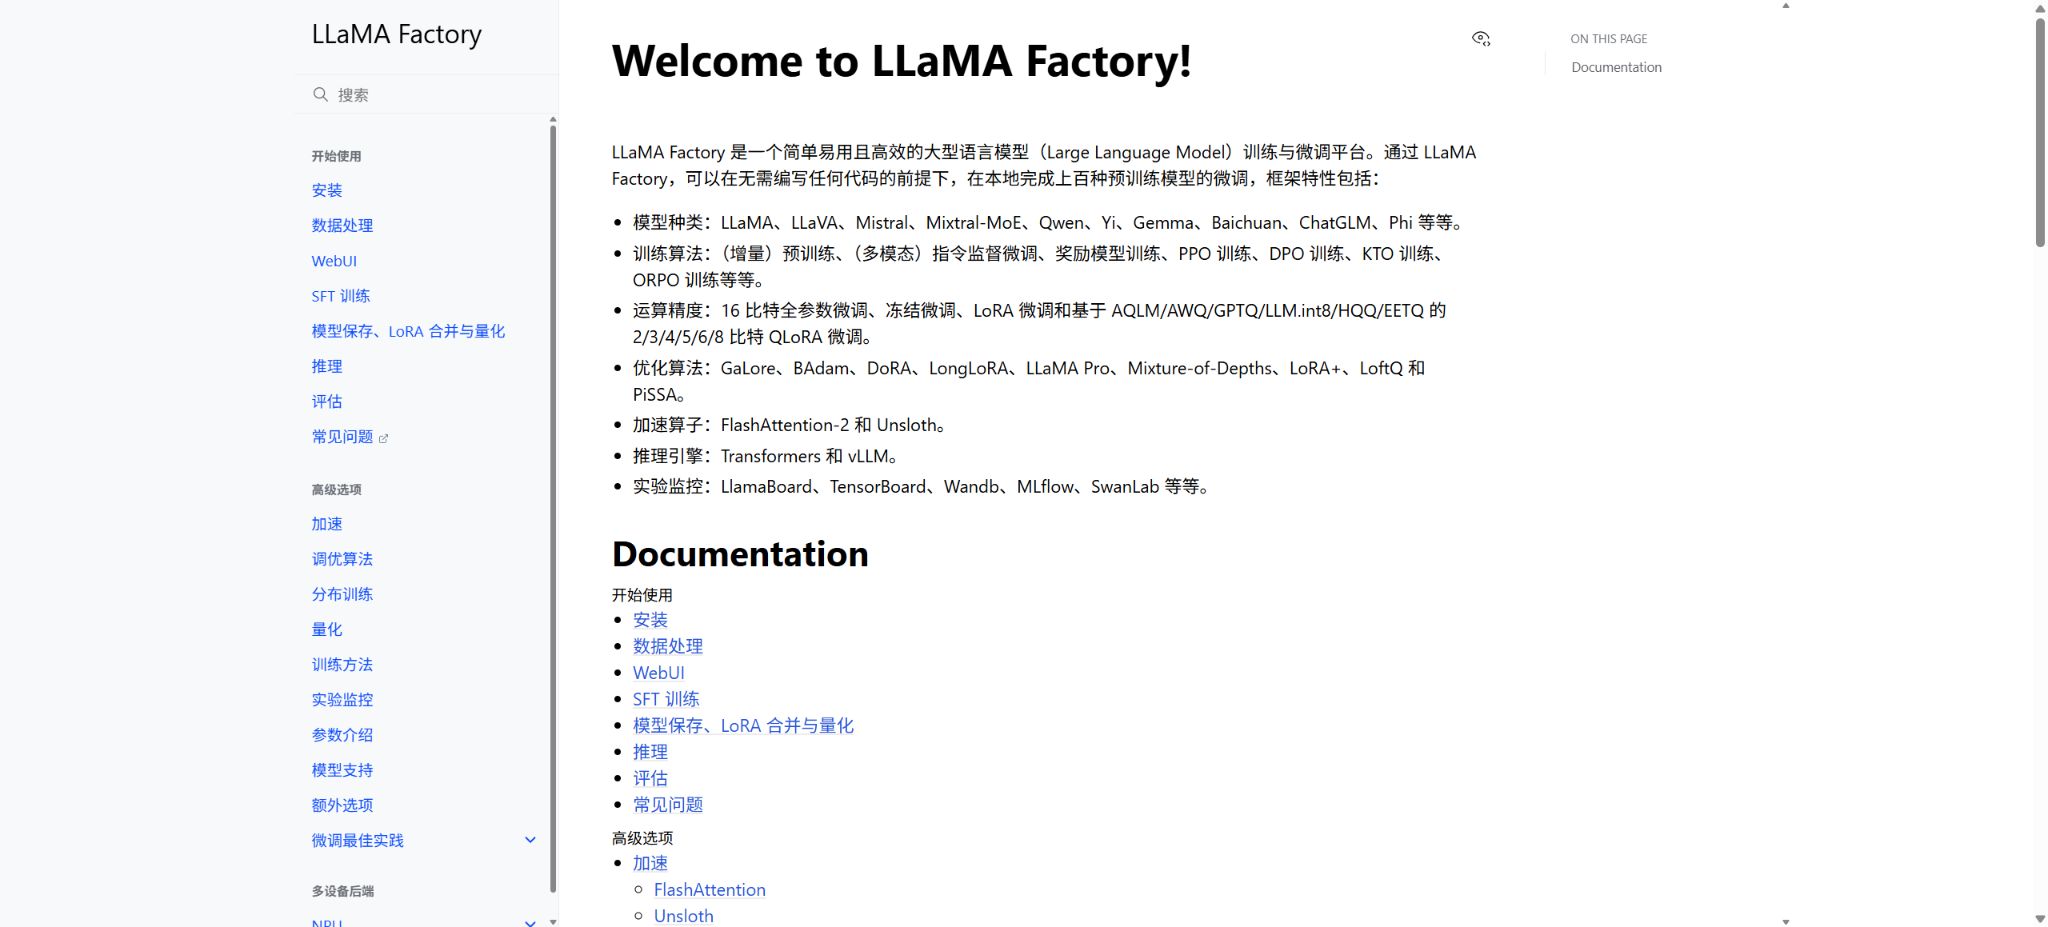
LLaMA Factory est un framework open source pour l’entraînement, le fine-tuning, l’évaluation et l’inference des grands modèles de langage et des modèles de langage visuel. Il intègre le chargement des modèles, les templates de données, les phases d’entraînement, le fine-tuning à faible consommation de paramètres, l’entraînement distribué, la quantification, l’exportation et les points d’implémentation dans une interface en ligne de commande et une WebUI unifiées, dans le but de réduire les coûts liés à la rédaction répétée de code d’entraînement pour différents modèles.
Le projet prend en charge plus de 100 LLM et VLM, couvrant des séries courantes telles que LLaMA, LLaVA, Qwen, Mistral, Mixtral, Gemma, Yi, Baichuan, ChatGLM, Phi, etc. Le framework ne fournit pas de poids de modèle, de données d’entraînement ni de puissance GPU ; l’utilisateur doit toujours respecter les licences propres à chaque modèle et à chaque ensemble de données.
Mise à jour de la version 0.9.5
À la date de cette vérification, la dernière version officielle publiée est 0.9.5, sortie en mai 2026. Elle intègre principalement le soutien pour Qwen3.5, Qwen3.6, Gemma 4 et Transformers v5, ainsi que des adaptations et correctifs liés à FSDP2, ROCm 7.2 et Intel XPU.
La documentation d’installation actuelle met également à jour les exigences en matière d’environnement Python à 3.11 ou version ultérieure ; lors de la mise à niveau de projets anciens, il convient de vérifier à nouveau les combinaisons compatibles des composants PyTorch, Transformers, CUDA ou NPU.
Les changements de numéro de version peuvent affecter les modèles de template, les champs de configuration et le backend de quantification. Il n’est pas recommandé de suivre directement la branche principale pour les tâches en production ; il convient plutôt de fixer les versions de LLaMA Factory, Transformers, PyTorch, les bibliothèques d’accélération et le modèle, puis de procéder à une mise à niveau après validation via des tâches courtes.
UI Web sans code
LLaMA Factory WebUI propose quatre types d’interfaces principales : l’entraînement, l’évaluation et la prédiction, la conversation, ainsi que l’export. L’utilisateur peut choisir le modèle, la phase d’entraînement, le jeu de données, la méthode de fine-tuning, le nombre de bits de quantification, le taux d’apprentissage, la taille du batch et le répertoire de sortie, puis lancer la tâche et consulter les journaux. Cela convient aux utilisateurs qui découvrent pour la première fois le fine-tuning des grands modèles ou qui ont besoin d’ajuster les paramètres à plusieurs reprises.
La WebUI ne sert qu’à la configuration et à l’accès aux tâches, elle ne réduit pas les besoins en mémoire vidéo et en puissance de calcul du modèle lui-même. L’interface échouera également à se lancer en cas d’erreurs dans le chemin du modèle, des modèles de conversation, du format des données, de la méthode de quantification ou des paramètres de l’environnement du dispositif.
Les tâches de longue durée doivent toujours s’accompagner d’une gestion de processus, de journaux, de points de contrôle et d’un suivi de l’entraînement.
Ligne de commande et configuration YAML
Les utilisateurs familiers avec les processus d’ingénierie peuvent lancer l’entraînement via la ligne de commande et des fichiers YAML. Le fichier de configuration permet de stocker l’emplacement du modèle, le jeu de données, les modèles de base, les étapes d’entraînement, le type de fine-tuning, l’optimiseur, la précision, le mode distribué, la stratégie de sauvegarde et les paramètres d’évaluation, ce qui facilite son intégration dans un système de contrôle de version et sa reproductibilité sur plusieurs machines.
Un projet officiel doit archiver ensemble la configuration, le verrouillage des dépendances, les versions des données, la graine aléatoire et les soumissions de code. Les clés API, les tokens d’accès et les adresses de stockage interne ne doivent pas être écrits directement dans des fichiers YAML ou des journaux publics ; ils doivent être gérés via des variables d’environnement ou des secrets.
Format du jeu de données et modèle
Les ensembles de données personnalisés nécessitent généralement que leur nom, le chemin du fichier, la correspondance des champs et le format soient enregistrés dans la configuration data_info. Le framework prend en charge le fine-tuning par instructions, les dialogues, les messages multiples, les paires de préférences, les retours KTO, ainsi que les données multimodales telles que les images et les vidéos.
Un format de données incompatible avec la phase d’entraînement sélectionnée provoquera directement une erreur ou des étiquettes incorrectes.
Les modèles de chat déterminent les messages système, les marques de rôle, les séparateurs et les masques d’étiquettes. L’entraînement, l’évaluation, la conversation, la fusion et le déploiement via API doivent utiliser des modèles cohérents ;
Ne pas se fier uniquement à la baisse de la perte ne permet pas de détecter un décalage du modèle ; il est préférable d’inspecter au hasard les tokens d’entrée et les tokens cibles après le Tokenizer.
Pré-entraînement et fine-tuning supervisé
Le cadre prend en charge le pré-apprentissage incrémental et le fine-tuning supervisé. Le pré-apprentissage incrémental permet au modèle de base de continuer à apprendre du corpus sectoriel, tandis que le fine-tuning supervisé entraîne la capacité à suivre des instructions à l’aide d’échantillons de questions-réponses ou de dialogues.
La structure des données, le taux d’apprentissage, la durée de l’entraînement et les méthodes d’évaluation diffèrent pour les deux ; on ne doit pas se substituer l’un à l’autre en modifiant uniquement un paramètre de phase.
Les corpus sectoriels doivent être dédoublés, nettoyés, soumis à une vérification des droits d’auteur et à un traitement de la vie privée. Les données supervisées nécessitent également une vérification de la justesse des réponses, des limites de refus de réponse, de la cohérence du format ainsi que de la distribution en longueur ; les données synthétiques de faible qualité introduiront des schémas d’erreurs dans le modèle.
Full, Freeze et LoRA
Le fine-tuning à tous les paramètres met à jour la majeure partie ou tous les paramètres du modèle, offrant une grande flexibilité mais entraînant les coûts les plus élevés en mémoire vidéo, en communication et en fichiers de sauvegarde. Le gel ne forme que des couches ou des modules sélectionnés, trouvant un équilibre entre ressources et performances.
LoRA entraîne un petit nombre de paramètres grâce à des adaptateurs à rang faible, et constitue la méthode la plus couramment utilisée pour l’adaptation sur les postes de travail personnels et pour les tâches multiples.
Le framework prend également en charge des méthodes telles que DoRA, LoRA+, LongLoRA, PiSSA, LoftQ, LLaMA Pro, Mixture-of-Depths, GaLore et BAdam. Ces différentes méthodes ne sont pas compatibles avec tous les modèles, appareils et backends distribués ; il convient de se référer à la documentation de la version actuelle ainsi qu’à des expériences sur de petits échantillons avant de choisir une méthode.
QLoRA et quantification à faible nombre de bits
QLoRA entraîne des adaptateurs LoRA sur des modèles de base à faible nombre de bits, ce qui permet de réduire considérablement l’occupation de la mémoire vidéo. Le framework prend en charge les configurations 2, 3, 4, 5, 6 et 8 bits, et peut s’intégrer à des backends tels que AQLM, AWQ, GPTQ, LLM.int8, HQQ et EETQ, mais sa disponibilité réelle est limitée par le système d’exploitation, la GPU, la structure du modèle et les versions des dépendances.
L’entraînement à faible nombre de bits ne signifie pas que n’importe quelle carte graphique peut le gérer. En plus des poids du modèle, il faut également allouer de l’espace pour les KV, les activations, l’optimiseur, les gradients, les lots de données et la longueur du contexte.
La quantification peut également réduire le débit ou la précision ; il convient d’évaluer en même temps la stabilité de l’entraînement et les effets en aval.
Optimisation des préférences et apprentissage par renforcement
LLaMA Factory prend en charge l’entraînement de modèles récompensés, ainsi que des processus d’alignement des préférences tels que PPO, DPO, KTO, ORPO, et couvre de nombreuses variantes d’optimisation directe des préférences. Les méthodes du type DPO utilisent généralement des paires de réponses gagnantes/perdantes, KTO peut employer des échantillons de feedback positif/négatif, tandis que PPO a besoin de composants liés aux récompenses, à la valeur et à la stratégie.
Les données de préférences doivent être contrôlées en ce qui concerne leur longueur, leur thème, leur difficulté et les biais des évaluateurs. Une augmentation de la récompense ne signifie pas nécessairement une amélioration globale de la fiabilité, de la sécurité et de l’expérience utilisateur ; avant une publication officielle, il est nécessaire de disposer de benchmarks indépendants, d’évaluations aveugles effectuées par des humains, de tests de red team et d’évaluations de régression.
Ajustement de modèles multimodaux
Le framework permet d’entraîner des architectures multimodales telles que LLaVA et Qwen, modèles visuo-linguistiques, en entrant à la fois des images ou des vidéos ainsi que des messages de texte. Les tâches multimodales conviennent aux questions-réponses visuelles, à la compréhension de documents, à l’analyse de graphiques et à la description d’images, mais les modèles diffèrent en ce qui concerne les placeholders médias, la résolution, l’échantillonnage des frames et les exigences de templates.
Les données d’images et de vidéos augmentent considérablement les coûts de stockage, de décodage, de mémoire vidéo et de chargement des données. Avant le téléchargement ou l’entraînement, il faut également gérer des risques tels que les portraits de personnes, les images protégées par des droits d’auteur, les documents sensibles et les coordonnées géographiques.
DeepSpeed, FSDP et entraînement multi-ordinateur
L’entraînement des grands modèles peut faire appel à des solutions telles que DDP, DeepSpeed, FSDP, FSDP2 et Ray, afin de s’étendre à plusieurs cartes ou machines grâce à la parallélisation des données, au partitionnement des paramètres et au partitionnement de l’état de l’optimiseur. La version 0.9.5 ajoute la prise en charge de FSDP2, offrant un accès aux interfaces de partitionnement plus récentes de PyTorch.
L’entraînement distribué nécessite une gestion unifiée, des bibliothèques de communication, un réseau, du temps d’exécution sur machine hôte et un stockage partagé, ainsi qu’une configuration adéquate du batch global, de l’accumulation des gradients et des méthodes de sauvegarde. Le passage direct d’une configuration à une seule carte à plusieurs machines peut entraîner des problèmes de taux d’apprentissage, de débit, de communication et de fichiers de checkpoint.
NVIDIA, AMD, Intel et Ascend NPU
Les environnements couramment utilisés incluent NVIDIA CUDA, et un support pour AMD ROCm et Intel XPU est également fourni. Les scénarios Ascend couvrent les séries de formation Atlas A2 et A3, permettant le pré-entraînement, le SFT, les modèles de récompense, le DPO, ainsi que Full, Freeze, LoRA, la fusion d’adaptateurs, DDP, FSDP, FSDP2 et DeepSpeed, et il est possible d’utiliser certains opérateurs de fusion NPU.
L’environnement Ascend doit correspondre aux versions de CANN, des pilotes, du firmware, de PyTorch et de torch-npu ; CUDA, ROCm et XPU disposent également de leurs propres matrices.
Le fait que le nom du matériel apparaisse dans le document ne signifie pas que tous les modèles et opérateurs ont été vérifiés ; des tests de compatibilité doivent être effectués en fonction du modèle, de la précision, des opérateurs et de la taille du cluster.
FlashAttention, Unsloth et accélération de l’entraînement
Le framework peut utiliser FlashAttention-2 pour réduire la consommation de mémoire et le temps de calcul liés à l’attention, et permet de choisir des chemins d’accélération tels qu’Unsloth. Ils ont des exigences précises en matière d’architecture GPU, de PyTorch, de CUDA, de Triton et de mise en œuvre du modèle ; en cas d’échec d’installation, il convient d’abord de revenir à l’environnement de base officiel pour validation.
L’amélioration du débit ne doit pas se faire au détriment de la stabilité numérique. Après avoir activé la précision mixte, les points de contrôle des gradients, la compilation ou la fusion d’opérateurs, il convient de comparer la perte, les gradients, la mémoire vidéo, la vitesse et l’évaluation finale, en conservant une configuration de référence permettant un retour en arrière.
Checkpoint, fusion LoRA et export du modèle
Le processus d’entraînement peut enregistrer des checkpoints par nombre d’étapes ou d’époques, et il est possible de définir le nombre à conserver. Chaque expérience doit utiliser un répertoire de sortie indépendant afin d’éviter l’écrasement des adaptateurs correspondant à des données, des modèles ou des hyperparamètres différents.
Une fois l’entraînement de LoRA terminé, il peut être fusionné avec le modèle de base et exporté ou quantifié selon le backend cible.
L’opération de fusion nécessite suffisamment de mémoire CPU, de mémoire vidéo et d’espace temporaire sur disque. La taille du modèle résultant est proche de celle des poids de base, et il n’est pas possible d’obtenir ainsi des droits de redistribution qui ne sont pas accordés au modèle de base ;
Avant la publication, il faut joindre la licence appropriée et la carte du modèle.
Dialogue, raisonnement par lots et vLLM
Le framework offre des interfaces de conversation en ligne de commande et via le navigateur, permettant de charger des modèles de base ou des adaptateurs LoRA spécifiques pour les tests. Les prédictions en batch peuvent être effectuées à l’aide des moteurs d’inférence Transformers ou vLLM ; vLLM est plus adapté à une génération à fort débit, mais ses capacités de support, ses formats de quantification et sa gestion de la mémoire vidéo diffèrent de ceux utilisés lors de l’entraînement.
Un entraînement réussi ne signifie pas pour autant que le déploiement est opérationnel. Il convient de tester le délai du premier token, le débit, la concurrence, la longueur du contexte, les conditions d’arrêt, la sortie structurée, l’utilisation de la GPU et les entrées anormales, et de s’assurer que l’Adapter, le modèle de template et le modèle de base correspondent parfaitement.
API compatible OpenAI
En utilisant la commande de démarrage API, le modèle peut être mis à disposition en tant que service compatible OpenAI, ce qui facilite l’intégration par les clients existants, les outils d’évaluation ou les applications. Le serveur permet de spécifier le modèle, le template, le type de fine-tuning et le chemin de l’adaptateur, et peut également être combiné avec une sortie en flux continu.
Cette interface est un point d’entrée pour le déploiement et non un service cloud hébergé. Pour une utilisation en production, il est nécessaire de mettre en place soi-même l’authentification, TLS, la limitation du trafic, l’audit, la sécurité du contenu, les files d’attente, les vérifications de santé, la récupération automatique et l’isolation des ressources ; il ne faut pas exposer directement des ports non authentifiés à Internet.
Surveillance et rapport d’essai
La configuration d’entraînement peut être connectée à des outils de suivi d’expériences tels que TensorBoard, Weights & Biases, SwanLab, MLflow et Trackio, afin d’enregistrer la perte, le taux d’apprentissage, la récompense, le débit, la mémoire vidéo et les indicateurs d’évaluation. L’équipe doit standardiser le nom du projet, celui des exécutions, les étiquettes et l’intervalle de sauvegarde, afin d’éviter que les expériences ne soient pas traçables.
La plateforme de surveillance peut recevoir des configurations, des journaux et des échantillons générés. Lorsqu’il s’agit de données d’entreprise ou d’instructions utilisateur, il convient de choisir un stockage local ou une solution privatisée, et de masquer les informations avant leur transmission.
Mode d’installation
La procédure d’installation courante consiste à cloner le dépôt officiel, à exécuter une installation modifiable dans un environnement Python indépendant, à installer selon les besoins les dépendances relatives à l’évaluation, à la quantification, au traitement distribué, à la NPU ou à l’inférence, et enfin à valider avec des commandes de version. Les combinaisons de dépendances pour Windows, Linux, WSL, Docker et différentes cartes d’accélération ne sont pas identiques.
Avant l’installation, il est préférable de déterminer d’abord les équipements de formation et le backend, puis de choisir les versions de PyTorch et des pilotes ; cela est plus stable que d’installer toutes les dépendances possibles en une seule fois. Les machines en ligne doivent conserver une liste de l’environnement, et stocker le cache du modèle, les données, les résultats et les dossiers temporaires sur un disque ayant suffisamment d’espace.
Prix et coûts d’utilisation
Le logiciel principal de LLaMA Factory est open source et gratuit, sans frais de abonnement officiels. Les coûts réels proviennent des ressources GPU ou NPU, des serveurs cloud, du stockage, du réseau, du téléchargement des modèles, de la création des données, de leur annotation, de l’évaluation et de la maintenance.
Le coût de l’entraînement à tous les paramètres, de l’entraînement multi-machine et des données de contexte long est bien plus élevé que celui des expériences à petite échelle avec LoRA.
Les services hébergés tels que LLaMA Factory Online qui apparaissent sur Internet sont des produits cloud indépendants ou des services collaboratifs ; le prix unitaire des GPU et leurs fonctionnalités varient dynamiquement, et leur prix ne peut pas être considéré comme celui du logiciel officiel d’un projet open source.
Est-ce open source ?
L’entrepôt LLaMA Factory est soumis à la licence Apache License 2.0, ce qui permet de l’utiliser, de la modifier et de la distribuer conformément à cette licence. Cette licence ne couvre que le code du projet ; elle ne s’applique pas automatiquement aux modèles tiers tels que Meta, Qwen, Google, Zhipu, ni aux données des utilisateurs, aux ensembles de données ou au contenu généré.
Avant une utilisation commerciale, il est nécessaire de vérifier séparément les dépendances du code, les poids des modèles, le tokenizer, les conditions relatives aux ensembles de données et aux ensembles d’évaluation. Certains modèles imposent des restrictions concernant l’usage commercial, la taille de l’utilisateur, le domaine ou les modalités de redistribution.
Guide d'utilisation de LLaMA Factory
Terminer une tâche de base
- Installer et configurer LLaMA Factory, et créer des projets et des noms d’exécution indépendants pour les expériences ;
- Enregistrer les hyperparamètres, la version des données, la version du code et la graine aléatoire dans le script d’entraînement ;
- Mettre à jour la tâche d’initialisation via la version 9.5 et se connecter au service cloud ou privé approprié ;
- Utiliser une UI Web sans code pour enregistrer en continu les pertes, les indicateurs, les journaux et l’état du matériel ;
- Exécuter un entraînement à petite échelle pour vérifier que le nombre d’itérations, les unités, les courbes et les échantillons multimédias sont corrects ;
- Après achèvement, enregistrer le modèle, les paramètres, les résultats ainsi que la description de l’expérience reproductible ;
Créer des flux de travail professionnels réutilisables
- Unifier les normes de nommage des projets, des expériences, des indicateurs et des étiquettes ;
- Intégrer la mise à jour de la version 9.5, l’interface Web sans code ainsi que la ligne de commande et les configurations YAML dans le modèle d’entraînement ;
- Établir des liens de version pour les ensembles de données, le code, l’environnement et les modèles ;
- Utiliser le même ensemble d’évaluation et les mêmes conditions expérimentales pour comparer, afin d’éviter de ne se baser que sur des courbes lissées ;
- Restreindre la portée du téléchargement des échantillons sensibles, des prompts et des sorties du modèle ;
- Définir les alertes d’anomalies, les stratégies de conservation et la révision manuelle avant de les déployer à l’équipe ;
À qui s’adresse-t-il ?
- Apprenants qui souhaitent effectuer leur première fine-tuning LoRA ou QLoRA via une WebUI ;
- Des ingénieurs en algorithmes sont nécessaires pour former de manière uniforme divers LLM et VLM open source ;
- Équipe de recherche menant des expériences sur les modèles SFT, DPO, KTO, PPO et de récompense ;
- Les institutions ayant besoin d’un entraînement distribué avec DeepSpeed, FSDP ou l’NPU Ascend ;
- Développeurs souhaitant combiner l’adaptateur, évaluer en masse et déployer des API compatibles.
Avantages du produit
- Couvre plus de 100 langues et des modèles de langage visuel ;
- WebUI et CLI offrent à la fois une approche facile pour les débutants et des processus de projet reproductibles ;
- Full, Freeze, LoRA, QLoRA ainsi que de nombreuses nouvelles méthodes de fine-tuning disponibles ;
- Prend en charge l’entraînement préalable, le SFT, la modélisation des récompenses et diverses étapes d’optimisation des préférences ;
- Compatibilité avec DeepSpeed, FSDP, vLLM et divers types de matériel ;
- Apache 2.0 est open source, sa communauté est active et les mises à jour sont fréquentes.
Restrictions et précautions
- La liste des modèles pris en charge est longue, mais toutes les combinaisons de phases d’entraînement, de stratégies de quantification et de matériel ne sont pas disponibles.
- Le WebUI ne peut pas remplacer le nettoyage des données, l’estimation de la mémoire vidéo, ni la gestion et l’évaluation des dépendances.
- Le fine-tuning à tous les paramètres nécessite une grande quantité de mémoire vidéo et de stockage, et QLoRA peut également être limité par le système d’exploitation et le backend de quantification.
- Activer trust_remote_code exécutera le code fourni par le dépôt de modèles ; il convient de fixer une Revision fiable et d’examiner l’origine.
- Les services publics nécessitent une authentification et des contrôles de sécurité, tandis que les données d’entraînement exigent une gestion de la vie privée, des droits d’auteur et des risques d’injection de prompts.
Questions fréquentes
LLaMA Factory est-il gratuit ?
Le code source est gratuit et est licencié sous la licence Apache 2.0. Les hébergements GPU en cloud, le stockage, les modèles et les données peuvent entraîner des frais ; les services de hébergement tiers sont facturés séparément.
Quelles méthodes de fine-tuning LLaMA Factory prend-elle en charge ?
Prend en charge Full, Freeze, LoRA, QLoRA, ainsi que des extensions telles que DoRA, LoRA+, PiSSA, etc. ; les étapes d’entraînement comprennent l’entraînement préalable, SFT, le modélisage des récompenses, PPO, DPO, KTO et ORPO, etc.
Est-ce que c’est possible sans expérience en programmation ?
La configuration de l’entraînement, de l’évaluation, du dialogue et de l’export peut se faire via l’interface WebUI, mais il est néanmoins nécessaire de comprendre le modèle, les formats de données, les modèles de template, la mémoire vidéo et les dépendances environnementales. Il est recommandé d’utiliser d’abord un petit modèle avec une petite quantité de données pour valider l’ensemble du processus.
Est-il possible de déployer une API ?
Il est possible de démarrer une API compatible OpenAI, ou d’utiliser vLLM pour des inférences en batch ou à fort débit. Pour une mise en ligne officielle, il est nécessaire de mettre en place soi-même l’authentification, la limitation du trafic, le contrôle de sécurité et la surveillance.
Est-ce que c’est compatible avec l’NPU Ascend ?
Il prend en charge les séries d’entraînement Atlas A2 et A3, ainsi que diverses phases d’entraînement et solutions distribuées, mais il faut que les versions de CANN, du pilote, du firmware, de PyTorch et de torch-npu soient compatibles.
LLaMA Factory est-il un modèle ?
Non. C’est un cadre de formation et d’ajustement fin, qui ne dispose pas de poids de modèles prêts à l’emploi pour une utilisation commerciale directe.
L’utilisateur doit sélectionner et télécharger le modèle de base conforme à la licence.
Outils similaires à LLaMA Factory


 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164