




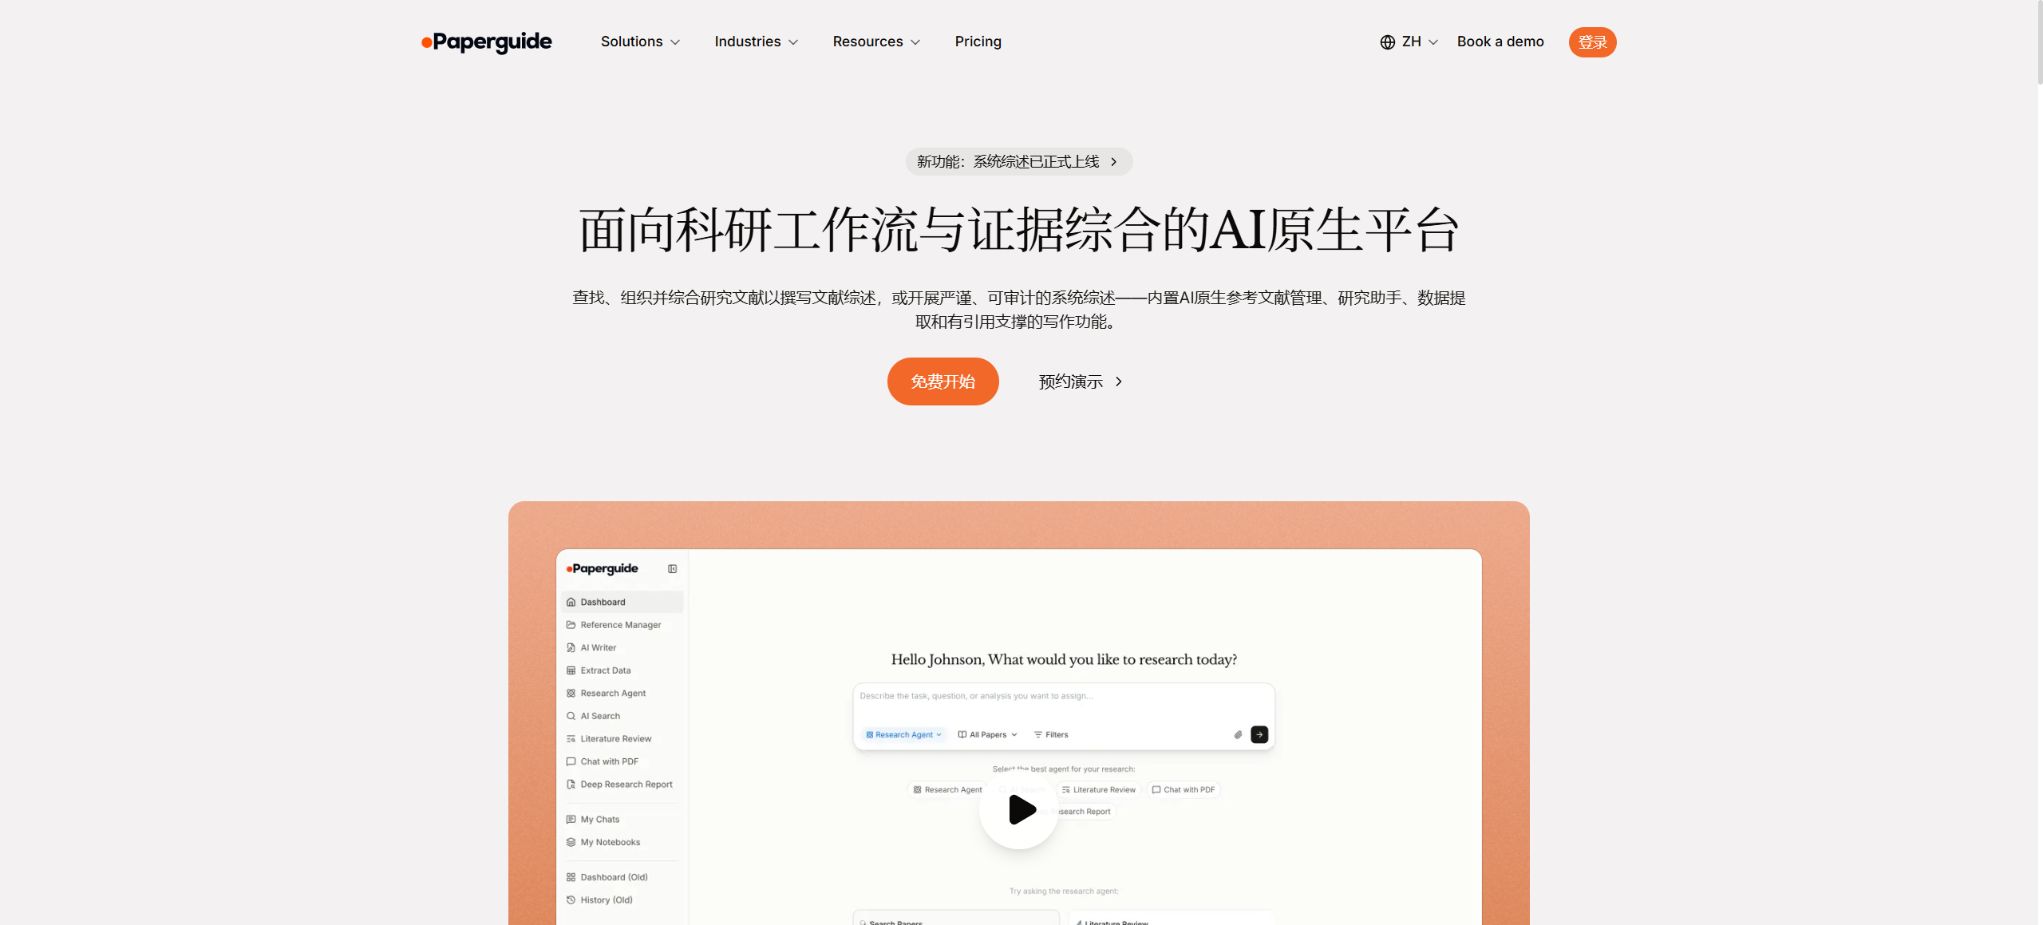
Paperguide
KI-Forschungswerkbank für die Erfassung von Forschungsergebnissen, Lektüre, Notizen, Zitaten und Systemüberblicken
Tags:KI-Lern-WebsitesWas ist ein Paperguide?
Paperguide ist eine umfassende AI-Forschungsplattform für Studenten, Lehrkräfte, Wissenschaftler und Entwicklerteams, die die Suche nach wissenschaftlichen Artikeln, das Lesen des vollständigen Textes, die Verwaltung von Literaturquellen, die Extraktion von Daten, systematische Übersichten sowie das Verfassen wissenschaftlicher Texte in einem einzigen Arbeitsbereich vereint. Nutzer können nicht nur in über 200 Millionen wissenschaftlichen Artikeln suchen, sondern auch ihre eigenen PDF-Dateien und Literaturquellen importieren. Anschließend kann der Research Agent diese Daten analysieren, strukturieren und Ergebnisse mit Quellenangaben erzeugen.
Bis zur aktuellen Überprüfung umfassen die Hauptfunktionen von Paperguide AI Search, Research Agent, Literature Review, Deep Research Report, Chat with PDF, Systematic Review, Extract Data sowie Reference Manager.
AI Writer, Team-Workspaces, Search API und MCP.
Es handelt sich um ein Cloud-exklusives Produkt; die Kernanwendung bietet keine open-source-Version für eine lokale Installation.
Kernfunktionen
1. AI-Suchverfahren für wissenschaftliche Artikelsuche
Die AI-Suche ermöglicht die Suche nach Artikeln anhand von Forschungsfragen, Themen, Titeln oder Beschreibungen in natürlicher Sprache. Standardmäßig werden mehr als 200 Millionen Artikel aus Quellen wie PubMed, arXiv, OpenAlex und Semantic Scholar durchsucht. Es ist auch möglich, die Suche auf PubMed, arXiv oder den eigenen Reference Manager einzuschränken.
Das Ergebnis ist keine einfache Liste von Links, sondern eine mit Quellen versehene Antwort, die auf hochrelevanten Artikeln basiert, sowie bis zu 20 wichtige Referenzmaterialien.
Die kostenlose Version bietet monatlich 20 Suchvorgänge mit AI Search; ab der Version Plus gibt es keine Beschränkung mehr. AI Search durchsucht nur wissenschaftliche Quellen und nicht gewöhnliche Webseiten, Blogs oder das öffentliche Internet.
Für Branchennews, regulatorische Bekanntmachungen oder Unternehmensinformationen sollten entsprechende Datenbanken oder offizielle Quellen genutzt werden.
2. Forschungsagent und Literaturübersicht
Der Research Agent kann sich auf eine bestimmte Frage konzentrieren und mehrere Suchschritte durchführen, um verschiedene Forschungsmethoden sowie Ergebnisse miteinander zu vergleichen. Dadurch können Übereinstimmungen, Widersprüche sowie Lücken in den vorhandenen Informationen gefunden werden. Er kann sowohl mit 200 Millionen Artikeln arbeiten als auch nur die in der Arbeitsumgebung des Benutzers vorhandenen Daten analysieren.
Chat mit PDF und Literature Review teilen nun eine einheitliche Agent-Architektur mit Research Agent – Nutzer können von der Suche aus weitere Fragen stellen, Artikel lesen und Übersichten erstellen.
Der Literature Review Agent kann zunächst die relevanten Abkommen festlegen und anschließend thematische Übersichten sowie Zitate zu bis zu 50 Artikeln erstellen. Der Deep Research Report eignet sich für Aufgaben, bei denen mehrere Suchschritte überwacht und gesteuert werden sollen.
Übersichten, die von KI erzeugt werden, sind weiterhin Forschungsvorläufe; eine manuelle Überprüfung des Forschungsdesigns, der Evidenzstärke, der wiederholten Stichproben sowie der Genauigkeit der Zitate darf nicht ausgelassen werden.
3. Chat with PDF
Nach dem Hochladen eines PDFs können Nutzer nach Methoden, Beispielen, Ergebnissen, Einschränkungen oder dem Auftritt eines bestimmten Satzes fragen. Das System bietet einen integrierten Leser sowie Seitenzitierungen, ermöglicht ein tiefgehendes Lesen eines einzelnen Dokuments und auch den Vergleich mehrerer Arbeiten.
Bei Fragen wie „Wo wurde das gesagt?“ wird der entsprechende ursprüngliche Text angezeigt, damit eine Überprüfung möglich ist.
Scans, komplexe Tabellen, Formeln, zusätzliche Anhänge sowie eine schlechte OCR-Qualität können die Auswertung beeinträchtigen. Für wichtige Daten wie Effektgrößen, Konfidenzintervalle, Dosen, Sicherheitsvorfälle und statistische Signifikanz sollte die ursprüngliche Seite überprüft werden; es reicht nicht aus, nur die Antworten aus dem Chat zu kopieren.
4. Strukturierte Extraktion von Daten
„Extract Data“ ordnet mehrere wissenschaftliche Artikel in Arbeitsbücher. Nachdem der Benutzer die Felder definiert hat, kann die KI die Anzahl der Probanden, das Forschungsdesign, die eingesetzten Interventionen, die Ergebnisse sowie die Effekte und Einschränkungen in großer Menge extrahieren und die Quellen zu den Ergebnissen verknüpfen.
Die kostenlose Version kann maximal 10 Dokumente pro Durchgang verarbeiten, wobei pro Tabelle 5 Spalten möglich sind; die Version Plus und höher können maximal 100 Dokumente sowie 50 Spalten pro Durchgang verarbeiten. Die Versionen Pro, Max und Enterprise unterstützen zudem die Extraktion von Bildern und Tabellen.
Die Felder sollten als klare Anweisungen formuliert werden, anstatt nur allgemeine Bezeichnungen wie „Ergebnis“ oder „Methode“ zu verwenden. Es ist am besten, Endpunkte, Zeitpunkte, Einheiten sowie Regeln für fehlende Werte getrennt voneinander festzulegen, damit die Forscher diese auswählen oder einzeln überprüfen können.
5. PRISMA-Systematische Übersichtsarbeit
Paperguide bietet eine umfassende sechsstufige Systemüberprüfung: Protocol, Papers, Filterung nach Titel und Zusammenfassung, Filterung des Volltextes, Datenauswertung und Berichterstattung. Die KI erstellt die Einbeziehungskriterien und Ausschlusskriterien sowie die Auswertungsfelder für die Forschungsfragen, führt die Suche und Filterung durch, liefert Belege für jedes Kriterium und erzeugt eine Dokumentation der Methoden sowie ein PRISMA-Diagramm.
Jede Phase muss von einer bestimmten Person überprüft werden, bevor man zur nächsten übergehen kann.
In der Phase der Titelzusammenfassung können „Include“, „Exclude“ oder „Maybe“ angegeben werden. In der vollständigen Textphase muss das PDF gelesen werden, um eine Entscheidung über die Aufnahme oder Ausschluss des Artikels zu treffen. Artikel ohne PDF werden als nicht verfügbar markiert und in die PRISMA-Eignungsprüfung einbezogen.
Alle Entscheidungen der KI, manuelle Eingriffe, Protokoll-Snaps sowie Aktionen der Mitglieder werden in Audit-Protokollen festgehalten. So kann ein einzelner Artikel von seiner Quelle bis zum endgültigen Ergebnis nachverfolgt werden.
Plus erlaubt in einer einzigen Systemüberprüfung maximal 1000 Artikel, Pro maximal 5000 Artikel, Max maximal 10.000 Artikel und Enterprise maximal 20.000 Artikel; Max und Enterprise bieten eine PRISMA-konforme Zwei-Review-Filterung.
Das System unterstützt die Exportierung in BibTeX, RIS und CSV in verschiedenen Phasen. Tabellen können extrahiert werden, um weitere Analysen durchzuführen, und der endgültige Bericht kann als PDF und DOCX exportiert werden.
Auditerbarkeit bedeutet nicht automatisch, dass die Kriterien für Veröffentlichung erfüllt sind. Die Forscher müssen weiterhin das Protokoll im Voraus registrieren, Suchanfragen für mehrere Datenbanken erstellen, graue Literatur berücksichtigen, Risiken von Verzerrungen sowie die Zuverlässigkeit der Beweise bewerten und jede wichtige Phase manuell überprüfen.
Die Behörden bezeichnen den endgültigen Bericht ausdrücklich als Entwurf für weitere Bearbeitung und nicht als abgeschlossene Arbeit.
6. Reference Manager
Der Referenzverwaltungs-Tool unterstützt Ordnern, Tags, Notizen und die Zusammenarbeit. Es ist möglich, Daten aus Zotero, Mendeley oder DOI zu importieren, außerdem können Suchergebnisse und PDF-Dateien gespeichert werden. Die in der Datenbank gespeicherten Artikel können direkt von Agenten, Extraktionswerkzeugen sowie AI Writer genutzt werden – dadurch wird das wiederholte Exportieren zwischen Such-, Chat- und Schreibprogrammen reduziert.
Die kostenlose Version bietet 500 MB Speicherplatz. Die kostenpflichtigen Optionen bieten unbegrenzten Speicherplatz für Literaturverweise – doch es müssen weiterhin die Richtlinien zur angemessenen Nutzung sowie die Urheberrechtsbeschränkungen eingehalten werden. Paperguide sollte nicht als einzige Backup-Quelle dienen; wichtige Dokumente sollten regelmäßig in Form von BibTeX-, RIS-, CSV-Dateien sowie im ursprünglichen PDF-Format exportiert werden.
7. AI Writer und automatische Zitierungen
Der AI Writer kann anhand von Forschungsfragen oder einem benutzerdefinierten Aufbau Entwürfe erstellen. Zudem kann er ausgewählten Texten umformulieren, erweitern, kürzen, überarbeiten und grammatikalische Fehler korrigieren. Er kann auf Literatur aus der Arbeitsumgebung oder von der Plattform zugreifen und zwischen mehr als 1000 Zitierstilen wechseln. Dabei werden die Zitate im Haupttext sowie die Referenzliste automatisch verwaltet.
Die erstellten Inhalte gehören dem Nutzer, doch die Regeln bezüglich der wissenschaftlichen Zitationen, der Angabe von KI-Unterstützung sowie der Prüfung auf Plagiate werden von der Universität, der Zeitschrift und den Förderinstitutionen festgelegt. Die Literaturverzeichnis-Einträge müssen einzeln überprüft werden – hinsichtlich Autor, Titel, Jahr, DOI sowie der tatsächlichen Zusammenarbeit. Man darf die Überprüfung nicht einfach auslassen, nur weil das System behauptet, „keine Zitate zu erfinden“.
8. Teamorganisation und Workspaces
Die im Jahr 2026 eingeführte Teamstruktur umfasst Organization, persönliche Räume, interne private Räume der Organisation sowie gemeinsame Arbeitsräume. Teams können Bibliotheken teilen, Dokumente gemeinsam bearbeiten, Daten gemeinsam auswerten und Systemüberblicke erstellen. Der Zugang wird über Rechte für Owner, Admin, Member sowie Arbeitsbereiche gesteuert.
Mit zwei oder mehr Plätzen können Organisations- und Zusammenarbeit Arbeitsbereiche erstellt werden; der Administrator kann die Nutzung sowie die Verwaltung der Plätze überwachen.
9. Chrome-Erweiterungen und Sammlungen von Institutionen
Chrome-Erweiterungen ermöglichen es, Inhalte von Zeitschriftenartikeln, wissenschaftlichen Arbeiten oder gewöhnlichen Webseiten in Reference Manager zu speichern, Ordnern zuzuweisen und der KI Fragen zu stellen. Auf der Preistabelle wird außerdem „Zugriff auf Artikel aus der Universitätsbibliothek über Browser-Erweiterungen“ als Funktion der verschiedenen Optionen aufgeführt.
Ob der vollständige Text zugänglich ist, hängt weiterhin von den Abonnements der zugehörigen Institution des Benutzers, den Einstellungen des Agents sowie den Berechtigungen des Verlags ab.
10. Search API und MCP
Die Search-API bietet eine Kombination aus semantischer und schlagwortbasierte Suche. Es werden Autorangaben, DOI-Nummern, Zusammenfassungen, BibTeX-Daten, PDF-Links sowie Zitierdaten zurückgegeben. Zudem sind Filter nach Jahr, Fachgebiet, Qualität der Zeitschrift sowie Open-Access-Kriterien möglich. Free: 10 Suchanfragen pro Monat, 5 Suchanfragen pro Minute.
Plus: 100 Mal pro Monat, 15 Mal pro Minute; Pro: 500 Mal pro Monat, 30 Mal pro Minute.
Auf der Preisseite wird angegeben, dass Max 1500 Mal pro Monat genutzt werden kann.
Enterprise wird nach Verbrauch abgerechnet; in den offiziellen Dokumenten wird der Preis derzeit mit 0,01 US-Dollar pro Transaktion angegeben, wobei maximal 50 Einträge pro Transaktion möglich sind.
MCP ermöglicht es externen AI-Hilfsprogrammen, Artikel zu suchen und deren Details anzusehen. Für die Nutzung der gemeinsam genutzten AI-Credits gilt: 10 Credits pro Suche, 2 Credits für das Anzeigen der Artikeldetails. Bei fehlgeschlagenen Aufrufen werden keine Kosten berechnet. Entwickler sollten den API-Schlüssel auf der Serverseite speichern und nicht in Webseiten oder mobilen Clients einbetten.
Wie werden AI-Credits berechnet?
Systematische Übersichtsarbeiten, gründliche Recherchen, Datenauswertung, Kommunikation mit Forschungsagenten, Erstellung und Bearbeitung von Texten sowie MCP verbrauchen alle AI-Credits. Die verfügbare Menge wird jeden Abrechnungstag monatlich aktualisiert; der tatsächliche Verbrauch hängt von der Anzahl der Quellen, der Länge des Inhalts, der Anzahl der Felder sowie von der Komplexität der Aufgabe ab.
Laut den offiziellen Schätzungen ermöglichen 12.500 Credits von Plus etwa 15 bis 17 Literaturübersichten pro Monat oder das Extrahieren von 10 Feldern aus 300 bis 400 Artikeln; 50.000 Credits von Pro ermöglichen etwa 60 bis 70 Übersichten oder das Extrahieren von 1200 bis 1600 Feldern aus Artikeln derselben Größe.
Das obige sind Beispiele und keine Garantien; bei offiziellen Projekten sollte zunächst mit einer kleinen Stichprobe geschätzt werden.
Preise und Angebote
Im Folgenden sind die jährlichen Preise in US-Dollar angegeben, die bei der aktuellen Überprüfung auf der offiziellen Website zu sehen waren. Die Preise werden pro Sitzplatz berechnet; für monatliche Abonnements sowie Steuern und Währungen vor Ort gelten die Angaben auf der Zahlelseite.
| Paket oder Version | Preise, Limits und Kernvorteile |
|---|---|
| Free | Kostenlos: 1000 AI-Credits pro Monat, 20 AI-Suchen, 500 MB Speicherplatz für Dokumente, 10 Extraktionen mit jeweils 5 Spalten pro Suche, 10 Suchanfragen über die Search-API. Enthält außerdem Funktionen wie PDF-Fragenbeantwortung, AI Writer, Erstellung von Berichten, Import in Zotero/Mendeley sowie mehr als 1000 Zitierstile. |
| Plus | Jährlich entspricht das 17 US-Dollar pro Sitzplatz pro Monat, insgesamt also 204 US-Dollar im Jahr; 12.500 Credits pro Monat, 1.000 systematische Übersichten, unbegrenzter Zugriff auf AI-Suche und Dokumentenspeicherung, 100 Extraktionen bzw. 50 Spalten pro Vorgang sowie 100 API-Aufrufe. |
| Pro | Jährlich 39 US-Dollar pro Sitzplatz pro Monat, insgesamt 468 US-Dollar im Jahr; 50.000 Credits pro Monat, 5.000 Systemüberblicksartikel, Extraktion von Bildern und Tabellen sowie 500 API-Aufrufe. |
| Max | Jährlich kostet jeder Sitzplatz 119 US-Dollar pro Monat, insgesamt also 1428 US-Dollar im Jahr; außerdem gibt es 150.000 Credits pro Monat, 10.000 systematische Übersichtsartikel, eine Doppelprüfung, Teammanagement sowie 1500 API-Aufrufe. |
| Enterprise | Anfragen stellen; anpassbare Credits, bis zu 20.000 Systemüberblicksartikel, Doppelprüfung, Team- und Sicherheitsfähigkeiten sowie anpassbare API-Limits. |
Dritte Seiten können weiterhin alte Paketoptionen wie Starter, Advanced, 12 Dollar oder 24 Dollar anzeigen, die nicht mehr der aktuellen Struktur Free, Plus, Pro, Max auf der offiziellen Website entsprechen. Bei der Kaufentscheidung sollten die Preise auf der offiziellen Website sowie die endgültige Rechnung herangezogen werden.
Daten, Privatsphäre und Eigentum
Laut den offiziellen Bedingungen behält der Benutzer das Eigentum an den hochgeladenen Dateien, Hinweisen und Materialien. Paperguide erhält lediglich eine eingeschränkte Genehmigung, die Inhalte zur Erbringung der Dienstleistungen zu verarbeiten, zu speichern und anzuzeigen. Benutzerdaten werden nicht verkauft und nicht zur Schulung öffentlicher oder allgemein nutzbarer KI-Modelle verwendet.
Die von KI erzeugten Zusammenfassungen, Analysen und Ausgaben gehören dem Benutzer.
Das bedeutet nicht, dass unbefugte Publikationen, Patientendaten oder Geschäftsgeheimnisse hochgeladen werden dürfen. Institutionelle Nutzer sollten weiterhin den Speicherort der Daten, die Unterauftragsverarbeiter, Lösch- und Backup-Maßnahmen, die Sicherheitszertifizierungen sowie die Vertragsbedingungen überprüfen und sich an die Lizenzbedingungen für Datenbanken halten.
GitHub und der Open-Source-Zustand
Bei dieser Überprüfung wurde kein offizieller GitHub-Open-Source-Repository gefunden, das über einen klaren Link auf der offiziellen Website verfügbar ist und das das vollständige Paperguide-Produkt darstellt. Die Kern-Webanwendung, der Artikelindex, Agent, Writer sowie die Systemübersicht sind alle Cloud-basierte Dienste – es gibt keine offizielle, selbst gehostete Community-Version.
Projekte mit dem gleichen Namen auf GitHub, Scraper oder Drittanbieter-Integrationen können nicht als offizielle Quellcodequellen angesehen werden.
Anleitung zur Nutzung von Paperguide
Eine grundlegende Aufgabe erledigen
- Klare Definition der im Paperguide zu erledigenden Code-Aufgaben, des Repository-Bereichs und der Akzeptanzkriterien;
- Verbinden oder importieren Sie das Testprojekt und erstellen Sie zunächst eine Sicherungskopie der aktuellen Branch.
- Zuerst wird mit AI Search ein Suchplan für die Erstellung erstellt, anschließend werden die zu ändernden Dateien überprüft.
- Verwenden Sie den Research Agent zusammen mit einer Literaturübersicht, um kleinere Anpassungen vorzunehmen;
- Ausführen von Tests, statischen Überprüfungen und der Kompilierung – unüberprüfter Code wird nicht direkt akzeptiert;
- Manuelle Überprüfung von Berechtigungen, Schlüsseln, Abhängigkeiten und Fehlerbehandlung vor der Kombination;
Erstellung wiederverwendbarer professioneller Workflows
- Wählen Sie ein real existierendes Projekt mit niedrigem Risiko als Vorlage aus;
- Die Reihenfolge der Verwendung von AI Search für die Suche nach Artikeln, Research Agent sowie Literaturübersichten und Chat with PDF ist festgelegt.
- Erfassen von Umgebung, Modellen, Hinweisen und Fehlbedingungen;
- Manuelle Freigabe für Schreib-, Bereitstellungs- und Löschvorgänge einrichten;
- Vergleichen Sie Geschwindigkeit, Kosten, Testbestehensrate und Anzahl der Nacharbeiten;
- Erst nach Überprüfung der Stabilität auf Team- oder Produktionsumgebung ausweiten;
Für welche Nutzer geeignet?
- Studenten und Wissenschaftler, die von der Suche bis zur Verfassung von Zitaten arbeiten müssen;
- Team zur Durchführung von Literaturübersichten, Umfangsübersichten und PRISMA-Systemübersichten;
- Wissenschaftler im Bereich der medizinischen oder sozialwissenschaftlichen Forschung, die Methoden, Beispiele und Ergebnisse von Studien in großer Anzahl extrahieren;
- Benutzer, die Zotero- und Mendeley-Daten in die AI-Analyse einbinden möchten;
- Labore und Einrichtungen, die eine gemeinsame Nutzung von Literaturdatenbanken, die Zusammenarbeit bei der Erstellung von Texten sowie Aufzeichnungen zur Überwachung benötigen;
- Entwickler, die Workflows für die Suche nach Artikeln über API oder MCP erstellen.
Einschränkungen und Hinweise
- 200 Millionen Artikel bilden die Größe des aggregierten Korpus – das bedeutet jedoch nicht, dass alle Artikel den vollständigen Text enthalten.
- Chinesische Zeitschriften, Dissertationen, kostenpflichtige Datenbanken und graue Literatur könnten unzureichend abgedeckt sein;
- Formelle Übersichten müssen wissenschaftliche Datenbanken ergänzen und reproduzierbare Suchanfragen speichern;
- KI könnte PDF-Dateien falsch interpretieren, die zu untersuchenden Objekte verwechseln, Negationswörter übersehen oder übermäßige Generalisierungen erzeugen;
- Die von KI in der Systemüberprüfung getroffenen Entscheidungen müssen von Menschen überprüft werden, und die Datenauswertung muss auf den Originaltext zurückgeführt werden.
- Bei Veröffentlichungen im Bereich Medizin, Politik und Forschung müssen zudem ein Bewertung der Verzerrungsrisiken sowie eine statistische und evidenzbasierte Bewertung durchgeführt werden.
- AICredits, die Anzahl der Systemüberblicksartikel und API-Anfragen sind unterschiedliche Beschränkungen – man darf nicht nur von einer „unendlichen Suche“ ausgehen.
- Großangelegte Projekte werden außerdem von der PDF-Abrufzeit, der Verarbeitungszeit, den Teamplätzen sowie den Richtlinien für eine angemessene Nutzung beeinflusst.
Häufige Fragen
Ist der Paperguide kostenlos?
Es gibt eine kostenlose Version mit 1000 Credits pro Monat, 20 AI-Suchen, 500 MB Speicherplatz sowie 10 API-Aufrufen. Damit kann man Funktionen wie PDF-Fragen beantworten, Texte verfassen sowie Berichte und Dokumente verwalten.
Wird Chinesisch unterstützt?
Chinesisch (Mandarin) als von KI erzeugte Sprache wird unterstützt; Writer, PDF-Fragen/Antworten, Literature Review, AI Search und Extract Data können in Chinesisch ausgegeben werden. Die Abdeckung chinesischer Literatur hängt weiterhin von den Quellen des Index ab.
Kann eine systematische Übersicht erstellt werden?
Ja, es umfasst Protokolle, Sammlung von Artikeln, Filterung von Zusammenfassungen und Volltexten, Extraktion, Berichterstattung sowie PRISMA-Diagramme, und behält manuelle Überprüfungen sowie Audit-Protokolle bei. Die kostenlose Version enthält keine vollständige Systemüberblicksarbeit; diese ist in den Versionen Plus und höher verfügbar.
Wird Zotero und Mendeley unterstützt?
Es wird die Importierung unterstützt, und es ist auch möglich, eine Literaturdatenbank über DOI, Browser-Erweiterungen sowie Suchergebnisse zu erstellen.
Wird eine API und MCP bereitgestellt?
Bereitgestellt. Die Search API verteilt die monatlichen Anfragen und die Geschwindigkeit entsprechend dem Plan.
MCP verwendet denselben AI-Credits-Pool: 10 Credits für die Suche, 2 Credits zum Anzeigen der Details.
Ist Paperguide open source?
Keine Open-Source-Version. Es wurden weder offizieller vollständiger Quellcode noch eine selbst gehostete Version gefunden. Das Produkt wird über Webseiten in der Cloud, Erweiterungen, APIs und MCP genutzt.
Werkzeuge, die dem Paperguide ähneln
 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164