




Tavus
KI-Plattform mit programmierbaren digitalen Avataren und personalisierbaren Videofunktionen
Tags:KI-VideobearbeitungstoolsWas ist Tavus?
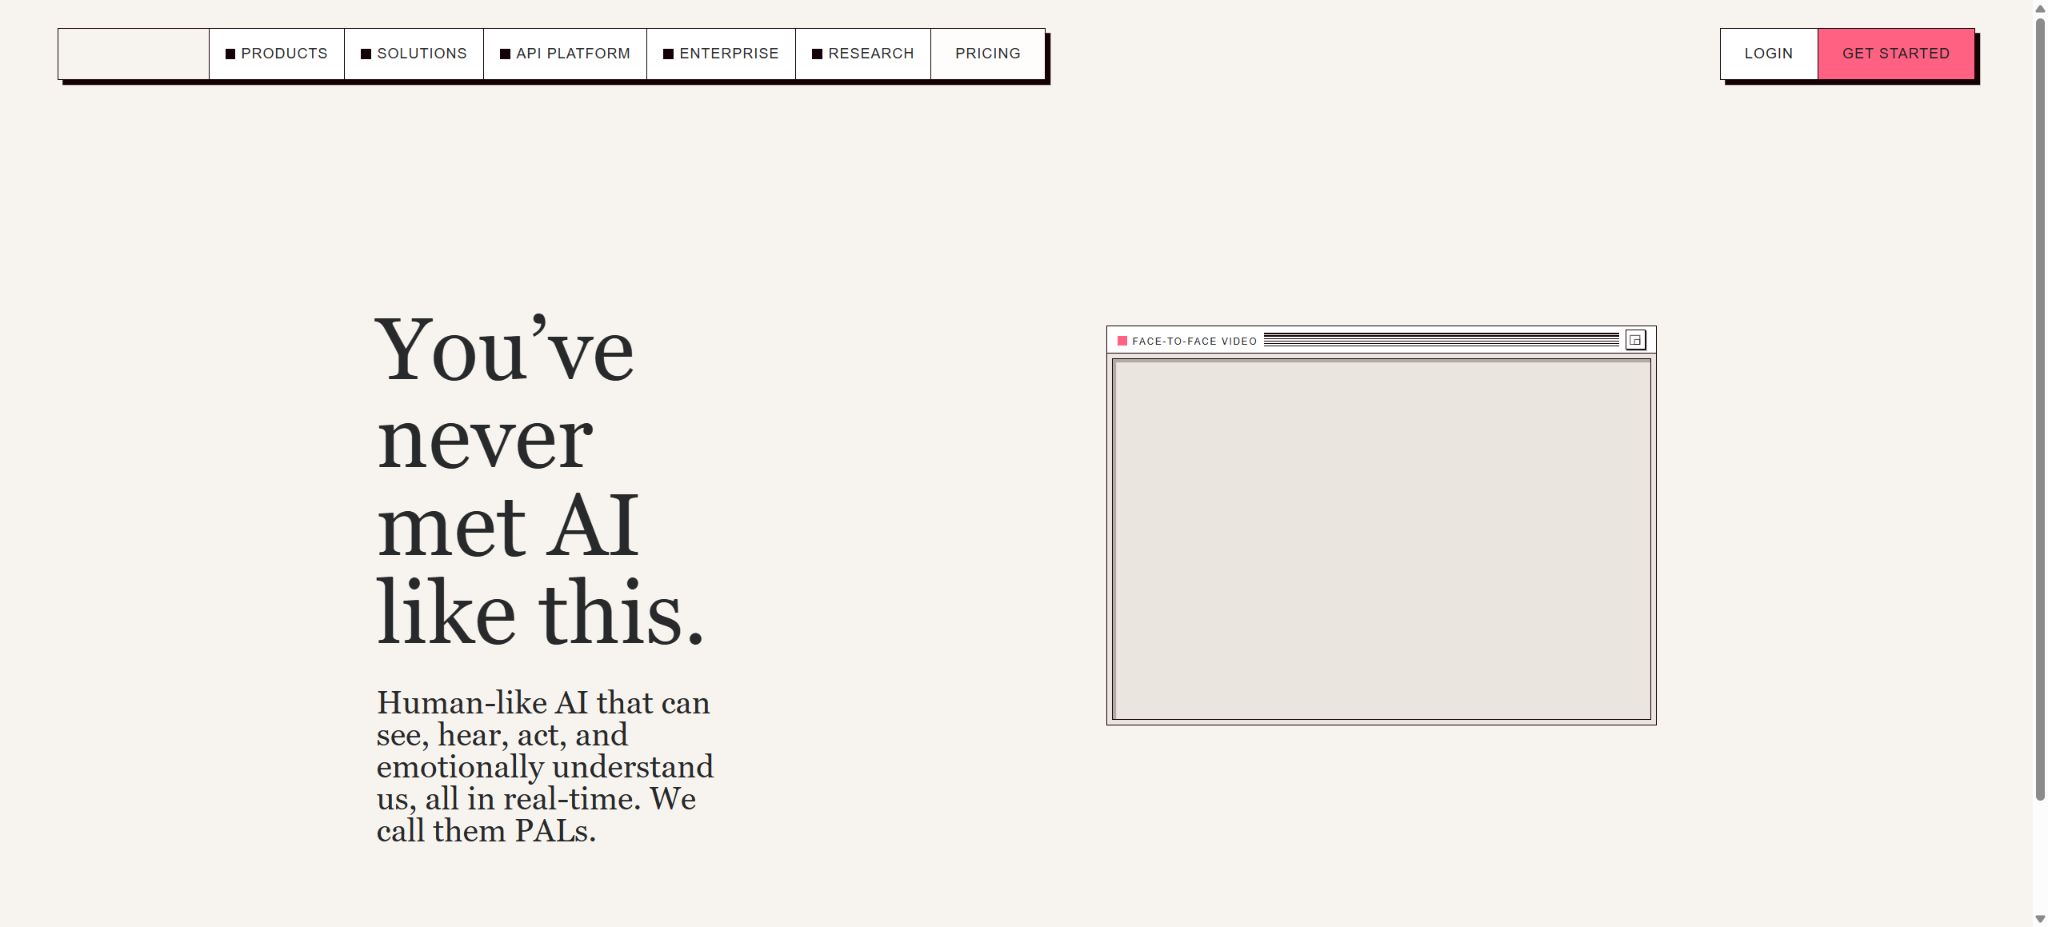
Tavus ist eine Plattform für Echtzeit-AI-Digitalmenschen, die sich an Entwickler, Produktteams und Unternehmen richtet. Ursprünglich erregte sie Aufmerksamkeit durch die Erstellung personalisierter Videos von digitalen Avataren. Heute ist das Kernprodukt die Conversational Video Interface, kurz CVI – eine Technologie zur Erstellung von Echtzeit-Videoschnittstellen für AI-Agenten, die sehen, hören, sprechen, sich erinnern und Tools aufrufen können.
CVI integriert die Darstellung von Digital-Personas, Spracherkennung, LLMs, Text-zu-Stimme-Übersetzung sowie WebRTC-Verbindungen in eine einzige API sowie Hostingskomponente. Entwickler müssen keine separaten Sprach- und Videodienste erwerben, um 1080p-Digital-Persona-Gespräche in Webseiten, Apps, Zoom oder Google Meet einzubinden.
Der Unterschied zwischen Face und PAL
Face definiert das Erscheinungsbild und die Stimme auf dem Bildschirm – also das Gesicht, die Stimme, die Mimik sowie die Darstellungsweise der digitalen Person. PAL definiert das Verhalten, das Wissen, die Anweisungen, die Ziele, die Beschränkungen, die Werkzeuge sowie die Konfiguration der Pipeline.
Ein PAL kann ein Standard-Gesicht verknüpfen oder beim Erstellen einer Sitzung ein anderes Gesicht auswählen.
Die getrennte Gestaltung von Identität und Verhalten erleichtert die Wiederverwendung: Derselbe Kundenservice-Logik kann von verschiedenen Personen genutzt werden, und dieselbe digitale Avatare kann unterschiedliche Rollen wie Verkauf, Schulung oder Beratung übernehmen.
Phoenix-Digital-Person-Rendering-Modell
Phoenix ist dafür verantwortlich, in Echtzeit Gesichter, Mikroausdrücke, Kopfbewegungen sowie Stimmungsveränderungen zu erzeugen. Die aktuelle Version Phoenix-4 ermöglicht es, die Ausdrücke je nach Kontext, Tonfall und Dialoghinweisen dynamisch anzupassen sowie einen natürlichen Übergang zwischen Sprech- und Zuhöreinstellungen zu schaffen.
Es konzentriert sich auf die Darstellung des Gesichts und ist nicht für umfassende Geschäftskenntnisse verantwortlich. Eine realistische Optik bedeutet nicht, dass die Antworten zuverlässig sind; die Qualität der Fakten wird weiterhin durch die PAL-Konfiguration, das LLM, die Wissensdatenbank und die Tools bestimmt.
Raven-Wahrnehmungsmodell
Raven analysiert die Videos, Geräusche, Körpersprache, den Bildschirmaustausch sowie Umgebungsanzeichen der Benutzer, um Emotionen, Absichten, Tonfall sowie bestimmte Gegenstände oder Handlungen zu erkennen. Es kann Tools auslösen, wenn bestimmte Verhaltensweisen oder Geräusche festgestellt werden.
Visuelle und emotionale Schlussfolgerungen können fehlerhaft sein und dürfen daher nicht allein zur medizinischen Diagnose, zur Auswahl von Mitarbeitern, bei Kreditentscheidungen oder in der Strafverfolgung verwendet werden. Bei der Erstellung sensibler Schlussfolgerungen ist eine klare Information, die Zustimmung des Nutzers sowie eine manuelle Überprüfung erforderlich.
Sparrow-Modell für die Verwaltung von Schichten
Sparrow kümmert sich um Pausen, Rhythmus, Abwechslung in den Dialogen sowie Unterbrechungen. Sparrow-1 ist die offiziell empfohlene Version – sie ist im Vergleich zu den älteren Versionen sowie zu den rein zeitbasierten Regeln schneller und natürlicher in der Bedienung.
Entwickler können die Turn-taking Patience auf niedrig, mittel oder hoch einstellen und auch die Empfindlichkeit steuern, mit der PAL unterbrochen wird. Bei Kundenservice-Anfragen kann man schneller reagieren, während in Gesprächs- und Beratungssituationen mehr Geduld erforderlich ist.
Erstellen Sie eine benutzerdefinierte Face aus einem Video
Eine hochwertige Methode besteht darin, ein etwa 1-minütiges Trainingsvideo hochzuladen, bei dem etwa 30 Sekunden für Sprechen und 30 Sekunden für Zuhören verwendet werden. Diese Methode ermöglicht es, Aussehen, Stimme, Gesichtsausdrücke sowie Sprachgewohnheiten festzuhalten; die Qualität und Kontrolle sind in der Regel besser als bei einem einzelnen Bild.
Trainingsvideos müssen klar, stabil, überwiegend positiv sein und den technischen Anforderungen entsprechen. Die Nutzer müssen die notwendigen Rechte an Bildern, Stimmen und Videos besitzen.
Face aus einem Bild erstellen
Die Benutzer können auch einzelne Bilder von Personen oder Charakteren hochladen. Das System erzeugt anschließend automatisch Trainingsdaten und lässt die vorhandenen Stimmen auswählen. Auf diese Weise ist die Implementierung schneller – doch die Genauigkeit bezüglich Identität, Bewegungen und Ausdrücken ist geringer als bei der Training mit Videos.
Das Bild Face eignet sich für Prototypen und virtuelle Charaktere und darf nicht für unbefugte Klonierung von lebenden Menschen verwendet werden.
Mehr als 100 verschiedene Stock-Faces
Tavus bietet mehr als 100 Stock Faces an, die von echten Schauspielern aufgenommen wurden. Sie eignen sich für schnelle Prototypen, Präsentationen sowie für Teams, die keine eigenen Materialien haben. Bei der Verwendung dieser Stock-Ressourcen müssen weiterhin die vom Portal vorgegebenen Regeln bezüglich der Darstellung und der Angabe von Werbung eingehalten werden.
PAL Maker – Codefreie Erstellung
PAL Maker bietet eine geführte Benutzeroberfläche, mit der Nicht-Entwickler Face, Stimme, Verhalten, Wissen, Ziele und Tools konfigurieren sowie direkt gehostete Dialoge starten können. Die API eignet sich hingegen für die Einbettung in fertige Produkte und die automatisierte Bereitstellung.
Wissensdatenbank und RAG
Eine optimierte Knowledge Base kann Unternehmensdokumente laden, um einen Suchkontext für die Beantwortung von Fragen zu bieten. Die Dokumente sollten in Versionen unterteilt werden, veraltete Informationen entfernt und Zugriffsrechte festgelegt werden.
RAG kann Halluzinationen verringern, aber es garantiert nicht, dass jedes Mal der richtige Abschnitt gefunden wird.
Dynamisches Gedächtnis
Dynamische Speicher ermöglichen es PAL, die Präferenzen und den Kontext des Benutzers in späteren Sitzungen zu speichern, wodurch die Kontinuität verbessert wird. Die gespeicherten Daten gelten als personenbezogene Daten; es müssen Informationen zur Bereitstellung, Löschung, Änderung sowie zum Aufbewahrungszeitraum bereitgestellt werden. Es sollten keine Passwörter, Zahlungsinformationen oder unnötig sensible Daten gespeichert werden.
Ziele, Schutzzäune und Aufruf von Tools
Ziele definieren die Aufgaben, die in einer Sitzung erledigt werden sollen. Guardrails begrenzen die nicht zulässigen Handlungen. Funktionen zur Aufrufung von Tools sowie Tools selbst dienen dazu, Bestellungen abzufragen, Termine zu planen oder den CRM-System zu aktualisieren. Die Parameter der Tools müssen vom Server überprüft werden, und bei hochriskanten Aktionen ist die Bestätigung des Benutzers erforderlich.
Emotionskontrolle
Phoenix-4 unterstützt explizite und implizite Emotionssteuerung. Bei der expliziten Einstellung kann die Ausdrucksrichtung festgelegt werden, im impliziten Modus wird sie anhand des Kontexts des Gesprächs angepasst.
Im Marketing und in der Unterhaltung können deutlichere Emotionen verwendet werden, während im Gesundheitswesen, in der Finanzbranche sowie bei der Bearbeitung von Beschwerden manipulative Ausdrucksweisen vermieden werden sollten.
Stimme, Aussprache und Rauschunterdrückung
CVI umfasst TTS, 24 kHz Audio, ein Aussprachewörterbuch, fortschrittliche Geräuschunterdrückung und Sprecherunterscheidung. Das benutzerdefinierte Aussprachewörterbuch kann Markennamen, Personennamen und Fachbegriffe korrigieren.
In lauten Umgebungen sollten weiterhin Textbestätigungen und Untertitel bereitgestellt werden.
Video- und reiner Audiotraffic
Entwickler können zwischen dem vollständigen Video-Modus oder dem Audio-only-Modus wählen. Der Kosten- und Bandbreitenverbrauch bei reinem Audio ist in der Regel geringer, was es für Telefonanrufe oder Hintergrundagenten geeignet macht.
Der Video-Modus bietet Emotionen und visuelle Wahrnehmung, erfordert aber höhere Anforderungen an das Netzwerk, die Geräte und die Privatsphäre.
Vergleich von Paketen und Preismodellen
| Paket | Preismodell | Gesicht und Menge | Passende Szenarien |
|---|---|---|---|
| Free | Kostenlose Entwicklungs-Testversion, genaue Anzahl der Minuten sowie die Anzahl der gleichzeitigen Verbindungen richten sich nach der Konsole. | Es können Stock-Ressourcen sowie grundlegende CVI-Dateien verwendet werden; es ist nicht möglich, eigene Gesichter zu erstellen. | Prototypen, API-Tests und Funktionsbewertung |
| Starter | Die Abonnement- oder Verbrauchspreise werden in der dynamischen Konsole angezeigt. | Freigegebene benutzerdefinierte Gesichter und höhere Sitzungslimits | Start-up-Produkte und kleine, formelle Implementierungen |
| Growth | Abgerechnet nach höherer Menge und Leistung | Anpassbare Faces, höhere Konkurrenzfähigkeit, Zeitintervalle und Produktionskapazität | Anwendungen im Wachstum und Mehrszenario-Einsatz |
| Enterprise | Individuelle Kostenschätzung | Anpassung von Face, Kapazität, Konformität, Support und Vertragsbedingungen | Hohe Konkurrenz, Regulierung und große Unternehmensprojekte |
Die Preisangaben auf der offiziellen Website werden in den veröffentlichten Texten nicht immer mit konkreten Beträgen angegeben. Es ist jedoch sicher, dass sowohl die Free- als auch die Enterprise-Versionen über APIs sowie eine End-to-End-Dienstleistungsstruktur verfügen. Bei den kostenpflichtigen Versionen können Face-Elemente, Anzahl der Minuten sowie die Anzahl der gleichzeitigen Verbindungen individuell angepasst werden. Vor dem Kauf sollte man sich in der Entwicklerkonsole einloggen, um die aktuellen Preise sowie die Kosten für zusätzliche Minuten, überzogene Nutzung sowie die Speicherung von Aufnahmen zu überprüfen.
Was ist im Preis inbegriffen?
Laut der offiziellen Website umfasst der Preis von CVI alle notwendigen Funktionen wie LLM, TTS und WebRTC. Zudem sind 1080p-Videos, Audio in 24kHz-Qualität sowie Funktionen zur Erkennung, zum RAG, zur Speicherung von Informationen, zu Schutzmaßnahmen, zu Werkzeugen, zur Transkription und zur Aufzeichnung enthalten. Die Gesamtkosten für Unternehmen können außerdem Integration, Datenvorbereitung, Konformität, Support nach dem Go-Live sowie Kosten für übermäßigen Verbrauch beinhalten.
Erstellung alter Videos und aktuelles CVI
Tavus verfügt weiterhin über die Videos-API sowie die Funktion zur Erstellung von digitalen Avatare. Früher wurde angegeben, dass eine einzelne Videoanleitung maximal 5 Minuten lang sein darf. Der Schwerpunkt des Produkts liegt nun auf Echtzeit-CVI und PAL. Das Produkt sollte daher nicht nur als Werkzeug zur Massenerstellung personalisierter Aufzeichnungen beschrieben werden.
Zoom und Google Meet
PAL kann in Zoom- und Google-Meet-Sitzungen eintreten und eignet sich für Vorstellungsgespräche, Schulungen, Verkäufe und Support. Vor dem automatischen Beitreten zur Besprechung muss den Teilnehmern mitgeteilt werden, dass es sich um KI handelt, sowie ob Aufnahmen, Videoaufzeichnungen, Transkripte erstellt und gespeichert werden.
Integration von LiveKit und Pipecat
Tavus bietet Möglichkeiten zur Integration von LiveKit und Pipecat, um die Face-Renderung in bestehende Echtzeit-Agenten sowie Medieninfrastrukturen einzubinden. Das Team muss sich mit dem Lebenszyklus der Sessions, der erneuten Verbindung zum Netzwerk, den Mikrofonrechten sowie den Server-Schlüsseln beschäftigen.
Schnelle Einbettungsprozesse
- Speichern Sie den TAVUS_API_KEY auf der Serverseite.
- Wählen Sie Stock oder eine benutzerdefinierte PAL und Face.
- Der Server ruft die Schnittstelle zur Erstellung einer Conversation auf.
- Einbetten Sie die zurückgegebene Conversation-URL in einen iframe oder eine Anwendung.
- Der Benutzer beendet die Sitzung freiwillig beim Verlassen, um eine anhaltende Abrechnung zu vermeiden.
Für automatische Tests kann test_mode verwendet werden, um Sitzungen zu erstellen, bei denen PAL tatsächlich nicht hinzugefügt wird und die sofort beendet sind, wodurch Verbindungsgebühren für normale Sitzungen vermieden werden.
Conversation API
Entwickler können Sessions erstellen, beenden und abrufen sowie Transkripte und Aufnahmen erhalten. Sobald eine Session erstellt wurde, beginnt die Abrechnung und es wird eine Ressource belegt; daher kann man sich nicht darauf verlassen, dass durch das Schließen des Browsers Ressourcen freigegeben werden.
OpenAPI und Serverseitige Sicherheit
Die offiziellen Quellen stellen den vollständigen OpenAPI-Vertrag zur Verfügung. Der API-Schlüssel darf weder in Browsercode, mobile Anwendungen noch in öffentliche Repositorien eingefügt werden;
Die Frontend-Anwendung kann nur auf ihr eigenes Backend zugreifen; das Backend erstellt die kontrollierten Sessions.
Die URL der Dateien, die für das Face-Training verwendet werden, sollte eine kurzfristig gültige Signaturadresse enthalten; Schlüssel sowie dauerhaft öffentlich zugängliche sensible Daten dürfen in den Protokollen nicht aufgezeichnet werden.
GitHub und Beispield Projekte
Tavus Engineering stellt auf seinem offiziellen GitHub-Repository Beispiele für CVI, Vorführprojekte zu Interviews und Santa zur Verfügung, um Entwicklern dabei zu helfen, Echtzeit-Schnittstellen zu verstehen. In den Suchergebnissen finden sich außerdem Drittanbieter-SDKs für Python, Ruby und C#, wobei vor der Verwendung unterschieden werden muss, ob es sich um offizielle oder von der Community gepflegte Tools handelt.
Open-Source-Zustand
Tavus’ Modelle Phoenix, Raven, Sparrow, die Face-Trainingsfunktionen sowie die Hosted-CVI- und Business-APIs sind keine Open-Source-Produkte. Die öffentlich verfügbaren Beispielprojekte bedeuten nicht, dass die Kernmodelle oder Serverdienste privat genutzt werden können.
Daten, Aufzeichnung und Konformität
CVI kann Transkripte und Aufnahmen von Gesprächen speichern sowie Video-, Audio-, Gesichts-, Emotions- und Wissensdaten verarbeiten. Unternehmen müssen Zustimmung, Rechtsgrundlage, Zugriffsrechte, Aufbewahrung, Löschung, Datenstandort sowie die Regulierung der Datenerfassung festlegen.
Die Benutzer können eine Löschung der Daten anfordern, doch die Unternehmensanwendungen müssen auch eine synchronisierte Löschung in ihren eigenen Datensystemen durchführen.
Tavus-Anleitung
Erstellung wiederverwendbarer professioneller Workflows
- Erstellung von Skripten, Drehbüchern, Markenmaterialien und einer Liste der zu verbietenden Elemente;
- Einheitliche Parameter für den Unterschied zwischen Face und PAL, das Phoenix-Digital-Person-Rendering-Modell und das Raven-Wahrnehmungsmodell speichern;
- Zuerst werden das Modell und die Obergrenze mit repräsentativen Aufnahmen getestet;
- Fehlerhafte Aufnahmen in eine manuelle Bearbeitung überführen oder neu erstellen;
- Einheitliche Untertitel, Lautstärke, Farben und Abspann-Copyright-Informationen;
- Erst nach Erfassung der Version und des Prüfers in Batch veröffentlichen;
Für welche Nutzer geeignet?
- Entwickler, die Echtzeit-Digital-Personal für Kundenservice und Verkaufssysteme erstellen;
- Dialogprodukte, die visuelle, auditive und emotionale Wahrnehmung erfordern;
- Team zur Erstellung von Schulungen und interaktiven Kursen für digitale Avatare;
- Unternehmen, die AI-Agenten in Zoom oder Google Meet einsetzen;
- Anwendungen, die RAG, Speicherung, Schutzmechanismen sowie Aufrufe von Tools benötigen;
- Teams, die mit LiveKit oder Pipecat eine Echtzeit-Medienpipeline aufbauen.
Hauptvorteile
- End-to-End umfasst LLM, TTS, WebRTC und die Darstellung von Digital Humans;
- Phoenix, Raven und Sparrow kümmern sich jeweils um das Aussehen, die Wahrnehmung und die Runden;
- Unterstützung zur Erstellung von benutzerdefinierten Gesichtern aus Videos oder einzelnen Bildern;
- PAL integriert Wissen, Erinnerung, Ziele, Schutzmechanismen und Werkzeuge;
- Bietet 1080p-Videos, geringe Verzögerung und umfangreiche Echtzeitsteuerung;
- Offene API, PAL Maker, Integration von Konferenz- und Echtzeit-Frameworks.
Einschränkungen und Hinweise
- Echtzeit-Video erfordert im Vergleich zu Text- oder Sprachagenten höhere Kosten, mehr Bandbreite sowie birgt größere Risiken für die Privatsphäre.
- Die Schätzung visueller Emotionen kann fehlerhaft sein; eine Anpassung des Gesichts erfordert eine Genehmigung.
- Wenn die Sitzung nicht ordnungsgemäß beendet wird, kann die Gebührenberechnung weiterlaufen;
- Die Kernplattform ist nicht open source, die genauen Preise müssen in der Konsole überprüft werden.
- LLM-Antworten, RAG-Suchvorgänge und Tool-Ausführungen können weiterhin Fehler aufweisen; hochriskante Operationen müssen manuell bestätigt werden.
Häufige Fragen
Ist Tavus kostenlos?
Es steht eine kostenlose Entwicklungsversion zur Verfügung, bei der grundlegende CVI- und Stock-Ressourcen genutzt werden können; die Anpassung von Gesichtern ist nur in den Versionen Starter, Growth und Enterprise möglich.
Wie lange braucht man an Materialien, um eine eigene digitale Avatar-Datei zu erstellen?
Mit hoher Qualität kann ein Video von etwa 1 Minute verwendet werden, wobei etwa 30 Sekunden für das Sprechen und 30 Sekunden für das Zuhören benötigt werden; auch ein einzelnes Bild kann schnell erstellt werden, doch die Qualität ist dann geringer.
Was ist der Unterschied zwischen Face und PAL?
Face ist für das Aussehen und die Stimme zuständig, PAL ist für Verhalten, Wissen, Ziele, Gedächtnis, Schutzmechanismen und Werkzeuge zuständig.
Bietet Tavus eine API an?
Es werden vollständige API- und OpenAPI-Spezifikationen bereitgestellt, mit denen Faces, PALs, Conversations, Videos, Tools und Dokumente verwaltet werden können.
Kann Tavus zu Zoom stoßen?
Es wird die Integration mit Zoom und Google Meet unterstützt; bei der Nutzung müssen die Teilnehmer über die Identität der KI sowie die Aufnahmepolitik informiert werden.
Ist Tavus Open Source?
Das Kernmodell sowie die Hosted-CVI-Lösung sind nicht open source; offizielle Beispiele und Demo-Projekte sind auf GitHub verfügbar.
Werkzeuge, die denen von Tavus ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164