




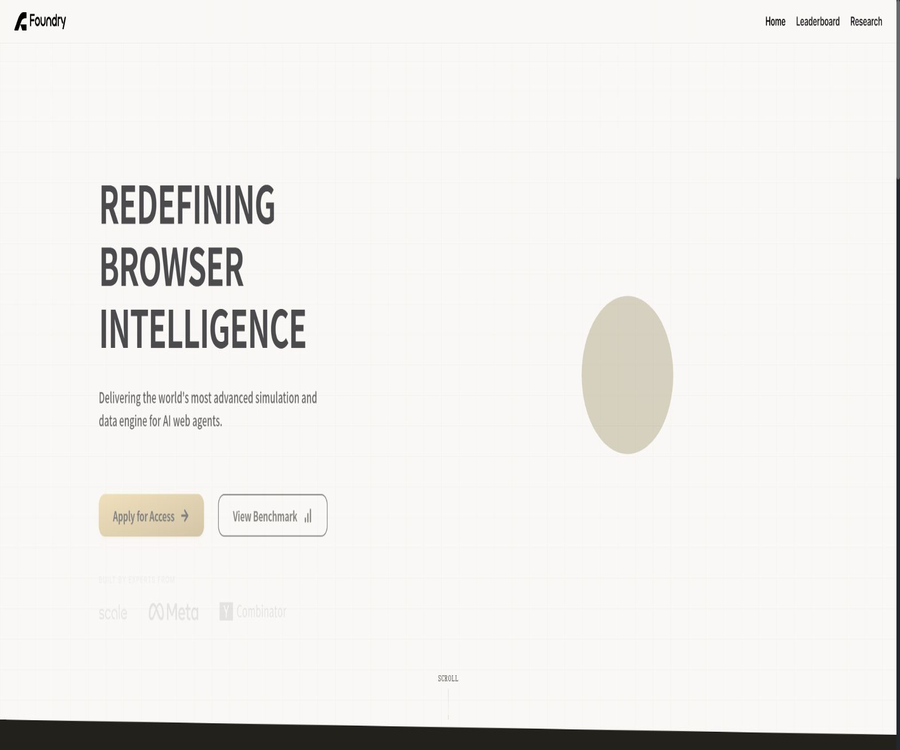
Foundry
Foundry – intelligente Tools für die AI-Entwicklung
Tags:KI-Design-ToolsWas ist eine Foundry?
Foundry ist eine Plattform für Simulation, Bewertung und Schulung von Daten, die für Entwicklerteams von KI-Browser-Agenten konzipiert wurde. Mithilfe eines wiederherstellbaren Unternehmens-Webumfelds ermöglicht sie es Entwicklern, automatisierte Agenten zu testen und auszubilden, ohne auf ständig sich verändernde echte Webseiten angewiesen zu sein.
Es handelt sich hier um eine Plattform für Browser-Agenten, die unter thefoundryai.com betrieben wird und zuvor den Domainnamen foundryrl.com verwendet hat – es handelt sich dabei nicht um Microsoft Foundry, Foundry VTT oder andere Produkte mit demselben Namen.
Eine kurze Beschreibung
Foundry bietet Browser-Agenten wiederholbare Webseiten-Simulationen, Bewertung Schritt für Schritt, detaillierte Daten zu Experten-Handlungsabläufen sowie ein Umfeld für Reinforcement Learning und kann über das Python SDK mit bestehenden Agenten verbunden werden.
Produktpositionierung
| Projekt | Die Positionierung von Foundry | Hauptnutzer |
|---|---|---|
| Simulation | Nachbildung der Unternehmenswebseite und des Geschäftsstatus | Agentenplattformen und Forschungsteams |
| Bewertung | Jede Handlung aufzeichnen, kategorisieren und bewerten. | Bewertung, Qualität und Modellteam |
| Daten | Erstellung von Expertenpfaden für reale Unternehmensprozesse | Überwachung des Fine-Tuning-Teams |
| Verstärktes Lernen | In einer wiederaufladbaren Umgebung große Mengen an Trajektorien abbilden | Nachtrainierung und Agent-RL-Team |
| Rangliste | Vergleich der Erfolgsrate und der Dauer bei Standardaufgaben | Entscheider für die Auswahl von Modellen und deren Entwicklung |
Warum benötigen Browser-Agenten eine Simulation?
Echte Websites werden ständig überarbeitet, die Daten werden aktualisiert und es treten unterschiedliche Account-Zustände auf, wodurch derselbe Agent zu verschiedenen Zeitpunkten mit unterschiedlichen Umgebungen konfrontiert wird. Zudem erschweren Codeverifizierungen, Maßnahmen gegen Automatisierung, Geschwindigkeitsbeschränkungen sowie Netzwerkstörungen eine wiederholbare Trainierung.
Foundry versucht, Webseiten, Konten und Geschäftsdaten in einem kontrollierbaren Zustand zu halten, damit jede Bewertung von derselben Ausgangslage ausgeht. Das Team kann Misserfolge auf das Agens selbst zurückführen, anstatt sie auf unerklärliche Schwankungen der Webseiten zu schieben.
Wiederholbare Browserumgebung
Der Simulation-Modul legt Wert auf eine pixelgenaue, wiederholbare Browserumgebung und vermeidet Seitenverschiebungen, zufälligen Rausch sowie externe Geschwindigkeitsbeschränkungen. Die Umgebung kann auf den ursprünglichen Zustand vor der Aufgabe zurückgesetzt werden, was sie für Batch-Regressionen und Strategievergleiche geeignet macht.
Der Wert der Reproduzierbarkeit
- Stellen Sie verschiedene Modelle den gleichen Seiten-, Daten- und Aufgabenszenarien gegenüber.
- Nach einem Misserfolg kann man das Vorgehen noch einmal abspielen und die konkreten Probleme im Interface oder in der Strategie identifizieren.
- Führen Sie nach dem Aufrüsten von Hinweisen, Modellen oder Tools konsistente Regressionstests durch.
- Testen Sie Schreibvorgänge, ohne die echten Geschäftsunternehmen zu belasten.
- Beim Batch-Sampling von Bahnen wird man nicht von den Anti-Automatisierungsmechanismen der echten Stationen gestört.
Agent-Bewertung
Der Evaluation-Modul verfolgt, kategorisiert und kennzeichnet jede Aktion des Agenten. Fehlversuche, Änderungen in der Anordnung, fehlerhafte Aktionen sowie Situationen, in denen das Ziel nicht erreicht wird, werden nicht einfach zu einer einzigen Endbewertung zusammengefasst.
Kernbewertungskriterien
| Indikatoren | Bedeutung | Interpretationsweise |
|---|---|---|
| Erfolgsrate der Aufgabe | Prozentualer Anteil der Zielerreichung | Es sollte unter Berücksichtigung der Schwierigkeit der Aufgabe sowie der Stichprobengröße erfolgen. |
| Durchschnittliche Bearbeitungszeit | Durchschnittliche Dauer für erfolgreich abgeschlossene Aufgaben | Schneller ist nicht unbedingt stabiler. |
| Anzahl der Aktionen | Die Schritte, die zur Erledigung einer Aufgabe erforderlich sind | Zu viel kann auf Umwege oder eine Wiederherstellung hindeuten. |
| Fehlerarten | Kategorien wie Klicken, Layout, Fehlbedienungen usw. | Zur Lokalisierung von Ingenieurproblemen |
| Zustandsänderung | Wie werden Webseiten und Geschäftsdaten geändert? | Überprüfen der Ergebnisse und nicht nur den Text ansehen |
| Konsistenz über Umgebungen hinweg | Übereinstimmung zwischen Simulationsergebnissen und Ergebnissen in der realen Umgebung | Bewertung der Simulationsgenauigkeit |
Bahnverläufe, Ereignisse und Zustandsaufzeichnungen
Beispiele für das Python SDK zeigen, dass Entwickler Aufgabenhinweise, Startseiten, Anmeldedaten, Zahlungsdetails und zusätzliche Anmerkungen abrufen können sowie Ereignisse, den endgültigen Zustand und Zustandsänderungen protokollieren. Anschließend vergleicht ein Prüfprogramm das Endresultat mit der Standardlösung.
Eignete Beweise für die Aufbewahrung
- Aufgaben-ID, Umgebungsversion und Agenten-Version.
- Jeder Schritt: Beobachtung, Handlung, Rückgabe des Werkzeugs und Zeit.
- Klicken, Eingeben, Navigieren und Ausnahmeereignisse.
- Änderungen im Anfangszustand, Endzustand und Zwischenzuständen.
- Künstliche Standards, automatische Bewertung und Fehlerkategorien.
- Modelle, Hinweise, Sampling-Parameter und Kosten.
Unternehmensweite Trainingsdaten
Das Data-Modul erzeugt von Experten annotierte, maßgeschneiderte Langzeitrückgabedaten für echte Unternehmensplattformen und cross-Application-Abläufe. Solche Daten können zur Überwachung des Feintunings genutzt werden, damit das Modell die richtige Ablaufreihheit, die Bewertung von Feldern sowie den Umgang mit Fehlern lernt.
Eigenschaften von Daten mit langen Bahnen
- Die Aufgabe erfordert den Wechsel zwischen mehreren Seiten und Anwendungen.
- Die vorherige Aktion ändert den Zustand der folgenden Seiten.
- Fehler können erst nach vielen Schritten aufdeckt werden.
- Es sollten nicht nur erfolgreiche Wege aufgeführt werden, sondern auch Beispiele für Wiederherstellung und Fehlerbehebung.
- Das Ergebnis der Aufgabe wird anhand des Status des Geschäfts überprüft, und nicht nur anhand der letzten Antwort.
Erweitertes Lernumfeld
Das RL-Modul ermöglicht es, in der sicheren Simulation zahlreiche Trajektorien wiederholt zu erfassen und zu bewerten, wodurch Risiken wie Captchas auf echten Webseiten, Sperrungen sowie Probleme mit den Produktionsdaten vermieden werden. Das Entwicklerteam kann daraufhin die Zuweisung von Ressourcen sowie die Fehlerbehebung in langwierigen Prozessen optimieren.
Forschungsfragen für das verstärkte Lernen
- Wie werden die endgültigen Belohnungen für den Erfolg an die Zwischenschritte verteilt?
- Wann sollte ein Agent versuchen, es erneut zu versuchen, auf einen alternativen Ansatz zurückgreifen oder die Strategie wechseln.
- Merker- und Zustandsverfolgung in cross-App-Workflows.
- Ausrichtung und Validierung von Feldern in komplexen Formularen.
- Abwägen zwischen Handlungs-kosten, Zeitaufwand und Erfolgsrate.
SDRBench-Benchmark
SDRBench, das von Foundry veröffentlicht wurde, ist ein Simulationswerkzeug für den Prozess der Vertriebsentwicklung – es handelt sich dabei um einen wiederverwendbaren Browser-Test sowie ein Trainingsumfeld für das maschinelle Lernen. Es umfasst 50 deterministische Aufgaben und behält den Zustand über verschiedene Anwendungen hinweg bei.
Die Aufgaben umfassen Geschäftsprozesse im Stil von Gmail, Sheets und LinkedIn für die Kundenakquise sowie Apollo und Salesforce, und dienen der Analyse von Leads, der personalisierten Ansprache von Kontakten, der Kundenverwaltung sowie der Bewertung der Eignung potenzieller Kunden.
Referenzabdeckungsfähigkeit
| Arbeitsphase | Vertretungsaufgaben | Benötigte Fähigkeiten des Agenten |
|---|---|---|
| Spurensuche | Suchen nach Firmen- und Kontaktdaten | Suchen, Lesen und Integration von Beweisen |
| Vorbereitung für die Außenkommunikation | Persönliche Inhalte auf der Grundlage von Hinweisen erstellen | Kontextverständnis und Texterstellung |
| Tabellenverwaltung | Lese- und Aktualisierungsliste der Hinweise | Strukturierte Datenverarbeitung |
| CRM-Wartung | Erstellen, Ändern und Fortschreiben von Aufzeichnungen | Rechte, Felder und Statusprüfungen |
| Qualifikationsbewertung | Potenzielle Kunden nach den Regeln bewerten | Mehrfaktorisches Schlussfolgern |
| Übertragung zwischen Anwendungen | Übertragung von Status zwischen E-Mails, Formularen und CRM | Langfristiges Gedächtnis und Konsistenz |
Offizielle Rangliste
Die Rangliste zeigt Modelle, die durchschnittliche Erfolgsrate sowie die durchschnittliche Dauer der erfolgreichen Aufgaben an und bietet eine Analyse der Prozessphasen. Zudem ermöglicht sie es Teams, eigene Agenten einzustellen, bestehende Agenten zu optimieren oder ihre Unternehmensprozesse mit Referenzwerten zu vergleichen.
Bei der Überprüfung gibt die Seite an, dass es sich um die Version von SDR Automation Benchmark vom September 2025 handelt, doch in der Tabelle werden keine verfügbaren öffentlichen Ergebnisse angezeigt. Im Haupttext des Verzeichnisses sollten keine fiktiven Ranglisten oder Erfolgsraten aufgeführt werden.
Übereinstimmung zwischen Simulation und realer Umgebung
Foundry schlägt vor, Aufgaben parallel in der Simulation und in der realen Umgebung auszuführen, wobei die Genauigkeit anhand der Korrelation der Erfolgsraten, der Pearson-Korrelation sowie der Übereinstimmung bei der Sortierung überprüft wird. Das System muss außerdem Abweichungen in der realen Benutzeroberfläche erkennen und die Simulation kontinuierlich kalibrieren.
Bewerten, ob die Simulation glaubwürdig ist
- Wählen Sie eine Gruppe von autorisierten und risikokontrollierten realen Geschäftsaufgaben aus.
- In der Simulation und in der realen Umgebung werden dieselben Agenten und Aufgabendefinitionen verwendet.
- Vergleichen Sie die Erfolgsraten, Schritte, Dauer und Fehlerarten.
- Berechnung der absoluten Differenzen, der Korrelationen und der Konsistenz der Modellrangfolge.
- Untersuchen Sie, ob die Unterschiede von den Seiten, den Daten, dem Netzwerk oder den Geschäftsregeln stammen.
- Die Simulation anpassen und erneut ausführen, bis der vorgegebene Fehlerbereich erreicht ist.
Anschlussmöglichkeit des Python SDK
Ein Beispiel von der offiziellen Website zeigt, wie Aufgaben über AWE-Umgebungsobjekte erstellt und ausgeführt werden. Dabei wird die Verbindungsadresse zur CDP ermittelt, anschließend wird die Browser-Sitzung an den vorhandenen Agenten übergeben. Nach der Ausführung können der endgültige Zustand, Zustandsänderungen sowie Ereignisse abgerufen werden.
Anmeldeprozess
- Beantragen Sie einen privaten Test und erhalten Sie ein Konto auf der Plattform sowie Aufgaben und Schlüssel.
- Installieren Sie das von der Plattform bereitgestellte Python SDK in einer isolierten Entwicklungsumgebung.
- Erstellen Sie eine AWE-Umgebung mit der Task-ID und aktivieren Sie die Ereignisprotokollierung.
- Lesen Sie die Aufgabenbeschreibung und übergeben Sie die Browser-Verbindungsadresse an den Agenten.
- Führen Sie den Agenten aus und warten Sie darauf, dass er seine Ergebnisse einreicht oder die Beendigungsbedingungen erfüllt sind.
- Erhalten Sie den Endzustand, Zustandsänderungen, Ereignisse und Verläufe.
- Verwenden Sie die Standardantworten oder betriebsbezogenen Heuristiken zur Berechnung der Punktzahl.
Erstellen eines Tutorials zur Rückgabewertung
- Wählen Sie eine repräsentative Aufgabensammlung nach Geschäftswert, Schwierigkeit und Risiko aus.
- Einfrieren von Aufgabeneingaben, Anfangszustand, Akzeptanzkriterien und Umgebungsversion.
- Definieren Sie Bewertungen für Erfolg, teilweisen Erfolg, fehlerhafte Änderungen und Zeitüberschreitung.
- Protokollieren Sie das Modell, die Hinweise, die Tool-Version, die Parameter und den Zufallskeim.
- Mehrfache Ausführungen, um den Durchschnitt, die Schwankung und die Konfidenzintervalle zu berechnen.
- Identifizieren Sie Hinweise auf Probleme bei der Art des Scheiterns – visuell, in der Planung oder bei der Ausführung.
- Fügen Sie einen Schwellenwert in den Veröffentlichungsprozess ein, um offensichtlich verschlechterte Versionen davon abzuhalten, veröffentlicht zu werden.
Leitfaden zur Erstellung von Trainingsdaten
- Bestimmen Sie die Zielplattformen, Benutzerrollen, Berechtigungen und wertvollen Prozesse.
- Teilen Sie den Workflow in überprüfbare Anfangszustände, Schritte und Ergebnisse auf.
- Von autorisierten Experten durchgeführt und mit einer vollständigen Aufzeichnung des Verlaufs.
- Markieren Sie Beobachtungen, Aktionen, Felder, Gründe, Fehler und Wiederherstellungen.
- Entfernen Sie echte persönliche Daten, Schlüssel sowie Klientengeheimnisse.
- Die Qualität der Bahnen wird durch doppelte Überprüfung und automatische Regelprüfungen überwacht.
- Teilen Sie die Datensätze in Trainings-, Validierungs- und Testdaten auf, um einen Datenleak zu verhindern.
Leitfaden zur Bewertung von Agenten einreichen
- Überprüfen Sie Ihre Berechtigung für private Tests und lesen Sie die aktuellen Einreichungsanforderungen.
- Festlegung der Version des intelligenten Agenten, des Modells, der Tools und der Laufparameter.
- Verwendung eines Test-Schlüssels zur Überprüfung der Verbindung, zum Beenden sowie zur Fehlerbehandlung.
- Übermitteln Sie den Agenten und lassen Sie die Plattform Standardaufgaben ausführen.
- Überprüfen Sie die Erfolgsrate, die Dauer, die Aktionen sowie die Fehlerinformationen.
- Beheben Sie es in der Phase des Scheiterns und testen Sie es erneut im selben Umfeld.
- Bei der Veröffentlichung der Ergebnisse sollen gleichzeitig Version, Datum und Methode angegeben werden.
Für welche Benutzer geeignet
- Browser-Agentur-Unternehmen: Es ist notwendig, Produktupdates stetig zu testen.
- Großes Modell-Team: Training der Fähigkeiten zur Verständnis und Handhabung von Webseiten.
- Agent RL-Team: Es werden ein wiederherstellbarer und skalierbarer Umgebungsrahmen benötigt.
- Unternehmens-Automatisierungs-Team: Überprüfung, ob Agenten sicher interne Systeme bedienen können.
- Daten-Team: Einkauf oder Erstellung hochwertiger Langzeitdatensätze.
- Forschungseinrichtung: Analyse der cross-Anwendungs-Planung, Wiederherstellung und Kreditzuweisung.
- Modellbewertungsteam: Etablierung eines Browser-Benchmarks mit Zustandsbelegen.
Typische Anwendungsszenarien
- Vergleichen Sie die Erfolgsraten verschiedener Modelle in denselben Unternehmensprozessen.
- Hinweise zu Regressionstests, Updates für Tools oder Browser-Executor.
- Bestimmen, an welcher Stelle der intelligente Agent bei Klicken, Eingabe oder Entscheidungsfindung versagt.
- Agenten ausbilden, die mit E-Mails, Tabellen, Kundenakquise und CRM arbeiten können.
- Testen Sie Schreibvorgänge, ohne die Produktionsdaten zu berühren.
- Erstellung von überwachtem Feinabstimmung und Verstärkungslernen-Tracks.
- Die spezifischen Arbeitsabläufe der Kunden in interne Standards umwandeln.
- Bewerten, ob die Webseite für den Einsatz von automatisierten Agenten geeignet ist.
Vorteile des Produkts
- Die Umgebung kann zurückgesetzt werden, um einen fairen Vergleich zwischen verschiedenen Agenten zu ermöglichen.
- Auf die Endzustände und die Überprüfung der Zustandsänderungen, und nicht nur auf die Antworten.
- Die Klassifizierung der einzelnen Aktionen hilft dabei, die wahren Ursachen für Misserfolge zu ermitteln.
- Simulation vermeidet echte Website-Verifizierungscodes, Sperrungen und Geschwindigkeitsbeschränkungen.
- Gleichzeitig abdeckt es die Bewertung, die Daten sowie den Trainingsprozess des verstärkten Lernens.
- Unterstützung für langwierige Prozesse sowie Workflows in verschiedenen Anwendungen und im Unternehmensumfeld unter Verwendung von SaaS-Lösungen.
- Das Python SDK kann mit bestehenden Browser-Agenten-Frameworks verbunden werden.
- SDRBench bietet einen öffentlichen Zugang zur Aufgabengestaltung und Forschung.
Einsatzbeschränkungen und Hinweise
- Die Plattform befindet sich noch in der privaten Testphase und erfordert eine Anfrage zur Zugangserteilung.
- Die offizielle Website gibt keine Informationen zu festen Paketen, kostenlosen Gebühren oder Preisen nach Verbrauch preis.
- Die Seite mit dem Beispiel-Datensatz ist als bald verfügbar gekennzeichnet und darf nicht als bereits zum Download freigegeben angesehen werden.
- Bei der Überprüfung der offiziellen Rangliste wurden die Ergebnisse der verfügbaren Modelle nicht angezeigt.
- Simulierungen weisen immer möglicherweise visuelle, zeitliche Verzögerungen sowie Unterschiede in den Regeln im Vergleich zu echten Webseiten auf.
- Unternehmensspezifische Umgebungen und manuelle Abläufe können höhere Herstellungskosten mit sich bringen.
- Echte Kontodaten, Anmeldedaten und Zahlungsdetails gehören zu hochsensiblen Informationen.
- Die Referenzwerte beziehen sich nur auf bestimmte Aufgaben und Versionen und können keine allgemeine Autonomiefähigkeit nachweisen.
- Die Verwendung des Python SDK bedeutet nicht, dass die Plattform, die Umgebung oder die Daten offen zugänglich sind.
- Es wurden weder offizielle GitHub-Repositorien noch eine klare Open-Source-Lizenz gefunden.
- Die Datenschutzrichtlinie legt keine feste Aufbewahrungsfrist für verschiedene Arten von Daten fest.
Preise und Zugangsmöglichkeiten
| Projekt | Aktueller Zustand | Kosteninformationen |
|---|---|---|
| Offizielle Website besuchen | Öffentlich | Kostenloser Zugang zu Produktbeschreibungen, Studien und Ranglisten |
| Rangliste ansehen | Öffentlich | Keine Gebühren erforderlich, jedoch werden derzeit keine Leistungsdaten angezeigt. |
| Private Tests | Antrag auf Zugang | Nicht offengelegter Festpreis |
| Vollständige Plattform | Antrag auf Zugang | Verhandeln nach Team, Umgebung, Aufgabe und Größe |
| Customisierte Unternehmenssimulation | Unternehmensdienstleistungen | Es muss entsprechend der Website und des Workflow-Preises kalkuliert werden. |
| Daten für die Ausbildung von Experten | Unternehmensdienstleistungen | Kostenangebot nach Bereich, Streckenlänge und Qualitätsanforderungen |
| Agent übergibt Bewertung | Kontaktieren Sie das Team | Auf der öffentlichen Seite sind die Gebührenregeln nicht aufgeführt. |
| Beispiel-Datensatz | Bald verfügbar | Es gibt noch keine offiziellen Preise oder eine Möglichkeit zum Download. |
Das Datum der Preisüberprüfung ist der 22. August 2026. Foundry hat noch keine Preise für Standardabonnements, Gebühren nach Nutzung oder Unternehmensverträge bekannt gegeben, weshalb die Preise nicht anhand anderer, gleichnamiger Foundry-Produkte festgelegt werden können.
Was muss bei der Kostenschätzung überprüft werden?
| Preisvariablen | Dinge, die bestätigt werden müssen | Mögliche Faktoren, die die Kosten beeinflussen können |
|---|---|---|
| Anzahl der Umweltfaktoren | Unternehmensanwendungen und Versionen, die simuliert werden müssen | Jede Anwendung muss modelliert und gewartet werden. |
| Aufgabenumfang | Anzahl der Aufgaben, Schwierigkeitsgrad, durchschnittliche Anzahl der Schritte und Status | Lange Aufgaben ausführen und mehr annotieren |
| Konkurrenz und Anzahl der Vorkommen | Tägliche oder monatliche Verläufe, Konkurrenzen und Spitzenwerte | Einfluss auf die Berechnungen und die Ressourcen des Browsers |
| Daten-Dienste | Ist eine Expertenvorführung, Überprüfung und Fehlerkorrektur erforderlich? | Die Kosten für künstliche Qualität weisen große Unterschiede auf. |
| Auflösung | Visuelle Anforderungen, Verhaltensanforderungen, Datenanforderungen und Verzögerungsanforderungen | Hochauflösung erfordert mehr Kalibrierung. |
| Einsatz und Sicherheit | Gemeinsame, dedizierte oder private Umgebungen | Isolierungs- und Konformitätsanforderungen beeinflussen die Architektur |
| Unterstützung | SLA, Reaktionszeit, Anpassung und Forschungshilfe | Unternehmensunterstützung wird in der Regel separat berechnet. |
Unterstützung für Plattformen und technische Schnittstellen
| Plattform oder Schnittstelle | Support-Status | Verwendung |
|---|---|---|
| Web-Website | Unterstützung | Produktbeschreibung, Antragstellung und Forschungsinhalte |
| Simulierte Browserumgebung | Unterstützung | Ausführen und Zurücksetzen von Webseitenaufgaben |
| Python SDK | Private Tests zur Verfügung stellen | Anbindung an bestehende Agenten-Workflows |
| CDP-Browser-Verbindung | Beispiele zeigen die Unterstützung | Lassen Sie den Agenten den Aufgaben-Explorer steuern. |
| Ereignis- und Zustandsinterface | Beispiele zeigen die Unterstützung | Lese Ereignisse, Endzustand und Änderungen |
| Offizielle Rangliste | Unterstützung | Darstellung von Standardreferenzen und Methoden |
| Eigene Desktop- oder Mobile-App | Nicht gefunden | Das Produkt richtet sich hauptsächlich an Forschung und Entwicklung sowie an Unternehmensanschlüsse. |
| Offene Self-Service-Konsole | Nicht gefunden | Vollständige Funktionalität erfordert eine private Testberechtigung. |
Sicherheit von API-Schlüsseln und Anmeldeinformationen
Beispiele für SDKs erfordern einen Foundry-Schlüssel; die Aufgaben können außerdem Anmeldedaten sowie Zahlungsdetails enthalten. Das Team sollte Testkonten, fiktive Zahlungsmittel sowie ein isoliertes Schlüsselverwaltungssystem verwenden und sicherstellen, dass keine Produktionsdaten in das Trainingsset oder die Protokolle gelangen.
- Verwenden Sie für jede Umgebung und jedes Team eigene, austauschbare Schlüssel.
- Nur dem Testkonto werden die Berechtigungen gewährt, die zur Erfüllung der Benchmarks erforderlich sind.
- In den Protokollen und Spuren werden Passwörter, Token, Zahlungs- sowie persönliche Felder ausgeblendet.
- Es ist Agenten untersagt, auf Domainnamen und Netzwerke außerhalb des Aufgabengebiets zuzugreifen.
- Einstellen von Laufzeitüberschreitung, Aktionslimit und Notbeendigung.
- Es werden zusätzliche Genehmigungen für die Exportierung von Daten und die Veröffentlichung von Ranglisten eingeführt.
- Regelmäßig werden abgelaufene Zugangsdaten sowie Testdaten abgeschlossener Projekte vernichtet.
Privatsphäre und Datenerfassung
Zu den von der Datenschutzerklärung aufgeführten von Nutzern eingereichten Informationen gehören E-Mail-Adresse, Name, Organisation, von Agenten eingereichte Daten, Referenzwerte sowie Kommunikationsinhalte. Zu den automatisch erfassten Informationen zählen Nutzungsanalysen, Geräteinformationen, IP-Adressen, Cookies, Leistungsindikatoren und Fehlerprotokolle.
Diese Daten werden für Betriebsdienste, die Verarbeitung von von Agenten eingereichten Daten, die Erstellung von Referenzwerten, die Verbesserung der Produkte sowie zur Unterstützung der Kommunikation und Sicherheit verwendet. Anbieter für Hosting, Analyse und Kundenservice können bei der Erfüllung ihrer Aufgaben entsprechende Daten verarbeiten.
Offenlegung und Vertraulichkeit der Rangliste
Laut den Richtlinien können die Leistungsdaten der KI-Agenten sowie die Referenzwerte in offiziellen Ranglisten angezeigt werden. Allerdings werden personenbezogene Informationen ohne ausdrückliche Zustimmung nicht veröffentlicht. Unternehmen sollten vor der Einreichung sicherstellen, ob der Name des KI-Agenten, die Konfiguration des Modells sowie die Informationen zu Fehlern veröffentlicht werden sollen.
Datenhaltung, grenzüberschreitend und Rechte
Personenbezogene Daten werden so lange aufbewahrt, wie es für die Erbringung von Dienstleistungen und zur Erfüllung der gesetzlichen Vorgaben notwendig ist, oder so lange, wie es gesetzlich vorgeschrieben ist; es werden keine festen Zeitraume angegeben. Die Daten können in andere Länder übertragen werden, wobei die geltenden Datenschutzmaßnahmen eingehalten werden müssen.
Je nach Standort können Nutzer den Zugriff auf Daten, deren Aktualisierung, Löschung, Einschränkung oder Ablehnung der Verarbeitung sowie die Übertragung der Daten und die Widerrufung der Zustimmung beantragen. Der Dienst ist nicht für Kinder unter 13 Jahren bestimmt.
GitHub, SDK und Open-Source-Status
Die offizielle Website zeigt Beispiele für die Integration des Python SDK, doch es gibt weder ein offiziell bestätigtes öffentliches GitHub-Repo noch eine Paketseite oder eine Open-Source-Lizenz. Das SDK wird vermutlich nur an private Testkunden verteilt.
| Projekt | Offener Status | Fazit |
|---|---|---|
| Foundry-Plattform | Proprietäre Unternehmensdienste | Das Produkt selbst ist nicht open source. |
| Python SDK | Die offizielle Website ist nur zugänglich, wenn man Zugang erhält. | Auf der öffentlichen Seite wird keine Lizenz angegeben. |
| SDRBench-Paper | öffentlich lesbar | Die Veröffentlichung einer wissenschaftlichen Arbeit bedeutet nicht, dass der zugehörige Code offen zugänglich ist. |
| Beispiel-Datensatz | Markierung wird bald veröffentlicht | Kann nicht als veröffentlicht behandelt werden. |
| Offizieller GitHub | Kein Lager wurde gefunden, das bestätigt werden kann. | Verwechseln Sie Microsoft oder andere gleichnamige Projekte nicht. |
| Code für die Simulationsumgebung | Nicht veröffentlicht | Es ist nicht möglich, die Anwendung allein über die offizielle Website zu bereitstellen. |
Unterschiede zu Microsoft Foundry
| Vergleichspunkte | Diese Seite: Foundry | Microsoft Foundry |
|---|---|---|
| Betreibende Stelle | Unabhängiges Team für Browser-Agenten-Plattformen | Microsoft |
| Hauptverwendungszweck | Web-Seiten-Simulation, Bewertung, Daten und Verstärkungslernen | Erstellung, Bereitstellung und Verwaltung von Unternehmens-AI-Anwendungen und Agenten |
| Hauptanschlüsse | Privates Python SDK und Simulationsbrowser | Azure-Cloudplattform, SDKs und Dienste |
| Preis | Private Tests, nicht öffentlich | Abrechnung nach spezifischen Azure-Diensten und Ressourcen |
| SDRBench | Offizielle Forschungsreferenzwerte | Es liegt nicht an der Zusammensetzung des Produkts. |
| Website-Domain | thefoundryai.com | Microsoft Cloud-Dienstleistungen |
Grundlegende Informationen
| Projekt | Inhalt |
|---|---|
| Name des Tools | Foundry |
| Ehemalige Markendomaine | foundryrl.com |
| Arten von Werkzeugen | Plattform für die Simulation von Browser-Agenten, Bewertung sowie Daten- und Verstärkungsunterrichtung |
| Kernmotor | Agent Web Engine |
| Offener Referenzwert | SDRBench |
| Aufgabenumfang | SDRBench enthält 50 deterministische Aufgaben. |
| Verbindungsstatus | Private Tests |
| Preismuster | Nicht öffentlich, Antrag auf Zugang zur Unternehmensbesprechung |
| Hauptplattformen | Web, Simulationsbrowser und Python SDK |
| Entwicklungs sprache | Beispiel für die offizielle Website ist Python |
| Offene API | Keine vollständigen öffentlichen Selbsthilfedokumente bereitgestellt. |
| Offizielles SDK | Angebote für den Zugriffspfad des Python SDK |
| Ist das Produkt open source? | Nicht open source |
| Offizieller GitHub | Nicht bestätigt |
| Datum der Aktualisierung der Datenschutzerklärung | 28. Oktober 2025 |
| Datum der Preisüberprüfung | 22. August 2026 |
Empfehlungswert
Empfehlungswert: 4,1 / 5. Foundry bietet klare Richtlinien zur Bewältigung der schwierigsten Probleme bei Browser-Agenten – wie Umweltveränderungen, die Bewertung langfristiger Abläufe sowie Probleme mit den Trainingsdaten. Geeignet für professionelle Entwicklerteams für Agenten.
Der Hauptmangel besteht darin, dass es sich weiterhin um private Tests handelt, die Preise sowie die vollständigen Dokumentationen nicht öffentlich zugänglich sind und es derzeit keine Ergebnisse in den Ranglisten gibt. Gewöhnliche Nutzer sowie Unternehmen, die lediglich die Automatisierung von Webseiten anstreben, profitieren nicht direkt davon.
Häufige Fragen
Was macht eine Foundry?
Es bietet dem Team der Browser-Agenten wiederverwendbare Webseiten-Simulationen, Umgebungen zur Durchführung von Tests, Daten zu langfristigen Expertenverhaltensmustern sowie Umgebungen für das Training mit Verstärkungslernen.
Ist das Microsoft Foundry?
Nein. Die Produkte auf dieser Seite werden von einem unabhängigen Team betrieben, das sich auf die Simulation und Bewertung von Browser-Agenten konzentriert – im Gegensatz zur gleichnamigen Cloud-Plattform von Microsoft.
Ist Foundry kostenlos?
Die Website kann kostenlos besucht werden, doch die vollständige Plattform befindet sich noch in der privaten Testphase. Es werden weder kostenlose Nutzungslimits noch Standardpakete oder feste Unternehmenspreise angegeben.
Wie erhält man die Zugriffsberechtigung?
Man muss eine Anfrage auf der offiziellen Website stellen, um einen privaten Test durchzuführen, oder sich mit dem Team in Verbindung setzen, um die Anforderungen bezüglich der Agenten, Aufgaben, Umgebung, Anzahl der Bewegungswege sowie der Daten zu erläutern.
Wird ein Python SDK bereitgestellt?
Es werden Zugangspfade bereitgestellt; die offizielle Website zeigt Python-Beispiele zur Verwendung der AWE-Umgebung, zum Task-ID, zur Browserverbindung sowie zum Lesen von Ereignissen.
Was ist SDRBench?
Es handelt sich um einen zurücksetzbaren Browser-Referenzrahmen sowie ein Lernumfeld für verstärktes Lernen, das für Workflows im Vertriebsentwicklungsbereich konzipiert ist und 50 deterministische, anwendungsübergreifende Aufgaben enthält.
Gibt es in der Rangliste die Ergebnisse der Modelle?
Die Rangliste enthält Felder für das Modell, die Erfolgsrate und die Dauer, doch bei der Überprüfung wird angezeigt, dass es keine verfügbaren Referenzwerte gibt, weshalb keine Rangliste erstellt werden kann.
Kann man eigene Agenten bewerten?
Es ist möglich, einen Agenten einzureichen, oder man kann sich an das Team wenden, um sein eigenes Datensatz oder Unternehmensworkflow als Referenz zu verwenden. Die genauen Voraussetzungen und Kosten sind nicht öffentlich bekannt.
Kann man auf einer echten Website trainieren?
Der Schwerpunkt von Foundry liegt auf kontrollierter Simulation, um Abweichungen im Vergleich zur echten Website sowie automatisierungsbedingte Einschränkungen zu vermeiden. Die Ergebnisse der Simulation müssen dennoch in einer autorisierten, realen Umgebung überprüft werden.
Kann man Trainingsdaten erzeugen?
Es können angepasste Daten mit langen Trajektorien zur Verfügung gestellt werden, die von Experten annotiert wurden, für das überwachte Feintuning auf echten Unternehmensplattformen. Die genauen Mengen, Qualitätsstandards und Preise müssen verhandelt werden.
Ist Foundry Open Source?
Keine Open-Source-Lösung. Die Artikel und SDK-Beispiele sind öffentlich zugänglich, doch es gibt weder den offiziellen Quellcode für die Open-Source-Plattform noch eine Simulationsumgebung oder eine klare Lizenz.
Kann das Beispieldatensatz heruntergeladen werden?
Im Überprüfungsmodus wird das Beispieldatensatz weiterhin als bald verfügbar angezeigt und kann daher nicht als bereits freigegeben betrachtet werden.
Wird das Ergebnis öffentlich veröffentlicht?
Hinweise zur Datenschutzerklärung: Die Leistungsdaten der KI sowie die Referenzwerte können in offiziellen Ranglisten erscheinen. Vor der Einreichung sollten offengelegte Felder und Anforderungen an die Vertraulichkeit überprüft werden.
Wie lange werden die Daten gespeichert?
Die Datenschutzrichtlinie gibt nur den Zeitraum an, der für die Erbringung des Dienstes oder aufgrund gesetzlicher Anforderungen erforderlich ist; es gibt keine festgelegte Dauer für die Speicherung. Die Vertragsbedingungen sollten für jede Kategorie separat festgelegt werden.
Eignet es sich für normale Nutzer der Webautomatisierung?
In der Regel geeignet nicht. Es richtet sich an professionelle Teams, die Browser-Agenten entwickeln, trainieren und bewerten, und nicht daran, gewöhnliche Benutzer dabei zu unterstützen, den Ablauf von Webseiten direkt aufzunehmen.
Zusammenfassung
Foundry bringt die Webumgebung, den Zustand, Ereignisse, Bewertungen sowie die Trainingsverläufe in derselben Infrastruktur zusammen, wodurch den Browser-Agent-Teams stabile, vergleichbare und wiederholbare Entwicklungszyklen ermöglicht werden. SDRBench zeigt konkrete Ansätze für langfristige Prozesse über verschiedene Anwendungen hinweg.
Teams, die dies in Betracht ziehen, sollten zunächst um einen privaten Test anfragen, um mithilfe eigener Testaufgaben die Übereinstimmung zwischen der Simulation und der realen Umgebung zu überprüfen. Zudem müssen im Vertrag Preis, Datensicherheit, Offenlegung der Ergebnisse, Trennung der Zugangsdaten, Aufbewahrungsfrist sowie die Lizenzen für das SDK festgelegt werden.
Tools, die den Foundry ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164