




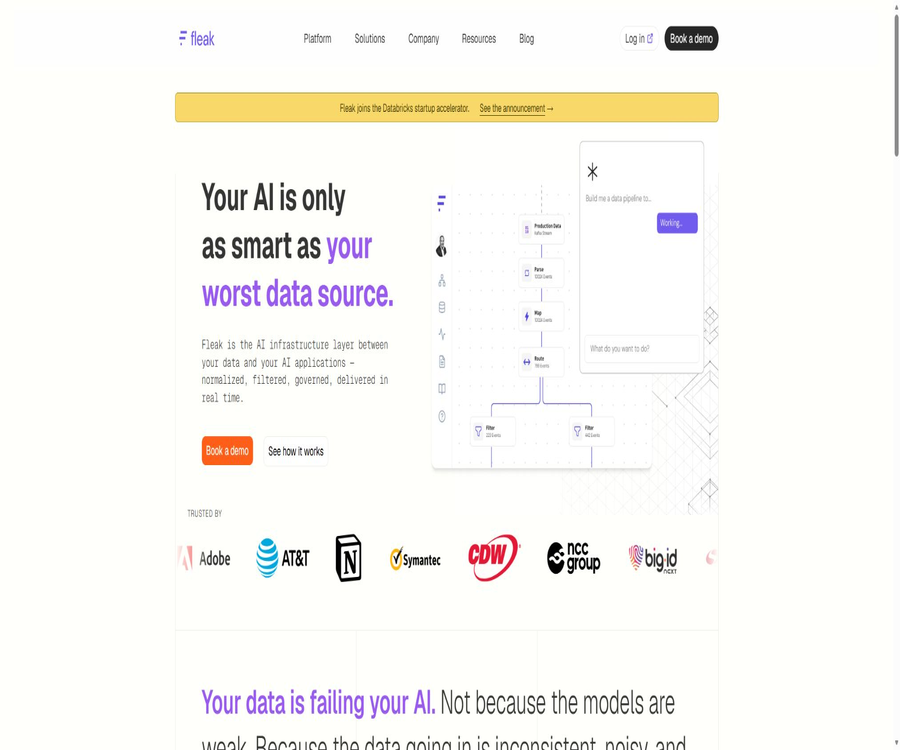
Fleak
Fleak – ein intelligentes Tool, das sich auf die AI-gestützte Gestaltung konzentriert.
Tags:KI-Design-ToolsEine kurze Beschreibung
Fleak ist eine Echtzeit-Dateninfrastruktur für Unternehmens-KI, Maschinendaten und Stream-Analyse, die die Analyse, Standardisierung, Filterung, Deduplizierung, Verwaltung sowie die Wertbasierte Routenplanung zwischen Datenquellen und KI-Anwendungen ermöglicht.
Einführung in die Tools
Fleak wurde von Fleak Tech Inc. entwickelt und dient derzeit als datenbasierte Schicht für KI-Anwendungen – und nicht als allgemeiner Chatbot. Die Benutzer erstellen Datenflüsse mithilfe visualisierter DAGs oder in natürlicher Sprache, die anschließend in gehostete Rechenclustern eingesetzt werden, um eine verteilte, asynchrone Verarbeitung zu ermöglichen.
Die Plattform löst hauptsächlich Probleme wie inkompatible Datenschemata, Änderungen im Schema der Quellsysteme, wiederholte Ereignisse, unnötiger Speicherbedarf durch wertlose Daten sowie unterschiedliche Berechtigungen der verschiedenen Zielsysteme. ZephFlow ist dabei ein eigenständig nutzbarer, open-source-basierter, zustandsloser Verarbeitungsmotor.
Zusammensetzung des Produkts
| Zusammensetzung | Hauptfunktion | Arbeitsweise | Offener Zustand |
|---|---|---|---|
| Fleak-Hosting-Plattform | Verbinden, orchestrieren, bereitstellen, überwachen und verwalten von Datenpipelines | Verwaltete Rechenclustern | Wirtschaftsdienstleistungen, Terminvereinbarung für Demonstrationen |
| Workflow Builder | Kanäle, Verarbeitungsknoten und Ausgaben mit DAG konfigurieren | Web-Oberfläche | Dokumente sind öffentlich, Kontofunktionen gemäß dem Plan |
| AI Copilot | Konfiguration des Natural-Language-Generation-Pipelines und Unterstützung bei Schema-Änderungen | Innerhalb der Plattform verwenden | Unternehmensfunktionen |
| ZephFlow Core | Zustandsloser, fließender Datenauswertung | Eingebettete Anwendungen, eigenständige Prozesse oder Netzwerkdienste | Apache 2.0 Open Source |
| ZephFlow Python SDK | Kombination von Filtern, Umwandlungen und Fehlerbehandlung mit Python | Python ruft den Java 17-Engine auf | Apache 2.0 Open Source |
Wirkungsprinzip
- Rohdaten werden über Kafka, Splunk, Maschinenprotokolle, Datenbanken, Industriesysteme oder andere Quellen bereitgestellt.
- Durch KI oder Regeln werden Eventtypen, Bedeutungen von Feldern, Schemata sowie Anforderungen an nachgelagerte Anwendungen erkannt.
- Verwenden Sie Analyse, Filtern, Aussagen, Ausdrücke oder SQL-Node zur Reinigung, Überprüfung, Standardisierung und Verzweigung.
- Leiten Sie die Einträge gemäß ihrem aktuellen Wert, ihrem Konformitätswert und dem Ziel-Schema an verschiedene Ziele weiter.
- Nach dem Bereitstellen in einem Hosted-Computing-Cluster wird die Verarbeitung kontinuierlich fortgesetzt, und im Überwachungspanel werden Durchsatz, Fehler sowie der Gesundheitszustand der Pipeline überwacht.
- Bei der Erkennung von Schema-Drifts im Oberfluss wird eine neue Konfiguration erstellt, die nach Überprüfung durch das Team erneut bereitgestellt wird.
Hauptfunktionen
KI-basierte Wertschätzung der Routen
Fleak bewertet den Wert jedes eingegebenen Datensatzes für nachgelagerte KI- oder Geschäftsanwendungen und entscheidet anschließend, ob dieser in Echtzeit übertragen, langfristig gespeichert oder verworfen werden soll. Auf diese Weise können unnötige, wiederholte und wertlose Ereignisse reduziert werden, bevor sie in einen Data Lake, ein SIEM oder ein Modell gelangen.
Layout in natürlicher Sprache
Die Benutzer können das Ziel in natürlicher Sprache beschreiben, wobei Copilot die Konfiguration zur Datenverarbeitung erstellt. Die Ergebnisse müssen dennoch mit echten Datensätzen überprüft werden, um Felder, Grenzbedingungen und Fehlerbehandlungsmechanismen zu validieren; die Beschreibungen können nicht direkt als Produktionsregeln verwendet werden.
Selbstheilendes Schema-Driften
Die Plattform kann Änderungen am upstream-Schema erkennen, Benachrichtigungen senden und neue Konfigurationen erstellen. Auf der offiziellen Website gibt es Seiten zum automatischen Neudeploy, es gibt aber auch Anleitungen, die eine Genehmigung durch den Benutzer vor dem Deploy erfordern. Im Produktivumfeld sollte die Konfiguration nach dem Prinzip „automatische Erkennung und Erstellung, anschließende manuelle Überprüfung vor Veröffentlichung“ erfolgen.
Visualisierung von DAG-Workflows
Der Workflow Builder verbindet Kanäle, Verarbeitungs- und Ausgabeknoten zu einem gerichteten, zyklischen Graphen, wobei die Ausgabe jedes oberfließenden Knotens zur Eingabe des folgenden Knotens wird. Vor der Veröffentlichung prüft die Plattform den DAG, danach kümmert sich das Hosted-Cluster um Parallelisierung, Konkurrenz und Lastverteilung.
Mehrfachformat-Parser
Parser-Node können strukturierten oder halbstrukturierten Text wie JSON, Schlüssel-Wert-Paare, CSV, Grok, Syslog, CEF sowie mehrzeiligen Windows-Text verarbeiten. Die nach der Analyse ermittelten Felder können anschließend zur Filterung, für Aussagen, für SQL-Anfragen sowie für die Schema-Konvertierung verwendet werden.
Filtern, Aussagen und Ausdrücke
Filter dienen dazu, unerwünschte Einträge auszuschließen, Assertionen werden verwendet, um erforderliche Felder sowie die Datenqualität zu überprüfen, Fleak Eval ist für die Erstellung oder Änderung von Feldern zuständig. Fehlgeschlagene Einträge können in die Fehlerverfolgung oder in die Warteschlange für ungelesene Nachrichten gelangen.
SQL-Datenumwandlung
FleakSQL ermöglicht es Teams, die mit SQL vertraut sind, Datensätze umzuwandeln und somit die Kosten für das Lernen spezieller Ausdrücke zu reduzieren. Die Unterstützung umfasst nicht alle Datenbankdialekte; vor der Migration komplexer Abfragen ist es notwendig, sich in den Syntax-Dokumenten zu informieren und Kompatibilitätsprüfungen durchzuführen.
Doppelte Einträge entfernen und Standardisieren
Die Plattform filtert die Daten, entfernt Doppelungen und standardisiert das Schema, bevor sie in der Speicherung oder im Modell verwendet werden. Dadurch können Doppelungen in der Speicherung, bei Abfragen sowie im Modellkontext reduziert werden. Die von der offiziellen Website angegebenen Kostensenkungen sind lediglich Werbeangaben; die tatsächlichen Ergebnisse hängen von der Datenqualität und den geltenden Regeln ab.
Feingranularer Governance- und Auditservice
Fleak führt die Zugriffskontrolle auf der Datenebene durch und protokolliert den Transformations- sowie Lieferprozess. Die offizielle Website weist einen vollständigen Auditrückverfolgungsmechanismus sowie SOC 2 Type II aus. Unternehmen sollten bei der Beschaffung die neuesten Berichte, den Umfang, Ausnahmen sowie die Datenverarbeitungsvereinbarungen anfordern.
Verteilte asynchrone Ausführung
Nach dem Bereitstellen des Orchestrierungsworkflows wird dieser im Fleek-Rechencluster ausgeführt. Die Plattform kümmert sich automatisch um die Parallelisierung, Konkurrenzverarbeitung sowie die Anpassung der Ressourcen. Das Team muss keine eigenen Logiken für Multithreading und Lastverteilung entwickeln, muss jedoch weiterhin Kapazitäts-, Verzögerungs- und Ausfallziele festlegen.
Beobachtbarkeit
Das Überwachungspanel dient dazu, den Zustand der Leitungen, die Durchsatzraten sowie Fehler zu überprüfen. So können Unterbrechungen in der Kommunikation, Fehler bei der Verarbeitung oder Probleme am Zielort frühzeitig erkannt werden. Vor dem Einsatz in der Produktion müssen die Speicherdauer der Kennzahlen, die Kanäle für Benachrichtigungen, die Felder der Protokolle sowie die Servicelevel festgelegt werden.
Echtzeit-Übertragung ohne Speicherung
Die offizielle Website betont, dass die Daten in Echtzeit umgewandelt und direkt an das Zielsystem gesendet werden können, ohne dass sie vorübergehend auf Fleak gespeichert werden müssen. Der „Null-Speicher“-Ansatz ist eine Eigenschaft des Pipeline-Designs – er bedeutet jedoch nicht, dass Protokolle, Auditaufzeichnungen, Fehlermeldungen oder Betriebsmetadaten überhaupt nicht gespeichert werden.
Offene Knoten und Datenschemae
| Kategorie | Offiziell veröffentlichte Knoten oder Formate | Hauptverwendungszweck | Überprüfungshinweis |
|---|---|---|---|
| Kanäle | Kafka-Quelle, Splunk-Quelle | Fließende Themen und Splunk-Abfragedateneingabe | Die auf der offiziellen Website genannten Kanäle bedeuten nicht, dass für jeden Connector öffentliche Dokumente vorhanden sind. |
| Verarbeiten | Fleak Eval, Filter, Assertion, Parser, SQL | Umwandlung, Filtern, Validierung, Analyse und abfragenbasierte Verarbeitung | Ausdrücke haben im Vergleich zu SQL eine eigene Syntax. |
| Analyseformat | JSON, Schlüssel-Wert-Paare, CSV, Grok, Syslog, CEF, mehrere Zeilen in Windows | Den ursprünglichen Text in eine strukturierte Aufzeichnung umwandeln | Die Stichproben sollten Abweichungen sowie mehrere Zeilengrenzen abdecken. |
| Ausgabe | Kafka, Delta Lake, Databricks, Elasticsearch | Nachrichten, Data Lakes und Suchindizes | Die Aktualisierungsrate kann bei verschiedenen Dokumenten unterschiedlich sein. |
| Fehlerbehandlung | S3-Tot-Posten-Queue | Speichern von Fehlern bei der Aufnahme, Analyse, Assertion und Konvertierung | Die Python SDK-Dokumentation gibt ausdrücklich Unterstützung. |
| Branchenschema | Sicherheitsschemata wie OCSF, UDM, CSF usw. | Standardisierung des Sicherheitslogs | Die Genauigkeit der Abbildung muss mit dem Zieltool überprüft werden. |
Erstellen eines gehosteten Datenpipelines
- Buchen Sie eine Demo und bereiten Sie den Eingabetyp, Beispielfälle, die maximale Durchsatzrate, Verzögerungen, das Ziel-Schema sowie den Zielort vor.
- Erstellen Sie im Workflow Builder einen DAG, konfigurieren Sie die Eingangsverbindungen sowie die minimal notwendigen Leseberechtigungen.
- Fügen Sie Parser-, Filter-, Assertion-, Eval- oder SQL-Node hinzu, um schrittweise die Ausgabe jeder Phase anzusehen.
- Einstellen des Ziels für Kafka, Delta Lake, Databricks, Elasticsearch oder Vertragsunterstützung.
- Verwenden Sie Testdaten, um Fälle wie Normalfälle, fehlende Felder, Typänderungen, Duplikate, übermäßig große Datensätze sowie Unterbrechungen des Ziels zu überprüfen.
- Einrichten im gehosteten Cluster, Konfiguration von Überwachung und Alarmierung, anschließend schrittweises Erweitern über kontrollierten Traffic.
Behandlung von Schema-Drift
- Für die wichtigsten Kanäle werden erwartete Schemata, erforderliche Felder, Typen, Enumerationen und Beispieldaten festgelegt.
- Aktivieren Sie die Detektion von Drifts und Alarme, um neue Felder, gelöschte Felder, Typänderungen sowie Änderungen in der verschachtelten Struktur zu erkennen.
- Prüfen Sie die von der KI erstellten neuen Konfigurationen und Feldzuordnungen, um festzustellen, ob es zu Verlusten, fehlerhaften Umwandlungen oder einer erweiterten Datenzugriffsmöglichkeit kommt.
- Alte und neue Ereignisse auf isolierten Daten abspielen, um Erfolgsraten, Ausgabeschemata und Kompatibilität mit nachgelagerten Systemen zu vergleichen.
- Nach der Freigabe der Änderung wird es erneut bereitgestellt, wobei die alte Konfiguration, die Rollback-Methode sowie die Audit-Einträge beibehalten werden.
Einführung in ZephFlow für Python
- Stellen Sie Python 3.8 oder eine neuerere Version sowie Java 17 oder eine neuerere Version bereit, da das Python SDK auf dem Java-Verarbeitungsmotor angewiesen ist.
- Installieren Sie das zephflow-Paket, erstellen Sie eine minimale Flussstruktur lokal und überprüfen Sie die Umgebung mit Speicherevents.
- Verwenden Sie JSONPath, um Einträge zu filtern, und nutzen Sie Eval-Expressionen, um Felder zu erstellen oder die Struktur zu ändern.
- Fügen Sie Assertionen hinzu und aktivieren Sie die schrittweisen Fehleranzeige, um sicherzustellen, dass fehlerhafte Daten nicht unbemerkt in die nachgelagerten Schritte gelangen.
- Für kontinuierliche Kanäle muss ein Profil oder eine Kafka-Quelle konfiguriert werden, und für Produktionsfehler sollte eine S3-Dead-Letter-Queue eingerichtet werden.
- Speichern Sie die erfolgreich getesteten DAGs als YAML und führen Sie in der kontinuierlichen Integration Beispiel- sowie Regressionstests aus.
Produktionsvalidierungsprozess
- Sammeln Sie Ereignisbeispiele, die normale, abweichende, wiederholte, unsortierte, verzögerte sowie zukünftige Schemata darstellen.
- Definieren Sie für jeden Verarbeitungsknoten Eingangs-, Ausgangs-, Fehler- und Leistungsakzeptanzbedingungen.
- Parallel laufen alte Pipelines und Fleak – vergleichen Sie die Anzahl der Einträge, Felder, Verzögerungen sowie die Ergebnisse am Zielort.
- Simulierung von Kanalunterbrechungen, abgelaufenen Zugangsdaten, Zielratebeschränkungen, Netzwerkfluktuationen und einer großen Anzahl an Fehlern.
- Überprüfen Sie die Auditfunktionen, den Zugriffskontrollmechanismus, die Alarmfunktionen, die Wiederabspielung von „Dead Letters“ sowie die Möglichkeit zum Rollback, bevor Sie entscheiden, ob der Produktivverkehr umgeleitet werden soll.
Für welche Benutzer geeignet
- Datenteam: Schneller Zugang zu neuen Kanälen und Reduzierung der wiederholten Arbeit bei der Wartung von Schemata und Konvertierungsregeln.
- AI-Plattform-Team: Vor der Verwendung von RAG, Agenten und Modellen werden die Eingaben gereinigt, dupliziert und normalisiert.
- Sicherheitsbetriebsteam: Mappt heterogene Protokolle auf ein einheitliches Sicherheitsschema und filtert den Rausch, der in das SIEM gelangt.
- Team für Industrie und IoT: Vereinheitlichung von Sensoren und OT-Telemetrie, um wiederholte Messungen sowie Unterschiede bei den Etiketten zu reduzieren.
- FinTech-Team: Standardisierung von Transaktionsereignissen, um konsistente Daten für Systeme zur Prävention von Betrug, zur Risikobewertung und zur Konformitätskontrolle bereitzustellen.
- Java- und Python-Entwickler: Nutzen Sie ZephFlow unter Apache 2.0, um stateless Verarbeitung in Ihren eigenen Anwendungen durchzuführen.
Typische Anwendungsszenarien
- Normalisierung des Sicherheitslogs: Die Ereignisse verschiedener Hersteller werden in OCSF, UDM oder CSF umgewandelt und anschließend in das Überwachungssystem eingespeist.
- AI-Eingabeverwaltung: Entfernen von Duplikaten und weniger wertvollen Ereignissen, Vereinheitlichung der Felder, bevor sie an das Modell oder den Agenten übergeben werden.
- Lake-Storage-Aufnahme: Verarbeitung von Daten aus Kafka oder Splunk und Schreiben in Delta Lake oder Databricks.
- Echtzeit-Suchindex: Massenkonvertierung von Ereignissen und Schreiben in Elasticsearch zur Untersuchung und Suche.
- Industrielle Fernmessreinigung: Standardisierung von Geräteetiketten, Einheiten und Schemata, Filterung von störenden Messwerten.
- Vorbereitung von Betrugsdaten: Standardisierung von Transaktionen über mehrere Kanäle, Ergänzung von Regeln sowie Beibehaltung einer vollständigen Prüfprotokollierung.
- Eingebettete Datenverarbeitung: ZephFlow als Java-Bibliothek in bestehende Dienste einbinden, ohne eine Hosting-Plattform zu verwenden.
Vorteile des Produkts
- Verbinden, analysieren, konvertieren, verwalten und liefern in einem Echtzeit-Pipeline-Prozess – um Zwischensysteme zu reduzieren.
- Die Konfiguration zur Erzeugung natürlicher Sprache senkt die Einstiegshürden, während die DAG-Node für Ingenieure zur Überprüfung erhalten bleiben.
- Die Erkennung von Schema-Drift und die Generierung von Konfigurationen können die Zeit zur Behebung von Änderungen im Oberflächenbereich verkürzen.
- Kluster-Hosting bewältigt Parallelität, Konkurrenz und Skalierbarkeit und eignet sich für Teams, die keine eigene Infrastruktur für den Datenflussverarbeitung nicht verwalten möchten.
- Die wertbasierte Routing-Logik filtert die Daten, bevor sie in den Speicher und das Modell gelangen, wodurch der Speicherverbrauch sowie der Verbrauch von Tokens kontrolliert werden kann.
- Der ZephFlow-Java-Kern sowie das Python-SDK nutzen Apache 2.0, was eine lokale Überprüfung sowie weitere Entwicklung erleichtert.
- Behauptungen, Fehlerverfolgung und die S3-Dead-Letter-Queue bieten einen klaren Isolierungsweg für fehlerhafte Daten.
Einsatzbeschränkungen und Hinweise
- Auf der offiziellen Website werden keine festen Pakete, kostenlose Datenvolumina oder konkrete Preise angegeben. Für Einkäufe ist eine Terminvereinbarung für eine Demonstration sowie ein Angebot vom Unternehmen erforderlich.
- Die Verbindung beliebiger Kanäle gehört zu einer umfassenden Produktbeschreibung; offizielle Workflow-Dokumente nennen nur einige Kanäle und Ausgabepunkte ausdrücklich.
- Selbstheilung kann nicht völlig unüberwacht erfolgen; Fehler bei der Schema-Kartierung können Probleme schnell auf alle nachgelagerten Komponenten übertragen.
- Die Angaben zu Leistung und Kosteneinsparungen auf der offiziellen Website sind Herstellerangaben, die durch eigene Messwerte bezüglich Anfragen, Durchsatz und nachgelagerter Kosten überprüft werden müssen.
- Keine Speicherung bedeutet nicht, dass auch keine Datenverarbeitung oder keine Protokollierung stattfindet. Die Regeln für die Aufbewahrung von Daten zur Überwachung, Fehlerbehebung und Unterstützung müssen durch einen Vertrag festgelegt werden.
- Die Hosting-Plattform ist nicht dasselbe wie das Open-Source-ZephFlow – der Open-Source-Engine fehlen eine kommerzielle Konsole, AI-Orchestrierung sowie Hosting-Dienste.
- Das Python SDK benötigt den Java 17-Engine; sowohl bei der Bereitstellung, in Containern als auch in lokalen Umgebungen müssen beide Laufzeitanforderungen erfüllt werden.
- Die S3-Dead-Letter-Queue funktioniert nur in Prozessen, die durch Datenkanäle gesteuert werden. Die Aufrufe des Speicherprozesses bewältigen Fehler schrittweise, indem sie die Ergebnisse zurückgeben.
- Detaillierte Berechtigungen für Daten sowie Auditing-Funktionen müssen richtig konfiguriert werden; eine fehlerhafte Autorisierung kann dazu führen, dass sensible Datensätze an ungeeignete Empfänger gelangen.
- Die Seiten zu Datenschutz, Allgemeinen Bedingungen und EULA sind zugänglich, doch die Auswertung der dortigen Informationen ist eingeschränkt. Unternehmen sollten vor Abschluss eines Vertrags den vollständigen Text anfordern.
Preise und Beschaffungsmethoden
Stand zum 22. August 2026 zeigte die offizielle Website von Fleak keine überprüfbaren öffentlichen Preislisten, kostenlose Angebote, Probephasen oder Preise pro Nutzungseinheit. Die einzige Möglichkeit war es, einen 30-minütigen Demo-Termin zu buchen. Keine historischen Preise Dritter dürfen als Grundlage für aktuelle Kaufentscheidungen herangezogen werden.
| Produkt oder Kostenposten | Offener Preis | Mögliche Messmethoden | Prüfen vor dem Kauf |
|---|---|---|---|
| Fleak-Hosting-Plattform | Individuelle Kostenschätzung | Leitungen, Durchsatz, Berechnungen oder Unternehmensverträge | Mindestverpflichtungen, Umweltkennzahlen, Support- und Service-Level |
| Kanäle und Verbindungen | Nicht veröffentlicht | Anschlüsse oder Datenmenge | Standard-Anschlüsse und Kosten für maßgeschneiderte Anbindungen |
| Fließende Berechnung | Nicht veröffentlicht | CPU, Anzahl der Ereignisse oder Laufzeit | Peakwerte, Skalierung und Übergebühren |
| Speicherung und Daten für ungelesene Nachrichten | Nicht veröffentlicht | Menge und Haltbarkeitsdauer | Kosten für Objektspeicherung, Protokollierung und Wiedergabe |
| Unternehmensführung | Nicht veröffentlicht | Benutzer, Rollen, Auditing und Umgebung | Einmaliges Anmelden, Ausführung von Audits sowie Speicherung der Daten |
| ZephFlow-Open-Source-Engine | Quellcode kostenlos | Kosten für eigene Infrastruktur | Betrieb, Support, Cloud-Ressourcen und nachgelagerte Dienste |
Offizielle öffentliche Informationen erwähnten eine Tagesabrechnung nach Pipe-Canvas oder Stream-CPU, doch die Website gibt keine aktuellen Zahlen oder vollständigen Regeln an. Bei Abschluss des Vertrags gelten die offiziellen Angebote, Bestellungen und Abrechnungsbedingungen.
Unterstützung für Plattformen und Deployment
| Plattform oder Methode | Support-Status | Verwendung | Anforderungen |
|---|---|---|---|
| Webseite DAG Builder | Unterstützung | Entwurf, Bereitstellung und Überwachung von gehosteten Workflows | Unternehmenskonto |
| Verwaltete Rechenclustern | Unterstützung | Distributed asynchrone Streamverarbeitung | Ressourcen nach Vertrag verteilen |
| Java SDK | Unterstützung | ZephFlow als eingebettete Anwendung oder eigenständig ausführen | Java 17 |
| Python SDK | Unterstützung | ZephFlow mit Python erstellen und ausführen | Python 3.8 und neuer sowie Java 17 und neuer |
| Unabhängige Prozesse | Unterstützung | Ausführung von stateless-Pipelines in der eigenen Umgebung | Selbstüberwachung und -betrieb |
| Netzdienste | Unterstützung | Ausführung des Verarbeitungsprozesses über die Service-Schnittstelle | Selbstschutz von Endpunkten und Kapazitäten |
| Container oder Cloud-Umgebung | Einsetzbar | Ausführung von Open-Source-Engines und Abhängigkeiten | Benutzerwartung von Images, Schlüsseln und Updates |
APIs, SDKs und Open Source
ZephFlow Core ist ein stateless-Datenverarbeitungsframework für Java 17, das als Bibliothek, als eigenständiger Prozess oder als Netzwerkdienst laufen kann. Die aktuelle Version lautet laut der README 0.4.1. Es unterstützt die Kombination von Knoten, Assertions, Fehlerbehandlung sowie eine flexible Deployment-Möglichkeit.
Das ZephFlow Python SDK kann über das Python-Paketarchiv installiert werden. Es unterstützt eine Stream-API, JSONPath-Filterung, Eval-Umwandlungen, Flow-Kombinationen, Assertions sowie S3-Dead-Letter-Queues. Sowohl die Java-Basis als auch das Python SDK sind unter der Apache 2.0-Lizenz verfügbar.
| Projekt | Sprache oder Schnittstelle | Lizenz | Beziehung zu Geschäftsplattformen |
|---|---|---|---|
| ZephFlow Core | Java 17 | Apache 2.0 | Fleak verfügt über eine stateless Verarbeitungsfähigkeit auf der unteren Ebene und kann unabhängig laufen. |
| ZephFlow SDK-Modul | Java-Abhängigkeiten | Apache 2.0 | Durch Gradle oder Maven zugänglich |
| ZephFlow Python SDK | Python 3.8 und neuer sowie der Java-Engine | Apache 2.0 | Python-Verpackung und lokale Pipeline-API |
| ZephFlow Examples | Java-Beispiel | Apache 2.0 | Demonstration der Verwendung des Open-Source-Engines |
| Fleak-Hosting-Plattform | Web-DAG, KI und gehostete Clustern | Closed-Source-Business-Dienste | Nicht vollständig open source, nur weil der Kernmotor open source ist |
Privatsphäre, Sicherheit und Governance
Mögliche Objekte für die Verarbeitung durch Fleak sind Sicherheitsprotokolle, Transaktionen, industrielle Telemetriedaten sowie AI-Eingaben, die Informationen zu Konten, Geräten, Netzwerken, Mitarbeitern oder Kunden enthalten. Unternehmen müssen klären, ob Daten gespeichert werden, wie lange Metadaten aufbewahrt werden, welche Zugriffsrechte vorhanden sind, welche Unterauftragnehmer beteiligt sind, in welchen Regionen die Daten verarbeitet werden und wie der Löschvorgang abläuft.
Die offizielle Website gibt an, dass es sich um SOC 2 Type II handelt, sowie um eine fein abgestufte Zugriffssteuerung, vollständige Konvertierungsprotokolle und Audit-Spuren. Doch die Übersichtsseite kann nicht anstelle eines Auditberichts dienen. Der Käufer sollte den Berichtszeitraum, den Umfang des Produkts, die Ausnahmen bei der Kontrollumsetzung sowie die Verantwortlichkeiten bei Open-Source- und gehosteten Implementierungen überprüfen.
- Verbinden Sie die Kanäle und Ziele mit Konten mit minimalem Berechtigungsgrad und verwalten Sie getrennt die Lese-, Schreib- und Verwaltungsrechte.
- Verwenden Sie in der Testumgebung gedämpfte Beispiele und übergeben Sie die Produktions-Sicherheitsprotokolle nicht direkt an unüberprüfte AI-Konfigurationen.
- Für jeden Zweig werden Datenkategorisierungen und zulässige Ziele festgelegt, um zu verhindern, dass sensible Felder in unzutreffende Systeme gelangen.
- Protokollieren Sie die Erstellung der Konfiguration, die manuelle Freigabe, den Einsatz, das Rollback sowie Änderungen an Berechtigungen, um eine nachvollziehbare Audit-Trail zu schaffen.
- Überprüfen Sie, ob die Überwachungsprotokolle, die Warteschlangen für ungelesene Nachrichten sowie die Support-Pakete die vollständigen ursprünglichen Ereignisse enthalten.
- Für Daten von ungeöffneten E-Mails sollten Verschlüsselung, Zugriffskontrollen, Haltbarkeitsfristen sowie Verfahren zur Löschung nach Wiedergabe festgelegt werden.
- Regelmäßig die Anmeldeinformationen für Kafka, Splunk, Cloud-Speicher und Datenbanken rotieren und abweichende Lesevorgänge überwachen.
- Die Verpflichtungen bezüglich des Null-Speicherns, der Verweildauer der Daten sowie deren Löschung sollen in den Vertrag und die Datenverarbeitungsvereinbarung aufgenommen werden.
Grundlegende Informationen
| Projekt | Inhalt |
|---|---|
| Name des Tools | Fleak |
| Entwicklungsunternehmen | Fleak Tech Inc. |
| Arten von Werkzeugen | KI-eigene Datenschicht, Echtzeit-Datenpipelines und Streamverarbeitung |
| Kernoberfläche | DAG Workflow Builder |
| Open-Source-Motor | ZephFlow |
| Hauptnutzer | Datenengineering, KI-Plattformen, Sicherheit, Industrie-Internet der Dinge und Finanzteams |
| Preismuster | Individuelle Kostenvoranschläge für Unternehmen; Quellcode von ZephFlow kostenlos |
| Ist eine Registrierung erforderlich? | Die Hosting-Plattform erfordert ein Unternehmenskonto. |
| Chinesische Unterstützung | Es wurde keine klare chinesische Benutzeroberfläche gefunden. |
| Verwaltete Bereitstellung | Unterstützung |
| Java SDK | Verfügbar, Java 17 |
| Python SDK | Verfügbar ab Python 3.8 und erfordert Java 17 |
| Ist das Produkt open source? | Die Hosting-Plattform ist nicht open source; die ZephFlow-Komponenten sind open source. |
| Open-Source-Lizenz | Apache 2.0 |
| Datum der Preisüberprüfung | 22. August 2026 |
Empfehlungswert
Empfehlungswert: 4,0 / 5. Fleak vereint Echtzeit-Analyse, Doppelteintrag-Entfernung, Standardisierung, Governance, Behandlung von Schema-Drifts sowie Lieferung an mehrere Ziele – was einen klaren Wert für Sicherheitsprotokolle, industrielle Telemetriedaten sowie AI-Eingabepipelines darstellt.
Die Hauptmängel sind die Unklarheit der Verkaufspreise, Unterschiede zwischen dem offiziellen Verzeichnis der Anschlüsse und den Angaben auf der Website sowie die Notwendigkeit, dass der Verkäufer Informationen zu Datenschutzfragen und Vertragsbedingungen bereitstellt. ZephFlow macht die technische Überprüfung einfacher, doch für eine Unternehmensplattform ist weiterhin eine vollständige POC erforderlich.
Häufige Fragen
Was macht Fleak?
Es befindet sich zwischen der Datenquelle und AI-, Data-Lake-, SIEM- oder Suchsystemen und analysiert, bereinigt, entfernt Doppelungen, standardisiert, ordnet und leitet Ereignisse in Echtzeit um.
Ist Fleak kostenlos?
Die Hosting-Plattform bietet keine kostenlosen Pakete oder Testversionen an. Es ist notwendig, einen Termin für eine Demonstration zu vereinbaren, um ein maßgeschneidertes Angebot zu erhalten. ZephFlow Core sowie das Python SDK können unter der Apache 2.0-Lizenz kostenlos genutzt werden.
Wie viel kostet Fleak?
Die offizielle Website gibt keine festen Zahlen an. Offene Informationen deuten darauf hin, dass die Abrechnung von der täglichen Nutzung des Pipeline-Canvas oder des Stream-CPU abhängen kann. Allerdings müssen die genauen Preise, die Mindestvertragslaufzeiten sowie die Regeln für Überschreitungen in der Angebotsunterlage festgelegt werden.
Kann Fleak wirklich Rohrleitungen automatisch reparieren?
Die Plattform kann automatisch Änderungen am Schema erkennen und neue Konfigurationen erstellen, doch auf der offiziellen Website wird auch erklärt, dass die Benutzer diese Änderungen genehmigen und erneut implementieren müssen. Wichtige Abläufe sollten keine Tests, Genehmigungsverfahren oder Rollbacks überspringen.
Welche Kanäle werden unterstützt?
Die offiziellen Workflow-Dokumente nennen ausdrücklich Kafka und Splunk. Auf der Website werden zudem eine Vielzahl von Anbindungen wie Sicherheit, Industrie, Schnittstellen und Datenbanken aufgeführt. Anbindungen, die in den Dokumenten nicht aufgeführt sind, müssen durch Demonstrationen und Tests überprüft werden.
Welche Ausgaben werden unterstützt?
Der Dokumentation sind ausdrücklich Ausgaben wie Kafka, Delta Lake, Databricks und Elasticsearch enthalten. Konkrete Versionen, Authentifizierung, Batch-Verarbeitung, Wiederholungsversuche sowie Transaktionssemantik müssen am Ziel-Connector überprüft werden.
Kann man Sicherheitsprotokolle verarbeiten?
Ja, die Plattform zielt darauf ab, verschiedene Sicherheitsprotokolle in OCSF, UDM oder CSF zu standardisieren und sie vor dem Eingang in SIEM- oder KI-Detektionswerkzeuge zu filtern und zu duplizieren.
Speichert Fleak die ursprünglichen Daten?
Die offizielle Website unterstützt eine Echtzeit-Übertragung ohne Speicherung, doch das bedeutet nicht, dass keine Überwachungs-, Prüfungs-, Fehler- und Support-Daten gespeichert werden. Unternehmen müssen durch Verträge festlegen, welche Arten von Daten gespeichert und gelöscht werden sollen.
Was ist ZephFlow?
ZephFlow ist der öffentlich verfügbare, stateless Datenverarbeitungsmotor von Fleak, der in Java-Anwendungen eingebettet werden kann, eigenständig laufen kann oder als Service bereitgestellt werden kann. Er unterstützt Filtern, Umwandlungen, Assertions sowie Fehlerbehandlung.
Gibt es ein Python SDK?
Ja, das Python SDK unterstützt fließende Kombinationen, JSONPath-Filterung, Eval-Umwandlung, Zusammenführung, Aussagen sowie S3-Dead-Letter-Queues. Zum Laufen wird außerdem Java 17 benötigt.
Ist Fleak Open Source?
Man kann es nicht pauschal als Open Source bezeichnen. Der Kern von ZephFlow in Java, das Python SDK sowie einige Beispiele verwenden Apache 2.0, doch die Hostplattformen, die AI-Orchestrierungstools sowie die Konsole sind kommerzielle, geschlossene Services.
Was umfasst SOC 2 Typ II?
Die offizielle Website gibt an, dass es sich um SOC 2 Type II handelt, doch auf der Startseite werden weder der Umfang noch der Zeitraum des Berichts angegeben. Das Unternehmen sollte einen aktuellen Bericht anfordern und überprüfen, ob dieser die Hosting-Plattformen, die damit verbundenen Infrastrukturen sowie die erforderlichen Datenströme umfasst.
Eignet es sich als Ersatz für bestehende Stream-Processing-Plattformen?
Es ist möglich, aber man sollte sich nicht nur auf die Funktionsliste konzentrieren. Man sollte die tatsächlichen Daten parallel abspielen und den Semantikgehalt, die Durchsatzrate, die Verzögerungen, die Fehlerrückgewinnung, die Anschlüsse sowie die Gesamtkosten vergleichen, bevor man über das Ausmaß der Migration entscheidet.
Wie vermeidet man fehlerhafte Zuordnungen von Feldern durch KI?
Legen Sie Aussagen und Ziel-Schemata für Schlüsselfelder fest, wiedergeben Sie die AI-Konfiguration mit historischen und abweichenden Beispielen und behalten Sie manuelle Freigabe, Abweichungsprüfung sowie einen One-Click-Rollback bei.
Zusammenfassung
Fleak befasst sich mit den Problemen bezüglich der Datenqualität und -verwaltung in AI-Systemen. Durch Echtzeit-DAGs, AI-Konfigurationen, die Behandlung von Schema-Veränderungen sowie eine effektive Werteverteilung wird sichergestellt, dass die in Modelle, Data Lakes oder Sicherheitstools eintretenden Daten konsistenter sind.
Bevor es zu einer offiziellen Einführung kommt, sollten Verbindungen, Verzögerungen, Fehler und Kosten über zuverlässige Kanäle überprüft werden. Zudem müssen Aspekte wie keine Datenspeicherung, Datenverweildauer, Audits, Servicelevel sowie Löschfunktionen im Vertrag festgelegt werden. Teams, die nur eine lokale, zustandslose Verarbeitung benötigen, können mit Apache 2.0s ZephFlow beginnen.
Tools, die den Fleak ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164