




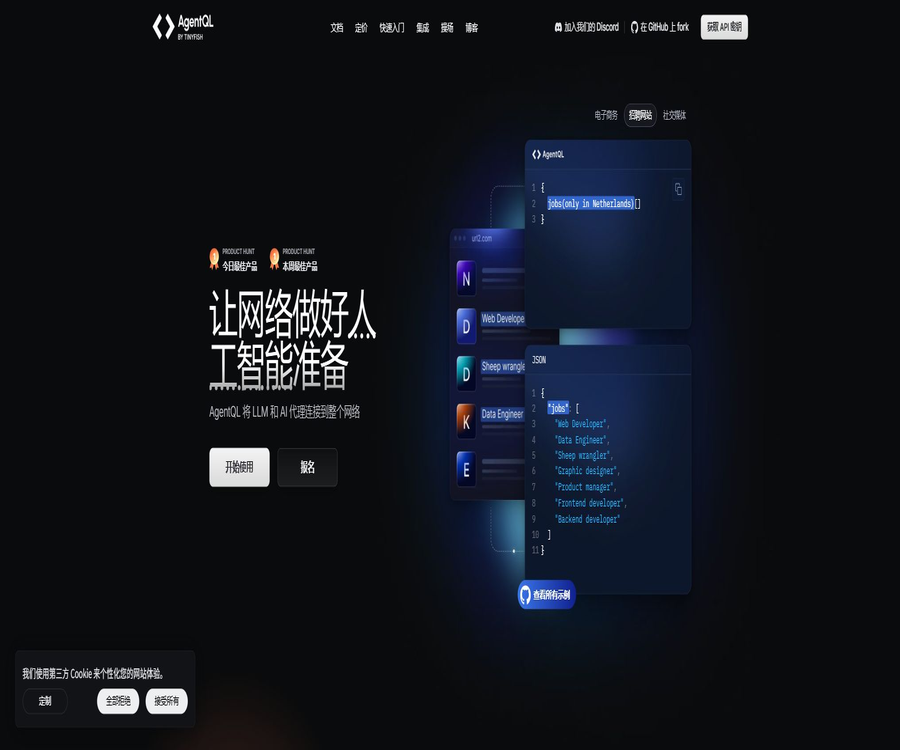
AgentQL
AgentQL – ein intelligentes Tool, das sich auf die Entwicklung mit KI konzentriert.
Tags:KI-Design-ToolsWas ist AgentQL?
AgentQL ist ein von TinyFish entwickeltes Set aus AI-basierten Tools für die Abfrage von Webseiten. Mit dieser Sprache können die gewünschten Daten oder Seitenelemente in natürlicher Sprache beschrieben werden. Sie eignet sich zur Extraktion von Daten von Webseiten, zur Automatisierung von Browsern, zur Durchführung von Tests sowie zur Erstellung von AI-Agenten, die Webseiten nutzen können.
Im Gegensatz zu Skripten, die auf feste CSS- oder XPath-Selektoren angewiesen sind, bestimmt AgentQL die Position der Elemente anhand ihrer Bedeutung, des Kontexts sowie der Struktur der Abfrage. Wenn sich die Seitenstruktur ändert, sind semantische Abfragen in der Regel leichter wiederverwendbar als Positionsselector – dennoch ist zur Gewährleistung der Zuverlässigkeit in der Praxis eine Testung sowie eine angemessene Fehlerbehandlung notwendig.
Kernfunktionen
- Verwendung von natürlichen Sprachnamen für Felder zur Lokalisierung von Webseitenelementen und Daten
- Geben Sie gemäß der Abfragesyntax eingebettete Objekte oder Listen zurück.
- Automatisierte Bedienung von Webseiten mit Playwright in Python und JavaScript
- Datenabfragen über eine REST-API aus jeder Programmiersprache ausführen
- Verwendung eines Remote-Browsers zur Ausführung von Aufgaben, die eine Sitzung und Interaktion erfordern
- Strukturierte Inhalte aus Webseiten, PDFs und Bildern extrahieren
- Verwendung der Debugger-Erweiterung zur Fehlersuche in echten Webseiten
- Anweisungen für Tests im Playground auswählen und Skripte exportieren
- Verbindung der Automatisierungsumgebungen wie LangChain, Zapier und MCP
AgentQL-Abfragesprache
AgentQL-Abfragen definieren anhand der Feldstruktur, wonach gesucht werden soll und wie die Ergebnisse aussehen sollen. Die Namen der Felder können bereits eine semantische Bedeutung haben. Listen, verschachtelte Objekte und zusätzliche Anmerkungen können miteinander kombiniert werden, um die Struktur der Ausgabe bereits vor der Ausführung klar zu definieren.
| Abfragemöglichkeiten | Wirkung | Beispielhafte Verwendungszwecke |
|---|---|---|
| Semantische Felder | Elemente anhand von Namen und Kontext identifizieren | Suchfeld, Preis oder „Nächste Seite“-Button positionieren |
| Liste | Mehrere ähnliche Einträge zurückgeben | Auswahl einer Liste von Produkten, Artikeln oder Bewertungen |
| Neststruktur | Darstellung der Beziehungen zwischen den internen Feldern des Projekts | Jedes Produkt enthält einen Namen, einen Preis und eine Bewertung. |
| Erläuterungen in natürlicher Sprache | Ergänzende Positionen, Bedeutungen oder Filterbedingungen | Titel oder bestimmte Karten im Haupttext begrenzen |
| Datenkonvertierung | Die Extraktionsergebnisse nach Zieltyp sortieren | Die Preise in Zahlen umwandeln |
| Prompt-Abfrage | Datenstruktur aus einer vollständigen Beschreibung ableiten | Schnelle Erkundung von noch nicht modellierten Seiten |
Die Funktionsweise der semantischen Lokalisierung
- Verständnis der geschäftlichen Bedeutung der Feldnamen auf der aktuellen Seite
- Bewertung des Ziels anhand des umliegenden Textes, der Tags und der Seitenhierarchie
- Es wird nicht erwartet, dass Entwickler im Voraus den genauen DOM-Pfad kennen.
- Ähnliche Websites können versuchen, die gleiche Abfragesyntax zu wiederverwenden.
- Auch nach der Neuanordnung der Seiten können Elemente mit derselben Semantik gefunden werden.
- Bei großer Mehrdeutigkeit können präzisere Erklärungen in natürlicher Sprache hinzugefügt werden.
Webdatenextraktion
Entwickler können mithilfe von SDKs oder REST-APIs strukturierte Daten aus öffentlichen sowie autorisierten Webseiten extrahieren. Die Struktur der Ausgabe wird durch die Abfrage definiert, was die anschließende Aufbereitung erleichtert. Leere Werte, Duplikate sowie der Status der Seiten müssen jedoch weiterhin im Geschäftskodum behandelt werden.
- Erfassung von Produktnamen, Preisen, Beständen und Bewertungen
- Überschriften, Datumsangaben, Autoren und Textinhalt zusammenfassen
- Extraktion von Suchergebnissen, Verzeichnissen und paginierten Listen
- Genehmigte Erfassung von Backend-Daten nach Anmeldung
- Dynamische Laden und Verarbeitung von Seiten mit unbegrenztem Scrollen
- Einheitliche Feldausgabe über ähnliche Standorte
Browser-Automatisierung
Die Python- und JavaScript-SDKs von AgentQL basieren auf dem Playwright-Workflow und liefern Elemente der Seite, die geklickt, ausgefüllt oder gelesen werden können. Entwickler können weiterhin die Wartefunktionen, den Browserkontext, die Netzwerkfunktionen sowie die Assertionsfunktionen von Playwright nutzen.
- Öffnen Sie die Webseite und finden Sie die Eingabefelder, Schaltflächen sowie Menüs.
- Formulare ausfüllen, Optionen auswählen und Aufgaben einreichen
- Anzeigen von Cookie-Hinweisen oder Pop-ups deaktivieren
- Seiten umblättern, scrollen und auf das asynchrone Inhaltsauftauchen warten
- Ausgeführte autorisierte Aktionen im Anmeldeverlauf
- Die Extraktionsergebnisse in den anschließenden Datenworkflow schreiben
Python- und JavaScript-SDKs
| Methode | Hauptfähigkeiten | Für Nutzer geeignet |
|---|---|---|
| Python SDK | Playwright-Automatisierung, Elementabfrage und Datenauswertung | Datenengineering, Forschung und Python-Agent-Entwickler |
| JavaScript SDK | Playwright-Automatisierung, Elementabfrage und Datenauswertung | Frontend-, Node.js- und Testengineering-Teams |
| REST API | Direkter Abruf von Webseiten, Dokumenten und Remote-Browsern | Integration in andere Sprachen oder leichte Dienste |
| Debugger-Erweiterung | Abfragen in den Entwicklerwerkzeugen des Browsers testen | Debugging und Identifizierung von Abfragedualität |
| Playground | Testabfragen, Optimierungshinweise und Exportieren von Skripten | Prototyp-Validierung und Lernen |
| CLI | Umgebung initialisieren und Skriptvorlage erstellen | Schnelle Erstellung lokaler Projekte |
REST API und Dokumentenauswertung
Die REST-API kann mit einer API-Key authentifiziert werden und liefert strukturierte Daten. Sie ermöglicht es, Webseiten abzurufen sowie PDF- und Bilddateien zu verarbeiten. Die Abfragen von Dokumenten erfolgen Seite für Seite oder pro Bild – daher muss bei großen Dateien die Anzahl der Anfragen im Voraus geschätzt werden.
- Aufruf aus jeder Sprache, die Netzwerkanfragen unterstützt
- Verwenden Sie eine Abfrage, um die Struktur präzise anzugeben, oder beschreiben Sie das Ziel mit einem Prompt.
- Wählen Sie den schnellen oder Standard-Extraktionsmodus aus.
- Erstellen einer Remote-Browser-Sitzung zur Ausführung interaktiver Aufgaben
- Konfiguration von Browsereinstellungen und Proxy-Adresse
- Verfolgung von Abläufen und Fehlern über Anfrage-Identifikatoren
Fernsteuerungs-Browser
Das AgentQL-Paket beinhaltet eine bestimmte Anzahl an Stunden für die Nutzung des Remote-Browsers sowie eine begrenzte Anzahl an gleichzeitigen Sitzungen – diese können zur Ausführung von Workflows mit dynamischen Webseiten in der Cloud genutzt werden. Bei den Paketen Starter und Professional unterscheiden sich die angebotenen Zeiten, die Gebühren für die Übernutzung sowie die Obergrenzen für gleichzeitige Sitzungen erheblich.
- Seiten, die JavaScript benötigen, im Hosted-Umfeld ausführen
- Der Browser-Session, die für mehrstufige Interaktionen erforderlich ist
- Konfiguration unterstützter Proxy-Exporte nach Region
- Wählen Sie eine Browserkonfiguration, die entweder leicht ist oder eher auf Täuschung von Detektionsmechanismen ausgerichtet ist.
- Einstellen eines Inaktivitäts-Timers, um zu vermeiden, dass inaktive Sitzungen Ressourcen verbrauchen.
- Cookies, Anmeldungen und lokale Speicherung nach Aufgaben isolieren
Debugger und Playground
Die Debugger-Erweiterung fügt dem Entwicklerwerkzeug des Browsers ein AgentQL-Panel hinzu, mit dem Abfragen direkt auf der aktuellen Webseite getestet und passende Elemente hervorgehoben werden können. Der Playground eignet sich besser zum Erkunden von Abfragen, zur Optimierungstipps sowie zur Erstellung von Skripten, die weiterentwickelt werden können.
- Wechsel zwischen Elementabfrages- und Datenextraktionsmodus
- Anzeige des Seitenbereichs, in dem die Abfrage zutreffen wird
- Überprüfen, ob die Checkliste und die verschachtelte Struktur den Erwartungen entsprechen.
- Natürlicher Sprachkontext für mehrdeutige Felder hinzufügen
- Schnelle Überprüfung der Ziel-Website vor dem Eingeben des Codes
- Die überprüften Ergebnisse in das SDK oder die API übertragen
Anwendbare Szenarien
- Erstellung eines AI-Agenten, der auf Webseiten zugreifen und Aufgaben ausführen kann
- Erhebung von E-Commerce-, Nachrichten-, Katalog- oder öffentlichen Forschungsdaten
- Automatische Ausfüllung von Formularen in internen Systemen und Partnerportalen
- Überwachung von Änderungen in Feldern, Preisen, Status oder Inhalt der Seite
- Bessere, wartbare semantische Positionierung für Testskripte
- Extrahierung von festen Strukturinformationen aus PDFs und Bildern
- Datenerfassung von mehreren Websites mit unterschiedlicher Struktur, aber ähnlicher Semantik
- Webseiteninformationen in LangChain, Zapier oder interne Prozesse integrieren
Für welche Benutzer geeignet
- KI-Engineer, die Web-Agenten schnell entwickeln müssen
- Python- und Node.js-Entwickler zur Wartung der Playwright-Automatisierung
- Daten, die strukturierte Webdaten erfordern, sowie Forschungsteams
- Testingenieure, die die Wartungskosten der Selektoren senken möchten
- Das Backend-Team, das über die REST-API auf Daten der Webseiten zugreifen soll
- Unternehmenskunden, die einen privaten Cloud- oder lokalen Einsatz benötigen
AgentQL-Preis
AgentQL bietet eine kostenlose Testversion sowie die Versionen Starter, Professional und Enterprise an. Die offiziellen Preise werden monatlich angegeben; die API sowie der Remote-Browser werden zusätzlich nach Verbrauch abgerechnet.
| Plan | Monatsgebühr | API-Limit und Übernutzungsgebühren | Fernsteuerungs-Browser | Parallel-Sessions |
|---|---|---|---|---|
| Kostenloser Probemonat | 0 US-Dollar | 300 Mal auf einmal; 10 Mal pro Minute | 1 Stunde | 1 Stück |
| Starter | 0 US-Dollar | 50 Mal pro Monat; für jede weitere Nutzung 0,02 US-Dollar | Enthält 10 Stunden; Zusatz pro Stunde 0,12 US-Dollar | 5 Stück |
| Professional | 99 Dollar | 10.000 Mal pro Monat; für jede Übersteigung 0,015 US-Dollar | Enthält 500 Stunden; Zusatz pro Stunde 0,10 US-Dollar | 100 Stück |
| Enterprise | Individuelle Kostenschätzung | Nach den Anforderungen des Unternehmens festlegen | Spezialcloud oder lokale Implementierung | Gemäß den Vereinbarungen des Plans |
Für die kostenlose Testversion ist keine Kreditkarte erforderlich – sie eignet sich dazu, vor der endgültigen Auswahl Suchfunktionen sowie den Remote-Browser zu testen. Ob Steuern, Gebühren für Vermittler, professionelle Dienstleistungen oder Kosten für die Lieferung an Unternehmen zusätzlich anfallen, hängt von der Zahlelseite und der Bestellbestätigung ab.
Empfehlungen zur Auswahl des Pakets
| Nachfrage | Vorgeschlagene Lösung | Gründe |
|---|---|---|
| Kurzfristige Überprüfung | Kostenloser Probemonat | 300 Aufrufe und 1 Stunde Browser-Zeit zur Bewertung |
| Persönliches Prototyp oder Aufgaben mit niedriger Frequenz | Starter | Keine Monatsgebühr und Skalierbarkeit nach Bedarf |
| Stabiler Datenworkflow | Professional | Höhere Aufrufzahlen, längere Sitzungszeiten und mehr Konkurrenz |
| Großangelegte oder sensible Daten | Enterprise | Es stehen gehostete Daten, eine dedizierte Cloud oder eine lokale Implementierung zur Verfügung. |
Schneller Einstiegsleitfaden
- Registrieren Sie ein Entwicklerkonto und erstellen Sie einen API-Schlüssel.
- Installieren Sie die Debugger-Erweiterung und öffnen Sie die Entwicklerwerkzeuge auf der Ziel-Webseite.
- Zuerst wird ein bestimmtes Element mithilfe einfacher Felder gefunden.
- Definieren Sie die vollständige Ausgabe mit Listen und verschachtelten Strukturen.
- Überprüfen Sie im Debugger jeweils die Elemente und die Datenergebnisse.
- Installieren Sie das Python- oder JavaScript-SDK und initialisieren Sie das Projekt.
- Fügen Sie die überprüften Abfragen dem Playwright-Skript hinzu.
- Fügen Sie Wartezeiten, Wiederholungsversuche, Behandlung von leeren Werten und Fehlerseiten hinzu, bevor Sie es online stellen.
Leitfaden zur Datenauswertung
- Überprüfen Sie die Nutzungsberechtigungen für die Zieldaten sowie die Bedingungen der Website.
- Listen Sie die Felder, Typen und Hierarchieverhältnisse auf, die zurückgegeben werden müssen.
- Verwenden Sie eine Liste für wiederholte Elemente und erstellen Sie eine verschachtelte Struktur für die Unterfelder.
- Wählen Sie repräsentative Seiten aus, um normale und fehlende Felder zu testen.
- Umgang mit Seitenroutierung, unbegrenztem Scrollen und dynamischer Ladebereitschaft.
- Überprüfen Sie Doppelungen, leere Werte, Typen und Zeichencodierungen.
- Einstellen von Frequenzbeschränkungen, Caching und Wiederholungsversuchen bei Fehlern.
- Regelmäßige Stichprobenvergleiche mit der ursprünglichen Seite, um Qualitätsveränderungen festzustellen.
Leitfaden zur Produktivumsetzung
- Schätzen Sie die Anzahl der Webseiten, Dokumentenseiten sowie die Stunden mit dem Remote-Browser pro Monat.
- Wählen Sie das passende Paket entsprechend den Limits für Konkurrenz und Geschwindigkeit aus.
- Speichern Sie den API-Schlüssel in einem Schlüsselverwaltungssystem und beschränken Sie den Zugriff darauf.
- Isolieren des Browserkontexts für Anmelde-Sessions und verschiedene Kunden.
- Definieren Sie klare Zustände für Zeitüberschreitungen, Verifizierungscode, Sperrungen und Seitenänderungen.
- Protokollieren Sie die Anfragenidentifikation, das Ziel, die Dauer, das Ergebnis und die Ursache des Fehlers.
- Einstellen von Alarmen für die Anzahl der Aufrufe, die Dauer der Browsernutzung und die Kosten.
- Organisieren Sie eine manuelle Überprüfung von datenintensiven Daten sowie automatisierte Abläufe.
Vorschläge zur Abfragedesignung
- Verwenden Sie Feldnamen mit klarer und stabiler Geschäftsbedeutung.
- Fügen Sie Beschreibungen zu Ort und Aussehen nur bei Bedarf hinzu.
- Echte Datenbeziehungen mit verschachtelten Strukturen darstellen
- Explizite Verwendung einer Liste für mehrere Projekte
- Komplexe Seiten in überprüfbare, kleine Abfragen aufteilen
- Optionale Felder akzeptieren leere Werte und dokumentieren den Grund für das Fehlen.
- Erstellung von Regressionstests mit repräsentativen Seiten und Abweichungsseiten
Bewertung der Zuverlässigkeit und Qualität
| Indikatoren | Bewertungsinhalt | Empfohlene Methoden |
|---|---|---|
| Genauigkeit des Feldes | Stimmen die extrahierten Werte mit der Seite überein? | Manuelle Stichprobenentnahme nach Feldern |
| Vollständigkeitsgrad | Wurden Ziele und Felder übersehen? | Im Vergleich zur Gesamtanzahl der Seiten |
| Wiederholungsrate | Wird derselbe Eintrag mehrfach zurückgegeben? | Erstellung einer Geschäftsprimärschlüssel zur Entdupplikation |
| Erfolgsrate der Lokalisierung | Ob die Interaktionselemente zuverlässig getroffen werden | Regressionstests für verschiedene Layouts und Zustände |
| Erfolgsrate der Aufgabe | Ist die mehrstufige Automatisierung abgeschlossen? | Den Status schrittweise aufzeichnen |
| Einheitenkosten | Aufruf- und Browsernutzungskosten | Berechnet nach Erfolgsbilanz |
| Zeit zur Wiederherstellung der Seitenänderung | Auswirkungen der Site-Update | Überwachung fehlgeschlagen, Ersatzprozess beibehalten |
Sicherheit und Konformität
- Besuchen Sie nur öffentliche oder autorisierte Seiten und Konten.
- Befolgung der Website-Bedingungen, Besuchshäufigkeit und Einschränkungen bei der Datennutzung
- Exponieren Sie den API-Schlüssel nicht in Abfragen, Protokollen oder Code.
- Isolierung und Verschlüsselung von Cookies, Sessions und heruntergeladenen Dateien
- Vermeiden Sie die Erfassung von persönlichen oder sensiblen Informationen, die nichts mit dem Geschäft zu tun haben.
- Für hochwirksame Aktionen wie Einreichung, Kauf, Löschung usw. wird eine manuelle Bestätigung erforderlich.
- Einstellen von Geschwindigkeiten, Budgets und einer Liste der zulässigen Domainnamen für die Automatisierung
- Vorbereitung von Authentifizierungscode, Zugriffsblockierung und Prozess der manuellen Übernahme
Vorteile des Produkts
- Die Lokalisierung in natürlicher Sprache ist leichter zu verstehen und zu warten als feste DOM-Pfade.
- Die Abfrage definiert selbst eine strukturierte Ausgabe und reduziert den Nachverarbeitungskodex.
- Dasselbe Tool deckt gleichzeitig Datenextraktion und Webseiteninteraktion ab.
- Python und JavaScript SDK sind direkt mit Playwright verbunden.
- Die REST-API ermöglicht den Zugriff von anderen Sprachen und stateless Aufgaben.
- Bietet Debugger, Playground, CLI und umfangreiche Beispiele
- Es können verschiedene Quellen wie Webseiten, PDFs und Bilder abgerufen werden.
- Das Kern-SDK sowie die Beispiele sind unter GitHub unter der MIT-Lizenz verfügbar.
Einsatzbeschränkungen und Hinweise
- Die semantische Lokalisierung kann bei mehrdeutigen Seiten immer noch zu falschen Elementen führen.
- Anmelden auf der Website, Verifizierungscodes und Anti-Automatisierungsmechanismen können den Ablauf blockieren.
- Dynamische Seiten erfordern eine angemessene Wartezeit und dürfen sich nicht nur auf eine einzige Abfrage verlassen.
- Fehler im Seiteninhalt beeinflussen die Extraktionsergebnisse direkt.
- API-Aufrufe und der Remote-Browser verursachen jeweils Kosten durch die Nutzung.
- PDFs werden pro Seite berechnet; die Kosten für große Dateien steigen schnell an.
- Vor der Mehrfachverwendung von Abfragen über verschiedene Seiten muss die Semantik der Felder noch auf jeder Seite überprüft werden.
- Automatisierung sollte keine Sicherheitsmaßnahmen oder Zugriffsbeschränkungen der Website umgehen.
- Im Gegensatz zu Open-Source-SDKs können Cloud-Dienste keine vollständige Plattform sein, die allein durch selbst gehostete Repositorien betrieben werden kann.
GitHub und Open Source
Das offizielle GitHub-Repositorium von AgentQL stellt Integrationen für Python und JavaScript sowie Beispiele und Entwicklungsressourcen zur Verfügung – unter Verwendung der MIT-Lizenz. Die gehosteten APIs, der Remote-Browser, das Entwicklerportal sowie die Unternehmensdienste gehören weiterhin zur kommerziellen Plattform und sollten nicht als vollständig open source angesehen werden.
| Komponenten | Status | Erklärung |
|---|---|---|
| Offizieller AgentQL-Repository | MIT-OpenSource | Enthält SDK-Integration, Beispiele und relevante Tool-Code |
| Python SDK | Offizielle Entwicklungswerkzeuge | Extraktion und Automatisierung mit Playwright |
| JavaScript SDK | Offizielle Entwicklungswerkzeuge | Für Node.js- und Playwright-Abläufe |
| REST API | Business-Hosting-Schnittstelle | Abgerechnet nach Paket und Nutzungsmenge |
| Fernsteuerungs-Browser | Wirtschaftliche Hosting-Dienste | Abgerechnet nach Dauer und Überschreitung des Verbrauchs |
| Enterprise | Kommerzielle Lieferung | Es kann eine dedizierte Cloud oder eine lokale Implementierung bereitgestellt werden. |
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | AgentQL |
| Entwicklungsunternehmen | TinyFish |
| Arten von Werkzeugen | AI-Seitenabfragen, Datenauswertung und Browser-Automatisierung |
| Hauptsprache | Python, JavaScript und REST API |
| Grundlagen der Automatisierung | Playwright |
| Unterstützte Inhalte | Webseiten, PDFs und Bilder |
| Kostenloses Angebot | Es gibt eine kostenlose Testversion sowie einen Starter. |
| Unternehmensbereitstellung | Es kann eine dedizierte Cloud oder eine lokale Implementierung bereitgestellt werden. |
| Ob Open Source | Das Kern-SDK sowie die Beispiele werden unter der MIT-Lizenz bereitgestellt; die Hostplattform ist ein kommerzieller Service. |
Empfehlungswert
4,6 / 5. AgentQL eignet sich für Entwickler und Agententeams, die durch semantische Abfragen die Wartungskosten von Web-Selektoren senken möchten. Die Toolchain, die Integration mit Playwright sowie die Preise sind recht umfassend. Für den Einsatz in der Produktion müssen jedoch weiterhin Probleme wie Unklarheiten bei den Seiten, Zugriffsbeschränkungen, Qualitätskontrolle sowie Kosten nach Verbrauch berücksichtigt werden.
Häufige Fragen
Was macht AgentQL hauptsächlich?
Es nutzt natürliche Sprache, um Daten und Elemente auf Webseiten zu finden, und führt durch SDKs oder APIs eine strukturierte Extraktion sowie die Automatisierung des Browsers durch.
Was ist der Zusammenhang zwischen AgentQL und Playwright?
Das AgentQL SDK fügt der Playwright-Workflow semantische Abfragemöglichkeiten hinzu; die bestehenden Funktionen zur Steuerung des Browsers, zum Warten sowie zur Überprüfung von Annahmen bleiben weiterhin verfügbar.
Kann AgentQL kostenlos verwendet werden?
Ja. Die kostenlose Testversion bietet 300 Aufrufe, während Starter monatlich 50 kostenlose Aufrufe bereitstellt und eine Abrechnung nach Verbrauch ermöglicht.
Wie viel kostet Professional?
Der öffentliche Preis für Professional beträgt 99 US-Dollar pro Monat und beinhaltet 10.000 API-Aufrufe sowie 500 Stunden Nutzung des Remote-Browsers.
Kann AgentQL PDFs extrahieren?
Ja, die REST-API unterstützt PDFs und Bilder; bei PDFs werden die API-Aufrufe in der Regel nach Seiten gezählt.
Welche Sprachen werden von AgentQL unterstützt?
Offiziell werden Python- und JavaScript-SDKs bereitgestellt, andere Sprachen können über die REST-API angebunden werden.
Kann AgentQL die Anmeldeseite verarbeiten?
Die nach dem Anmelden angezeigte Seite kann in einer autorisierten Browser-Sitzung verarbeitet werden, doch die Anmeldeinformationen müssen geschützt werden und die Regeln der Website eingehalten werden.
Ist AgentQL open source?
Der offizielle Code-Repository verwendet die MIT-Lizenz, doch die gehosteten APIs, das Remote-Browser-Tool sowie die Unternehmensdienste bleiben kommerzielle Produkte.
Wird der semantische Selektor für immer stabil bleiben?
Nein. Es verringert den Wartungsaufwand durch Veränderungen in der Seitenstruktur, doch Unklarheiten, Inhaltseränderungen und Zugriffsstatus können weiterhin zu Fehlern führen.
Werkzeuge, die AgentQL ähneln

 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164