




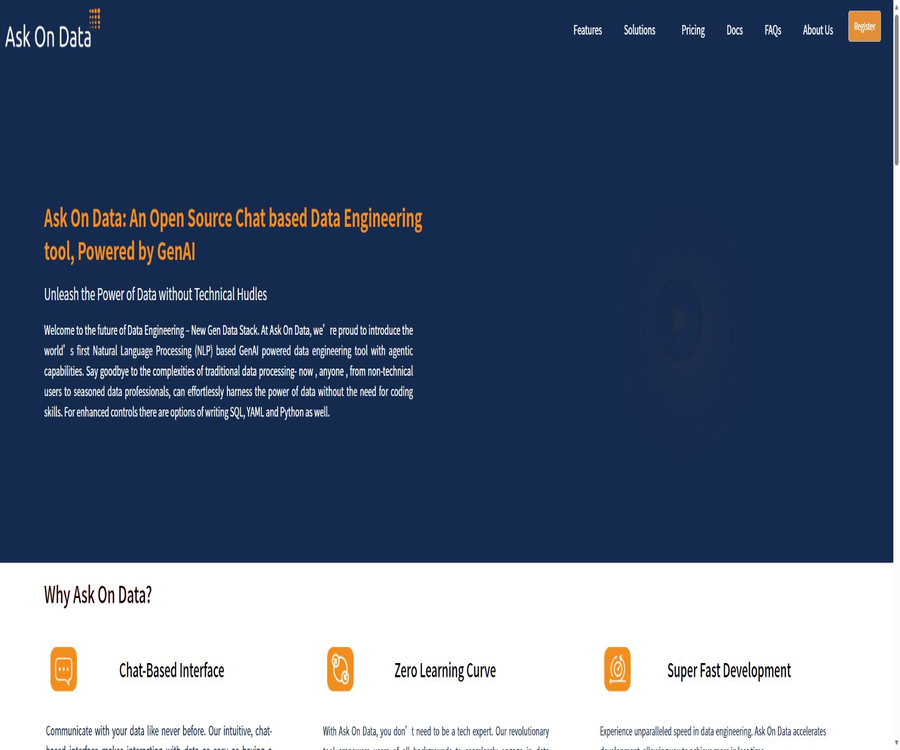
Ask On Data
Ask On Data – ein intelligentes Tool, das sich auf Entwicklungsframeworks für KI konzentriert.
Tags:AI-EntwicklungsframeworksWas ist Ask On Data?
Ask On Data ist ein tool für die generative AI-gestützte Datenverarbeitung, das über Chat-Interaktionen genutzt wird. Die Nutzer können in natürlicher Sprache Anforderungen bezüglich der Datenübertragung, -reinigung, -Vernetzung, -Umwandlung und -Scheduling beschreiben. Es richtet sich an Dateningenieure, Analysten, Data Scientists sowie Geschäftsnutzer, die ihre Programmieraufwände reduzieren möchten.
Die Positionierung dieses Produkts liegt eher bei einer von KI angetriebenen ETL- und Datenpipelines-Plattform – und nicht nur bei einem Datenbank-Frage-Antwort-Tool, das natürliche Sprache in Abfragesätze umwandelt. Gleichzeitig behält die Plattform professionelle Steuerungsmethoden wie SQL, Python und YAML bei, was es Technikern erleichtert, komplexe Logiken sowie Sonderfälle zu handhaben.
Hauptfunktionen
- Pipeline-Erstellung in natürlicher Sprache: Durch Beschreibung der Datenverarbeitungsanforderungen in englischen Dialogen erzeugt das System die entsprechenden Schritte für die Datenpipeline.
- Datenintegration: Unterstützt das Zusammenführen, Verbinden, Übertragen sowie den Datenfluss zwischen verschiedenen Quellen.
- Datenreinigung und -aufbereitung: Behandlung von fehlenden Werten, Formatierungen, Feldern und anderen Qualitätsproblemen der Daten.
- Datenumwandlung: Durchführung von benutzerdefinierten Berechnungen, Feldableitungen und Umwandlung von Geschäftsregeln.
- Echtzeit-Voransicht der Daten: Nach jedem Senden eines Konvertierungs-Befehls kann ein Muster der Ergebnisse angezeigt werden, um vor dem Ausführen der eigentlichen Aufgabe eine Überprüfung durchzuführen.
- Ablaufverlauf und Rückgängigmachen: Überprüfen Sie die historischen Aktionen im Workflow und rücken Sie Änderungen zurück, wenn Fehler festgestellt werden.
- Auftragsplanung und -scheduling: Einstellung von vollständiger Laden, schrittweiser Laden oder Neuladen nach Leeren sowie Ausführung in der angegebenen Frequenz.
- Code-Steuerung: Bei feiner Anpassung kann SQL, Python verwendet werden oder die YAML-Konfiguration bearbeitet werden.
- Customisierte Spark-Logik: Hinzufügen von Apache Spark-Code in die Task-Scheduling-Phase zur Bearbeitung spezieller Anforderungen.
Unterstützte Datensätze
Laut der offiziellen Website kann die Plattform Datenquellen wie Datenbanken, Data-Warehouses, Data-Lakes, Schnittstellen, Tabellendateien sowie Protokolle verarbeiten. Zudem ermöglicht sie es den Nutzern, Anfragen nach individuellen Datenquellen zu stellen. Der Umfang der tatsächlich verfügbaren Datenquellen variiert je nach Paket.
| Quelle der Daten | Inhalt, der bearbeitet werden kann | Vor der Verwendung muss es überprüft werden. |
|---|---|---|
| Excel und CSV | Lokale Tabellen, Datenexport und kleine Datensätze | Die kostenlose Cloud-Version unterstützt nur diese beiden Dateitypen und hat eine Kapazitätsbeschränkung. |
| Relationale Datenbanken | Datenbank für Geschäftsaktivitäten, Datenbank für Bestellungen und Analyse-Datenbank | Antrieb, Netzwerk, Berechtigungen sowie Les- und Schreibbereiche |
| Datenlager und Datenseen | Großangelegte historische Daten und Analysedaten | Verbindungen, Rechenressourcen und Strategien für Zieltabellen |
| API | Daten von Drittsystemen und Online-Diensten | Zertifizierung, Frequenzbeschränkungen und Feldänderungen |
| Protokolle und andere Dateien | Anwendungsprotokolle und Batch-Dateien | Formatanalyse, Kodierung und Behandlung von Fehlerdaten |
Wie funktionieren Datenpipelines
- Wählen Sie eine Datenquelle aus oder verbinden Sie sich damit und legen Sie Zugangsdaten sowie die minimal notwendigen Berechtigungen fest.
- Lassen Sie die Plattform Daten zur Vorschau laden, um zunächst zu überprüfen, ob Felder, Typen und Beispiele korrekt sind.
- Beschreiben Sie die Schritte der Verbindung, Reinigung, Berechnung oder Umwandlung in natürlicher Sprache.
- Überprüfen Sie schrittweise die Datenansicht und die Vorgangshistorie nach jeder Anweisung.
- Wenn nötig, prüfen und die erzeugten YAML-, SQL- oder Python-Logiken anpassen.
- Bestimmen Sie die Quelle der Zieldaten, die Schreibmethode sowie die Regeln für den Umgang mit Fehlern.
- Stellen Sie eine manuelle Auslösung oder einen Zeitplan ein und wählen Sie die Voll- oder Inkrementelpolitik aus.
- Führen Sie kleine Tests durch, überprüfen Sie die Ergebnisse und arbeiten Sie anschließend mit den offiziellen Daten.
Für welche Anwendungsszenarien geeignet
- Datenmigration: Übertragung von Daten aus Dateien, Datenbanken oder anderen Systemen auf die Zielplattform.
- Datenreinigung: Vereinheitlichung des Feldformats, Korrektur von Ausreißern und Erstellung eines analysierbaren Datensatzes.
- Datenintegration: Durch Verknüpfung oder Zusammenführung der Daten mehrerer Geschäftssysteme.
- Vorverarbeitung von Berichten: Vor dem Zugriff auf BI-Tools werden Umwandlungen, Aggregationen und Konsolidierungen durchgeführt.
- Vorbereitung des maschinellen Lernens: Erstellung von bereinigten und für die Merkmalsverarbeitung vorbereiteten Daten zur Modelltrainierung.
- Zeitgesteuerte Synchronisierung: Wiederholte Datenauffrischungsaufgaben werden stündlich, täglich oder zu anderen Intervallen ausgeführt.
- Rohrleitungsprototyp: Die Konversionsidee wird durch Chat schnell überprüft, anschließend optimieren die Ingenieure die Produktionskonfiguration.
Für welche Benutzer geeignet
- Dateningenieur: Schnelle Erstellung eines Rohentwurfs für Pipelines sowie präzise Steuerung durch Code und Konfiguration.
- Datenanalyst: Reduzierung der einfachen Vorbereitungsarbeiten für Daten, um mehr Zeit für Analyse und Überprüfung zu haben.
- Datenwissenschaftler: Organisieren Sie die Trainingsdaten selbst – es ist nicht notwendig, bei jeder Vorbereitung auf separate ingenieurtechnische Unterstützung zu warten.
- BI-Team: Prozesse für die Datenreinigung, -konsolidierung und regelmäßige Aktualisierung vor der Erstellung von Berichten.
- Vertriebsmitarbeiter: Unter Berücksichtigung der Berechtigungen und Überprüfungsmechanismen werden die Anfragen zur Verarbeitung von Grunddaten in natürlicher Sprache gestellt.
- Kleine und mittlere Unternehmen: Bewerten Sie den Prozess der chatbasierten Datenverarbeitung mit einer selbst gehosteten oder kostenlosen Cloud-Version.
Vorteile des Produkts
- Der dialogbasierte Eingang senkt die Hürden für die Ausdrucksweise bei gängigen Datenverarbeitungsaufgaben.
- Bei jedem Schritt können die Daten vorausgesehen werden, was dabei hilft, Fehler vor dem eigentlichen Betrieb aufzudecken.
- Beibehaltung der Steuerung über YAML, SQL, Python und Spark – ohne Beschränkung auf rein codefreie Operationen.
- Unterstützung für die Historie der Aktionen sowie für das Rückgängigmachen von Änderungen – damit man den Ablauf der Arbeitsabläufe nachverfolgen kann.
- Es ist möglich, die Umwandlungsschritte weiter zu organisieren und als wiederholte Aufgaben zu planen.
- Das Self-Hosting-Angebot ist auf der offiziellen Website als kostenlos angegeben und eignet sich für Tests durch technische Teams.
Nutzungsbeschränkungen
- Die aktuelle Chat-Oberfläche verwendet hauptsächlich englische Anweisungen; die Qualität der Verständnis- und Erstellungsleistung in Chinesisch muss selbst getestet werden.
- Generative KI kann die Bedeutung von Feldern oder Geschäftsregeln falsch interpretieren; eine Vorschau entspricht nicht einer vollständigen Datenvalidierung.
- Schreib-, Lösch- und Überschreibvorgänge in Datenbanken können zu tatsächlichen Verlusten führen; daher müssen Berechtigungen eingeschränkt und Backups erstellt werden.
- Die kostenlose Cloud-Version unterstützt nur Excel und CSV, wobei die maximale Größe einer Datei 5 MB beträgt.
- Die kostenlose Cloud-Version bietet keine Aufgabenerstellung und kann daher keine kontinuierlichen Produktionsprozesse übernehmen.
- Für die Unternehmensversion gibt es keinen offiziellen Festpreis; die Kosten werden in Abhängigkeit von der Datenmenge sowie dem Umfang der angebotenen Dienstleistungen festgelegt.
- Die offizielle Website behauptet, dass es sich um Open Source handelt, doch das offizielle GitHub-Repo war zum Zeitpunkt der Überprüfung leer und es war nicht möglich, den vollständigen Quellcode herunterzuladen, um es selbst zu deployen.
- Offene Dokumente reichen noch nicht aus, um alle Datenbankverbindungen, Systemanforderungen sowie die Details zur Betriebsführung in Produktivumgebungen zu bestätigen.
Vergleich von Versionen und Preisen
Auf der offiziellen Website von Ask On Data werden drei Optionen aufgeführt: Open-Source- und selbstverwaltete Lösungen, kostenlose Cloud-Lösungen sowie Unternehmenscloud-Lösungen. Die Unternehmensversion wird nach der Menge der Daten abgerechnet, wobei kein festes Entgelt angegeben wird.
| Version | Preis | Datenquelle | Scheduling | Verwaltung und Support |
|---|---|---|---|---|
| Open Source | Kostenlos | Die offizielle Website gibt an, alle Datenbanken als Quelle und Ziel zu unterstützen. | Unterstützung | Selbstverwaltung, Community-Unterstützung, manuelle Bereitstellung von Patches und Updates |
| Free | Kostenlos | Nur Excel und CSV, Dateigröße bis 5 MB | Nicht unterstützt | Offizielle Verwaltung, Community-Unterstützung, automatische Aktualisierungen, Backups und Überwachung |
| Enterprise | Anfragen zur Kostenermittlung senden | Die offizielle Website gibt an, alle Datenbanken als Quelle und Ziel zu unterstützen. | Unterstützung | Offizielle Verwaltung, Unternehmensunterstützung, automatische Aktualisierungen, Backups und Überwachung |
In den FAQ des offiziellen Webshops wird außerdem erklärt, dass die Self-Hosting-Lösung kostenlos genutzt werden kann. Die Kosten für die Unternehmensversion hängen von der Menge der Daten ab. Da das offizielle Code-Repository derzeit leer ist, muss man sich vor dem tatsächlichen Herunterladen und Bereitstellen der Lösung noch mit dem Team in Verbindung setzen.
Open Source und GitHub-Status
Auf der offiziellen Website wird Ask On Data an mehreren Stellen als Open-Source-Produkt bezeichnet, und die Open-Source-Version zum Selbsthosten wird als kostenlose Lösung dargestellt. Unter der offiziellen GitHub-Organisation wurde außerdem ein öffentlicher Repository mit demselben Namen eingerichtet.
Stand der Überprüfung ist das Repository leer – es enthält weder Quellcode noch Installationsanleitungen, Versionen oder Lizenzdokumente. Daher kann nicht allein auf Angaben auf der offiziellen Website geschlossen werden, dass derzeit eine auditable, einsetzbare Open-Source-Version verfügbar ist.
| Überprüfungspunkte | Aktueller Zustand | Fazit |
|---|---|---|
| Offizielle Produktbeschreibung | Produkt als Open Source bezeichnen | Zur offiziellen Positionierung des Herstellers |
| GitHub-Repository | Öffentlich, aber leer | Derzeit gibt es keinen verfügbaren Code. |
| Lizenz | Lager nicht verfügbar | Es ist nicht möglich, die genaue Open-Source-Lizenz zu bestimmen. |
| Installationsanleitung | Lager nicht verfügbar | Es ist nicht möglich, die Selbstbereitstellung nach offiziellen Schritten durchzuführen. |
| Versionen und Veröffentlichungen | Keine öffentliche Veröffentlichung | Es ist nicht möglich, die stabile Version sowie die Versionshistorie zu überprüfen. |
Technische Architektur
Laut den offiziellen FAQ basiert die Backend-Plattform auf Python, während für das Frontend React verwendet wird. Die Datenverarbeitung erfolgt durch Apache Spark-Aufgaben, die dabei orchestriert werden. Zudem werden Technologien wie LangChain, Ollama und Airbyte erwähnt.
- Python: Bietet Logik für Backend-Dienste und Datenverarbeitung.
- React: Erstellung interaktiver Benutzeroberflächen für Webseiten.
- Apache Spark: Ausführung von Datenverarbeitungsaufgaben zur Erzeugung von Daten.
- LangChain: Verbindung zwischen großen Modellen und Anwendungsprozessen.
- Ollama: Bietet Funktionen zur Ausführung lokaler oder selbst verwalteter Modelle.
- Airbyte: Zur Datenverbindung und -integration in Ökosystemen.
Empfehlungen für eine sichere Verwendung
- Verwenden Sie zur Überprüfung der Quelldaten vorrangig Lesekonten, und für das Schreiben in die Zieldatenbank sollten separate Konten mit eingeschränkten Berechtigungen genutzt werden.
- Geben Sie weder Passwörter, Schlüssel, sensible persönliche Informationen noch unbefugte Produktionsdaten in das Chatfeld ein.
- Die erstellte Verknüpfungs-, Filter-, Aggregations- und Berechnungslogik wird manuell überprüft.
- Zuerst wird es an einer Testdatenbank und mit einer kleinen Stichprobe ausgeführt; nach Überprüfung der Ergebnisse wird das Datensatzvolumen erweitert.
- Erstellen Sie Strategien für Snapshots, Backups und wiederherstellbare Versionen für die Zieltabelle.
- Protokollieren Sie die Prompte, Konfigurationen, Modelle, Pipeline-Versionen und die Ergebnisse jeder Ausführung.
- Vor der offiziellen Beschaffung sollten die Speicherorte der Daten, die Verschlüsselung, die Prüfmechanismen, die Löschverfahren sowie die Vorschriften für Notfallreaktionen überprüft werden.
Anfänger-Tutorial
- Erstellen Sie zunächst kleine Excel- oder CSV-Testdateien ohne sensible Informationen.
- Registrieren Sie sich kostenlos für die Cloud-Version und laden Sie Dateien mit einer Größe von bis zu 5 MB hoch.
- Überprüfen Sie die von dem System erkannten Feldnamen, Datentypen und Beispieldaten.
- Führen Sie eine Filterung oder Datenreinigung mit einfachen englischen Anweisungen durch.
- Prüfen Sie die Echtzeit-Voransicht nach der Konvertierung und vergleichen Sie sie manuell mit den ursprünglichen Daten.
- Eine weitere Verbindungs-, Berechnungs- oder Formatwandlungsoperation hinzufügen.
- Überprüfen Sie die Historie der Aktionen und testen Sie, ob die Funktion zum Rückgängigmachen wie erwartet funktioniert.
- Exportieren oder speichern Sie die Ergebnisse und dokumentieren Sie die Genauigkeit, die Dauer sowie die Schritte, die einer manuellen Anpassung bedürfen.
Lehrbuch zur Unternehmensbewertung
- Wählen Sie einen Datensatzpipeline mit klaren Regeln, geringem Risiko und bereits vorhandenen Ergebnissen.
- Strukturieren Sie die Größe der Daten, deren Quellen, die Ziele, die Aktualisierungsfrequenz sowie die Compliance-Anforderungen.
- Bestätigen Sie mit dem Produktteam die Steckverbinder, die Bereitstellungspositionen, die Quelle der Modelle sowie ob Daten an Dritte übermittelt werden.
- Es werden eine Demonstration der Fehlerrückgewinnung, der Aufsicht über Aufgaben, der Berechtigungskontrolle sowie der Audit-Logs gefordert.
- Verwenden Sie gedämpfte Daten zur Überprüfung komplexer Verbindungen, inkrementeller Synchronisierung und Fehlerbehandlung.
- Vergleichen Sie die Entwicklungszeit, Betriebskosten, Genauigkeit und Wartungsaufwand der bestehenden Prozesse.
- Bestätigen Sie die Datenerfassung, den Support-Standard, die Fehlerbehebung sowie die Beendigungsmechanismen im Vertrag.
- Nach Erreichen der Akzeptanzkriterien werden die Produktionsdaten sowie die kritischen Zeitpläne übertragen.
Unterschiede zu Tools für Fragen und Antworten in natürlicher Sprache
| Vergleichsdimensionen | Ask On Data | Datenbank-Frage-und-Antwort-Tool |
|---|---|---|
| Kernziel | Erstellen, Konvertieren und Schedulieren von Datenpipelines | Mit natürlicher Sprache abfragen und Daten erklären |
| Hauptausgabe | Ausführbare Datenverarbeitungswerkflüsse | SQL, Antworten, Diagramme oder Analyseergebnisse |
| Sollten die Daten geändert werden? | Mobilisierbar, konvertierbar und in das Ziel schreibbar | In der Regel geht es vor allem um das Lesen und Analysieren. |
| Ausführungstechnik | Spark-Aufgaben und Pipeline-Orchestrierung | Datenbankabfragemotor |
| Hauptrisiken | Fehlerhafte Konvertierung, Überschreiben oder Migration von Daten | Fehlerhafte Abfragen oder Interpretationen der Ergebnisse |
Grundlegende Informationen
| Projekt | Inhalt |
|---|---|
| Produktname | Ask On Data |
| Produkttyp | Generative AI-Datenverarbeitung und ETL-Plattformen |
| Interaktionsweise | Natürliche Sprachkommunikation auf Englisch, SQL, Python und YAML |
| Hauptfähigkeiten | Datenintegration, -reinigung, -umwandlung, -Voransicht, -Orchestrierung und -Scheduling |
| Ausführungsrahmen | Apache Spark |
| Verwaltungsmodus | Kostenloser Cloud-Service, Unternehmenscloud sowie der von der offiziellen Website angebotene Self-Hosting-Ansatz |
| Preismuster | Kostenlose Anfrage an Unternehmen |
| Ob Open Source | Die offizielle Website gibt an, dass es sich um Open Source handelt, doch der offizielle Repository ist derzeit leer und es gibt keine Lizenz. |
| Für Nutzer geeignet | Dateningenieure, Analysten, Datenwissenschaftler, BI-Teams und Unternehmensdatenteams |
Empfehlungswert
Der Gesamtbewertungswert beträgt 3,2 von 5 möglichen Punkten. Ask On Data verbindet natürliche Sprache, Datenanzeige, Code-Steuerung sowie Spark-Pipelines miteinander – das Konzept des Produkts ist klar. Allerdings schränken leere Lager, unzureichende Dokumentation sowie unklare Preise der Firma die derzeitige Überprüfbarkeit ein.
Häufige Fragen
Wofür wird Ask On Data hauptsächlich verwendet?
Es wird verwendet, um über Chats Pipelines für Datenmigration, -reinigung, -Verknüpfung, -Umwandlung und -Scheduling zu erstellen.
Ist es ein Tool für Chat-Fragen und -Antworten in Datenbanken?
Nicht ganz – seine Hauptausgabe sind ausführbare Datenverarbeitungsworkflows, und nicht nur Abfragedaten.
Ist Ask On Data kostenlos?
Sowohl die selbst gehostete Version als auch die Basis-Cloud-Version, die auf der offiziellen Website aufgeführt sind, sind kostenlos. Für die Unternehmens-Cloud-Version ist ein Preisanfrage erforderlich.
Welche Einschränkungen gibt es bei der kostenlosen Cloud-Version?
Es unterstützt nur Excel und CSV, die maximale Größe einer Datei beträgt 5 MB, und es gibt keine Aufgabenplanung.
Kann man eine Datenbank verbinden?
Laut der offiziellen Website unterstützen die Open-Source-Version sowie die Enterprise-Version Datenbanken als Quelle und Ziel; die konkreten Connector müssen vor der Verwendung überprüft werden.
Kann man die von KI erzeugte Verarbeitungslogik einsehen?
Es ist möglich, YAML-Dateien anzusehen und zu bearbeiten. Zudem kann die Steuerung mithilfe von SQL, Python sowie Spark-Code in der Planungsphase verbessert werden.
Ist Ask On Data wirklich open source?
Die offizielle Website behauptet, dass es sich um Open Source handelt, doch im offiziellen Repository befinden sich derzeit weder Code noch Lizenzen, weshalb eine unabhängige Prüfung sowie eine Einrichtung der Anwendung vorerst nicht möglich sind.
Wird die Daten sofort geändert?
Beim Aufbau der Pipelines wird zunächst eine Vorschau geladen; die tatsächlichen Daten werden erst verarbeitet, nachdem die Aufgabe manuell ausgelöst oder nach dem Plan ausgeführt wurde.
Eignet es sich für die direkte Verarbeitung von Produktionsdatenbanken?
Es wird nicht empfohlen, es ohne Testung direkt zu verwenden. Stattdessen sollten zunächst Konten mit eingeschränkten Rechten, Testdaten, manuelle Überprüfungen sowie zuverlässige Backups genutzt werden.
Tools, die dem Ask On Data ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164