




LLaMA Factory
Offenes, einheitliches Framework für die Feinabstimmung, Bewertung und Inferenz großer Modelle
Tags:AI-EntwicklungsframeworksWas ist LLaMA Factory?
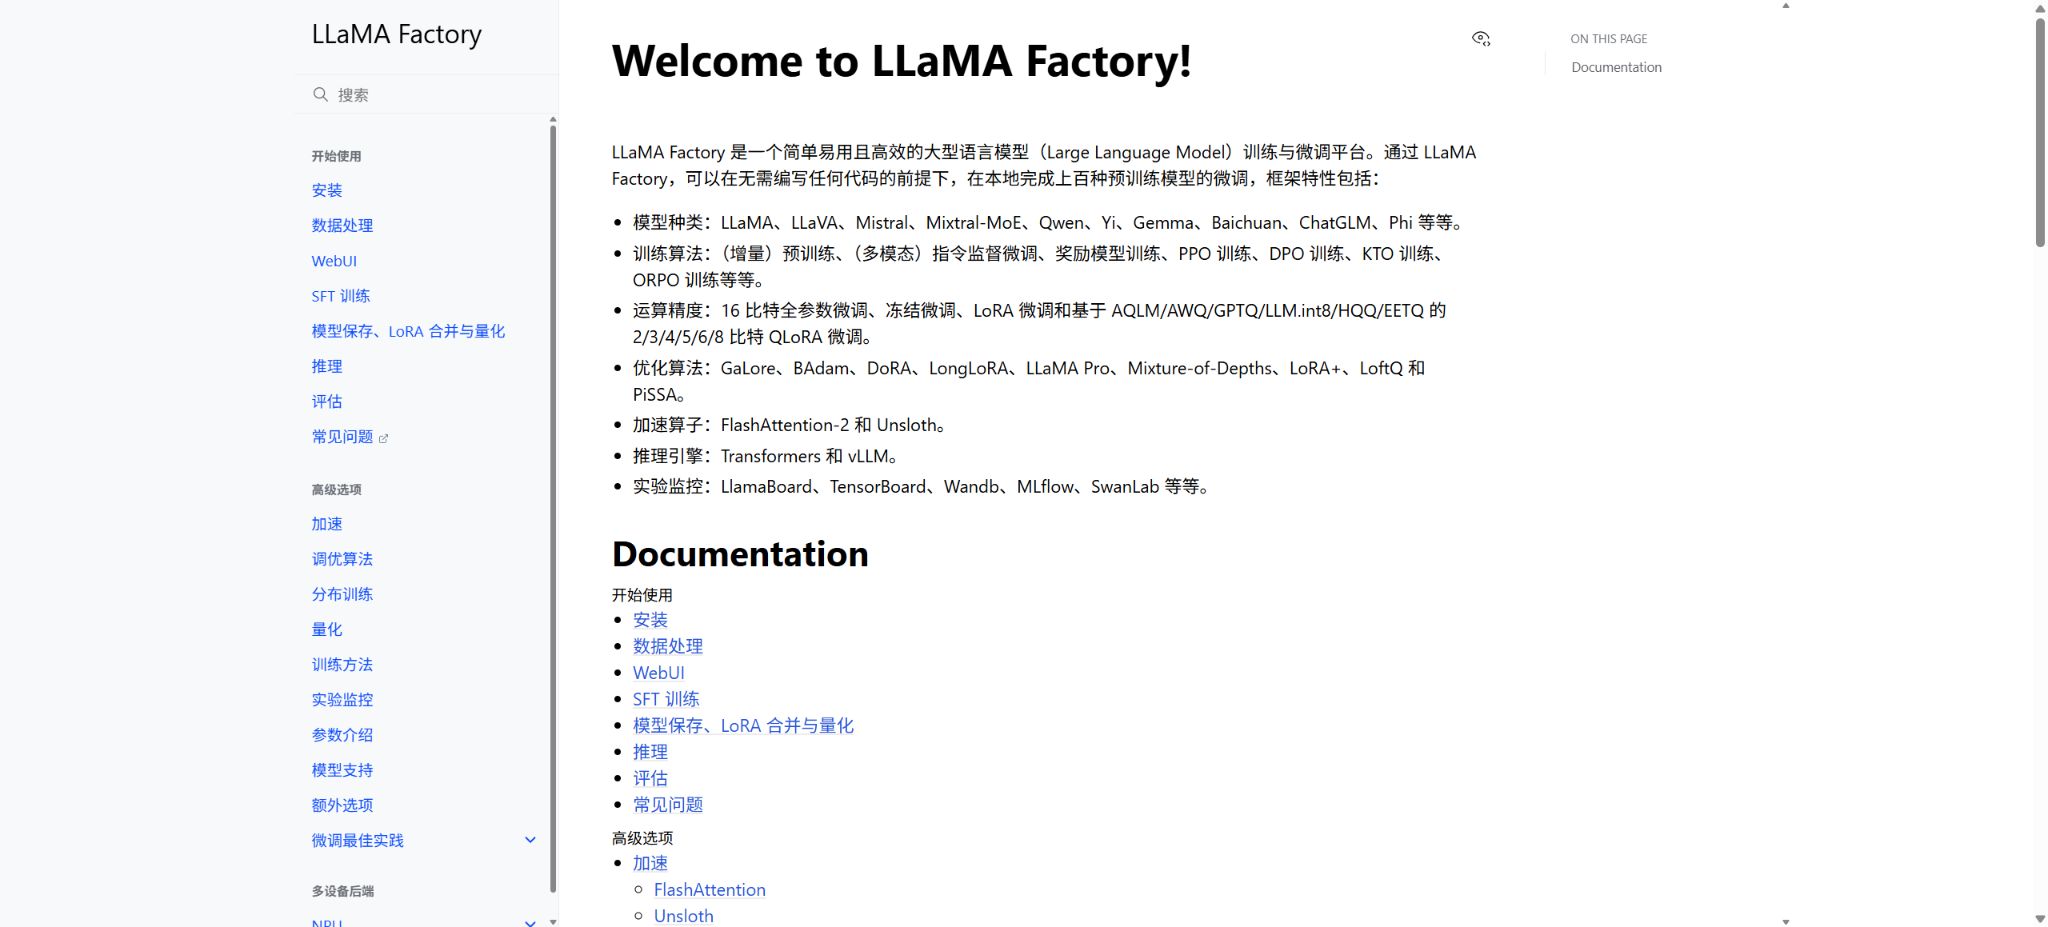
LLaMA Factory ist ein Open-Source-Framework für das Trainieren, Feinabstimmen, Evaluieren und Auswerten großer Sprachmodelle sowie visuell-sprachlicher Modelle. Es integriert das Laden von Modellen, Datenvorlagen, den Trainingsprozess, effizientes Parameter-Feinabstimmen, verteiltes Training, Quantisierung, Export sowie die Bereitstellung in einer einheitlichen Kommandozeile und WebUI. Ziel ist es, die Kosten für das erneute Schreiben von Trainingscode zwischen verschiedenen Modellen zu reduzieren.
Das Projekt unterstützt mehr als 100 verschiedene LLMs und VLMs, darunter gängige Serien wie LLaMA, LLaVA, Qwen, Mistral, Mixtral, Gemma, Yi, Baichuan, ChatGLM und Phi. Das Framework selbst stellt weder Modellgewichte noch Trainingsdaten oder GPU-Leistung bereit; die Nutzer müssen weiterhin den jeweiligen Lizenzen der einzelnen Modelle und Datensätze entsprechen.
Update für Version 0.9.5
Stand dieser Überprüfung ist die neueste offiziell veröffentlichte Version 0.9.5, die im Mai 2026 veröffentlicht wurde. Sie bringt vor allem die Unterstützung für Qwen3.5, Qwen3.6, Gemma 4 und Transformers v5 mit sich, sowie Anpassungen und Fixes für FSDP2, ROCm 7.2 und Intel XPU.
Die aktuellen Installationsanleitungen aktualisieren außerdem die Anforderungen an die Python-Umgebung auf 3.11 oder neuer. Bei der Aktualisierung alter Projekte sollte man die kompatible Kombination der Komponenten PyTorch, Transformers, CUDA oder NPU erneut überprüfen.
Änderungen der Versionnummer können die Modellvorlagen, Konfigurationsfelder sowie den Quantisierungs-Backend beeinflussen. Für Produktivaufgaben wird empfohlen, nicht direkt von der Hauptbranche abzuleiten, sondern stattdessen LLaMA Factory, Transformers, PyTorch, die Beschleunigungsbibliotheken sowie die Modellrevision festzulegen und erst nach Überprüfung mit kurzen Aufgaben zu aktualisieren.
Zero-Code-WebUI
Die LLaMA Factory WebUI bietet vier Hauptoberflächen für Training, Bewertung und Vorhersage, Dialoge sowie Export. Der Benutzer kann das Modell, die Trainingsphase, das Datensatz, die Anpassungsmethode, die Quantisierungsstufe, die Lernrate, die Batch-Größe sowie den Ausgabekatalog auswählen, anschließend die Aufgabe starten und die Protokolle einsehen. Sie eignet sich für Nutzer, die zum ersten Mal mit der Anpassung großer Modelle arbeiten oder wiederholt Konfigurationen anpassen müssen.
Die WebUI dient lediglich zur Konfiguration und zum Zugriff auf Aufgaben und verringert nicht die Speicheraufnahmen sowie Rechenleistung des Modells selbst. Wenn der Pfad zum Modell, die Chat-Vorlagen, das Datenformat, die Quantifizierungsmethode oder die Einstellungen der Geräteumgebung fehlerhaft sind, wird die Benutzeroberfläche ebenfalls nicht korrekt gestartet.
Lange Laufzeiten sollten weiterhin mit Prozessverwaltung, Protokollierung, Checkpoints und Trainingsüberwachung einhergehen.
Befehlszeile und YAML-Konfiguration
Benutzer, die mit den Engineering-Prozessen vertraut sind, können das Training über die Kommandozeile sowie mit YAML-Dateien starten. Die Konfigurationsdatei kann den Speicherort des Modells, die Datensätze, Vorlagen, die Trainingsphasen, die Art der Feinabstimmung, den Optimierer, die Genauigkeit, den verteilten Ansatz, die Speicherrichtlinien sowie die Bewertungsparameter speichern. Dadurch lässt sich das Projekt in Versionskontrollsystemen verwalten und auf mehreren Maschinen nachvollziehen.
Formelle Projekte sollten Konfigurationen, Abhängigkeitsverbindungen, Datenversionen, Zufallszahlen sowie Code-Änderungen zusammen archivieren. API-Schlüssel, Zugriffstoken und interne Speicheradressen sollten nicht direkt in öffentlichen YAML-Dateien oder Logs gespeichert werden, sondern über Umgebungsvariablen oder Secrets verwaltet werden.
Datensatzformat und Vorlage
Für benutzerdefinierte Datensätze muss in der data_info-Konfiguration in der Regel der Name, der Dateipfad, die Feldzuordnung sowie das Format angegeben werden. Das Framework unterstützt Anpassungen von Befehlen, Dialoge, mehrfache Nachrichtenaustausche, Präferenzpaare, KTO-Erückmeldungen sowie multimodale Daten wie Bilder und Videos.
Wenn das Datenformat nicht mit der gewählten Trainingsphase übereinstimmt, tritt entweder ein Fehler auf oder es werden fehlerhafte Labels erzeugt.
Die Chat-Vorlagen bestimmen die Systembenachrichtigungen, die Rollenmarkierungen, die Stoppsymbole sowie die Maskierungen für Tags. Für das Training, die Bewertung, den Dialog, die Kombination sowie die Implementierung über APIs sollten einheitliche Vorlagen verwendet werden.
Ein Rückgang des Verlusts allein reicht nicht aus, um einen Fehlversatz des Templates festzustellen; es ist am besten, die Eingabedaten und die Ziel-Token nach dem Tokenizer zu überprüfen.
Vortrainieren und überwachtes Feintunen
Das Framework unterstützt inkrementelles Vortrainieren und überwachtes Feintunen. Das inkrementelle Vortrainieren dient dazu, dass das Basismodell weiterhin aus dem jeweiligen Fachgebiet lernt, während das überwachte Feintunen die Fähigkeit zur Befolgung von Anweisungen durch Beispiele für Fragen und Antworten oder Dialoge trainiert.
Die Datenstruktur, die Lernrate, die Dauer des Trainings sowie die Bewertungsmethoden unterscheiden sich bei den beiden Ansätzen. Deshalb sollten sie nicht einfach durch Anpassung eines einzigen Parameters ersetzt werden.
Für das Domänenkorpus müssen Duplikate entfernt, es muss gereinigt werden, außerdem müssen Urheberrechtsprüfungen durchgeführt sowie Aspekte der Privatsphäre berücksichtigt werden. Bei den überwachten Daten muss zudem die Richtigkeit der Antworten überprüft werden, ebenso wie die Grenzen für abgelehnte Antworten, die Einhaltung des Formats sowie die Verteilung der Längen. Daten von schlechter Qualität können fehlerhafte Muster in das Modell einbringen.
Full, Freeze und LoRA
Die vollständige Anpassung aller Parameter aktualisiert die meisten oder alle Parameter des Modells. Dadurch ist sie sehr flexibel, erfordert aber den größten Speicherbedarf sowie Kosten für Kommunikation und Checkpoints. Beim Freezing werden nur ausgewählte Schichten oder Module trainiert – dadurch wird ein Kompromiss zwischen Ressourcenverbrauch und Leistung erzielt.
LoRA trainiert mit einem kleinen Satz an Parametern mithilfe von niedrig-rangigen Adaptern und ist die am häufigsten verwendete Methode für individuelle Workstations sowie für die Anpassung an mehrere Aufgaben.
Das Framework unterstützt außerdem Methoden wie DoRA, LoRA+, LongLoRA, PiSSA, LoftQ, LLaMA Pro, Mixture-of-Depths, GaLore und BAdam. Die verschiedenen Methoden sind nicht in allen Modellen, Geräten und distribuierten Backend-Systemen kompatibel. Vor der Auswahl sollte man sich auf die Dokumentation der aktuellen Version sowie auf kleine Testversuche stützen.
QLoRA und niedrigbitige Quantisierung
QLoRA trainiert LoRA-Adapter auf niedrigbitigen Basismodellen, wodurch der Speicherverbrauch erheblich reduziert werden kann. Das Framework unterstützt 2-, 3-, 4-, 5-, 6- und 8-Bit-Verfahren sowie Backends wie AQLM, AWQ, GPTQ, LLM.int8, HQQ und EETQ. Die tatsächliche Nutzbarkeit ist jedoch durch Einschränkungen durch das Betriebssystem, die GPU, die Modellstruktur und die Version der Abhängigkeiten begrenzt.
Niedrigbit-Training bedeutet nicht, dass es auf jedem Grafikchip ausgeführt werden kann. Neben den Modellgewichten muss auch Platz für KV-Werte, Aktivierungen, Optimierer, Gradienten, Datensätze sowie die Länge des Kontexts bereitgestellt werden.
Die Quantifizierung kann außerdem die Durchsatzrate oder Genauigkeit verringern; daher sollten sowohl die Stabilität des Trainings als auch die Ergebnisse im Anschluss getestet werden.
Präferenzoptimierung und Verstärkungslernen
LLaMA Factory unterstützt das Training von Belohnungsmodellen sowie Verfahren zur Präferenzanpassung wie PPO, DPO, KTO und ORPO und umfasst verschiedene Varianten der direkten Präferenzoptimierung. Methoden wie DPO verwenden in der Regel Paare aus Gewinn- und Verlustantworten, KTO kann positive und negative Feedback-Beispiele nutzen, während PPO Komponenten bezüglich Belohnungen, Werteschätzungen und Strategien erfordert.
Die Präferenzdaten sollten hinsichtlich Länge, Thema, Schwierigkeitsgrad sowie Bewertungsverzerrungen kontrolliert werden. Ein Anstieg der Belohnung bedeutet nicht automatisch eine Verbesserung in Bezug auf Richtigkeit, Sicherheit und Benutzererfahrung. Vor der offiziellen Veröffentlichung sind unabhängige Benchmarks, manuelle Blindbewertungen, Red-Team-Tests sowie Rückgriffsbewertungen erforderlich.
Feinabstimmung von multimodalen Modellen
Der Rahmen ermöglicht das Trainieren mehrmodaler Architekturen wie LLaVA und Qwen – visuell-linguistische Modelle –, wobei Bilder oder Videos zusammen mit Textnachrichten eingegeben werden können. Mehrmodale Aufgaben eignen sich für visuelle Fragen beantworten, Dokumentverständnis, Diagrammanalyse sowie Bildbeschreibungen. Allerdings haben die verschiedenen Modelle unterschiedliche Anforderungen hinsichtlich der Medienplätze, der Auflösung, der Frame-Abtastung und der Vorlagen.
Bild- und Videodaten erhöhen erheblich die Kosten für Speicherung, Dekodierung, Grafikspeicher sowie das Laden von Daten. Vor dem Hochladen oder Trainieren müssen zudem Risiken wie Personendarstellungen, urheberrechtlich geschützte Bilder, sensible Dokumente und Standortinformationen berücksichtigt werden.
DeepSpeed, FSDP und Mehrrechner-Training
Das Training großer Modelle kann mit Lösungen wie DDP, DeepSpeed, FSDP, FSDP2 und Ray durchgeführt werden. Dabei wird durch Datenparallelität, Parameter-Sharding sowie Optimierer-Zustands-Sharding die Skalierung auf mehrere Karten oder Maschinen ermöglicht. In Version 0.9.5 wurde die Unterstützung für FSDP2 hinzugefügt, wodurch Zugang zu den neueren PyTorch-Sharding-Schnittstellen gewährt wird.
Distributed Training erfordert eine einheitliche Steuerung, Kommunikationsbibliotheken, Netzwerke, Host-Zeit sowie gemeinsam genutzten Speicher, und es muss korrekt festgelegt werden, wie globale Batches, Gradienten akkumuliert und gespeichert werden. Ein direkter Übergang von einer einzigen Karte auf mehrere Geräte kann zu Problemen mit der Lernrate, der Durchsatzleistung, der Kommunikation sowie bei den Checkpoints führen.
NVIDIA, AMD, Intel und Ascend NPU
Zu den gängigen Umgebungen gehören NVIDIA CUDA; es wird außerdem Unterstützung für AMD ROCm und Intel XPU bereitgestellt. Die Ascend-Szenarien umfassen die Trainingsreihen Atlas A2 und A3 und ermöglichen Vortrainieren, SFT, Belohnungsmodelle, DPO sowie die Methoden Full, Freeze, LoRA, Adapterkombination, DDP, FSDP, FSDP2 und DeepSpeed. Zudem können einige NPU-Integrationsoperatoren verwendet werden.
Die Ascend-Umgebung erfordert kompatible Versionen von CANN, Treibern, Firmware sowie PyTorch und torch-npu; CUDA, ROCm und XPU haben ebenfalls ihre eigenen Versionen.
Die Angabe des Hardware-Namens in der Dokumentation bedeutet nicht, dass alle Modelle und Operatoren bereits getestet wurden. Es sollten Kompatibilitätsprüfungen nach Modell, Genauigkeit, Operator sowie Clustergröße durchgeführt werden.
FlashAttention, Unsloth und Beschleunigung des Trainings
Der Framework kann FlashAttention-2 verwenden, um die Speicherverbrauch und die Rechenauslastung bei der Berechnung der Aufmerksamkeit zu verringern. Zudem sind Beschleunigungswege wie Unsloth verfügbar. Es gibt spezifische Anforderungen an die GPU-Architektur, PyTorch, CUDA, Triton sowie an die Implementierung des Modells. Im Falle eines Installationsfehlers sollte man zunächst zur offiziellen Grundumgebung zurückkehren, um diese zu überprüfen.
Eine Steigerung der Durchsatzleistung sollte nicht auf Kosten der numerischen Stabilität gehen. Nach dem Aktivieren von gemischter Präzision, Gradienten-Checkpointing, Kompilierung oder Fusion von Operatoren sollten Loss-Werte, Gradienten, GPU-RAM, Geschwindigkeit sowie die endgültige Bewertung verglichen werden, um eine Referenzkonfiguration zum Zurückgreifen beizubehalten.
Checkpoint, LoRA-Integration und Modellexport
Im Trainingsprozess können Checkpoints nach der Anzahl der Schritte oder Epochen gespeichert werden, wobei die Anzahl der zu speichernden Checkpoints festgelegt werden kann. Für jedes Experiment sollte ein eigener Ausgabekatalog verwendet werden, um eine Überwrite von Adaptern für unterschiedliche Daten, Vorlagen oder Hyperparameter zu vermeiden.
Nach Abschluss der LoRA-Trainierung kann es mit dem Basismodell kombiniert und für das gewünschte Backend exportiert oder quantifiziert werden.
Die Zusammenführung erfordert ausreichend CPU-Speicher, Grafikspeicher sowie temporären Speicherplatz auf der Festplatte. Das Volumen des zusammengeführten Modells entspricht in etwa dem des ursprünglichen Modells, und es können dadurch keine Rechte zur Weiterverbreitung gewährt werden, die dem ursprünglichen Modell nicht zustehen.
Vor der Veröffentlichung müssen die richtigen Lizenzen und Modellkarten beigefügt werden.
Dialog, batchbasierte Inferenz und vLLM
Das Framework bietet eine Kommandozeilen-Chat-Funktion sowie einen Eingang für Webseitenkommunikation. Es ist möglich, Grundmodellien zu laden oder spezifische LoRA-Adapter einzusetzen, um die Modelle zu überprüfen. Für Batch-Vorhersagen können die Inferenzengines Transformers oder vLLM verwendet werden. vLLM eignet sich besser für eine hohe Durchsatzrate bei der Generierung von Inhalten. Allerdings unterscheiden sich die unterstützten Formate, die Quantisierungsverfahren sowie die Verwaltung des Grafikspeichers von denen beim Training.
Erfolgreiches Training bedeutet nicht, dass die Lösung auch einsetzbar ist. Es sollten die Verzögerung beim Erstellen des ersten Tokens, die Durchsatzrate, die Konkurrenzfähigkeit, die Länge des Kontexts, die Beendigungsbedingungen, die strukturierte Ausgabe, der GPU-Auslastung sowie fehlerhafte Eingaben getestet werden. Zudem muss sichergestellt werden, dass die geladenen Adapter, Vorlagen und das Basismodell vollständig übereinstimmen.
OpenAI-kompatible API
Mithilfe der API-Startbefehle kann das Modell als OpenAI-kompatibler Dienst bereitgestellt werden, was es bestehenden Clients, Bewertungstools oder Anwendungen erleichtert, darauf zuzugreifen. Auf der Serverseite können das Modell, die Vorlage, die Art der Feinabstimmung sowie der Pfad des Adapters festgelegt werden; außerdem kann dies mit fließender Ausgabe kombiniert werden.
Diese Schnittstelle dient als Eintrittspunkt für die Bereitstellung, nicht als Cloud-Dienst mit Hosting-Funktionen. Für den produktiven Einsatz müssen Authentifizierung, TLS, Bandbreitenbegrenzung, Auditing, Inhaltssicherheit, Warteschlangen, Health Checks, automatische Wiederherstellung sowie Ressourcenisolation selbst bereitgestellt werden. Ports ohne Authentifizierung dürfen nicht direkt ins öffentliche Netzwerk freigegeben werden.
Experimentelle Überwachung und Berichterstattung
Die Trainingskonfiguration kann mit Experimentverfolgungstools wie TensorBoard, Weights & Biases, SwanLab, MLflow und Trackio verbunden werden, um Verlustwerte, Lernraten, Belohnungen, Durchsatz, GPU-RAM sowie Bewertungskennzahlen aufzuzeichnen. Das Team sollte Projektname, Laufname, Tags sowie den Speicherzeitraum standardisieren, um zu verhindern, dass Experimente nicht nachverfolgt werden können.
Die Überwachungsplattform kann Konfigurationen, Protokolle sowie generierte Beispiele erhalten. Wenn es um Unternehmensdaten oder Anfragen der Benutzer geht, sollte eine lokale Speicherung oder eine privatisierte Lösung gewählt werden, wobei die Daten vor der Übermittlung maskiert werden müssen.
Installationsmethode
Der übliche Installationsprozess besteht darin, das offizielle Repository zu klonen, die Installation in einer eigenständigen Python-Umgebung durchzuführen, bei Bedarf Abhängigkeiten für Bewertung, Quantifizierung, Verteilung, NPU oder Inferenz hinzuzufügen und schließlich mit dem Versionskommando zu überprüfen. Die Kombinationen aus Abhängigkeiten für Windows, Linux, WSL, Docker sowie verschiedene Beschleunigungskarten unterscheiden sich voneinander.
Bevor man etwas installiert, sollte man zunächst die Trainingsgeräte sowie den Backend-Server festlegen. Anschließend sollte man die Versionen von PyTorch und den entsprechenden Treibern auswählen – das ist stabiler als wenn man alle möglichen Abhängigkeiten auf einmal installiert. Auf den Servern im Produktivbetrieb sollte eine Liste der Umgebungsvariablen gespeichert werden, und Modelle, Daten, Ausgaben sowie temporäre Verzeichnisse sollten auf einem Datenträger mit ausreichend Speicherplatz abgelegt werden.
Preise und Nutzungskosten
Die Kernsoftware von LLaMA Factory ist kostenlos und open source – es fallen keine offiziellen Abonnementsgebühren an. Die tatsächlichen Kosten entstehen durch die Rechenleistung von GPU oder NPU, Cloud-Server, Speicher, Netzwerk, das Herunterladen von Modellen, die Erstellung von Daten, die Annotation, die Bewertung sowie die Wartung.
Die Kosten für das Training mit allen Parametern, das Multi-Machine-Training sowie das Verarbeiten langer Kontextdaten sind erheblich höher als bei kleinen LoRA-Experimenten.
Hosted-Dienste wie LLaMA Factory Online, die im Internet verfügbar sind, gehören zu eigenständigen Cloud-Produkten oder Kooperationsdiensten. Der Preis pro GPU sowie die damit verbundenen Vorteile ändern sich dynamisch; daher kann man ihre Preise nicht mit den Preisen für offene Quellcode-Software vergleichen.
Ist es Open Source?
Der LLaMA Factory-Repository wird unter der Apache License 2.0 bereitgestellt, wodurch er nach den Bedingungen dieser Lizenz verwendet, modifiziert und verbreitet werden kann. Diese Lizenz gilt nur für den Projektcode und umfasst nicht automatisch Drittanbietermodelle wie Meta, Qwen, Google oder Zhipu, ebenso wenig wie Benutzerdaten, Datensätze oder generierte Inhalte.
Vor der kommerziellen Nutzung müssen die Abhängigkeiten des Codes, die Gewichte der Modelle, der Tokenizer sowie die Bedingungen für das Datensatz- und Testdatenset einzeln überprüft werden. Einige Modelle haben Einschränkungen hinsichtlich der kommerziellen Nutzung, der Anzahl der Nutzer, des Anwendungsbereichs oder der Art der Weiterverbreitung.
Anleitung zur Verwendung von LLaMA Factory
Eine grundlegende Aufgabe erledigen
- LLaMA Factory installieren und konfigurieren sowie für das Experiment separate Projekte und Laufnamen erstellen;
- In dem Trainingsskript sollten Hyperparameter, Datenversionen, Codeversionen sowie die Zufallszahlenseed festgehalten werden;
- Durch die Aktualisierung auf Version 9.5 werden die Initialisierungsaufgaben durchgeführt und eine Verbindung zu den richtigen Cloud- oder privaten Diensten hergestellt;
- Verwenden Sie eine Zero-Code-WebUI, um kontinuierlich Verluste, Metriken, Protokolle sowie den Hardware-Zustand aufzuzeichnen;
- Führen Sie ein kleines Trainingslauf durch, um zu überprüfen, ob Schrittanzahl, Einheiten, Kurven und Medienbeispiele korrekt sind;
- Speichern Sie nach Abschluss das Modell, die Einstellungen, die Ergebnisse sowie die Anleitung zur Wiederholung des Experiments.
Erstellung wiederverwendbarer professioneller Workflows
- Einheitliche Normen für die Benennung von Projekten, Experimenten, Indikatoren und Labels;
- Die Version 9.5, die codefreie WebUI sowie die Befehlszeile und YAML-Konfigurationen sollen in das Schulungstemplate aufgenommen werden;
- Versionen für Datensätze, Code, Umgebungen und Modelle verknüpfen;
- Verwenden Sie dasselbe Bewertungsset und dieselben Vergleichsexperimente, um zu vermeiden, sich nur auf glatte Kurven zu konzentrieren;
- Einschränkung des Upload-Bereichs für sensible Proben, Prompts und Modellausgaben;
- Stellen Sie Alarme für Ausnahmen, Speicherungspolitiken sowie manuelle Überprüfungen ein, bevor Sie sie auf das Team ausweiten;
Für welche Nutzer geeignet?
- Lernende, die die erste Anpassung mit LoRA oder QLoRA über die WebUI durchführen möchten;
- Es werden Algorithmus-Ingenieure benötigt, die verschiedene Open-Source-LLM- und VLM-Algorithmen einheitlich trainieren können;
- Forschungsteam, das Experimente mit SFT, DPO, KTO, PPO und Belohnungsmodellen durchführt;
- Einrichtungen, die für das verteilte Training DeepSpeed, FSDP oder Ascend NPU benötigen;
- Entwickler, die Adapter zusammenführen, Batch-Bewertungen durchführen und kompatible APIs bereitstellen möchten.
Vorteile des Produkts
- Umfasst mehr als 100 Sprachen und visuelle Sprachmodelle;
- Die WebUI und die CLI bieten sowohl eine einfache Einführung als auch wiederholbare Projektprozesse.
- Full, Freeze, LoRA, QLoRA sowie zahlreiche weitere neue Feinabstimmungsmethoden sind vorhanden;
- Unterstützung für Vortrainings, SFT, Belohnungsmodellierung sowie verschiedene Optimierungsphasen für Präferenzen;
- Kompatibel mit DeepSpeed, FSDP, vLLM und verschiedenen Hardware-Typen;
- Apache 2.0 ist open source, die Community ist aktiv und es gibt häufige Updates.
Einschränkungen und Hinweise
- Die Liste der unterstützten Modelle ist lang, aber nicht alle Kombinationen aus verschiedenen Trainingsphasen, Quantisierungsverfahren und Hardware sind verfügbar.
- Die WebUI kann die Datenreinigung, die Schätzung des Arbeitsspeicherverbrauchs sowie das Verwalten und Bewerten von Abhängigkeiten nicht ersetzen.
- Die Feinabstimmung aller Parameter erfordert viel Grafikspeicher und Speicherplatz; QLoRA kann zudem durch Einschränkungen des Betriebssystems und des Quantisierungsbackends beeinträchtigt werden.
- Die Aktivierung von trust_remote_code führt den vom Modellrepository bereitgestellten Code aus; es sollte eine zuverlässige Revision festgelegt und die Quelle überprüft werden.
- Öffentliche Dienste erfordern Authentifizierung und Sicherheitskontrollen, während bei Trainingsdaten Aspekte wie Privatsphäre, Urheberrechte sowie das Risiko von Manipulationen berücksichtigt werden müssen.
Häufige Fragen
Ist LLaMA Factory kostenlos?
Der Kerncode ist kostenlos und unterliegt der Apache 2.0-Lizenz. Für GPU-Cloud-Server, Speicher, Modelle und Daten können Gebühren anfallen; Drittanbieter-Hosting-Dienste werden separat berechnet.
Welche Anpassungsmethoden werden von LLaMA Factory unterstützt?
Es werden Full, Freeze, LoRA, QLoRA sowie Erweiterungen wie DoRA, LoRA+, PiSSA usw. unterstützt; die Trainingsphasen umfassen Vortrainieren, SFT, Belohnungsmodellierung, PPO, DPO, KTO und ORPO usw.
Kann man ohne Programmiererfahrung arbeiten?
Die Konfiguration von Training, Bewertung, Dialog und Export ist über die WebUI möglich, doch es ist dennoch notwendig, sich mit dem Modell, den Datensformaten, den Vorlagen, dem Speicherbedarf sowie den Umgebungsanforderungen vertraut zu machen. Es wird empfohlen, zunächst mit einem kleinen Modell und einer geringen Menge an Daten den gesamten Ablauf zu testen.
Kann eine API bereitgestellt werden?
Es ist möglich, eine mit OpenAI kompatible API zu nutzen, oder man kann vLLM für Batch- oder Hochdurchsatz-Berechnungen verwenden. Für einen offiziellen Betrieb müssen Authentifizierung, Bandbreitenbegrenzung sowie Sicherheitsprüfungen und -überwachung selbst implementiert werden.
Wird die Ascend NPU unterstützt?
Es wird die Atlas A2- und A3-Trainingsreihen sowie verschiedene Trainingsphasen und verteilte Ansätze unterstützt, wobei die Versionen von CANN, Treibern, Firmware, PyTorch und torch-npu übereinstimmen müssen.
Ist LLaMA Factory ein Modell?
Nein. Es handelt sich um ein Framework für Training und Feinabstimmung, das keine vorgefertigten, direkt für den kommerziellen Einsatz geeigneten Modellgewichte beinhaltet.
Der Benutzer muss ein Basismodell auswählen und herunterladen, das der Lizenz entspricht.
Tools, die der LLaMA Factory ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164