




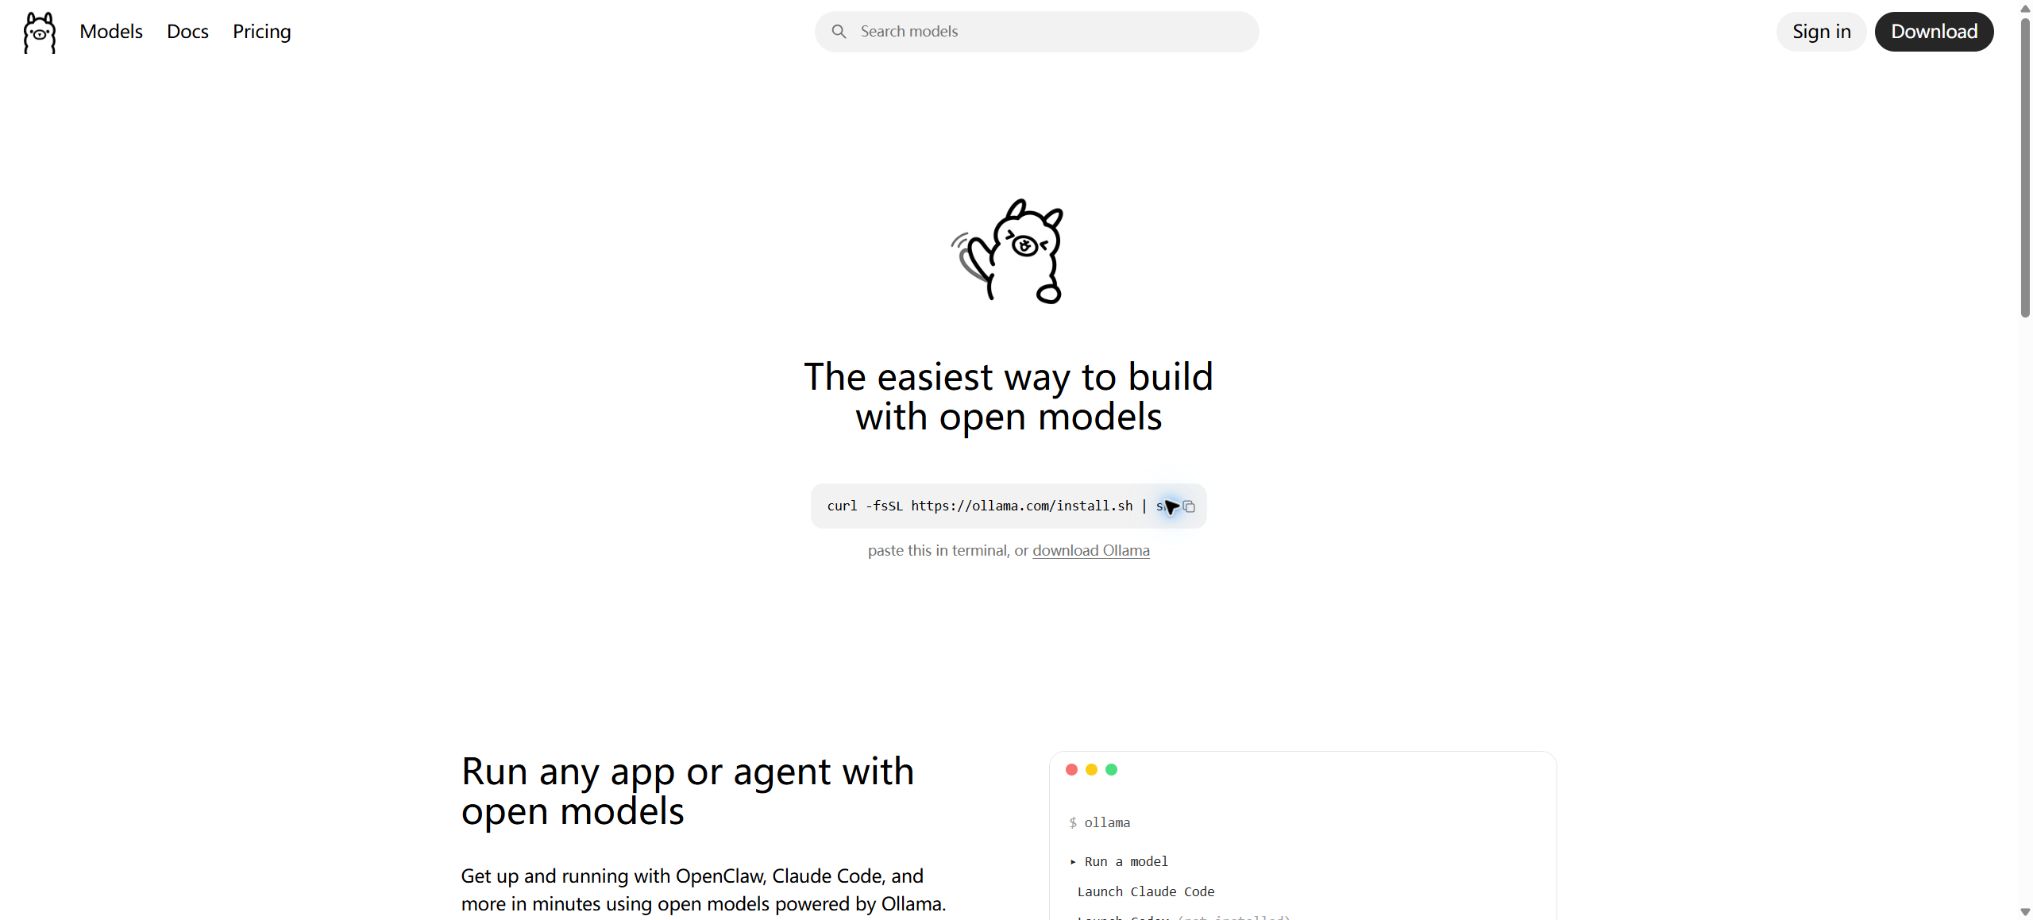
Ollama
Schnelles Ausführen und Aufrufen von offenen großen Sprachmodellen auf dem lokalen Computer oder in der Cloud
Tags:AI-EntwicklungsframeworksWas ist Ollama?
Ollama ist ein lokales Tool zum Herunterladen, Ausführen und Verwalten großer Sprachmodelle. Nach der Installation können mithilfe einfacher Befehle Modelle wie Qwen, Gemma, DeepSeek, gpt-oss, Llama usw. heruntergeladen werden, um auf dem eigenen Windows-, macOS- oder Linux-Gerät zu chatten oder eine API bereitzustellen.
Es ist für Modelldateien, quantisierte Versionen, den Ladevorgang in den Arbeitsspeicher, den Kontext sowie lokale Dienste zuständig – dadurch müssen Entwickler keine komplexen Inferenzframeworks manuell konfigurieren. Ollama bietet außerdem Cloud-Modelle an: Die Befehle und APIs ähneln denen der lokalen Modelle, doch die eigentliche Inferenz wird automatisch auf die Ollama-Cloud übertragen, wodurch große Modelle ausgeführt werden können, die auf dem lokalen Gerät nicht untergebracht werden können.
Kernfunktionen
- Lokale Modellverwaltung:Modelle können mit den Befehlen pull, run, list, show und remove heruntergeladen, ausgeführt, angezeigt und entfernt werden; es werden verschiedene Parametermengen sowie Quantisierungsversionen unterstützt.
- Lokale API:Nach der Installation werden standardmäßig Funktionen für Erstellung, Chatten, Embedding, Liste der Modelle sowie Verwaltungsschnittstellen bereitgestellt. Für den Zugriff vom lokalen Rechner ist in der Regel kein API-Schlüssel erforderlich.
- OpenAI-kompatible Schnittstelle:Häufig verwendete Methoden wie Chat Completions ermöglichen einen einfachen Anschluss an bestehende Anwendungen, IDEs und Agenten-Tools.
- Modelfile:Erstellen Sie wiederverwendbare, benutzerdefinierte Modelle aus der Definition von Basismodellen – Systemprompt, Vorlagen, Parametern, Adaptern und Lizenzinformationen.
- Werkzeuge und strukturierte Ausgabe:Unterstützung für Tool Calling, JSON Schema, visuelle Eingaben und Embedding – die genauen Funktionen hängen vom Modell ab.
- Cloud-Modell:Mit Modellen, die das Cloud-Label tragen, oder durch direkte Aufrufe der Cloud-API kann man ohne lokale GPU den vollen Kontext sowie die Fähigkeiten großer Modelle nutzen.
- Integration von Entwicklungstools:Es kann mit Claude Code, Codex, OpenCode, OpenClaw, Zed sowie verschiedenen Chat-UIs verbunden werden, wobei die Konfiguration durch ollama launch vereinfacht wird.
- Web-Suche und Abrufen:Der Cloud-Service bietet Such- und Webseiten-Les-APIs, um lokale oder cloudbasierte Modelle mit Echtzeitdaten zu ergänzen.
Preis
| Paket oder Version | Preise, Limits und Kernvorteile |
|---|---|
| Lokale Nutzung / Kostenlos | 0 Dollar: Es fallen keine Abonnementsgebühren an, um den Client herunterzuladen und das Modell auf dem eigenen Gerät auszuführen; Cloud bietet eine geringe, kostenlose Datenmenge sowie 1 gleichzeitiges Modell. |
| Pro | 20 Dollar pro Monat oder 200 Dollar pro Jahr – die Cloud-Nutzung ist etwa 50-mal höher als bei der kostenlosen Version. Es können gleichzeitig 3 Cloud-Modelle ausgeführt werden, außerdem ist das Hochladen und Teilen eigener Modelle möglich. |
| Max | 100 US-Dollar pro Monat, Cloud-Nutzung etwa 5-mal so hoch wie bei Pro, 10 parallele Modelle; neue Abonnements sind vorerst ausgesetzt, bestehende Nutzer behalten ihre Rechte. |
| Team | Einführungsphase: 25 US-Dollar/Sitzplatz/Monat, mindestens 5 Sitzplätze, Mindestbetrag 125 US-Dollar/Monat; Nutzung des gemeinsamen Kontos und der Team-Bilanz – derzeit muss man sich auf die Warteliste setzen. |
| Enterprise | Individuelle Kostenvoranschläge mit höheren Preisen bei größeren Mengen, Verträgen, Support für sichere Beschaffung und Implementierungsplanung. |
Cloud ist kein fester Token-Paket, sondern die Nutzung wird nach dem Modelllevel, den Eingaben, den gepufferten Eingangs- und Ausgangstokens bemessen; verschiedene Modelle verbrauchen je nachdem unterschiedlich viel – vom günstigen Level 1 bis zum kostspieligen Level 4.
Die individuellen Pläne haben eine Beschränkung von 5 Stunden pro Sitzung sowie eine wöchentliche Beschränkung von 7 Tagen; Pro und Max ermöglichen den Kauf zusätzlicher Guthaben.
Zuerst werden die Verbrauchsmengen der Teammitglieder abgezogen; bei Überschreitung wird gemäß dem Modelltarif vom gemeinsamen Saldo abgebucht.
Hardware und lokale Kosten
Dass lokale Software kostenlos ist, bedeutet nicht, dass die Verarbeitung keine Kosten verursacht. Die Modelldateien können einige GB bis mehrere hundert GB groß sein; Geschwindigkeit und verfügbare Kontexte hängen von RAM, Grafikspeicher, GPU-Architektur und Quantisierung ab.
Kleine Modelle können auf der CPU oder auf Geräten mit gemeinsamer Speicheranlage ausgeführt werden, während große Modelle viel Grafikspeicher oder mehrere GPUs benötigen. Je länger der Kontext ist, desto mehr Speicher wird vom KV-Cache in Anspruch genommen.
Bei der offiziellen Implementierung müssen auch Stromversorgung, Server, Konkurrenzfähigkeit, Überwachung, Backups sowie Zugriffskontrollen berücksichtigt werden.
Privatsphäre, Open Source und Lizenzen
Beim lokalen Betrieb geben die Hersteller an, dass weder Benachrichtigungen noch Daten sichtbar sind; die Cloud-Funktion kann deaktiviert werden, um in den rein lokalen Modus zu wechseln.
Bei der Verwendung von Cloud werden Hinweise und Antworten verarbeitet, um den Service bereitzustellen. Offiziell wird jedoch erklärt, dass der Inhalt weder gespeichert noch aufgezeichnet wird und auch nicht zur Schulung verwendet wird; es werden lediglich begrenzte Metadaten zu Konten und Nutzungsmengen erfasst.
Cloud wird hauptsächlich in den USA gehostet, kann aber auch nach Europa und Singapur geleitet werden.
Die Kern-Befehlszeilenuhr und der Server-Repository von Ollama werden unter der MIT-Lizenz bereitgestellt. Es ist zu beachten, dass die Modelldateien jeweils eigene Lizenzen haben: Einige erlauben die kommerzielle Nutzung, während andere Einschränkungen hinsichtlich des Verwendungszwecks, der Anzahl der Nutzer oder der Weiterverbreitung aufweisen.
Dass Ollama open source ist, bedeutet nicht, dass alle über es heruntergeladenen Modelle frei für kommerzielle Zwecke genutzt werden können; Unternehmen müssen die jeweiligen Modellkarten und Lizenzen einzeln prüfen.
Der Open-Source-Anteil der Desktop-GUI, Cloud- und Webdienste kann auch nicht einfach mit dem des Kernrepositories gleichgesetzt werden.
Ollama-Anleitung
Eine grundlegende Aufgabe erledigen
- Registrieren Sie sich bei Ollama und erstellen Sie einen API-Schlüssel, der ausschließlich für die Testumgebung verwendet wird;
- Wählen Sie das Modell entsprechend der Eingabetypen, des Kontexts, der Qualität, der Geschwindigkeit und des Preises aus;
- Zuerst wird die lokale Modellverwaltung aufgerufen, um die minimale Anfrage abzuschließen und die zurückgegebene Struktur zu überprüfen;
- Testen Sie anschließend die fließende Ausgabe, Parameter und Fehlerantworten mit der lokalen API;
- Protokollieren Sie Tokens, Anrufanzahl, Verzögerung, Fehlerrate und Kosten pro Aufruf;
- Tragen Sie den Schlüssel in den Server-basierten Schlüsselmanager ein, bevor Sie die eigentliche Anwendung anschließen;
Erstellung wiederverwendbarer professioneller Workflows
- Für die Entwicklungs-, Test- und Produktionsumgebungen werden unterschiedliche Schlüssel und Limits verwendet;
- Ein repräsentatives Bewertungsset wird unter Verwendung von lokalen Modellen, lokalen APIs sowie OpenAI-kompatiblen Schnittstellen erstellt;
- Einstellen von Timeout, Konkurrenz, Wiederholungsversuchen, Limitierung sowie Budgetobergrenzen;
- Durchführung von Überprüfungen hinsichtlich Fakten, Sicherheit, Formatierung und sensibler Informationen am Ausgangsinhalt;
- Überwachung von Änderungen bei Modellversionen, Preisen, Verzögerungen und Ausfallraten;
- Vorbereitung von Plänen für die Herabstufung des Modells, Schutzmaßnahmen sowie manuelle Übernahme.
Für welche Benutzer geeignet
- Entwickler, die möchten, dass die Daten auf dem Gerät bleiben, sowie Nutzer, denen die Privatsphäre wichtig ist
- Team zur Entwicklung lokaler RAG-, Chat-, Programmier-Assistenten und Agenten
- Entwickler von Anwendungen, die eine einheitliche API zum Wechseln zwischen lokalen und Cloud-Modellen benötigen
- Forschung und Ausbildung für Nutzer zum Lernen verschiedener Open-Source-Modelle sowie zu deren Quantifizierungseffekten
Sicherheit und Beschränkungen
- Die lokale API benötigt standardmäßig möglicherweise keine Authentifizierung, sollte nur mit zuverlässigen Netzwerken verbunden werden und nicht direkt der Öffentlichkeit zugänglich gemacht werden.
- Container, entfernte Server und Teamumgebungen sollten Reverse-Proxy, TLS, Authentifizierung sowie Geschwindigkeitsbeschränkungen aufweisen;
- Wenn ein Agent auf einen Terminal oder ein Dateisystem zugreift, muss er eine Sandbox sowie minimale Berechtigungen verwenden.
- Die Ausgabe des Modells kann Halluzinationen enthalten, unsicheren Code erzeugen oder sensible Daten aus den Anweisungen preisgeben;
- Die Qualität kleiner Modelle ist in der Regel geringer als die von führenden Cloud-Modellen.
- Die Quelle des Modells, die Integrität der Datei sowie die Lizenz müssen ebenfalls überprüft werden.
- Kritische Geschäftsprozesse sollten Bewertungen, Inhaltsfilterung und manuelle Überprüfungen umfassen.
Häufige Fragen
Ist Ollama völlig kostenlos?
Lokale Clients und lokale Inferenz sind kostenlos; Cloud-Nutzung auf höherem Niveau, Teamdienste sowie eigene Hardware und Stromkosten sind erforderlich.
Braucht Ollama eine Internetverbindung?
Für den ersten Download des Modells ist eine Internetverbindung erforderlich; nach dem Download kann das lokale Modell ohne Internetbetrieb genutzt werden. Cloud- und Web-Suche erfordern hingegen eine Internetverbindung.
Kann man ohne Grafikkarte arbeiten?
Einige kleine Modelle können ausgeführt werden, allerdings etwas langsamer. Für große Modelle mit unzureichender Speicherkapazität kann man auf quantisierte Versionen oder Cloud-Modelle zurückgreifen.
Tools, die Ollama ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164