




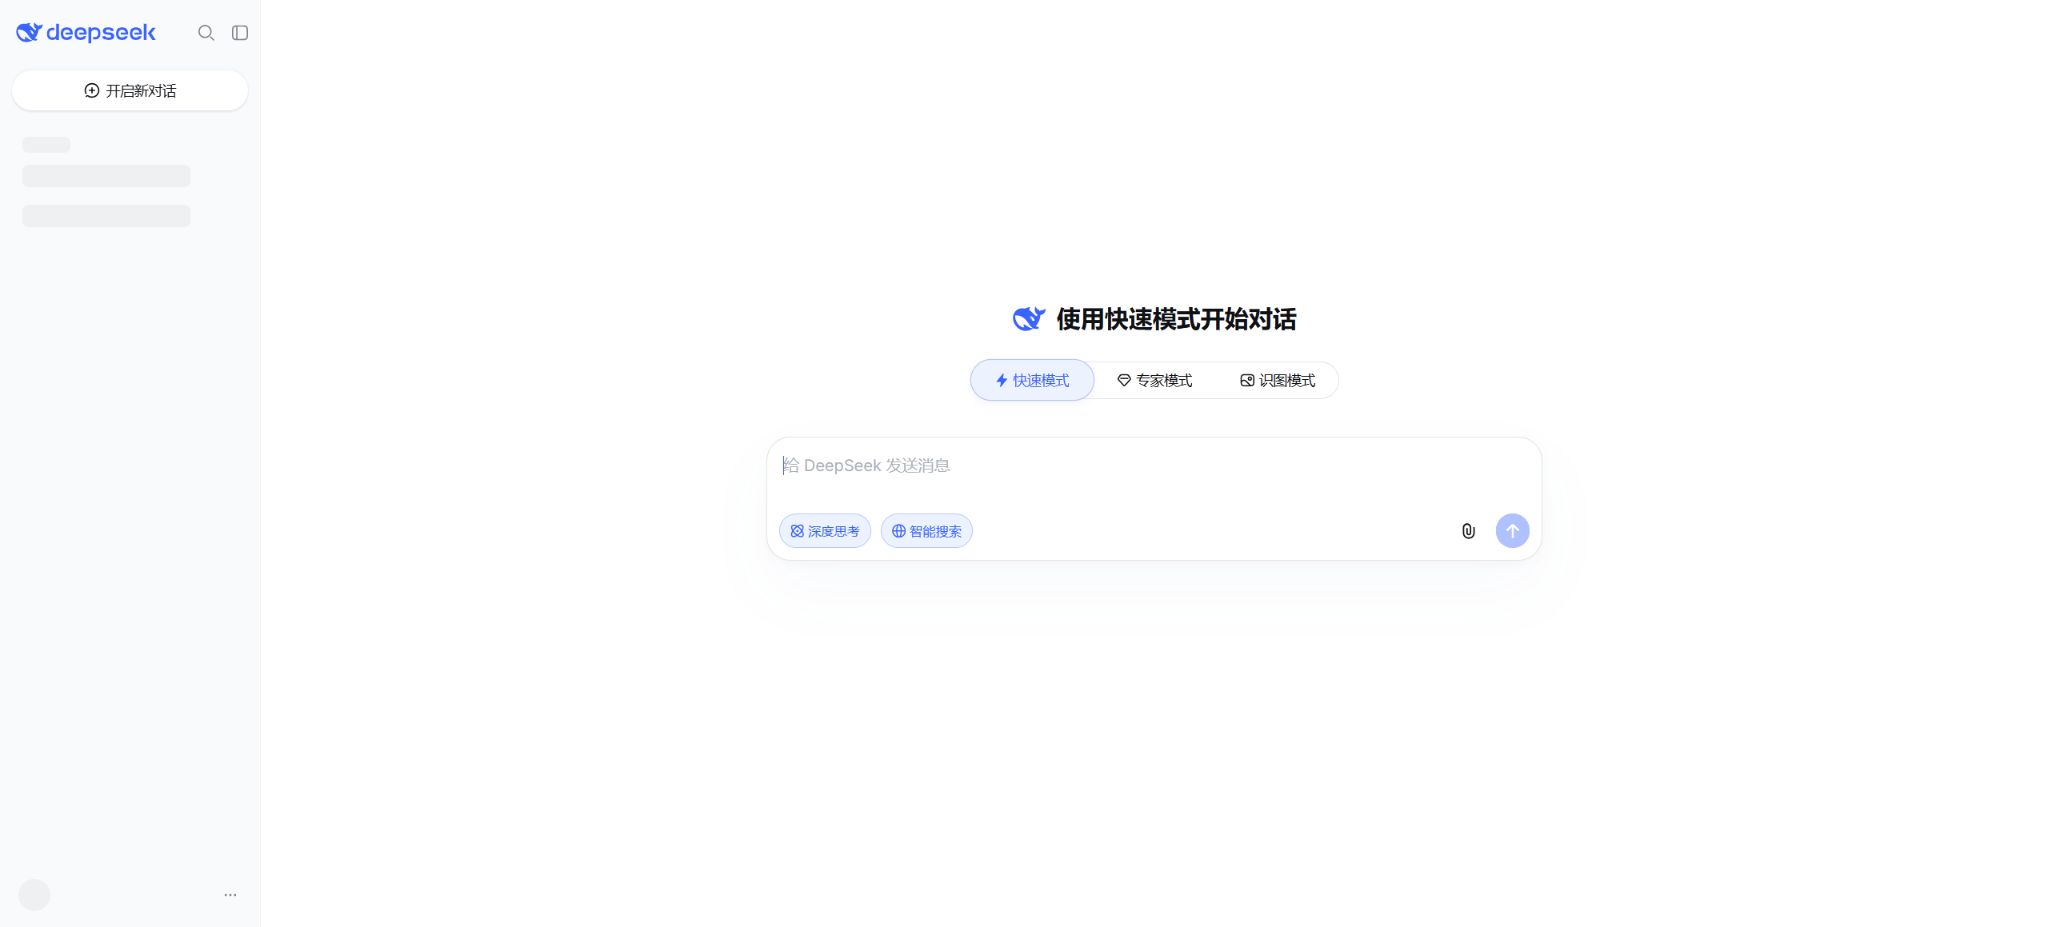
DeepSeek
Ein inländischer KI-Assistent mit gutem Preis-Leistungs-Verhältnis, der über Fähigkeiten in der Logik, Programmierung sowie bei allgemeinen Fragen verfügt.
Tags:KI-Dialog-ChatWas ist DeepSeek?
DeepSeek ist eine Marke für große KI-Modelle, ein kostenloser AI-Assistent sowie eine Entwickler-API-Plattform, die von der Hangzhou DeepSeek Artificial Intelligence Basic Technology Research Co., Ltd. entwickelt wurde. Nutzer können über die Webversion oder die offizielle App Fragen beantworten, Texte schreiben, übersetzen, Probleme lösen, programmieren, im Internet suchen, Bilder verstehen und Dateien lesen.
Entwickler können über Schnittstellen, die mit den Formaten von OpenAI und Anthropic kompatibel sind, auf die Modelle zugreifen. Zudem können sie die offiziell veröffentlichten Modellgewichte herunterladen, um sie zu untersuchen, anzupassen oder lokal zu deployen.
Stand dieser Überprüfung hat DeepSeek seinen offiziellen Hauptpfad bereits betreten.DeepSeek-V4In der Serie sollte R1 oder V3 nicht weiter als die neuesten Flaggschiffe bezeichnet werden. V4 umfasst V4-Flash, das auf Geschwindigkeit und Kosteneffizienz setzt, sowie V4-Pro, das eine größere Größe sowie bessere Fähigkeiten in Bezug auf Wissen und komplexe Schlussfolgerungen bietet.
Die Behörden stellten am 31. Juli 2026 die offizielle Beta-Version der V4-Flash-API zur Verfügung, wobei der Schwerpunkt auf der Verbesserung der Fähigkeiten der Code-Agenten sowie der Tools zur Ausführung von Aufgaben lag. Bei diesem Update wurden die V4-Pro-API sowie die Modelle für App/Web-Seiten nicht gleichzeitig geändert.
Über das Internet verbreitete Informationen über „DeepSeek-R2“ weisen keine offiziellen Veröffentlichungen auf; in Katalogen sollten Gerüchte nicht als existierende Produkte betrachtet werden.
Kernfunktionen
- Allgemeine KI-Unterhaltung:Bearbeitung von Wissensfragen, Zusammenfassung von Inhalten, chinesische Texte verfassen, Übersetzen, Erklärungen zum Lernen, Konzeption von Plänen und alltägliche Entscheidungen. Das Modell kann zwischen schnellen Antworten und tiefergehender Analyse wechseln, doch die Ausgaben können dennoch Fehler aufweisen.
- Tiefgründiges Nachdenken:Sowohl V4-Pro als auch V4-Flash unterstützen drei verschiedene Stufen der Denkleistung: „Kein Nachdenken“, „Think High“ und „Think Max“. Für alltägliche Aufgaben kann das Modell „Kein Nachdenken“ verwendet werden, um die Geschwindigkeit zu erhöhen. Für Mathematik, Programmierung, Planung sowie komplexe Analysen eignet sich hingegen eine höhere Stufe der Denkleistung.
- Suche im Internet:Die Verbraucher können im Internet nach Informationen suchen und daraus zusammenfassende Antworten erstellen. Dies eignet sich zur Abfrage von Hintergrundinformationen zu Nachrichten, Produktdaten sowie aktuellen Ereignissen. Suchergebnisse sind nicht identisch mit dem Originaltext – Daten, Zahlen, Zitate und Richtlinien müssen daher auf der ursprünglichen Seite überprüft werden.
- Bilderkennung und Fragen zu Bildern:Die offizielle Mobile-App verfügt nun über einen Bilderkennungsmodus, mit dem Fotos, Screenshot oder Diagramme hochgeladen werden können, um sie zu analysieren, Texte daraus zu extrahieren und Fragen zu beantworten. Es handelt sich dabei um eine Form der visuellen Verarbeitung – es sollte nicht fälschlicherweise als Funktion zur Erstellung von professionellen Bild- oder Videoinhalten angesehen werden.
- Dokumente lesen:Es wird das Hochladen von Dokumenten unterstützt, sowie die Zusammenfassung des Inhalts, die Extraktion von Schlüsselpunkten, die Erklärung von Konzepten und weitere Nachfragen. Es eignet sich für die erste Lektüre von Aufsätzen, Berichten, Verträgen und Lernmaterialien. Die Erkennung von sehr großen Dateien, komplexer Formatierung, Scans sowie Tabellen wird durch das Format beeinflusst.
- Code und Mathematik:Code kann erstellt, interpretiert, debuggt und umstrukturiert werden; außerdem können Algorithmen, mathematische Herleitungen sowie ingenieurwissenschaftliche Probleme bearbeitet werden. Die offizielle Version von V4-Flash wurde speziell für Aufgaben mit Code-Agenten verbessert und eignet sich dazu, in Entwicklungstools Analysen durchzuführen, Patches zu erstellen sowie Terminalaufgaben zu erledigen. Produktionscode muss jedoch getestet und auf Sicherheit überprüft werden.
- Langer Kontext:Sowohl die offiziellen Modelle V4-Pro als auch V4-Flash unterstützen einen Kontext von 1 Million Token, wobei die maximale Ausgabellänge bei 384 K liegt. Die tatsächlich verfügbare Länge hängt außerdem von der Plattform, dem Grafikspeicher, den Kosten, den Verzögerungen sowie den Einschränkungen des Clients ab.
- Agent und Toolaufrufe:Die API unterstützt JSON-Ausgabe, Tool-Anrufe, Fortsetzung von Dialogpräfixen sowie FIM-Verbesserungen; V4-Flash bietet native Unterstützung für die Responses-API und ermöglicht die Anbindung an Code-Proxye sowie automatisierte Workflows. Tool-Anrufe können Modellobehler als tatsächliche Aktionen darstellen; bei Aufgaben wie Schreiben von Dateien, Veröffentlichung, Zahlungen oder Löschungen sollte eine manuelle Bestätigung erfolgen.
- Synchronisation auf mehreren Geräten:Es stehen Versionen für Web, iPhone, iPad und Android zur Verfügung. Auf mobilen Geräten kann man nach früheren Gesprächen suchen, Tabellen kopieren und herunterladen, die Schriftgröße anpassen sowie Bilder und Dateien hochladen. Weitere Funktionen werden im Laufe der Zeit in Abhängigkeit von der Version und dem Land hinzugefügt.
Wie wählt man zwischen V4-Pro und V4-Flash?
V4-Flash ist ein MoE-Modell mit insgesamt 284 Milliarden Parametern und 13 Milliarden Aktivierungsparametern; es eignet sich für Nutzer, die Geschwindigkeit, niedrige API-Kosten sowie die Verarbeitung großer Mengen an Texten und Code benötigen. V4-Pro hingegen verfügt über insgesamt 1,6 Billionen Parametern und 49 Milliarden Aktivierungsparametern; es ist besser geeignet für kennzeichenreiche Aufgaben, komplexe Schlussfolgerungen, die Analyse langer Dokumente sowie anspruchsvolles Programmieren.
Beide wurden mit Daten im Umfang von über 32 T Token vorgetrainiert und verwenden eine gemischte Aufmerksamkeitsarchitektur, um die Rechenausgaben sowie die Speicherkosten für Kontexte in der Größenordnung von Millionen zu senken.
„Pro eignet sich auf jeden Fall für alle Aufgaben“ ist nicht korrekt. Für einfache Fragen und Antworten, Klassifizierungen, Datenauswertungen sowie für Anwendungen mit hohem Durchsatz ist Flash in der Regel kostengünstiger.
Für komplexe Untersuchungen oder schwierigen Code wechseln Sie auf Pro.
Think Max verbraucht mehr Rechen- und Ausgabetoken. Die offiziellen Anleitung zur lokalen Installation empfehlen außerdem, für diesen Modus mindestens 384 K an Kontextspeicher bereitzustellen. Daher eignet er sich nicht als Standardmodus für alle Anfragen.
Kostenloses Nutzen und API-Preise
Die Webversion von DeepSeek sowie die offizielle App können derzeit kostenlos genutzt werden. Im Apple App Store wird die offizielle App als „kostenlos“ gekennzeichnet, wobei keine In-App-Käufe aufgeführt sind. Kostenlos bedeutet jedoch nicht unbegrenzte Ressourcen: In Zeiten hoher Belastung kann es zu Wartezeiten kommen. Zudem können Suchfunktionen, Bilderkennung, Dateiuploads, die Länge der Gespräche sowie die Anzahl der erneuten Erstellung von Nachrichten durch Kontrollmechanismen oder Kapazitätsbeschränkungen eingeschränkt sein.
Die Behörden haben keine Verpflichtung zugesagt, eine unbegrenzte Nutzung für Endverbraucher sicherzustellen; die tatsächliche Grenze richtet sich nach der Anzeige im Account-Interface.
API und kostenloser Chat sind zwei separate Produkte. Entwickler müssen eine eigene API-Key erstellen und diese aufladen; die Gebühren werden nach den eingegebenen und ausgegebenen Tokens berechnet.
Der derzeit offiziell angegebene Preis wird in Millionen von Tokens ausgedrückt:
| Paket oder Version | Preise, Limits und Kernvorteile |
|---|---|
| V4-Pro | Bei einem Cache-Hit beträgt die Kosten 0,025 Yuan, bei einem Cache-Miss 3 Yuan; die Ausgabekosten betragen 6 Yuan. |
| Pro | V4-Pro: Cache-Hit – Eingabe 0,025 Yuan, Cache-Miss – Eingabe 3 Yuan, Ausgabe 6 Yuan. |
Die offizielle Konkurrenzbeschränkung für V4-Flash beträgt 2500, für V4-Pro 500; in beiden Fällen liegt der Kontextwert bei 1 Million Tokens.
Die Behörden haben darauf hingewiesen, dass geplant ist, die API-Preise insgesamt anzuheben – und zwar in erheblichem Maße. Daher dienen diese Zahlen nur als Orientierungshilfe bei der Überprüfung. Vor dem offiziellen Start sollten die aktuellen Preise in der Konsole abgefragt werden.
Wenn sowohl ein aufladbarer Saldo als auch ein kostenloses Guthaben vorhanden sind, wird zuerst das kostenlose Guthaben abgezogen. Der kostenlose Betrag kann nicht in einen API-Saldo umgewandelt werden.
API und Zugang für Entwickler
Die DeepSeek-API bietet das für OpenAI kompatible Chat-Completions-Format sowie eine Schnittstelle im Anthropic-Format. Die vorhandenen SDKs müssen in der Regel nur durch Anpassung der Schlüsselwerte, des Modellnamens und der Service-Adresse integriert werden. Die aktuellen offiziellen Modelle heißen deepseek-v4-flash und deepseek-v4-pro.
Die alten Versionen deepseek-chat und deepseek-reasoner wurden am 24. Juli 2026 nicht mehr verwendet; die Modellnamen in den alten Anleitungen müssen aktualisiert werden.
V4-Flash unterstützt derzeit die Responses-API; die Unterstützung für Responses bei V4-Pro richtet sich nach den neuesten Dokumentationen. Beide Modelle unterstützen Denkmodus und Nicht-Denkmodus, JSON-Ausgabe sowie Aufrufe von Tools. Es können jedoch Kompatibilitätsbeschränkungen zwischen dem Denkmodus und der erzwungenen Auswahl eines bestimmten Tools bestehen.
Bei der Erstellung von LangChain, Code-Proxys oder strukturierten Ausgabe-Prozessen sollten Regressionstests anhand der tatsächlichen Parameter durchgeführt werden. Man darf nicht einfach davon ausgehen, dass sich alle Felder aufgrund der „Kompatibilität mit OpenAI“ genauso verhalten.
Open-Source-Zustand und lokale Bereitstellung
Die offiziellen Gewichte für DeepSeek-V4-Pro, V4-Flash sowie ihre Basisversionen sind jetzt veröffentlicht; die Modellkarten verwenden diese Gewichte eindeutig.MIT-LizenzDie Gesamtparameter von V4-Pro betragen etwa 1,6 T, bei V4-Flash sind es etwa 284 B. Offiziell werden Gewichte in den Präzisionsstufen FP8 sowie eine Mischung aus FP4 und FP8 bereitgestellt. Zudem werden Anleitungen zur Nutzung von Tools wie Transformers, vLLM und SGLang zur Implementierung gegeben.
R1, V3, Coder, VL, OCR sowie mehrere Projekte zur Trainingsinfrastruktur sind ebenfalls in der offiziellen Community verfügbar, doch die Lizenzbedingungen sollten für jeden Repo separat überprüft werden.
„Open-Source-Gewichte“ bedeuten nicht, dass ein herkömmlicher Computer das vollständige Modell problemlos ausführen kann. Selbst bei niedriger Präzision benötigen V4-Flash und insbesondere V4-Pro viel Speicher, Arbeitsspeicher sowie die Möglichkeit zur parallelen Verarbeitung über mehrere Karten; zudem erhöht ein Kontextumfang von Millionen die KV-Cache-Größe erheblich.
Privatnutzer eignen sich in der Regel besser für die offizielle kostenlose Version, APIs oder zuverlässige Hosted-Inferenzdienste; vor dem Herunterladen von Quantisierungsmodellen sollte man die Quelle, den Genauigkeitsverlust, die Lizenzbedingungen sowie die Hardwareanforderungen überprüfen.
Man muss auch zwischen den offiziellen Modellgewichten, dem Forschungskodex sowie den DeepSeek-Online-Produkten unterscheiden: Chatsites, Account-Systeme, Suchfunktionen im Internet, Sicherheitsmechanismen für Inhalte sowie Cloud-basierte Inferenzplattformen werden nicht als vollständige Anwendungen unter Open Source bereitgestellt. Eine genauere Bezeichnung im Verzeichnis lautet: „Die Kernmodellgewichte sind unter Open Source verfügbar, während die Online-Produkte und Hosting-Dienste nicht unter Open Source liegen.“
Unterstützungsplattformen
DeepSeek bietet Web, iPhone, iPad, Android und API an. Die App für Apple in China erfordert derzeit iOS oder iPadOS 15.0 oder neuer und unterstützt mehrere Sprachen;
Die offizielle Android-App ist ebenfalls für Smartphones und Tablets verfügbar.
Beim Herunterladen sollte man überprüfen, dass der Entwickler Hangzhou Deep Exploration ist, um Drittanbieter-Apps mit ähnlichen Namen, die eine zusätzliche Abonnementgebühr verlangen oder zu viele Berechtigungen einfordern, zu vermeiden.
DeepSeek-Anleitung
Eine grundlegende Aufgabe erledigen
- Registrieren Sie DeepSeek und erstellen Sie einen API-Schlüssel, der ausschließlich für die Testumgebung verwendet wird;
- Wählen Sie das Modell entsprechend der Eingabetypen, des Kontexts, der Qualität, der Geschwindigkeit und des Preises aus;
- Rufen Sie zunächst den allgemeinen AI-Dialog auf, um die minimale Anfrage abzuschließen und die zurückgegebene Struktur zu überprüfen;
- Prüfen Sie anschließend die Flussausgabe, Parameter und Fehlerreaktionen durch tiefgehende Überlegungen;
- Protokollieren Sie Tokens, Anrufanzahl, Verzögerung, Fehlerrate und Kosten pro Aufruf;
- Tragen Sie den Schlüssel in den Server-basierten Schlüsselmanager ein, bevor Sie die eigentliche Anwendung anschließen;
Erstellung wiederverwendbarer professioneller Workflows
- Für die Entwicklungs-, Test- und Produktionsumgebungen werden unterschiedliche Schlüssel und Limits verwendet;
- Ein repräsentatives Bewertungssatz wird auf der Grundlage von allgemeinen AI-Gesprächen, tiefgehender Analyse und vernetzten Suchfunktionen erstellt;
- Einstellen von Timeout, Konkurrenz, Wiederholungsversuchen, Limitierung sowie Budgetobergrenzen;
- Durchführung von Überprüfungen hinsichtlich Fakten, Sicherheit, Formatierung und sensibler Informationen am Ausgangsinhalt;
- Überwachung von Änderungen bei Modellversionen, Preisen, Verzögerungen und Ausfallraten;
- Vorbereitung von Plänen für die Herabstufung des Modells, Schutzmaßnahmen sowie manuelle Übernahme.
Für welche Benutzer geeignet
- Einfache Nutzer, die kostenlose chinesischsprachige Fragen beantwortet haben, Texte schreiben, übersetzen, im Internet suchen sowie Lernmaterialien erhalten möchten;
- Studenten und Wissensarbeiter, die wissenschaftliche Arbeiten, Berichte, Screenshote sowie lange Dokumente lesen müssen;
- Entwickler, die Codegenerierung, Repository-Analyse, Debugging sowie Agent-Workflows benötigen;
- Teams und Unternehmen, die zu geringen Token-Kosten auf langformatige Kontextmodelle zugreifen möchten;
- Einrichtungen mit Mehrkarten-Hardware, die Open-Weight-Modelle erforschen, feinjustieren oder privat einsetzen möchten.
Einsatzbeschränkungen und Sicherheitshinweise
- DeepSeek kann Halluzinationen, veraltete Informationen, erfundene Zitate und Rechenfehler liefern;
- Suchen im Internet kann nur die Schnelligkeit erhöhen, nicht aber die Richtigkeit der Ergebnisse garantieren.
- Medizinische, rechtliche, finanzielle sowie politische Angaben sowie wissenschaftliche Zitate müssen von Fachleuten oder aus den ursprünglichen Quellen überprüft werden.
- Auch ein langer Kontext bedeutet nicht, dass das Modell jeden Detail unverfälscht behalten kann; wichtige Zahlen, Bedingungen und Tabellen über mehrere Seiten hinweg sollten separat überprüft werden.
- Bevor Verträge, Lebensläufe, Quellcode, Kundendaten, Fotos und Audiodateien hochgeladen werden, sollten unerwünschte Personalausweisnummern, Schlüsselwörter, Geschäftsgeheimnisse sowie persönliche Informationen zuerst entfernt werden.
- Apples Datenschutzmitteilung gibt an, dass die App möglicherweise grobe Standortangaben, Kontaktdaten, Benutzerinhalte, Suchhistorien, Gerätedaten sowie Nutzungs- und Diagnosedaten verarbeiten kann;
- Bei sensiblen Geschäftsaktivitäten eines Unternehmens sollten der Standort der Datenspeicherung, die Aufbewahrungsfrist, die Löschmechanismen sowie die internen Konformitätsanforderungen bewertet werden.
- Eine lokale Implementierung erhöht zwar die Kontrolle über die Daten, überträgt aber gleichzeitig die Verantwortung für das Herunterladen der Modelle, die Lieferkette, die Zugriffskontrolle, die Protokollierung, die Behebung von Sicherheitslücken sowie die Einhaltung von Inhaltsvorgaben auf den Betreiber.
- Offenlegung der Gewichte bedeutet nicht, dass die Ergebnisse nicht rechtlich gebunden sind, und sie gewährt Dritten auch nicht automatisch Rechte an Marken, Personendarstellungen, Datensätzen oder generierten Inhalten.
Häufige Fragen
Ist DeepSeek kostenlos?
Die offizielle Website und die App sind derzeit kostenlos, es gibt keine offiziellen In-App-Käufe für Mitglieder; die API wird separat nach Token abgerechnet.
Die kostenlose Version kann weiterhin mit langen Warteschlangen, begrenzten Funktionalitäten sowie Kontrollmechanismen verbunden sein.
Was ist das neueste Modell von DeepSeek?
Die aktuelle offizielle Hauptversion ist DeepSeek-V4, einschließlich V4-Pro und V4-Flash. Die offizielle API-Version von V4-Flash wurde am 31. Juli 2026 für die öffentliche Beta-Testung veröffentlicht;
Es gibt noch keine offiziellen Informationen zu R2.
Unterstützt DeepSeek Bilder und Dateien?
Unterstützung. Die offizielle App bietet bereits einen Bilderkennungsmodus und optimiert kontinuierlich den Upload von Bildern und Dateien;
Es kann zur Bildverarbeitung, zum Extrahieren von Texten, zur Zusammenfassung von Dokumenten und zur Stellung weiterer Fragen verwendet werden, ist aber kein professionelles Werkzeug zur Erstellung von Bildern oder Videos.
Ist DeepSeek open source?
Die Gewichte von V4-Pro, V4-Flash und Base werden unter der MIT-Lizenz veröffentlicht, und auch für Modelle wie R1 und V3 gibt es offizielle Open-Source-Repositorys; Webseiten, Apps, Suchfunktionen sowie Cloud-Plattformen sind jedoch keine vollständig open source.
Wie viel kostet die DeepSeek API?
Derzeit beträgt die Kosten pro Million Token: Für V4-Flash sind es 0,02 Yuan bei einem Treffer im Cache, 1 Yuan bei keinem Treffer sowie 2 Yuan für die Ausgabe; für V4-Pro sind es jeweils 0,025 Yuan, 3 Yuan und 6 Yuan.
Die Behörden haben bereits mit erheblichen Preisanpassungen gerechnet; vor dem Anschluss muss dies noch einmal bestätigt werden.
Kann ein gewöhnlicher Computer V4 lokal ausführen?
Das vollständige V4-Modell ist sehr groß und erfordert in der Regel professionelle Server mit mehreren Karten. Persönliche Computer können nur versuchen, quantisierte oder zerlegte Versionen des Modells zu verwenden – oder kleinere „Distillation“-Modelle. Dadurch müssen Kompromisse in Bezug auf Geschwindigkeit, Kontext oder Leistung eingegangen werden.
Tools, die dem DeepSeek ähneln


 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164