




Complexity AI
Complexity AI – macht KI effizienter und sorgt dafür, dass die Arbeit einfacher wird.
Tags:Steigerung der Effizienz durch KIWas ist Complexity AI?
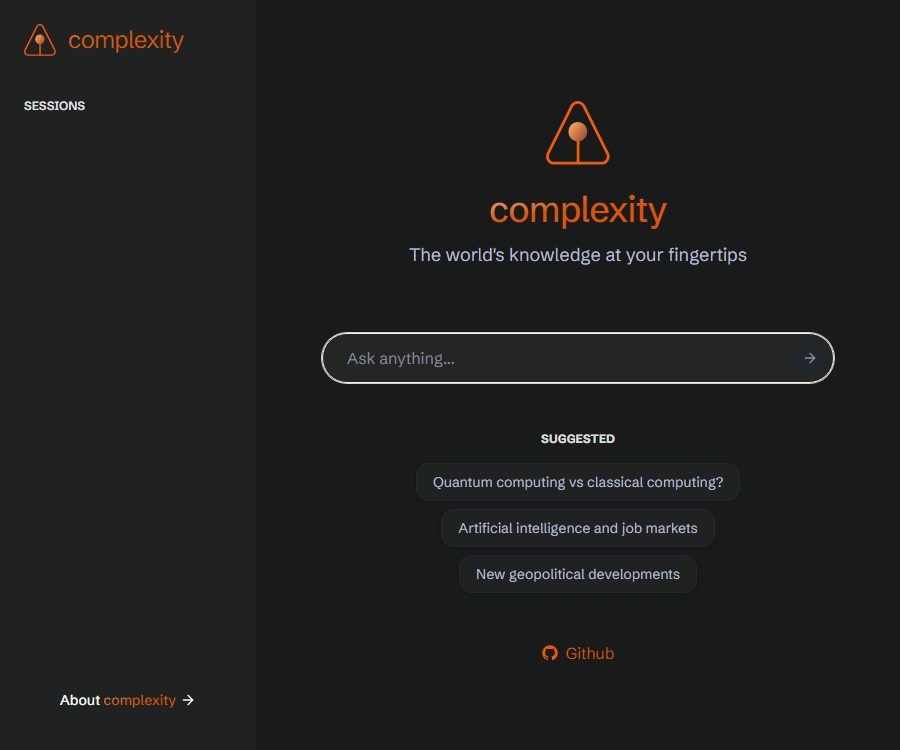
Complexity AI ist eine Web-AI-Suchmaschine, die von Emil Ahlbäck und Hamed Mohammadpour entwickelt wurde. Ihr Ziel ist es, Fragen in natürlicher Sprache zu beantworten und relevante Webseiteninhalte anzuzeigen. Sie basiert auf den Chat-Fähigkeiten von Cohere sowie einem Connector für die Suche in Webseiten und positioniert sich als vereinfachtes Tool zur Beantwortung von Fragen im Internet.
Dieser Eintrag bezieht sich auf die Suchplattform Complexity AI sowie deren Code-Repository des FOLLGAD-Teams – es handelt sich dabei nicht um die gleichnamige Erweiterung für Browser namens Perplexity. Die Entwickler, Webseitenadressen, Funktionen sowie Lizenzbedingungen unterscheiden sich bei beiden.
Hauptfunktionen
Vernetzte Fragen und Antworten
- Der Benutzer gibt eine Textfrage auf der Webseite ein; das System führt zunächst eine Suche in der Webseite durch und erstellt anschließend mit einem Modell eine prägnante Antwort in natürlicher Sprache.
- Die Antworten werden schrittweise in Fließtextform angezeigt, was geeignet ist, um Konzepte schnell zu verstehen, Themen zu vergleichen oder allgemeine Informationen nachzuvollziehen.
- Die Standardkonfiguration für den öffentlichen Code sind die Cohere Command R-Serie-Modelle, doch die tatsächlich eingesetzten Modelle können über Umgebungsvariablen auf der Serverseite angepasst werden.
Suche nach Dokumenten und Absatzzitaten
- Die Suche nach Verbindern liefert relevante Dokumente. Auf der Ergebnisseite werden die Titel der gefundenen Dokumente in Form von Karten angezeigt, und im Antworttext wird der Referenzbereich markiert.
- Der Benutzer kann das Dokument ansehen, das zu einem bestimmten Textabschnitt gehört, um festzustellen, ob die Antwort durch die gefundenen Materialien gestützt wird.
- Das Zitieren bedeutet nicht, dass die Schlussfolgerung zwangsläufig richtig ist; es muss weiterhin das Datum, der Kontext und die Glaubwürdigkeit der ursprünglichen Seite überprüft werden.
Anhaltende Nachfragen und Vorschlagsfragen
- In derselben Sitzung können weiterhin Fragen eingegeben werden; der Server stellt dem Modell die bisherigen Fragen und Antworten als Chat-Geschichte zur Verfügung.
- Nach jedem Durchgang kann das System auf der Grundlage der aktuellen Sitzung automatisch bis zu drei kurze Nachfragen erzeugen.
- Lange Gespräche können aufgrund eines begrenzten Kontexts des Modells frühe Details verlieren; wichtige Bedingungen sollten bei Nachfragen erneut dargelegt werden.
Sitzungsprotokolle und Teilen
- Der Browser speichert die Liste der Sitzungen lokal, um das Zurückkehren zu früheren Fragen und Antworten zu erleichtern.
- Der Servercode schreibt gleichzeitig Probleme, Antworten, Benutzeridentifikatoren, Verweise sowie Dokumentinformationen in die Datenbank, um das Laden von Historie und den read-only-Teilen zu ermöglichen.
- Die Teilen-Funktion erzeugt eine nur zum Lesen geeignete Sitzungsebene. Vor dem Senden sollte überprüft werden, ob im Dialog persönliche, kundenspezifische oder interne Informationen enthalten sind.
Feedback und Nutzungsanalyse
- Die Ergebnisseite bietet Optionen für Zustimmung, Ablehnung und textbasierte Rückmeldungen, um Entwicklern dabei zu helfen, die Qualität der Antworten sowie die Funktionsanforderungen zu erfassen.
- Öffentliche Code-Integration von PostHog zur Erfassung von Ereignissen wie Seitenbesuche, Fragen, Antworten, Klicks, Feedback sowie anonym generierte Benutzeridentifikatoren.
- Die Website gibt keine offenen Informationen über den vollständigen Ablauf der Datenspeicherung und -löschung preis. Für sensible Anfragen sollte man sich nicht ausschließlich auf anonyme Identifikatoren als Schutz der Privatsphäre verlassen.
Eingabe und Ausgabe
| Projekt | Unterstützte Inhalte | Ergebnisform | Einschränkungen |
|---|---|---|---|
| Eingabe | Probleme mit Texten in natürlicher Sprache und fortlaufende Nachfragen | Einreichen im Web-Frage-Antwort-Verfahren | Keine Funktionen zur Hochladen von Dokumenten, Bildern oder Audiodateien vorhanden. |
| Suche | Das Modell ruft den Web-Suchverbindler auf, um Dokumente zu erhalten. | Suche nach Dokumentkarten und Zuordnung von Referenzen | Der Abdeckungsbereich und das Update-Zeitpunkt sind nicht öffentlich. |
| Antwort | Inhalt erstellen unter Einbeziehung von Fragen, Geschichte und Suchmaterialien | Fließender Markdown-Text | Es können Auslassungen, Veraltungen oder falsche Schlussfolgerungen auftreten. |
| Weitere Schritte | Nachfragen, Kopieren und Teilen, Qualitätsfeedback | Kontinuierliche Sitzungen und nur lesbare Seiten | Sitzungsdaten können lokal sowie auf der Serverseite gespeichert werden. |
Anwendungsmethode
- Öffnen Sie die Produktseite und geben Sie das konkrete Problem in das Eingabefeld ein. Bitte berücksichtigen Sie dabei das Thema, den Zeitraum sowie die gewünschte Ausgangsform.
- Warten Sie, bis das System die Suche auf der Webseite sowie die Erstellung der Antwort abgeschlossen hat. Schauen Sie sich zunächst die Karten mit den gefundenen Dokumenten an und überprüfen Sie anschließend die Quellenangaben zu den wichtigsten Aussagen.
- Verwenden Sie Empfehlungsfragen oder stellen Sie eigene Nachfragen, um zusätzliche Bedingungen zu klären. Falls nötig, fordern Sie den Vergleich verschiedener Ansichten oder eine Einengung des Zeitraums an.
- Prüfen Sie die Originaldokumente zu wichtigen Fakten, und betrachten Sie die erzielten Ergebnisse nicht direkt als medizinische, rechtliche, finanzielle oder andere fachliche Schlussfolgerungen.
- Bei der Zusammenarbeit können Lesesitzungen geteilt werden, wobei zunächst sensible Inhalte entfernt werden sollten und man sich bewusst sein muss, dass die Empfänger des Links den gesamten Dialog sehen könnten.
Passend für Nutzer und Szenarien
- Allgemeine Informationen abrufen: Erhalten Sie schnell einen Überblick über ein Thema in natürlicher Sprache und lesen Sie anschließend in den zitierten Materialien weiter.
- Ausgangspunkt für Lernen und Forschung: Kontinuierliches Nachfragen zu einem Konzept, Sortierung von Begriffen, Unterschieden und möglichen weiteren Forschungsrichtungen.
- Vorbereitung des Inhaltsthemas: Suche nach Hinweisen auf öffentlichen Webseiten sowie gängigen Ansichten, doch vor der Veröffentlichung muss die Richtigkeit der Informationen unabhängig überprüft werden.
- Entwickler lernen: Die Umsetzung von Next.js, Cohere, Web-Suche, fließender Antwort und Zitatenanzeige.
Hosted Services und eigenes Deployment
Auf der Produktseite werden weder Abonnements noch Punkte, Limits oder Unternehmenslösungen angegeben, und es wird auch keine dauerhafte kostenlose Nutzung zugesichert. Die Website bietet derzeit die Möglichkeit, direkt Fragen zu stellen, doch die Anzahl der nutzbaren Anfragen, die Konkurrenzbeschränkungen sowie die zukünftigen Gebühren sind derzeit noch nicht bekannt.
| Paket oder Version | Preis | Abrechnungszeitraum | Kernrechte oder -beträge | Für Nutzer geeignet |
|---|---|---|---|---|
| Offizielle Hosting-Webseite | Noch nicht veröffentlicht | Noch nicht veröffentlicht | Fragen auf der Webseite, Suchen nach Antworten, Zitieren sowie fortlaufende Sessions; die Limits sind nicht angegeben. | Benutzer, die eine direkte Erfahrung wünschen |
| Selbstständige Bereitstellung des Quellcodes | Der Preis der Software ist vorerst nicht bekannt. | Die Kosten für die Dienstleistungen müssen selbst getragen werden. | Es ist notwendig, Cohere, Datenbanken, Analyse-Dienste sowie die Bereitstellungsumgebung einzurichten. | Ein Team mit Fähigkeiten in der Entwicklung und im Betrieb. |
Eine eigene Implementierung kann außerdem Kosten für die Aufrufung von Modellen, Webseiten-Suchen, Datenbanken sowie Hosting- und Analyse-Dienste verursachen. Da das Repository keine Lizenz besitzt, muss vor der Implementierung, Änderung oder kommerziellen Nutzung eine angemessene Genehmigung bei den Rechteinhabern eingeholt werden.
Plattformen, APIs und Open-Source-Status
- Das Produkt wird in Form einer responsiven Website bereitgestellt; es gibt keine offizielle Mobile-App, Desktop-Client oder Browser-Erweiterung.
- Der Lagerbetreiber macht die internen Schnittstellen für Fragen, Antworten und Empfehlungen zugänglich, bietet jedoch keine stabile API, SDK, Authentifizierungsmechanismen oder Service-Level-Versprechen für Dritte.
- In einem Code-Repository kann man die technische Struktur einsehen und nachbilden, es liegen jedoch keine Lizenzdokumente vor; die Offenlegung des Quellcodes bedeutet nicht, dass eine Genehmigung zur Vervielfältigung, Änderung, Verbreitung oder kommerziellen Nutzung erteilt wird.
- Der Lagerbestand ist nicht archiviert, aber der letzte Code-Upload liegt im Dezember 2024. Das aktuelle Wartungstempo sowie der weitere Ablauf sind vorerst unklar.
Hinweise zu Privatsphäre, Sicherheit und Urheberrechten
- Eine öffentliche Implementierung speichert die Benutzeridentifikation im Browser selbst sowie eine lokale Kopie der Sitzung.
- Fragen, Antworten, Zitate und relevante Dokumente werden in die Datenbank auf der Serverseite geschrieben. Die Analysekomponenten können außerdem Ereignisse wie Seitenaufrufe, gestellte Fragen, gegebene Antworten sowie Feedbacks erhalten.
- Das Produkt verfügt weder über eine offizielle, unabhängige Datenschutzrichtlinie noch über Angaben zur Aufbewahrungsdauer, zum Verfahren zur Löschung von Daten, zu den Dienstbedingungen oder zu Sicherheitsanweisungen. Es eignet sich daher nicht zur Übermittlung vertraulicher, regulierter oder identifizierbarer personenbezogener Daten.
- Die Ergebnisse der Webseitensuche sowie die Antworten des Modells können urheberrechtlich geschütztes Material Dritter enthalten. Die Angabe von Quellen gewährt keine automatische Genehmigung zur Vervielfältigung oder kommerziellen Nutzung.
- Es gibt keine offiziellen Regeln für Rückerstattungen oder Verträge bezüglich der Zahlungen. Sollte in Zukunft eine Möglichkeit zur Abrechnung entstehen, sollten vor der Zahlung die Preise sowie die Bedingungen für Verlängerung, Stornierung und Rückerstattung überprüft werden.
Fähigkeitsgrenzen
- Es handelt sich um ein leichtes Tool für Online-Fragenbeantwortung – es ist keine überprüfte, professionelle Datenbank, und es gibt keinen offiziellen Suchumfang.
- Das Modell kann Webseiten falsch interpretieren, Zeiten verwechseln oder Aussagen ohne ausreichende Begründung erstellen; Zitate können zudem nur einen Teil eines Satzes unterstützen.
- Es ist nicht möglich zu bestätigen, ob die aktuelle Implementierung vollständig mit dem öffentlichen Repository übereinstimmt; die Stabilität der Modelle, der Datenverarbeitung und der Dienste kann sich je nach Umgebungskonfiguration ändern.
- Die Benutzeroberfläche verwendet hauptsächlich Englisch; für Eingaben und Antworten in anderen Sprachen gibt es keine garantierte Qualität.
Häufige Fragen
Was kann Complexity AI leisten?
Es nimmt Textfragen entgegen, sucht auf Webseiten und erzeugt in Echtzeit Antworten mit Karten zu den gefundenen Dokumenten sowie Zitaten aus Abschnitten. Zudem ist es möglich, im selben Gespräch weitere Fragen zu stellen.
Ist es ein offizielles Produkt von Perplexity?
Nein. Dieser Eintrag bezieht sich auf das eigenständige Suchprojekt Complexity AI und sollte nicht mit Perplexity oder der gleichnamigen Perplexity-Browsererweiterung verwechselt werden.
Ist Complexity AI kostenlos?
Die aktuelle Webseite bietet eine Möglichkeit, direkt Fragen zu stellen, gibt jedoch keine Informationen zu einer dauerhaften kostenlosen Nutzung, zu einer Obergrenze für die Anzahl der Fragen oder zu Zahlungsmöglichkeiten. Daher kann sie nicht als dauerhaft kostenloser Service bezeichnet werden.
Ist Complexity AI Open-Source-Software?
Das offizielle Repository hat den Quellcode veröffentlicht, hat jedoch keine Lizenz angegeben. Benutzer können den Code lesen, dürfen aber daraus nicht schließen, dass eine Genehmigung zur Modifikation, Verbreitung oder kommerziellen Nutzung vorliegt.
Wird eine API oder ein SDK bereitgestellt?
Der Projektcode enthält interne Frage-Antwort-Schnittstellen und nutzt das Cohere SDK, bietet jedoch keine stabile API oder offizielle SDKs zur Nutzung durch Dritte an.
Kann man sensible Informationen eingeben?
Es wird nicht empfohlen. Eine öffentliche Umsetzung würde die Sitzungen lokal sowie auf der Serverseite verarbeiten und Analysen ermöglichen, während die Seite bisher keine vollständigen Richtlinien bezüglich der Datenspeicherung, -löschung und -sicherheit bereitstellt.
Werkzeuge, die der Complexity AI ähneln



 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164