




ClearML
ClearML – ein intelligentes Tool, das sich auf die Steigerung der Effizienz in der KI konzentriert.
Tags:Steigerung der Effizienz durch KIWas ist ClearML?
ClearML ist eine End-to-End-MLOps- und LLMOps-Plattform für Teams im Bereich Machine Learning, generatives AI sowie Infrastruktur. Sie umfasst Funktionen für das Experimentenverfolgen, die Verwaltung von Daten und Modellversionen, Trainingsaufgaben, Pipelines, GPU-Steuerung, Modellservices sowie die Verwaltung von Enterprise-Deployment.
Die Plattform besteht aus drei Schichten: dem Infrastructure Control Plane, dem AI Development Center und dem GenAI App Engine. Die Nutzer können entweder die Hosted-Dienste von ClearML nutzen oder eigener Code verwalten. Zudem steht die Möglichkeit zur Anschaffung von kommerziellen Lösungen für VPCs, lokale Netzwerke, isolierte Umgebungen sowie hybride Umgebungen zur Verfügung.
Eine kurze Beschreibung
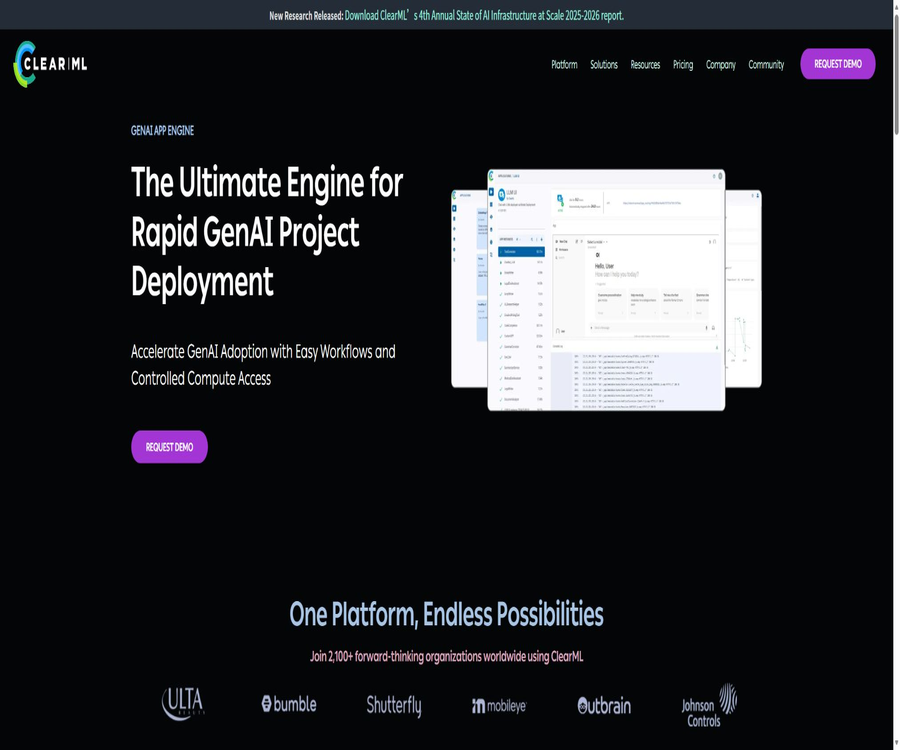
ClearML integriert KI-Experimente, Daten, Modelle, Rechenressourcen sowie Produktionsendpunkte in ein einheitliches Tracking-System und nutzt den GenAI App Engine, um Open-Source-Modelle oder angepasste große Modelle auf GPU-Clustern zu bereitstellen, wobei Netzwerk, Authentifizierung, Datenverkehr und Überwachung zentral gesteuert werden.
Dreischichtige Architektur der Plattform
| Plattformschicht | Hauptaufgaben | Für Teams geeignet |
|---|---|---|
| Infrastructure Control Plane | GPU-Ressourcen, Warteschlangen, Scheduling, automatische Skalierung und Verwaltung mehrerer Clustern | Plattformengineering, DevOps und IT |
| AI Development Center | Experimente, Daten, Training, Modelle, Pipelines und Zusammenarbeit | Datenwissenschaftler und Maschinenlerningenieure |
| GenAI App Engine | Einsatz von LLMs, RAG, KI-Agenten und generativen Anwendungen | LLM-Engineering, Anwendungsentwicklung und Geschäftsabteilungen |
| Platform Management Center | Management von Cross-Tenant-Aktivitäten, Nutzung und Kosten | Große Unternehmen und Dienstleister |
Hauptfunktionen
Experimentelle Verfolgung und Reproduzierbarkeit
Das ClearML Python SDK kann automatisch Versionen des Codes, ungespeicherte Änderungen, Abhängigkeiten, Parameter, Konsoleausgaben, Metriken sowie Systemressourcen aufzeichnen. Zudem unterstützt es Modelldatenbanken, Diagramme, Bilder, Audio- und Videodateien sowie alle Arten von Artefakten.
- Experimente, Modelle, Datensätze und Berichte werden nach Projekten und Unterprojekten organisiert.
- Vergleichen Sie Parameter, Kennzahlen, Umgebungen und Ausgaben mehrerer Ausführungen.
- Verknüpfung von Git-Versionen, Abhängigkeitspaketen und den tatsächlich ausgeführten Befehlen.
- Protokollierung von CPU, GPU, Temperatur, Festplatte, Netzwerk und anderen Betriebszuständen.
- Aus vorhandenen Experimenten können Remote-Aufgaben oder wiederverwendbare Vorlagen erstellt werden.
Versionierung von Datensätzen
Das ClearML-Datensatz-System bewahrt auf Basis von Object Storage differenzierbare Datenversionen sowie deren Herkunftsverhältnisse auf. Benutzer können Daten in S3, Google Cloud Storage, Azure, NAS oder gemeinsam genutztem Speicher platzieren und diese im Code nach Versionen abrufen.
Modellwarenhaus und Genealogie
Das Modellarchiv verwaltet zentral Modelldateien, Zustände, Tags, Projekte und Metadaten und verknüpft die Modelle mit den Experimenten, aus denen sie entstanden sind. Das Team kann aufgrund der Veröffentlichung eines Modells oder von Zustandsänderungen weitere Aktionen auslösen.
Aufgabenwarteschlange und ClearML Agent
Der ClearML Agent holt Aufgaben von lokalen Servern, Cloud-Hosts, Containern oder Kubernetes ab und führt sie unter Verwendung des gespeicherten Codes sowie der entsprechenden Umgebung aus. Die Warteschlange sowie die Arbeitsknoten ermöglichen es den Entwicklern, nicht manuell auf GPU-Servern einzuloggen, um jedes Experiment durchzuführen.
Fließband und Automatisierung
Benutzer können die Schritte der Datenverarbeitung, des Trainierens, der Bewertung und Veröffentlichung zu einer anpassbaren Pipeline zusammenfassen. Zudem können auf Basis von Datensätzen Aufgaben erstellt werden, Modelle veröffentlicht oder Aktionen bei Änderungen der Kennzahlen ausgelöst werden. Community verfügt über eine grundlegende Pipeline, während Pro zusätzliche Trigger sowie eine automatisierte Benutzeroberfläche bietet.
Automatische Erweiterung und Verkleinerung von Cloud-Ressourcen
Pro ermöglicht es, Rechenressourcen je nach Bedarf in AWS, Google Cloud und Azure zu starten oder zu deaktivieren. Scale und Enterprise bieten zudem schedulerunabhängige Verwaltung, mehrere Clustern, Ressourcenstrategien sowie eine feingranuliertere Steuerung von GPUs.
Entfernte Entwicklung und Anwendung
Das kostenpflichtige Paket bietet eine Fernsteuerung des IDEs sowie ClearML-Anwendungen, um interaktive Entwicklungsumgebungen, Dashboards oder Geschäftsanwendungen auf verwalteten Rechenressourcen auszuführen. Für Anwendungsinstanzen können zusätzliche Gebühren pro Laufstunde anfallen.
Funktionen von GenAI App Engine
Einfache Einrichtung von LLM mit einer Klickweise
GenAI App Engine ermöglicht es, aus den Modellrepositorien von Hugging Face oder ClearML open-source-Modelle, maßgeschneiderte Modelle oder angepasste Modelle auszuwählen und diese über eine Benutzeroberfläche oder die CLI zu deployen. Auf der offiziellen Website werden Dienstplattformen wie vLLM, Llama.cpp und Triton aufgeführt.
Sicherheitsmodell-Endpunkte
Die Plattform erstellt für die nach der Bereitstellung verfügbaren Modelle zertifizierte Endpunkte und kümmert sich um das Netzwerk, die Zugriffskontrolle sowie die Routenverwaltung des Datenverkehrs. Unternehmen können mithilfe von RBAC festlegen, welche Modelle und Daten von welchen Teams, Anwendungen und Geschäftseinheiten aufgerufen werden dürfen.
Dynamische Routing und horizontale Skalierung
Anfragen können dynamisch zwischen Modellkopien und Rechenknoten umgeleitet werden und je nach Lastlevel skalieren. Dadurch kann die verfügbare Kapazität in Spitzenzeiten erhöht und bei geringer Last ungenutzte GPUs eingespart werden.
Einheitliche Speicherlösung und Kosteneinsparung
Die von ClearML vorgestellte Unified Memory bewahrt inaktive Modelle im CPU-Speicher auf und freiert so Speicherplatz für aktive Modelle auf der GPU. Die tatsächliche Einsparung hängt von der Größe des Modells, dem Speicher des Nodes, der Startzeit sowie dem Aufrufmuster ab.
Endpunktüberwachung
Der Administrator kann die Anzahl der Anfragen, die Verzögerungen sowie die Ressourcen wie CPU, GPU, Speicher, Eingabe/Ausgabe und Netzwerkressourcen einsehen. Für den Produktivbetrieb sollten zudem Anzeiger auf der Anwendungs Ebene hinzugefügt werden, wie die Qualität des Services, die Fehlerrate, Sicherheitsaspekte sowie Nutzerfeedback.
RAG und Vektor-Datenbanken
Der GenAI App Engine unterstützt die Abfrageverbesserung bei generativen Workloads. Scale und Enterprise bieten Integrationen mit Hyper-Datasets sowie Vektordatenbanken. Teams können eingebettete Modelle bereitstellen und Dokumentverarbeitung, Indexierung, Abfragen sowie -antworten in einem Workflow organisieren.
KI-Agenten und benutzerdefinierte Anwendungen
Die Plattform kann KI-Agenten einsetzen, um deren Aufrufe und Leistung zu überwachen, sowie angepasste Startanleitungen und Benutzeroberflächen für interne Nutzer erstellen. Custom Apps gehören zu den Enterprise-Funktionen; herkömmliche Open-Source-Komponenten sowie Hosting-Pakete sollten nicht standardmäßig als vollständig enthalten angesehen werden.
Vollständiger MLOps-Arbeitsablauf
- Wählen Sie einen Hosting-Service oder erstellen Sie einen ClearML Server und legen Sie Arbeitsbereichsanmeldeinformationen an.
- Installieren Sie das Python SDK und initialisieren Sie die ClearML Task im Trainingscode.
- Führen Sie kleine Experimente durch, um zu überprüfen, ob Code, Parameter, Kennzahlen, Modelle und Produkte vollständig dokumentiert sind.
- Ordnen Sie die Daten zu datenbasierten Datensätzen mit Versionen und konfigurieren Sie die Objektspeicherung sowie Zugriffsrechte.
- Erstellen Sie Agenten und Warteschlangen, um Trainingsaufgaben remote auf angegebenen CPU- oder GPU-Ressourcen auszuführen.
- Setzen Sie die Vorkonvertierung, das Training, die Bewertung und die Registrierung des Modells zu einem Pipeline zusammen.
- Die zur Veröffentlichung bereitstehende Version wird über das Modell-Repository freigegeben und auf dem Test-Endpoint bereitgestellt.
- Leistung, Sicherheit und Rollback überprüfen, bevor in die Produktion übergegangen wird; kontinuierliche Überwachung der Ressourcen und der Leistung des Modells.
Anleitung zur Verwendung
Anschluss an das erste Python-Experiment
- Erstellen Sie eine ClearML-Werkstatt und generieren Sie Zugangsdaten.
- Installieren Sie das ClearML-Python-Paket in der Entwicklungsumgebung.
- Führen Sie clearml-init aus und verbinden Sie das SDK mit dem Zielserver.
- Erstellen Sie am Eingang des Codes eine Aufgabe und geben Sie den Projektnamen sowie den Namen der Aufgabe an.
- Führen Sie das Trainingsskript aus, um zu überprüfen, ob Konsole, Parameter, Metriken und die Überwachung der Ressourcen automatisch angezeigt werden.
- Laden Sie ein Testmodell und ein Produkt hoch und überprüfen Sie, ob es von der Aufgabenseite aus nachverfolgt werden kann.
- Nach Überprüfung, dass keine sensiblen Umgebungsvariablen oder Schlüssel aufgezeichnet wurden, kann mit dem eigentlichen Projekt begonnen werden.
Ein LLM-Endpoint bereitstellen
- Registrieren Sie GPU-Node in einem verwalteten Cluster und erstellen Sie separate Warteschlangen für Inferenzaufgaben.
- Wählen Sie den Modellkanal aus und überprüfen Sie die Gewichtslizenz, die Anforderungen an den Arbeitsspeicher sowie die Quantifizierungsweise.
- Wählen Sie vLLM, Llama.cpp, Triton oder einen Service-Engine, der zum Modell passt.
- Einstellen von GPU, CPU, Speicher, Kopien, Skalierungsbereich und Inaktivitätsstrategie.
- Konfigurieren von Authentifizierung, RBAC, Netzwerkzugängen sowie den Nutzern oder Diensten, deren Zugriff erlaubt ist.
- Überprüfen Sie mit Testanfragen die Ausgabe, Verzögerungen, Konkurrenz, Fehler und Ressourcennutzung.
- Einstellen von Überwachung und Alarmen, anschließend schrittweise Freigabe für die Produktivnutzung über grauen Traffic.
Einen selbst gehosteten Server aufbauen
- Vorbereiten Sie einen eigenständigen Host oder eine Kubernetes-Umgebung und lesen Sie zunächst die entsprechenden Deployment-Dokumente für die jeweilige Version.
- Planen Sie Netzwerke, Domainnamen, Zertifikate und Speicher für Web-, API- und Dateidienste.
- Implementieren Sie den ClearML Server-Komponenten und erstellen Sie zuverlässige Datenverzeichnisse sowie Backups.
- Schließen Sie unerwünschte öffentliche Zugänge und konfigurieren Sie Anmeldeauthentifizierung sowie minimale Berechtigungen.
- Verbinden Sie das SDK mit dem internen Server des Agents und führen Sie Testaufgaben ohne sensible Daten aus.
- Überprüfung der Wiederherstellung von Backups, des Upgrade-Prozesses, der Aufbewahrung von Protokollen sowie des Schlüsselwechsels.
- Migrieren Sie weitere offizielle Experimente, Modelle und Daten und aktualisieren Sie kontinuierlich die Sicherheitspatches.
Für welche Benutzer geeignet
- Einzelne Forscher und Universitätsteams: Kostenlose Hosting-Lösungen oder eigenes Hosting für die Verwaltung von Experimenten sowie für die Speicherung von Datenversionen.
- Maschinelles-Learning-Ingenieur: Verwaltung von Trainingsaufgaben, Modellen, Daten und reproduzierbaren Umgebungen.
- MLOps-Team: Aufbau von Pipelines, Fernausführung, Automatisierung und Veröffentlichungsprozesse für Modelle.
- LLM-Engineer: Implementierung von Open-Source- oder angepassten Modellen, RAG und KI-Agenten.
- Plattform-Entwicklerteam: Zentrale Steuerung der GPU-Ressourcen lokal, in der Cloud und in Kubernetes.
- Große Unternehmen: Betrieb von KI-Plattformen in VPCs, lokalen Netzwerken, isolierten Netzwerken oder hybriden Umgebungen.
- AI-Dienstleister: Verwendung von Funktionen zur Multitenant-Verwaltung, zur Kontrolle des Verbrauchs, der Quoten sowie der Kosten.
Typische Anwendungsszenarien
- Tracking von Deep-Learning-Experimenten und Vergleich von Parametern, Metriken und Code-Differenzen.
- Übertragen Sie das Training von dem Notebook auf die entfernte GPU-Queue.
- Erhaltung von Datensätzen, Modellversionen und vollständiger Herkunftsverfolgung.
- Die Pipeline wird automatisch nach einem Datenupdate oder der Veröffentlichung des Modells ausgeführt.
- Einsatz von internen großen Modelldiensten und Kontrolle des Zugriffs nach Team.
- Für die Unternehmens-Wissensdatenbank werden Workflows für Dokumentverarbeitung, vektorbasierte Suche und RAG-Antworten erstellt.
- Erweitern oder verkleinern Sie auf Anfrage Replikas zur Lastverteilung und überwachen Sie die GPU-Nutzung.
- In einem isolierten Netzwerk werden AI-Arbeitsschichten ausgeführt, die das Senden von Daten nach außen nicht zulassen.
Vorteile des Produkts
- Von Experimenten bis hin zu Modell-Diensten – eine umfassende Abdeckung, die die Kombination mehrerer separater Tools reduziert.
- Python-Code benötigt in der Regel nur geringfügige Anpassungen, um automatisch umfangreiche Ausführungsdaten aufzunehmen.
- Unterstützung für gehostete, selbst gehostete, VPC-, lokale, isolierte Netzwerke sowie hybride Implementierungen.
- Der ClearML Agent kann Aufgaben auf Bare-Metal-Systemen, in der Cloud und mit Kubernetes wiederholen.
- GenAI App Engine vereint den Modell-Engine, das Netzwerk, die Authentifizierung, die Routing-Funktionen sowie die Überwachung in einer einzigen Plattform.
- Offene SDKs, Agenten, Serverkomponenten und Web-Komponenten zur Erleichterung der Audits und Erweiterungen.
- Das Community-Hosting-Angebot ist für Teams von bis zu 3 Personen kostenlos und beinhaltet eine klare Grundmenge.
- Enterprise bietet fortgeschrittene Scheduling-Funktionen, Quoten, RBAC, LDAP sowie professionelle Dienstleistungen.
Einsatzbeschränkungen und Hinweise
- ClearML ist kein konfigurationsfreier Chatbot – seine Einrichtung und Wartung erfordern Kenntnisse in Python, Containern, Netzwerken und GPUs.
- Kostenloser Hosting-Service ist nur für Teams mit bis zu 3 Personen geeignet und unterliegt Beschränkungen hinsichtlich Speicherplatz, Metriken-Ereignisse sowie API-Aufrufe.
- Pro wird nach Sitzplätzen abgerechnet; ab dem überschrittenen Kapazitätslimit fallen zusätzlich Gebühren für Speicher, Metriken, Aufrufe und Anwendungsstunden an.
- Für Scale und Enterprise gibt es keine offiziellen Festpreise; die Kosten hängen von der Größe der GPU sowie von den Anforderungen bezüglich Implementierung und Support ab und müssen daher individuell angefragt werden.
- Alle Unternehmensfunktionen von GenAI App Engine sind nicht in Community oder Pro enthalten.
- Selbstverwaltung bedeutet, dass man selbst für die Datenbanken, den Objektspeicher, die Backups, Updates, die Authentifizierung, Zertifikate sowie Sicherheitspatches verantwortlich ist.
- Die automatische Aufzeichnung von Experimenten kann versehentlich Codeunterschiede, Parameter, Pfade oder sensible Informationen in der Konsole erfassen.
- Dritte Modelle und Datensätze unterliegen weiterhin ihren jeweiligen Lizenzen sowie Datenschutz- und Exportbeschränkungen.
- Dynamische Skalierung und CPU-Entlastung erfordern ein Abwägen zwischen Kosten, Durchsatz und Verzögerungen beim Neustart.
- Die Überwachung der Modellendpunkte bedeutet nicht, dass die Qualität, Sicherheit und Konformität der Ausgabe bereits gewährleistet sind.
- Verschiedene Code-Repositories verwenden unterschiedliche Lizenzen wie Apache-2.0 und SSPL und können nicht mit einem einzigen Label zusammengefasst werden.
- Die offizielle Website bezeichnet die Self-Hosting-Lösung als 100 % Open Source, doch tatsächlich wird SSPL v1.0 verwendet; vor dem Kauf und der Verteilung sollte jede Lagerstätte überprüft werden.
Preise und Pakete
Die unten angegebenen Preise wurden am 21. August 2026 überprüft; die Währung ist der US-Dollar. Das ClearML AI Development Center bietet die Versionen Community und Pro an. Für private Umgebungen werden Scale oder Enterprise verwendet. Die selbst gehostete Software kann kostenlos eingesetzt werden, doch die Kosten für Infrastruktur und Wartung liegen beim Nutzer.
| Paket | Preis | Team oder Größe | Kernlimit | Passende Szenarien |
|---|---|---|---|---|
| Community Hosted | 0 Dollar, keine Kreditkarte erforderlich | Maximal 3 Personen | 100 GB Produkt, 1 GB Kennzahl-Ereignis, 1 Million API-Aufrufe pro Monat | Einzelpersonen, Forschung, Hochschulen und kleine Teams |
| Pro Hosted | 15 US-Dollar/Benutzer/Monat plus Gebühr für die zusätzliche Nutzung | Maximal 10 Personen | 120 GB Produkt, 1,2 GB Kennzahl-Ereignisse, 1,2 Millionen API-Aufrufe pro Monat | Teams, die eine automatische Skalierung sowie fortschrittliche Automatisierung benötigen |
| Scale | Individuelle Kostenschätzung | 8 bis 48 GPU, VPC | Gemäß Vertrag | Organisationen, die Vektoren, Kubernetes, SSO sowie Kontrolle über die Infrastruktur benötigen |
| Enterprise | Individuelle Kostenschätzung | Mehrere große Projekte | Gemäß Vertrag | Lokal, VPC, isolierte Netzwerke, Multi-Cloud oder hybride Deployment |
| Self-hosted | Für die Softwarelizenz wird kein Abonnementgebühr erhoben. | Selbstplanung | Begrenzt durch eigene Hardware und Speicher | Teams, die bereit sind, die Wartung selbst zu übernehmen |
Preis für zusätzliche Mengen
| Abrechnungsposten | Enthält Limit | Über dem Preis |
|---|---|---|
| Artifact Storage | 120GB | Für jeden zusätzlichen 1 GB werden 0,10 US-Dollar berechnet. |
| Metric Events | 1.2GB | Für jede zusätzliche 1 MB werden 0,01 US-Dollar berechnet. |
| API Calls | 1,2 Millionen Mal pro Monat | Für jede weitere 100.000 Vorgänge erhält man 1 US-Dollar. |
| Anwendung läuft | Nach tatsächlichem Betrieb der Anwendung | 0,04 US-Dollar pro Stunde pro Anwendung |
| Rechenressourcen | Nicht im Preis der Standardplätze enthalten | Von der Cloud-Konto des Benutzers oder von privatem Hardware. |
Community und Pro beziehen sich hauptsächlich auf die Kosten für die Hostung eines AI Development Centers und umfassen nicht die vollständige Kontrolle über die Infrastruktur für Scale und Enterprise sowie die Funktionen von GenAI. Vor dem Kauf sollten Plätze, Nutzungsmenge, GPU, Objektspeicher, Netzwerk und Support zusammen berechnet werden.
Implementierungsweise und Plattform
| Methode | Unterstützungszustand | Hauptmerkmale |
|---|---|---|
| ClearML Hosted | Unterstützung | Schnelle Registrierung, Server-Hosting durch die Plattform |
| Self-hosted | Unterstützung | Docker, virtuelle Maschinen oder Kubernetes – eigenständige Verwaltung |
| VPC | Scale und Enterprise | In dem Cloud-Netzwerk des Kunden bereitgestellt |
| On-premises | Enterprise | In einem lokalen Unternehmenscluster ausgeführt |
| Air-gapped | Enterprise | Für isolierte Netzwerkumgebungen |
| Hybrid und Multi-Cloud | Enterprise | Zentrale Verwaltung verschiedener Rechensressourcen |
| Entwicklungsplattform | Windows, macOS und Linux | SDKs und Entwicklungstools können auf gängigen Systemen laufen. |
| Rechenumgebung | Rohmaschinen, Container, Kubernetes und Cloud-Server | Von Agenten und dem Kontrollflächen-Orchestrierungssystem |
API, SDK und Integration
ClearML bietet ein Python SDK, eine REST-API sowie eine CLI an – diese dienen zur Verwaltung von Aufgaben, Projekten, Datensätzen, Modellen, Warteschlangen, Pipelines und Automatisierungsprozessen. Die Python-Bibliotheken können über gängige Paketmanager installiert werden; anschließend wird der Zielserver mit clearml-init konfiguriert.
- Zu den Machine-Learning-Frameworks gehören PyTorch, TensorFlow, Keras, XGBoost, LightGBM und Scikit-learn usw.
- Der Code kann mit Git, Jupyter Notebook und Remote-IDE-Werkflüssen verknüpft werden.
- Die Speicherung ist über S3, Google Cloud Storage, Azure, NAS sowie gemeinsame Dateisysteme möglich.
- Die Orchestrierung unterstützt Bare Metal, Docker, Kubernetes sowie gängige Cloud-Plattformen.
- Modellservices können mit Engines wie vLLM, Llama.cpp und Triton kombiniert werden.
- Unternehmensidentitäten und Berechtigungen können je nach Lösung mithilfe von SSO, SAML, LDAP und RBAC verwaltet werden.
Open-Source-Zustand und Lizenzen
ClearML verwendet nicht für alle Komponenten dasselbe Lizenzmodell. Das Kern-Python-SDK, der ClearML Agent, ClearML Serving sowie das öffentliche Repository von ClearML werden unter der Apache License 2.0 lizenziert, was die Nutzung und Anpassung unter Einhaltung der Lizenzbedingungen ermöglicht.
Der Backend-Repository von ClearML Server verwendet die Server Side Public License v1.0. Unternehmensspezifische Funktionen, Hosted-Dienste und kommerzielle Unterstützung werden durch die Offenlegung der Grundkomponenten nicht automatisch zugänglich gemacht; vor der Nutzung müssen die Lizenzen für die jeweiligen benötigten Komponenten einzeln überprüft werden.
| Komponenten | Öffentliche Informationen | Lizenz oder Genehmigung |
|---|---|---|
| ClearML Python SDK | Offener Quellcode | Apache-2.0 |
| ClearML Agent | Offener Quellcode | Apache-2.0 |
| ClearML Serving | Offener Quellcode | Apache-2.0 |
| ClearML Web | Offener Quellcode | Apache-2.0 |
| ClearML Server | Offener Quellcode | SSPL v1.0 |
| Erweiterte Funktionen für Scale und Enterprise | Unvollständige Offenlegung | Wirtschaftsverträge |
Privatsphäre und Sicherheit
Der Speicherort und der Zugriffsweg für die selbst gehostete Open-Source-Version werden vom Betreiber kontrolliert. Laut den Richtlinien zu Datenschutz bei ClearML werden keine personenbezogenen Daten von Endnutzern erfasst, genutzt oder Cookies verwendet; außerdem erfolgt kein regelmäßiger Zugriff auf persönliche Daten innerhalb der Plattform. Die Hosted-Dienste hingegen werden von ClearML sowie seinen Dienstleistern zur Verwaltung von Konten, Protokollen und Plattformdaten genutzt.
- Sensible Modelle, Daten und Produkte sollten vorrangig in von Kunden kontrollierten Speichern und privaten Netzwerken gespeichert werden.
- Experimentparameter, Konsoleausgaben und ungesendeter Code können Schlüssel enthalten; diese sollten vor der Verwendung gefiltert werden.
- Die Produktionsendpunkte benötigen Authentifizierung, RBAC, Netzwerkisolierung, Bandbreitenbegrenzung und Auditing.
- Enterprise unterstützt SSO, LDAP, die Konfiguration von Vault sowie präzisere Berechtigungen.
- Die Bereitstellung in einer isolierten Netzwerkumgebung kann den Datenausfluss verringern, doch Modelle, Images und Updates erfordern einen Offline-Lieferprozess.
- Selbstverwaltete Teams müssen die Datenbanken, Dateien sowie den Objektspeicher selbst sichern und die Wiederherstellung überprüfen.
- Bevor man Dienste mit Hosting nutzt, sollte man die aktuelle Datenschutzrichtlinie, den Standort der Daten sowie die Unterauftragsverarbeiter prüfen.
- Man sollte die Beschreibungen der Sicherheitsfähigkeiten der offiziellen Website nicht einfach als Beweis dafür ansehen, dass das Unternehmen bereits eine bestimmte regulatorische Zertifizierung erlangt hat.
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | ClearML |
| Arten von Werkzeugen | MLOps, LLMOps, GPU-Infrastruktur und GenAI-Deployment-Plattformen |
| Kernschicht | Infrastruktur-Steuerungsplattform, AI-Entwicklungszentrum, GenAI-App-Engine |
| Preismuster | Kostenlose Hosting-Lösung, Abrechnung nach Anzahl der Plätze, Unternehmensanfragen und selbstständiges Hosting |
| Kostenloser Hosting-Service | Maximal 3 Personen, 100 GB Speicherplatz, 1 Million API-Aufrufe pro Monat |
| Startpreis pro Stück | 15 US-Dollar/Nutzer/Monat plus Zusatznutzung |
| Einrichtungsmethode | Hosted, Self-hosted, VPC, lokaler Zugriff, isolierte Netzwerke und hybride Lösungen |
| Haupt-SDK | Python |
| REST API | Ja |
| Offizieller GitHub | Ja |
| Ob Open Source | Einige Kernkomponenten sind öffentlich zugänglich, die Lizenzen sind nicht einheitlich. |
| SDK-Lizenz | Apache-2.0 |
| Server-Lizenz | SSPL v1.0 |
Empfehlungswert
Die Empfehlungsbewertung liegt bei 4,7 von 5 Punkten. ClearML umfasst nicht nur Experimente, Daten- und Modellverwaltung, sondern auch die Steuerung von GPUs sowie den Einsatz von GenAI – ideal für Entwicklerteams, die Entwicklung und Produktion auf derselben Plattform abwickeln möchten.
Die Haupthindernisse sind die komplexe Implementierung und Verwaltung sowie die Notwendigkeit, die Kapazitäten der Unternehmensinfrastruktur zu prüfen. Zudem sind die Lizenzen für Open-Source-Komponenten nicht einheitlich. Kleine Teams können zunächst in Communitys oder durch eigenständige Experimente testen, bevor sie entscheiden, ob sie ihre Aktivitäten ausweiten sollen.
Häufige Fragen
Ist ClearML kostenlos?
Es gibt ein kostenloses Community-Hosted-Angebot für bis zu 3 Teammitglieder, das 100 GB Speicherplatz für Dateien, 1 GB für Metriken/Ereignisse sowie 1 Million API-Aufrufe pro Monat bietet. Selbst gehostete Komponenten können ebenfalls kostenlos bereitgestellt werden, wobei die Hardware und der Betrieb selbst getragen werden müssen.
Ist ClearML ein Open-Source-Tool?
Die Kernkomponenten sind öffentlich zugänglich, doch die Lizenzen unterscheiden sich. Das Python SDK, der Agent und das Serving verwenden Apache-2.0, der Server verwendet SSPL v1.0. Die kommerziellen Enterprise-Funktionen sind nicht vollständig öffentlich zugänglich.
Kann ClearML LLMs bereitstellen?
Ja, GenAI App Engine unterstützt das Bereitstellen von Open-Source-Modellen sowie angepassten Modellen aus einem Modellrepository oder Hugging Face. Zudem können Engines wie vLLM, Llama.cpp und Triton verwendet werden. Die vollständigen Funktionen sowie die Möglichkeiten der Bereitstellung hängen vom gewählten Paket ab.
Unterstützt ClearML RAG?
Unterstützung für RAG-Arbeitslasten, eingebettete Modelle sowie Integration mit Vektordatenbanken. Scale und Enterprise bieten zudem Funktionen wie Hyper-Datasets – die konkrete Vektordatenbank und Architektur werden je nach Projekt ausgewählt.
Kostet das Pro-Paket nur 15 Dollar für den Sitzplatz?
Nein, 15 Dollar sind die monatliche Gebühr pro Benutzer. Zudem können Kosten für die Speicherung der Daten, für bestimmte Ereignisse, für API-Aufrufe, für den Betrieb der Anwendung sowie für die tatsächlich genutzten Rechenressourcen anfallen.
Kann es vollständig im internen Netzwerk des Unternehmens laufen?
Es ist möglich, selbst zu hosten. Enterprise bietet außerdem lokale, isolierte Netzwerke sowie eine hybride Deployment-Möglichkeit. Unterstützung für die Enterprise-Version, RBAC, LDAP, Konfiguration von Vault sowie fortgeschrittene Scheduling-Funktionen erfordern einen Geschäftsvertrag.
Muss man viel Trainingscode ändern?
Für die Überwachung grundlegender Experimente reicht in der Regel nur die Initialisierung der Aufgabe aus, um automatisch umfangreiche Informationen aufzunehmen. Komplexe Daten, Pipelines, Modellservices sowie Ressourcenverwaltung erfordern jedoch weitere Konfigurationen.
Bietet ClearML eine API?
Es werden REST-APIs, ein Python-SDK sowie eine CLI bereitgestellt, um Aufgaben, Projekte, Datensätze, Modelle und Automatisierungen zu verwalten. Die Hosting-Lösung ist durch eine monatliche Obergrenze für API-Aufrufe begrenzt.
Wird selbst gehostetes Daten an ClearML gesendet?
Die Richtlinien zur Open-Source-Privatsphäre besagen, dass ClearML keinen regulären Zugang zu den Daten der Endbenutzer hat, die die Lösung selbst hosten. Der Deployer muss weiterhin die Images, Updates, Telemetriedeckungen sowie die genutzten Drittanbieter-Cloud-Dienste überprüfen.
Eignet es sich für Teams ohne DevOps-Erfahrung?
Community- und Pro-Hosting sind einfacher zu starten, doch GPU-Clustern, private Implementierungen sowie Produktionsendpunkte erfordern weiterhin Fähigkeiten in der Plattformentwicklung. Vollständiges Self-Hosting eignet sich nicht für Teams ohne Erfahrung in Containern, Speicherlösungen, Netzwerken und Backups.
Zusammenfassung
ClearML eignet sich dazu, zerstreute Experimente, Daten, Modelle sowie GPU-Ressourcen in ein nachvollziehbares, planbares und einsetzbares AI-Engineering-System zu bündeln. GenAI App Engine bringt zudem LLMs, RAG und Agenten unter eine einzige Infrastruktursteuerung.
Bei der Auswahl sollte man gleichzeitig die Funktionsfähigkeiten, die Implementierungsweise, die Lizenzen sowie die Gesamtkosten prüfen. Der sicherste Ansatz ist es, zunächst mit kostenlosen Hosting-Diensten oder einer kleinen selbst gehosteten Lösung Experimente durchzuführen, bevor man schrittweise Queue-, Pipeline- und Produktionsmodell-Dienste einsetzt.
Tools, die ClearML ähneln



 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164