




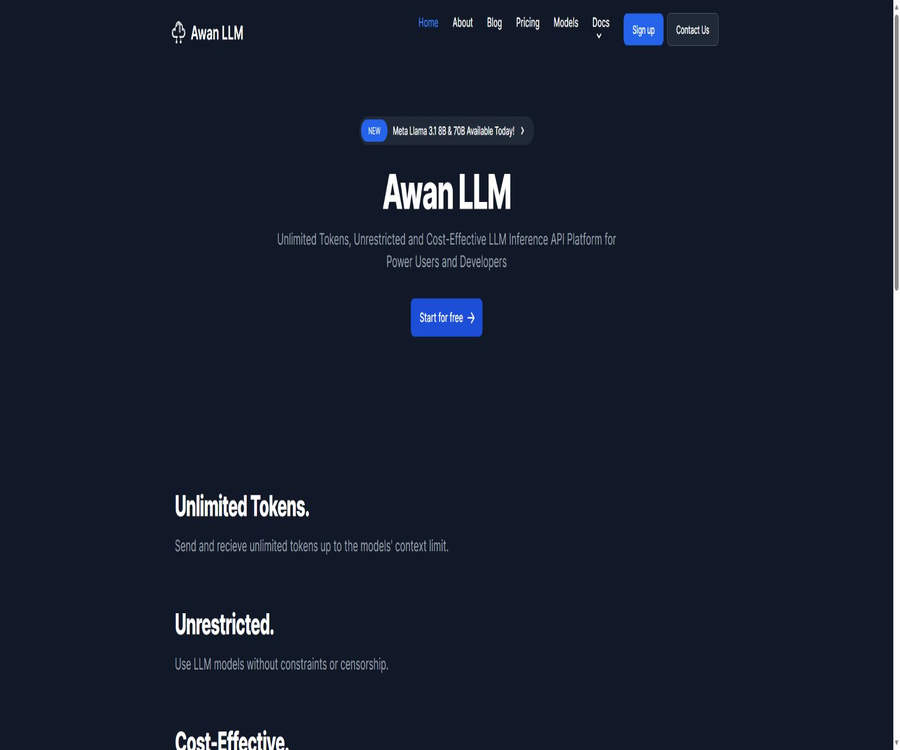
Awan LLM
Awan LLM – ein intelligentes Tool, das sich auf die Steigerung der Effizienz von KI konzentriert.
Tags:Steigerung der Effizienz durch KIWas ist Awan LLM?
Awan LLM ist eine API-Plattform für große Sprachmodelle, die sich an Entwickler und Teams für KI-Anwendungen richtet. Sie bietet über eine einheitliche Schnittstelle Funktionen zur Ergänzung von Chat- und Textinhalten und legt besonderen Wert auf einen festen Monatsbeitrag, keine Beschränkung der Anzahl der generierten Tokens innerhalb des Limits sowie geringe Einschränkungen bei den Eingabefeldern.
Die Plattform führt die Modelle auf eigenen Servern aus und setzt Beschränkungen für die Nutzung durch die Anzahl der Anfragen pro Minute sowie pro Tag. Unter „unendlich vielen Tokens“ ist nicht ein unendlicher Kontext oder eine unbegrenzte Anzahl an Aufrufen zu verstehen – jede Ein-/Ausgabe wird weiterhin durch den Kontextraum des jeweiligen Modells sowie die Parameter der Schnittstelle begrenzt.
Für welche Nutzer eignet sich Awan LLM?
- Unabhängige Entwickler: Testen Sie Chatbots, Inhaltswerkzeuge oder Automatisierungs-Skripte mit geringeren Fixkosten.
- AI-Anwendungsteam: Über standardisierte Schnittstellen werden Llama-Modelle unterschiedlicher Größe angesprochen.
- Entwickler von Agenten: Bearbeitung von Aufgaben zur Planung, Zusammenfassung und Organisation von Werkzeugen, die mehrere Modellaufrufe erfordern.
- Rollenbasierte Benutzer: Erstellung von Geschichten, virtuellen Charakteren und Anwendungen für lange Gespräche.
- Datenverarbeitungsteam: Massen-Zusammenfassung, Klassifizierung, Umformulierung oder Extraktion unvertraulicher Texte.
- Entwickler von Programmierwerkzeugen: Bietet einen Modell-Backend für Code-Vervollständigung, -Erklärung und -Dokumentenerstellung.
- Lehr- und Testnutzer: Lernen Sie im Rahmen der kostenlosen Nutzungsbedingungen REST API und streambasierte Antworten.
Hauptfunktionen
- Chat-Vervollständigung: Verwendung eines Systems zur Organisation von Rollennachrichten, Benutzerfragen und Assistentenantworten.
- Text ergänzen: Die zusammengesetzten Prompt-Wörter einreichen und den anschließenden Text erzeugen.
- Fließende Rückgabe: Ergebnisse werden während des Erstellungsprozesses kontinuierlich bereitgestellt, wodurch das Warten auf lange Antworten verringert wird.
- Stichprobenkontrolle: Konfiguration von Temperatur, Top P, Top K, Wiederholungsstrafe und Stop-Wörtern.
- Erweiterte Dekodierparameter: Unterstützt Optionen wie dynamale Temperatur, Min P, Mirostat und Beam Search.
- Parallelanfragen: Bei entsprechenden Berechtigungen werden mehrere Aufgaben gleichzeitig gestartet, um die Gesamtleistung zu erhöhen.
- Einheitliche Authentifizierung: Überprüfung der Identität des Aufrufers mithilfe einer API-Schlüssel im Bearer-Format.
- Modellwechsel: Unter derselben Schnittstelle wählen Sie Modelle mit unterschiedlicher Größe und Kontextlänge aus.
Unterschied zwischen Chat-Vervollständigung und Textvervollständigung
| Interface-Typ | Eingabemethode | Passende Szenarien | Hinweise |
|---|---|---|---|
| Chatten-Vervollständigung | System-, Benutzer- und Assistenten-Nachrichten-Array | Frage-und-Antwort-Hilfe, mehrfaches Dialogverhalten, intelligente Agenten | Einige Modelle könnten Systemnachrichten nicht akzeptieren. |
| Text ergänzen | Prompt, der nach dem Modellvorlage strukturiert wurde | Weitergeschrieben, Rollenspiel, herkömmlicher Erweiterungs-Client | Es ist notwendig, den vom Zielmodell geforderten Prompt-Format zu verwenden. |
Unterstützte Modelle und Kontexte
Auf der offiziellen Modellseite werden die Modelle derzeit in die Kategorien Small und Large eingeteilt, wobei auch die eigenen Feinabstimmungsmodelle von Meta Llama und Awan LLM aufgeführt sind. Der Modellkatalog kann sich je nach Rechenkapazität und Betriebsbedingungen ändern; vor der offiziellen Nutzung sollte man sich an die Modellidentifikatoren orientieren, die über die Konsole aufrufbar sind.
| Beispiel für ein Modell | Klassifizierung nach Größe | Kontext | Offiziell empfohlene Richtung |
|---|---|---|---|
| Meta-Llama-3.1-8B-Instruct | Small | 131,072 | Allgemeine Aufgaben und langer Kontext |
| Meta-Llama-3-8B-Instruct | Small | 8,192 | Allgemeine Texterstellung |
| Awanllm-Llama-3-8B-Dolfin | Small | 8,192 | Anweisungen entsprechen den Szenarien mit niedrigem Ablehnungsgrad. |
| Awanllm-Llama-3-8B-Cumulus | Small | 8,192 | Geschichtenschreiben und Rollenspiel |
| Meta-Llama-3.1-70B-Instruct | Large | 131,072 | Komplexere allgemeine Aufgaben |
| Meta-Llama-3-70B-Instruct | Large | 8,192 | Hochwertige allgemeine Generierung |
Erklärung der Erstellungsparameter
- Temperatur: Je niedriger der Wert, desto stabiler ist in der Regel die Situation; je höher der Wert, desto vielfältiger ist sie in der Regel.
- top_p und top_k: Begrenzung des Bereichs der möglichen Token, zur Steuerung der Zufälligkeit.
- max_tokens: Begrenzt die maximale Anzahl der zu erzeugenden Token pro Aufruf; sie darf den vom Modell zulässigen Bereich nicht überschreiten.
- repetition_penalty: Verringerung wiederholter Inhalte, doch zu hohe Werte können die Natürlichkeit der Sprache beeinträchtigen.
- Presence-Penalty und Frequency-Penalty: Die Auswahl der folgenden Wörter wird anhand des Auftretens und der Häufigkeit angepasst.
- stop und stop_token_ids: Die Erstellung wird beendet, wenn der angegebene Text oder Token auftritt.
- Seed: Hilft dabei, die Ergebnisse von Experimenten unter Einhaltung der Modell- und anderen Bedingungen wiederzugeben.
- Stream: Wenn es aktiviert ist, wird der erzeugte Inhalt in Abschnitten zurückgegeben; der Client muss den Datenstrom verarbeiten.
Wie man mit Awan LLM beginnt
- Registrieren Sie ein Konto auf der Plattform und melden Sie sich an.
- Gehen Sie in den Kontobereich, um eine API-Schlüssel zu erstellen, und speichern Sie diesen ausschließlich sicher auf der Serverseite.
- Öffnen Sie die Modellseite, wählen Sie das Modell aus und notieren Sie den genauen Modellnamen sowie die Kontextbeschränkungen.
- Erstellen Sie zunächst eine minimale Anfrage mithilfe eines Chat-Beispiels, um zu überprüfen, ob die Authentifizierung sowie die Antwortstruktur in Ordnung sind.
- Je nach Geschäftsanforderungen werden die maximale Ausgangsleistung, die Temperatur, die Stoppsbedingungen sowie die fließende Rückgabe festgelegt.
- Erhalten Sie die Fehlercodes, die Reaktionszeiten sowie die tägliche Anzahl der Aufrufe, um zu entscheiden, ob ein Upgrade des Pakets notwendig ist.
API-Zugriffsprozess
- Konfigurieren Sie die Basisadresse als Eingangspunkt für die versionierte API von Awan LLM.
- Setzen Sie im Anfrage-Header den JSON-Inhaltstyp sowie den Bearer-API-Schlüssel.
- Für Chat-Aufgaben wird „messages“ verwendet, für normale Vervollständigungs-Aufgaben wird „prompt“ verwendet.
- Übergeben Sie den Namen des Eingangsmodells, die Abtastparameter und die maximale Generierungslänge.
- Überprüfen Sie den Antwortzustand und die Fehlermeldungen sowie führen Sie bei Rate Limiting und vorübergehenden Fehlern einen verzögerten Neversuch durch.
- Im Stream-Modus wird die Ausgabe Schritt für Schritt analysiert, und nach Abschluss wird sie zu einem endgültigen Text zusammengefügt.
- Vor dem Go-Live sollten Statistiken zu der Nutzung, ein Schlüsselwechsel sowie Warnungen bei ungewöhnlichen Ausgaben eingerichtet werden.
Konfigurieren im vorhandenen Client
Die offizielle Startseite gibt Anleitung zur Konfiguration von Hugging Face Chat UI und SillyTavern. Bei der Anbindung sind in der Regel die Basisadresse der kompatiblen Schnittstelle, der API-Schlüssel, die Modellidentifikation sowie die entsprechenden Prompt-Vorlagen einzugeben.
- Chat-UI: Geeignet zum Erstellen einer Chat-Oberfläche für interne Teamkommunikation oder private Webseiten.
- SillyTavern: Geeignet für Benutzer, die Charaktergespräche führen und benutzerdefinierte Prompt-Vorlagen benötigen.
- Eigenentwickelte Frontend: Geeignet für Produkte, die eine Markenoberfläche, ein Benutzerkontensystem sowie eine Verbindung zu Geschäftsdaten benötigen.
- Backend-Skripte: Geeignet für Batch-Verarbeitung, zeitgesteuerte Aufgaben, Datenextraktion und Content-Pipelines.
Vergleich der Paketpreise
Awan LLM verwendet eine Kombination aus einer festen Monatsgebühr und einer bestimmten Anzahl an Anfragen. Derzeit nimmt das Unternehmen nur Zahlungen über PayPal entgegen. Die unten angegebenen Preise und Limits sind die Werte, die auf der Überprüfungsseite angezeigt werden. Vor dem Kauf sollten Sie daher unbedingt die Zahlungsseite sowie die Seite mit den Details zum Modell prüfen.
| Paket | Monatsgebühr | Anfragen pro Minute | Kleine tägliche Anfragen | Tägliche Anfragen bei Medium | Große tägliche Anfragen |
|---|---|---|---|---|---|
| Lite | Permanent kostenlos | 20 | 200 | 10 | 10 |
| Core | 5 Dollar | 20 | 5,000 | 3,000 | 10 |
| Plus | 10 Dollar | 50 | 10,000 | 6,000 | 2,000 |
| Pro | 20 Dollar | 100 | 80,000 | 40,000 | 30,000 |
| Max | 80 Dollar | 200 | Unbegrenzt | Unbegrenzt | Unbegrenzt |
| Enterprise | Anfragen zur Kostenermittlung senden | Unbegrenzt | Unbegrenzt | Unbegrenzt | Unbegrenzt |
Wie wählt man die richtigen Pakete aus?
- Lite: Geeignet zur Überprüfung von Schnittstellen, zum Lernen des Programmierens oder zum Ausführen von selten genutzten persönlichen Experimenten.
- Core: Geeignet für leichte persönliche Projekte, bei denen hauptsächlich kleine und mittlere Modelle verwendet werden.
- Plus: Geeignet für Anwendungen und Charaktere, die mehr Aufrufe großer Modelle benötigen.
- Vorteil: Geeignet für Teams mit hohem Durchsatz, parallelen Aufgaben und dem Bedarf an Prototypen.
- Max: Geeignet für kleine Unternehmen, die häufig aufrufen, deren Umfang aber dennoch von einer öffentlichen Plattform bewältigt werden kann.
- Enterprise: Geeignet für großangelegte Geschäfte, die SLAs, Geschwindigkeitsgarantien, benutzerdefinierte Modelle oder Feinabstimmungen benötigen.
Wie versteht man unbegrenzte Tokens?
Die in dem Paket erwähnten unbegrenzten Token bedeuten, dass die Plattform nicht pro eingegebenem und ausgegebenem Token abgerechnet wird. Die Nutzer sind weiterhin an die Anzahl der Anfragen pro Minute, die Anzahl der Anfragen pro Tag, die verfügbaren Modelle sowie den Kontextrahmen pro Modell gebunden.
Auch parallele Anfragen können die Obergrenze für die Anzahl der Aufrufe pro Minute des Pakets nicht umgehen; die tatsächliche Durchsatzrate ändert sich außerdem je nach Last der Plattform. Die auf der Modellseite angegebenen Werte für die Geschwindigkeit einer einzelnen Anfrage sowie bei parallelen Anfragen sind Schätzungen und stellen keine Garantien für den Servicelevel dar.
Typische Anwendungsfallen
- AI-Kundenservice-Prototyp: Erstellung von Antworten auf häufige Fragen auf der Grundlage von Geschäftsanweisungen.
- Inhaltsproduktion: Erstellung von Überblicken, Umformulierung von Texten, Zusammenfassung von Materialien und Erweiterung von Ideen.
- Agent-Workflows: Übernehmen die Planung, die Aufbereitung von Informationen sowie die Textverarbeitung vor und nach dem Aufruf von Tools.
- Rollenspiel: Aufrechterhaltung der Charaktereigenschaften, der Weltanschauung der Geschichte und mehrerer Interaktionsrunden.
- Dokumentverarbeitung: Zusammenfassung, Klassifizierung und strukturierte Extraktion von nicht sensiblen, langen Texten.
- Code-Hilfe: Erklärung von Code, Erstellung von Kommentaren, Vervollständigung von Abschnitten und Strukturierung technischer Dokumente.
- Massenverarbeitung von Daten: Größere Mengen an kurzen Texten werden einheitlich gereinigt, annotiert oder in ein anderes Format umgewandelt.
Vorteile des Produkts
- Festes Monatsentgelt: Bei Aufgaben mit hohem Ausstoß lässt sich die Kosten für die Aufrufung des Modells leichter schätzen.
- Kostenloses Paket: Die Überprüfung der Schnittstellenverfügbarkeit ist ohne vorherige Kaufnotwendigkeit möglich.
- Einfache Schnittstelle: Chat- und Textvervollständigung eignet sich für gängige Entwicklungsframeworks.
- Modellwahl klar: Offiziell werden Kontext, Geschwindigkeit und empfohlene Anwendungen aufgeführt.
- Reich an Parametern: Entwickler können die Zufälligkeit, die Wiederholungshäufigkeit und die Stoppsbedingungen fein abstimmen.
- Fließende Ausgabe: Geeignet für Dialogoberflächen und die Erstellung langer Inhalte.
- Eigene Inferenz-Infrastruktur: Offizielle Angaben besagen, dass das Modell auf eigenen Servern läuft.
- Hinweiswörter werden nicht protokolliert: Die Datenschutzerklärung besagt, dass Hinweiswörter sowie die erzeugten Inhalte nicht aufgezeichnet werden.
Nutzungsbeschränkungen
- Begrenzter Modellumfang: Die verfügbaren Modelle hängen von der aktuellen Implementierung der Plattform ab, und nicht alle Open-Source-Modelle können direkt verwendet werden.
- Die Anfragenbegrenzung ist deutlich: Die tägliche Obergrenze für große Modelle in den günstigen Paketen ist niedrig.
- Die Geschwindigkeit schwankt: Die offiziellen Schätzungen zur Durchsatzrate hängen von der aktuellen Nutzerlast ab.
- Es gibt nur wenige Zahlungsmöglichkeiten: Auf der Preisseite steht derzeit nur, dass PayPal unterstützt wird.
- Fehlende offizielle SLA: Die Standard-Pakete bieten keine Garantie für eine feste Verfügbarkeit und Generierungsgeschwindigkeit.
- Unterschiedliche Parameterkompatibilität: Einige Modelle unterstützen keine Systemnachrichten oder nicht alle Dekodierungsparameter.
- Inhalt muss noch überprüft werden: Eine niedrige Einschränkung bedeutet nicht, dass der erzeugte Inhalt korrekt, rechtlich zulässig oder direkt veröffentlichungsfähig ist.
- Konzentriertes Lieferantenrisiko: Das Produktionsystem muss auf Verzögerungen, Beschränkungen in der Leistung sowie Ausfälle vorbereitet sein.
Privatsphäre und Datenverarbeitung
Die Datenschutzrichtlinie besagt, dass die Plattform weder die Eingabeanfragen der Nutzer noch die erzeugten Ergebnisse speichert. Stattdessen werden die Anzahl sowie die Geschwindigkeit der Anfragen aufgezeichnet, um eine Begrenzung der Nutzung sowie Statistiken zu erstellen. Zudem speichert die Plattform die von den Nutzern freiwillig bereitgestellten Kontoinformationen und verwendet Cookies, um die Sitzungen aufrechtzuerhalten.
Diese Erklärung bedeutet nicht, dass alle Daten nicht über Server verarbeitet werden. Medizinische, rechtliche, geschäftliche Geheimnisse sowie sensible persönliche Daten müssen zunächst anonymisiert werden, und es muss anhand der Compliance-Anforderungen der Organisation entschieden werden, ob sie übermittelt werden dürfen.
Inhaltsrechte und zulässige Nutzung
Die Nutzungsbedingungen betrachten die von dem Modell auf Basis der Eingaben des Benutzers erzeugten Ergebnisse als Benutzerinhalte. Dennoch müssen bei der tatsächlichen Nutzung auch die Lizenzen des zugrunde liegenden Modells, die Rechte Dritter sowie die geltenden lokalen Gesetze eingehalten werden. Der Benutzer darf sein Konto weder teilen, übertragen noch verkaufen, und er darf den Dienst nicht zur Durchführung illegaler, schädlicher Aktivitäten oder zur Verbreitung von Spam oder Schadsoftware nutzen.
Empfehlungen für eine sichere Verwendung
- Schreiben Sie die API-Schlüssel nicht in die Webseiten-Code, öffentliche Repositorien, Screenshots oder Client-Installationspakete.
- Erstellen Sie Schlüssel für die Entwicklungs-, Test- und Produktionsumgebung getrennt voneinander und wechseln Sie diese regelmäßig aus.
- Löschen Sie vor dem Versenden die Personalausweisnummer, Kontonummer, Geschäftsgeheimnisse und unnötige persönlichen Daten.
- Zur Ausgabe werden Schritte zur Faktenüberprüfung, Inhaltskontrolle und manueller Bestätigung hinzugefügt.
- Setzen Sie eine Obergrenze für die Konkurrenz, Timeout-Werte, exponentielles Backoff sowie Schutzmechanismen, um zu verhindern, dass Fehler sich ausweiten.
- Es werden Anfragemetadaten und nicht der sensible Inhalt aufgezeichnet, um Probleme mit der Leistung und den Limits leichter diagnostizieren zu können.
- Vorbereiten Sie Ersatzmodelle oder Lieferanten, um die Auswirkungen eines Ausfalls eines einzigen Dienstes zu verringern.
Methoden zur Leistungsprüfung
- Wählen Sie einen festen Testdatensatz aus, dessen Länge und Sprache der des echten Geschäftsprozesses ähneln.
- Getestet werden jeweils kurze Antworten, lange Antworten sowie eine einzige Anfrage und mehrere Anfragen parallel.
- Protokollieren Sie die Verzögerung des ersten Tokens, die Gesamtlaufzeit, die Erstellungsrate und die Fehlerquote.
- Steigern Sie schrittweise die Konkurrenzlast und beobachten Sie die pro Minute begrenzte Anzahl an Anfragen sowie Schwankungen im Service.
- Überprüfen Sie die Qualität des Inhalts, die Formatstabilität sowie die Unterschiede zwischen den verschiedenen Modellen.
- Die monatlichen Gebühren, die verfügbaren Anfragen sowie die Betriebskosten werden zusammengeführt, um die tatsächlichen Kosten pro Aufgabe zu ermitteln.
Vergleich von Awan LLM und Self-Hosting
| Vergleichspunkte | Awan LLM | Selbsthostete Open-Source-Modelle |
|---|---|---|
| Startkosten | Registrieren und die API konfigurieren. | Es sind eine GPU, ein Inferenzframework sowie Tools zur Überwachung erforderlich. |
| Abrechnungsmethode | Festes Monatsentgelt plus Anfragenlimit | Hardware, Cloud-Ressourcen, Energiekosten und Betriebskosten |
| Modellsteuerung | Verwendung der von der Plattform bereitgestellten Modelle und Parameter | Man kann selbst wählen, quantifizieren, feinjustieren und upgraden. |
| Datenpfad | Anfrage an den Server des Anbieters gesendet | Kann in einem umorganisierten Kontrollumfeld verarbeitet werden. |
| Skalierung und Wartung | Die Plattform ist für die öffentlichen Infrastrukturen verantwortlich. | Das Team ist für die Kapazität, Störungen und Sicherheit verantwortlich. |
| Zielgruppe | Entwickler und kleine Teams, die eine schnelle Verbindung wünschen | Organisationen mit Rechenleistung, Compliance-Anforderungen oder Bedarf an maßgeschneiderten Lösungen |
Open Source und GitHub-Status
Der Awan LLM-Inferenzdienst selbst ist kein Open-Source-Produkt, und auf der offiziellen Website gibt es keinen verifizierbaren Zugang zu einem offiziellen GitHub-Quellcode-Repository. Im Internet existieren Drittanbieter-Pakete und Beispielprojekte, doch daraufhin kann die Plattform nicht als Open Source bezeichnet werden, und der Code von Drittanbietern kann auch nicht als offizielles SDK angesehen werden.
Einige der unterliegenden Modelle, die von der Plattform aufgerufen werden, verfügen über eigene offene Gewichte und Lizenzen – das ist etwas anderes als die Frage, ob die API-Plattform selbst open source ist. Bei der Bereitstellung, Weiterverbreitung oder kommerziellen Nutzung von Modellen sollte man stets die jeweilige Modelllizenz prüfen.
Status von API und SDK
Awan LLM bietet eine öffentliche REST-API sowie Beispiele für Anfragen in Python, Shell und TypeScript, doch es gibt kein eigenständig veröffentlichtes und offiziell gewartetes vollständiges SDK. Entwickler können allgemeine Netzwerkanfragemodule verwenden und selbst Authentifizierung, Wiederholungsversuche, streambasierte Verarbeitung sowie Überwachung implementieren.
Grundlegende Informationen
| Felder | Inhalt |
|---|---|
| Name des Tools | Awan LLM |
| Arten von Werkzeugen | API-Plattform für das Schlussfolgern mit großen Sprachmodellen |
| Hauptfähigkeiten | Chat-Vervollständigung, Textvervollständigung, fließende Erstellung und parallele Anfragen |
| Modellrichtung | Meta Llama und Awan LLM-Feinabstimmungsmodelle |
| Abrechnungsmodell | Kostenloses Paket, fester Monatsbeitrag und Unternehmensanfragen |
| Hauptbeschränkungen | Anfragen pro Minute, Anfragen pro Tag und Modellkontext |
| Zahlungsmethoden | Auf der offiziellen Preisseite steht derzeit, dass nur PayPal unterstützt wird. |
| Ist eine Registrierung erforderlich? | Benötigt |
| Wird eine API bereitgestellt? | Ja |
| Wird ein offizielles SDK bereitgestellt? | Kein eigenständiges offizielles SDK gefunden. |
| Ob Open Source | Die Plattform ist nicht open source. |
Empfehlungswert
Der Gesamtbewertungswert beträgt 4,0 von 5 Punkten. Awan LLM eignet sich für Entwickler, die Wert auf eine feste Monatsgebühr, eine hohe Anzahl an generierten Tokens sowie einen schnellen API-Zugang legen. Bei Produktprojekten sollten jedoch die Häufigkeit der Modellaktualisierungen, die Anfragenlimits, die Zahlungsmöglichkeiten, die Stabilität sowie die Risiken im Zusammenhang mit dem Anbieter sorgfältig bewertet werden.
Häufige Fragen
Ist Awan LLM kostenlos?
Es wird ein dauerhaft kostenloses Lite-Paket angeboten: Kleine Modelle können 200 Mal pro Tag verwendet werden, mittlere und große Modelle jeweils 10 Mal pro Tag – wobei eine Obergrenze von 20 Anfragen pro Minute gilt.
Hat Awan LLM wirklich keine Begrenzung bezüglich der Tokens?
Es wird nicht pro Token abgerechnet, ist aber dennoch an tägliche Anfragen, Anfragen pro Minute, den Modellkontext sowie die maximalen Ausgabeparameter gebunden.
Wie viel kostet das günstigste Pay-Plan?
Das Core-Paket kostet derzeit 5 US-Dollar pro Monat und eignet sich für eine geringe Nutzung durch Einzelpersonen.
Welche API-Typen werden unterstützt?
Es wird die Chat-Vervollständigung sowie die Textvervollständigung unterstützt, und es ist eine fließende Rückgabe möglich.
Kann man die Anfragen parallel stellen?
Parallelanfragen werden unterstützt, doch Berechtigungen und die Gesamtfrequenz bleiben vom gewählten Paket abhängig.
Wird der Prompt aufgezeichnet?
Laut der offiziellen Datenschutzerklärung werden keine Eingabebefehle sowie die erzeugten Ergebnisse aufgezeichnet, doch die Anzahl und Geschwindigkeit der Anfragen werden festgehalten.
Ist es mit allen Modellparametern kompatibel?
Nicht unbedingt, die Fähigkeiten der Modelle sowie ihre Vorlagen unterscheiden sich. Einige Modelle könnten Systemnachrichten oder bestimmte fortgeschrittene Parameter nicht akzeptieren.
Ist Awan LLM open source?
Die Hosting-Plattform ist nicht open source, und es gibt auch keinen offiziellen GitHub-Repository-Link, der auf der offiziellen Website aufgeführt ist.
Gibt es ein offizielles SDK?
Die Behörden stellen Beispiele für mehrsprachige Anfragen zur Verfügung, doch es gibt kein eigenständig veröffentlichtes, vollständiges offizielles SDK.
Kann es für Geschäftsprojekte verwendet werden?
Es kann für die kommerzielle Entwicklung bewertet werden, jedoch müssen gleichzeitig die Servicebedingungen, die Lizenzen für die zugrunde liegenden Modelle sowie die Anforderungen an die Konformität mit den geltenden Geschäftsregeln überprüft werden.
Wie sollte man die Kosten kontrollieren?
Wählen Sie das Paket entsprechend der Modellkategorie und der tatsächlichen täglichen Anfragenmenge aus und legen Sie Alarme für Konkurrenz, Wiederholungsversuche und Nutzung fest.
Eignet es sich zur Verarbeitung sensibler Daten?
Man kann die Konformität nicht allein anhand einer Aussage, dass keine Hinweise aufgezeichnet werden, beurteilen. Sensible Daten müssen maskiert werden und einer Sicherheits- sowie Rechtsprüfung durch die Organisation unterzogen werden.
Werkzeuge, die dem Awan LLM ähneln



 Guigong-Netzwerk-Sicherheitsnummer: 45132202000164