




LLaMA Factory是什麼?
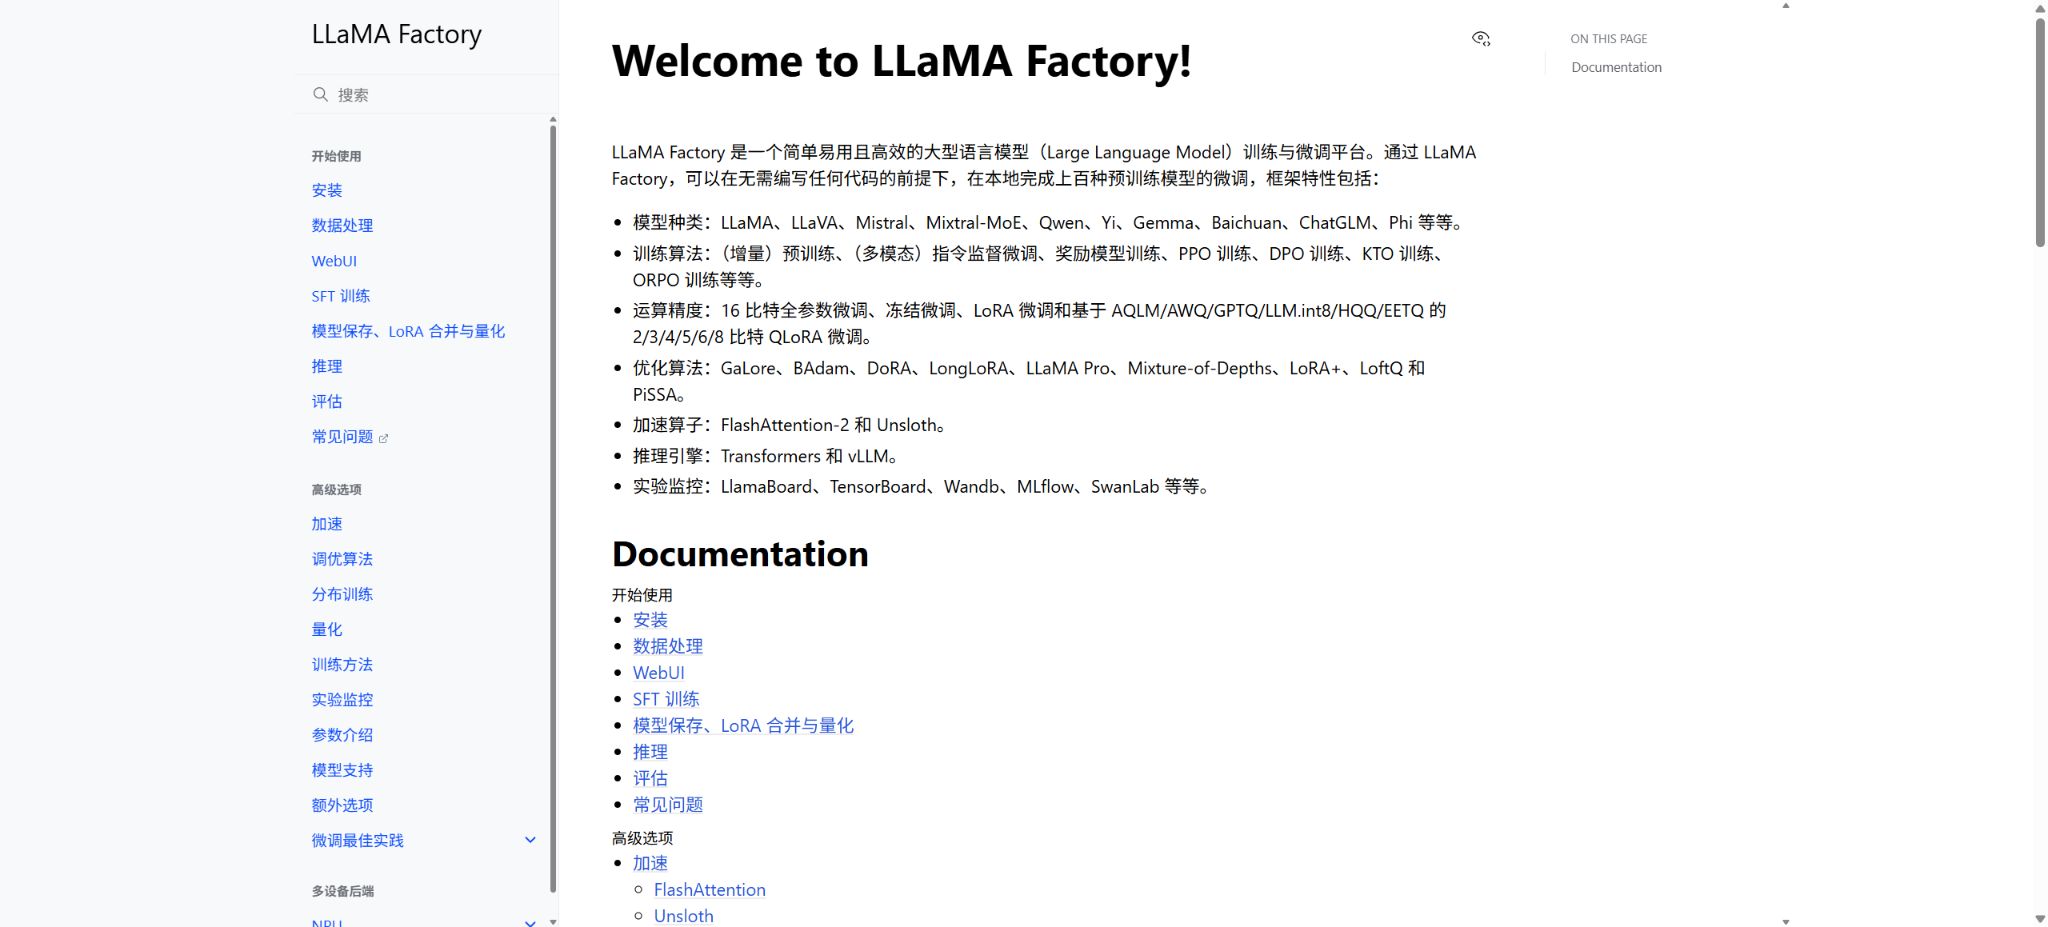
LLaMA Factory是一套面向大語言模型和視覺語言模型的開源訓練、微調、評估與推理框架。它將模型載入、資料模板、訓練階段、參數高效微調、分散式訓練、量化、導出以及部署功能整合在統一的命令行與WebUI中,其目標是減少在不同模型之間重複編寫訓練代碼的成本。
該項目支援100多種LLM與VLM,涵蓋LLaMA、LLaVA、Qwen、Mistral、Mixtral、Gemma、Yi、Baichuan、ChatGLM、Phi等常見系列。框架本身不提供模型權重、訓練數據或GPU算力,使用者仍需遵守每個模型與資料集各自的許可證規定。
0.9.5版本更新
截至本次核驗,官方最新公開版本為0.9.5,於2026年5月發布,重點增加Qwen3.5、Qwen3.6、Gemma 4和Transformers v5的支持,並加入FSDP2、ROCm 7.2及Intel XPU相關的適配與修復。
目前的安裝說明文件也將 Python 環境要求更新為 3.11 及以上,升級舊專案時應重新核對 PyTorch、Transformers、CUDA 或 NPU 组件的相容組合。
版本號變化可能影響模型模板、配置字段和量化後端。生產任務不建議直接跟隨主分支,應固定LLaMA Factory、Transformers、PyTorch、加速庫和模型Revision,再用短任務驗證後升級。
零代碼WebUI
LLaMA Factory WebUI提供訓練、評估與預測、對話和導出四類主要界面。使用者可以選擇模型、訓練階段、資料集、微調方式、量化位數、學習率、批次大小和輸出目錄,然後啟動任務並查看日誌,適合第一次接觸大模型微調或需要重複調整配置的使用者。
WebUI僅是用於配置與任務入口,不會降低模型本身的顯存和算力需求。當模型路徑、聊天模板、資料格式、量化方法或設備環境配置出錯時,界面同樣會啟動失敗;
長時間任務仍應配合進程管理、日誌、Checkpoint與訓練監控。
命令行與YAML配置
熟悉工程流程的使用者可透過命令列和YAML檔案來啟動訓練。設定檔可以儲存模型位置、資料集、模板、訓練階段、微調類型、優化器、精確度、分散式處理方式、儲存策略以及評估參數,這樣便於進行版本控制,並能在多台電腦上重複執行。
正式專案應將設定、依賴關係、資料版本、隨機種子以及程式碼提交內容一起歸檔。API Key、存取令牌和內部儲存地址不應直接寫入公開的YAML或日誌中,而應透過環境變數或Secret管理工具來處理。
資料集格式與模板
自訂資料集通常需要在data_info設定中登記名稱、檔案路徑、欄位對應關係及格式。該框架支援指令微調、對話、多輪訊息交換、偏好設定、KTO回饋,以及圖像、影片等多模態資料。
資料格式與所選訓練階段不匹配會直接報錯或產生錯誤標籤。
聊天模板決定系統提示、角色標記、停止符和標籤遮罩。訓練、評估、對話、合併與API部署應使用一致模板;
只看Loss下降並不能發現模板錯位,最好抽查Tokenizer後的輸入和目標Token。
預訓練與監督微調
框架支援增量預訓練和監督微調。增量預訓練用於讓基礎模型持續學習領域語料,監督微調則用問答或對話樣本來訓練指令遵循能力。
兩者的數據構造、學習率、訓練長度和評估方法不同,不應僅修改一個階段參數就互相替代。
領域語料需要去重、清洗、版權審查和隱私處理。監督數據還要檢查答案正確性、拒答邊界、格式一致性與長短分佈,低品質合成數據會把錯誤模式寫入模型。
Full、Freeze與LoRA
全參數微調會更新模型的大部分或全部參數,靈活性高但顯存、通訊和Checkpoint成本最大。Freeze則只訓練選定的層或模組,在資源與效果之間折中。
LoRA透過低秩適配器來訓練少量參數,是個人工作站及多任務適配中最常使用的方式。
框架還支援DoRA、LoRA+、LongLoRA、PiSSA、LoftQ、LLaMA Pro、Mixture-of-Depths、GaLore和BAdam等方法。不同方法並非在所有模型、設備及分散式後端上都能相容,選擇時應以當前版本文件及小樣本實驗為準。
QLoRA與低比特量化
QLoRA在低比特基礎模型上訓練LoRA適配器,可顯著降低顯存佔用。框架支援2、3、4、5、6和8位方案,並可接入AQLM、AWQ、GPTQ、LLM.int8、HQQ和EETQ等後端,但實際可用性受到操作系統、GPU、模型結構及依賴版本的限制。
低比特訓練並不代表任何顯卡都能運行。除了模型權重之外,還需要為KV、激活函數、優化器、梯度、資料批次以及上下文長度留出空間;
量化也可能降低吞吐或精度,應同時測試訓練穩定性與下游效果。
偏好優化與強化學習
LLaMA Factory支援獎勵模型訓練、PPO、DPO、KTO、ORPO等偏好對齊流程,並涵蓋多種直接的偏好優化變體。DPO一類方法通常使用勝負回應對,KTO可以使用正負反饋樣本,PPO則需要獎勵、價值與策略相關的組件。
偏好數據應控制長度、主題、難度和標註者偏差。獎勵上升並不代表事實性、安全性及用戶體驗全面提升,正式發布前需要獨立基準、人工盲評、紅隊測試和回歸評估。
多模態模型微調
該框架可訓練LLaVA、Qwen視覺語言模型等多模態架構,將圖像或影片內容與文本訊息一起輸入。多模態任務適用於視覺問答、文件理解、圖表分析以及圖片描述,但不同模型的媒體佔位符、解析度、幀採樣率及模板要求各不相同。
圖像與影片資料會大幅增加儲存、解碼、顯存以及資料載入的開銷。在上傳或訓練之前,還必須處理人像、版權圖片、敏感文件以及地理位置等相關風險。
DeepSpeed、FSDP與多機訓練
大模型訓練可以接入DDP、DeepSpeed、FSDP、FSDP2和Ray等方案,利用數據並行、參數分片和優化器狀態分片擴展到多卡或多機。0.9.5版本增加了對FSDP2的支援,為較新的PyTorch分片接口提供了接入方式。
分散式訓練需要統一的驅動程式、通訊函式庫、網路、主機時間以及共享儲存空間,同時還必須正確設定全局批次大小、梯度累積與儲存方式。若直接將單卡配置擴展到多台機器,可能會導致學習率、處理效率、通訊效能以及檢查點管理等方面出現問題。
NVIDIA、AMD、Intel與昇騰NPU
常用環境包括NVIDIA CUDA,也提供AMD ROCm和Intel XPU相關支持。昇騰場景覆蓋Atlas A2與A3訓練系列,可進行預訓練、SFT、獎勵模型、DPO,以及Full、Freeze、LoRA、適配器合併、DDP、FSDP、FSDP2和DeepSpeed,並可使用部分NPU融合算子。
昇騰環境需要匹配CANN、驅動、固件、PyTorch與torch-npu版本;CUDA、ROCm和XPU也有各自矩陣。
硬體名稱出現在文件中並不等於所有模型與運算子都已經過驗證,應該根據模型、精確度、運算子以及集羣規模來進行相容性測試。
FlashAttention、Unsloth與訓練加速
框架可使用FlashAttention-2降低注意力計算的顯存與時間開銷,並可選擇Unsloth等加速路徑。它們對GPU架構、PyTorch、CUDA、Triton及模型實現有明確要求,安裝失敗時應先回到官方基礎環境驗證。
吞吐量的提升不應以數值不穩定為代價。在啟用混合精度、梯度檢查點、編譯或融合運算子之後,必須比較損失值、梯度、顯存使用量、速度以及最終的評估結果,並保留一套可作為回退依據的基準配置。
Checkpoint、LoRA合併與模型導出
訓練過程可按步數或Epoch保存Checkpoint,並設定保留數量。每個實驗應使用獨立輸出目錄,避免覆蓋不同數據、模板或超參數的適配器。
LoRA訓練完成後可與基礎模型合併,並按目標後端導出或量化。
合併操作需要足夠的CPU記憶體、顯示記憶體以及磁碟的暫存空間。合併後的模型體積接近基礎權重,且不能因此獲得基礎模型未授予的再分發權;
發布前要附帶正確許可證與模型卡。
對話、批量推理與vLLM
框架提供命令行Chat和網頁對話入口,可載入基礎模型或指定LoRA適配器進行檢查。批量預測可使用Transformers或vLLM推理引擎,vLLM更適合高吞吐量生成,但其支援範圍、量化格式和顯存管理方式與訓練端不同。
訓練成功並不等於能夠投入使用。應測試首個Token的延遲、吞吐量、並發處理能力、上下文長度、停止條件、結構化輸出、GPU使用率以及異常輸入的情況,並確認所載入的Adapter、模板與基礎模型完全對應。
OpenAI相容API
使用API啟動命令可以將模型暴露為OpenAI相容的服務,便於現有的用戶端、評測工具或應用程式接入。服務端可指定模型、模板、微調類型及適配器路徑,亦能與流式輸出相結合。
該介面是部署入口而非託管雲服務。生產環境中使用時必須自行補充認證、TLS、限流、審計、內容安全、隊列、健康檢查、自動恢復以及資源隔離功能,不得將未經認證的端口直接暴露在公網上。
實驗監控與報告
訓練配置可接入TensorBoard、Weights & Biases、SwanLab、MLflow和Trackio等實驗追蹤工具,記錄Loss、學習率、獎勵、吞吐量、顯存及評估指標。團隊應統一專案、Run名稱、Tag及保存週期,以避免實驗無法追蹤。
監控平台可能收到配置、日誌和生成的樣本。涉及企業數據或用戶提示詞時,應選擇本地儲存或私有化方案,並在上報前進行脫敏處理。
安裝方式
常見的安裝流程是克隆官方倉庫,在獨立的 Python 環境中執行可編輯的安裝指令,並根據需求安裝評估、量化、分散式處理、NPU 或推理相關的依賴項目,最後再使用版本控制命令進行驗證。Windows、Linux、WSL、Docker以及不同加速卡的依賴組合也各不相同。
安裝前先確定訓練設備與後端,再選擇PyTorch與驅動版本,比一次安裝所有可選依賴更穩定。線上機器應記錄環境清單,並將模型緩存、資料、輸出及臨時目錄放在容量充足的磁碟中。
價格與使用成本
LLaMA Factory的核心軟體是免費開源的,沒有官方訂閱費用。實際成本則來自GPU或NPU的運算能力、雲主機、儲存空間、網路、模型下載、資料製作、標註、評測以及後續維運等。
全參數訓練、多機訓練和長上下文數據的成本會遠高於LoRA小規模實驗。
網路上出現的LLaMA Factory Online等託管服務屬於獨立的雲端產品或合作服務,GPU單價和權益會動態變化,不能將其價格當成開源項目的官方軟體價格。
是否開源?
LLaMA Factory倉庫採用Apache License 2.0,可依據該許可證進行使用、修改與散佈。此許可證僅適用於專案的程式碼,並不會自動涵蓋Meta、Qwen、Google、智譜等第三方模型,亦不涵蓋使用者數據、資料集或所產生的內容。
商業使用前必須分別檢查代碼依賴、模型權重、Tokenizer、資料集和評測集條款。某些模型限制商用、使用者規模、領域或再分發方式。
LLaMA Factory使用教學
完成一次基礎任務
- 安裝並配置LLaMA Factory,為實驗建立獨立專案及運行名稱;
- 在訓練腳本中記錄超參數、資料版本、代碼版本和隨機種子;
- 透過9.5版本更新初始化任務並連接正確的雲端或私有服務;
- 使用零代碼WebUI持續記錄Loss、指標、日誌和硬體狀態;
- 運行小規模訓練,檢查步數、單位、曲線和媒體樣本是否正確;
- 完成後保存模型、配置、結果與可復現實驗說明;
建立可重複使用的專業工作流
- 統一專案、實驗、指標和標籤命名規範;
- 將9.5版本更新、零代碼WebUI和命令行與YAML配置納入訓練模板;
- 為數據集、代碼、環境和模型建立版本關聯;
- 使用相同評測集和口徑比較實驗,避免只看平滑曲線;
- 限制敏感樣本、提示詞和模型輸出的上傳範圍;
- 設定異常告警、保留策略和人工複核後再推廣到團隊;
適合哪些用戶?
- 希望用WebUI完成第一次LoRA或QLoRA微調的學習者;
- 需要統一訓練多種開源LLM與VLM的算法工程師;
- 進行SFT、DPO、KTO、PPO與獎勵模型實驗的研究團隊;
- 需要DeepSpeed、FSDP或昇騰NPU分佈式訓練的機構;
- 希望合併Adapter、批量評測並部署相容API的開發者。
產品優勢
- 覆蓋100多種語言與視覺語言模型;
- WebUI與CLI兼顧入門和可重複的工程流程;
- Full、Freeze、LoRA、QLoRA及多種新型微調方法齊全;
- 支援預訓練、SFT、獎勵建模與多種偏好優化階段;
- 相容DeepSpeed、FSDP、vLLM及多類硬體;
- Apache 2.0為開源軟體,社群活躍且更新頻繁。
限制與注意事項
- 模型支援列表很長,但不同訓練階段、量化方案和硬體組合並非全部可用;
- WebUI不能代替數據清洗、顯存估算、依賴管理和評估;
- 全參數微調需要大量顯存與儲存,QLoRA也可能受操作系統和量化後端限制;
- 啟用trust_remote_code會執行模型倉庫提供的代碼,應固定可信Revision並審查來源;
- 公開服務需要鑒權與安全控制,訓練數據需要處理隱私、版權和提示注入風險;
常見問題
LLaMA Factory免費嗎?
核心代碼免費,且採用Apache 2.0許可證。GPU雲主機、儲存、模型與數據可能產生費用,第三方託管服務則另行計價。
LLaMA Factory支援哪些微調方法?
支援Full、Freeze、LoRA、QLoRA,以及DoRA、LoRA+、PiSSA等擴展;訓練階段包括預訓練、SFT、獎勵建模、PPO、DPO、KTO和ORPO等。
沒有程式設計經驗可以使用嗎?
可以透過WebUI來配置訓練、評估、對話及導出,但仍需了解模型、資料格式、模板、顯存以及環境需求。建議先使用小型模型與少量資料來驗證整個流程。
可以部署API嗎?
可以啟動OpenAI相容的API,也可用vLLM進行批量或高吞吐量推論。正式上線需要自行建設鑒權、限流、安全審核與監控。
支援昇騰NPU嗎?
支援Atlas A2與A3訓練系列及多種訓練階段和分散式方案,但必須匹配CANN、驅動、固件、PyTorch與torch-npu版本。
LLaMA Factory是模型嗎?
不是。它是訓練與微調框架,不帶自可直接商用的模型權重。
用戶需要選擇並下載符合許可證的基礎模型。
類似於LLaMA Factory的工具


 桂公網安備45132202000164號