




一句话介绍
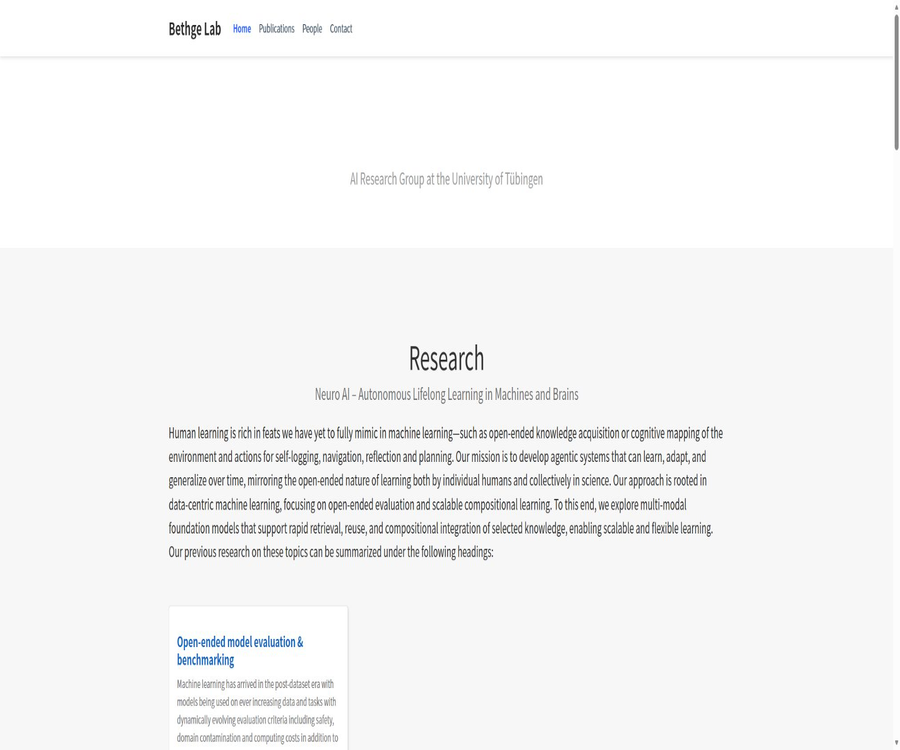
Bethge Lab是图宾根大学的AI与计算神经科学研究团队,官网集中展示研究方向、成员、论文、数据集和开源代码,而不是提供在线聊天或内容生成服务。
实验室简介
Bethge Lab由Matthias Bethge领导,研究横跨机器学习、计算神经科学、视觉科学和自主终身学习。其目标是理解生物大脑的推理与学习机制,并探索能够持续适应、组合知识和泛化的机器系统。
Matthias Bethge是图宾根大学计算神经科学与机器学习教授,并担任图宾根AI中心负责人。实验室与当地大学、马克斯·普朗克研究机构、ELLIS及其他学术网络保持合作。
它不是普通AI工具
- 没有面向公众的提示词输入框或通用AI聊天界面。
- 不提供按月订阅的写作、搜索或办公软件。
- 官网主要用于了解课题、阅读论文、查找成员和申请岗位。
- 真正可操作的资源通常位于论文附件、代码仓库和数据集页面。
- 不同研究项目具有不同依赖、许可证、维护状态和复现难度。
当前核心研究方向
开放式模型评测与基准
实验室关注模型进入后数据集时代后的评测问题,包括任务不断变化、安全、数据污染、计算成本和评测民主化。相关研究尝试把静态排行榜扩展为可持续、可组合和样本级的开放评估。
语言模型智能体
该方向研究能够推理、交流和自主执行任务的语言模型智能体。公开课题包括定理证明、科学发现自动化、科学引用检索以及对不确定未来事件的信息聚合。
终身组合与目标中心学习
实验室认为持续学习不只是避免灾难性遗忘,还要让过去经验成为未来可复用的模块。研究将组合泛化、目标中心表征、多模态预训练和可扩展终身学习连接起来。
神经表征与机制可解释性
研究团队使用机器学习分析神经数据,探索生物神经元群体如何完成推理和学习。工作涉及视网膜、视觉皮层数字孪生、神经表征比较和按需细化的脑区模型。
人类与机器的注意力
该方向研究图像、视频、虚拟现实中的显著性、扫视路径和眼动,并比较人类注意力与机器视觉机制。目标之一是把更符合人类行为的注意力模型用于视觉和行为研究。
AI科学创业
实验室也关注如何把机器学习研究转化为具有长期实际价值的解决方案,并与研究衍生企业合作。网站列出的创业与合作内容不等于实验室向公众销售统一的商业产品。
研究方向对照
| 研究方向 | 主要问题 | 典型资源 | 适合读者 |
|---|---|---|---|
| 开放式评测 | 如何持续评价快速变化的模型 | 评测框架、基准和数据集 | 模型评测与治理研究者 |
| 语言模型智能体 | 如何提高推理、引用和任务协作能力 | 论文、基准和实验代码 | NLP与智能体研究者 |
| 终身组合学习 | 如何复用知识并减少遗忘 | 持续学习与多模态项目 | 机器学习研究者 |
| 神经表征 | 神经群体如何计算与学习 | 神经数据模型和分析代码 | 计算神经科学研究者 |
| 人机注意力 | 人类眼动与机器注意力如何比较 | 显著性模型、眼动数据和基准 | 视觉与认知科学研究者 |
| 科学创业 | 研究成果如何转化为可行方案 | 合作项目与衍生企业信息 | 研究创业者 |
官网可用资源
- 研究概览:快速了解团队当前使命和主要课题。
- 论文目录:按年份和出版类型浏览论文、预印本与会议文章。
- 项目附件:部分论文提供PDF、代码、数据集、项目页、视频或幻灯片。
- 成员页面:查看负责人、博士后、博士生、硕士生、行政人员和校友。
- 申请页面:了解博士后、博士、实习、轮转和学位论文机会。
- 新闻与合作:查看实验室活动、学术合作和社会影响项目。
代表性论文主题
论文目录覆盖视觉注意力、神经数据建模、持续学习、组合泛化、多模态模型和大语言模型评测。目录中的论文状态可能包括正式发表、会议论文和预印本,引用时应核对版本。
- 开放式能力的样本级模型评测。
- 科学主张与文献引用匹配能力。
- 多模态模型的持续预训练与合并。
- 视觉语言模型的概念频率和零样本表现。
- 目标中心学习与组合泛化。
- 持续测试时适应和分布外泛化。
- 人类视觉注视、显著性和扫视路径预测。
- 视网膜与视觉皮层的功能建模。
GitHub开源资源
与实验室同名且主页指向官网的GitHub组织当前拥有数十个公开仓库,主要存放论文实现、基准、数据处理工具和实验代码。仓库并不是一个统一软件包,使用前必须逐个查看说明与许可证。
Foolbox
Foolbox是用于构造神经网络对抗样本的Python工具箱,可配合PyTorch、TensorFlow和JAX使用。它适合鲁棒性研究与模型评估,不应被用于未授权攻击真实系统。
imagecorruptions
imagecorruptions提供向图像添加常见腐蚀的Python能力,可用于测试模型面对噪声、模糊、天气和数字失真的稳定性。仓库采用Apache 2.0许可证,但输入数据和模型仍可能有独立授权。
model-vs-human
model-vs-human用于在分布外数据上比较模型与人工行为。该项目适合研究机器视觉是否依赖与人类不同的线索,当前仓库没有在元数据中明确展示标准许可证。
CiteME与ONEBench
CiteME关注语言模型能否找回科学文本所引用的论文,ONEBench关注开放能力的样本级基准。两者可用于评测研究,但数据、代码和评测结果需要按照各自仓库说明解读。
近年研究仓库
组织还公开了终身模型评测、多模态预训练、强化学习、神经表征和语言基准等项目。仓库更新时间与论文发布节奏不同,不能把最近推送直接等同于稳定版本。
开源项目对比
| 项目 | 用途 | 主要语言 | 许可证状态 | 注意事项 |
|---|---|---|---|---|
| Foolbox | 对抗样本与鲁棒性评测 | Python | MIT | 仅用于授权研究与测试 |
| imagecorruptions | 图像腐蚀与鲁棒性测试 | Python | Apache 2.0 | 核对数据和模型授权 |
| model-vs-human | 模型与人类行为比较 | Python | 仓库元数据未明确 | 使用前阅读项目文件 |
| CiteME | 科学引用检索评测 | Python | 非标准声明 | 分别检查数据与代码条款 |
| ONEBench | 开放能力样本级评测 | Python | MIT | 结果依赖样本与评测配置 |
| frequency_determines_performance | 多模态预训练频率研究 | Notebook | MIT | 复现可能需要较大数据和算力 |
如何查找合适的论文
- 先从研究概览确定主题属于评测、智能体、终身学习、神经表征还是注意力。
- 进入论文目录,按年份、会议或论文类型缩小范围。
- 阅读标题和摘要,确认任务、数据、方法及评价指标是否匹配需求。
- 检查论文页面是否提供代码、数据集、项目页或幻灯片。
- 优先引用最终发表版本,并核对作者、会议、年份和数字对象标识符。
- 记录论文版本、代码提交和数据版本,保证后续可以复现。
如何使用研究代码
- 从论文页面找到对应仓库,确认仓库确实由作者或实验室维护。
- 阅读说明文件、论文、许可证、依赖版本和已知问题。
- 建立隔离的Python环境,不要直接安装到生产系统。
- 先运行官方最小示例或测试,再尝试完整数据和训练任务。
- 固定代码提交、随机种子、数据版本和硬件环境。
- 比较自己的结果与论文指标,并记录无法复现的差异。
- 发布衍生工作时按许可证和学术规范进行引用。
论文复现流程
- 明确要复现的是训练结果、评测结果、图表还是定性案例。
- 核对原始数据是否公开、是否需要申请以及是否允许重新分发。
- 记录软件环境、驱动、框架、显卡和随机种子。
- 先在小规模样本上验证数据读取和损失计算。
- 按论文附录检查超参数、预处理、数据划分和评测协议。
- 至少运行多次并报告均值、方差和失败情况。
- 区分完全复现、近似复现和概念验证,不要夸大一致性。
申请加入实验室
官网分别说明博士后、博士生、实习、实验室轮转及本科或硕士论文的申请路径。团队明确表示申请数量很多,应使用指定申请表,而不是直接向普通邮箱发送完整申请。
- 阅读当前研究方向,选择与个人经历最匹配的课题。
- 准备简历、研究陈述、代表项目和可验证的代码或论文。
- 说明希望解决的问题,而不是只表达对AI的泛泛兴趣。
- 按照博士后、博士项目或学生项目的指定渠道提交。
- 核对申请截止日期、材料要求和推荐信安排。
- 等待正式通知,不要把自动确认当作录取或面试。
适合哪些用户
- 机器学习研究者:寻找持续学习、多模态和模型评测工作。
- 计算神经科学研究者:查找视觉系统与神经表征模型。
- 博士与硕士生:寻找论文、数据、复现项目和申请机会。
- 工程师:评估Foolbox、imagecorruptions等研究工具。
- 模型安全团队:研究对抗鲁棒性和开放式评测。
- 视觉与认知科学人员:使用显著性、眼动和行为比较资源。
- 科学创业者:了解研究成果转化和实验室衍生项目。
典型使用场景
- 为持续学习或组合泛化课题建立文献起点。
- 复现论文并比较新方法与实验室公开基线。
- 使用对抗样本工具评估视觉模型鲁棒性。
- 使用图像腐蚀测试模型在分布变化下的表现。
- 研究语言模型的科学引用和开放能力评测。
- 比较机器视觉预测与人类眼动或行为数据。
- 查找博士后、博士和学生研究机会。
资源优势
- 把机器学习与计算神经科学放在同一研究框架中。
- 论文目录时间跨度长,并提供较完整的作者与出版信息。
- 不少论文页面同时提供代码、数据或项目附件。
- GitHub组织包含成熟工具和近年论文实现。
- 研究方向覆盖模型评测、智能体、多模态、视觉和神经数据。
- 部分仓库采用MIT或Apache 2.0等清晰许可证。
- 官网明确展示团队、合作网络与申请方式。
使用限制与注意事项
- Bethge Lab是研究团队,不是可直接完成日常任务的SaaS工具。
- 官网内容主要为英文,论文需要机器学习或神经科学基础。
- 部分代码属于论文复现材料,未必具备生产级稳定性。
- 不同仓库许可证不同,有些项目没有明确标准许可证。
- 论文代码可能依赖旧版框架、专用硬件或大规模数据。
- 公开模型和基准可能含数据偏差、污染或评测泄漏问题。
- 对抗样本项目只能用于授权测试、教学和防御研究。
- 预印本和会议版本可能与最终发表内容存在差异。
- 仓库星标、提交频率和论文引用不能单独证明方法可靠。
- 申请页面和人员信息会变化,应以提交时官网状态为准。
价格与使用成本
Bethge Lab官网、论文目录和公开GitHub仓库不采用商业订阅套餐。阅读网页通常免费,但论文全文、数据访问、训练算力和第三方云服务可能产生独立成本。
| 资源 | 公开价格 | 可能成本 | 说明 |
|---|---|---|---|
| 实验室官网 | 免费访问 | 网络与时间成本 | 无需购买会员 |
| 论文目录 | 免费浏览 | 部分出版物可能受期刊访问限制 | 优先查找开放版本 |
| GitHub代码 | 公开访问 | 算力、存储和工程维护 | 遵守各仓库许可证 |
| 数据集 | 因项目而异 | 申请、下载、存储和合规成本 | 查看数据使用协议 |
| 申请项目 | 官网未列服务费 | 教育、签证和生活成本另计 | 录取规则由具体项目决定 |
平台与访问方式
| 平台 | 支持情况 | 用途 |
|---|---|---|
| Web官网 | 支持 | 研究概览、论文、成员和申请信息 |
| GitHub | 支持 | 代码、数据说明、问题与版本记录 |
| Windows | 依项目而定 | 通过浏览器或本地研究环境使用 |
| macOS | 依项目而定 | 通过浏览器或本地研究环境使用 |
| Linux | 多数研究代码优先 | 训练、评测和复现 |
| 移动端 | 浏览网页 | 不等于提供独立移动应用 |
API、SDK与开源状态
Bethge Lab没有统一的商业API、账户控制台或通用SDK。开源能力以单独研究仓库为单位,用户需要根据论文选择项目,并遵守该仓库及其数据、模型和依赖的许可证。
实验室本身不是一个可以整体安装的开源产品,但大量研究代码公开。目录中的开源状态更适合标注为‘研究代码部分开源’,不能简单写成所有成果都采用同一许可证。
安全与研究伦理
- 对抗样本和模型攻击只能用于获得授权的系统。
- 神经、行为和眼动数据可能涉及人体研究与隐私限制。
- 下载数据前检查伦理审批、同意范围和再分发条件。
- 大模型评测应记录提示词、模型版本、温度和数据污染风险。
- 科研代码应在隔离环境中运行,并检查依赖与文件操作。
- 生成或评测结果不能代替同行评审与独立复核。
基本信息
| 字段 | 内容 |
|---|---|
| 名称 | Bethge Lab |
| 性质 | 大学机器学习与计算神经科学研究团队 |
| 负责人 | Matthias Bethge |
| 所属机构 | 图宾根大学 |
| 主要方向 | 终身学习、模型评测、智能体、神经表征与视觉注意力 |
| 价格模式 | 官网和公开代码免费访问,无商业订阅 |
| 是否需要注册 | 浏览官网不需要,第三方资源可能需要 |
| 统一API | 没有 |
| 统一SDK | 没有 |
| GitHub | 有同名组织和数十个公开仓库 |
| 开源状态 | 研究代码部分开源,许可证因仓库而异 |
| 主要语言 | 英文 |
推荐指数
综合推荐指数为4.4分,满分5分。对于机器学习、计算神经科学和模型评测研究者,Bethge Lab提供了具有连续主题脉络的论文目录和丰富代码资源。
它不适合寻找一键式AI搜索、写作或办公服务的普通用户。研究人员还需要承担论文筛选、环境配置、许可证核验和复现实验成本。
常见问题
Bethge Lab是什么?
它是图宾根大学的AI与计算神经科学研究团队,不是商业AI应用。
Bethge Lab可以直接在线使用吗?
可以浏览研究与论文,但没有统一在线生成工具。实际操作通常需要进入对应代码仓库并配置研究环境。
访问官网需要付费吗?
官网和公开代码无需订阅,论文出版物、云算力和部分数据可能产生其他费用。
有哪些主要研究方向?
包括开放式模型评测、语言模型智能体、终身组合学习、神经表征、人机注意力和AI科学创业。
Bethge Lab开源吗?
不能把整个实验室称为一个开源产品,但其GitHub组织公开了大量研究代码。
所有仓库都可以商用吗?
不可以一概而论,每个仓库、数据集、模型和依赖都要分别检查许可证与使用条款。
Foolbox适合什么用途?
适合在授权环境中生成对抗样本并评估神经网络鲁棒性。
是否提供统一API?
没有,公开资源以独立论文项目、Python包、Notebook和数据集为主。
支持中文吗?
官网和大多数论文以英文为主,部分代码可用于多语言研究,但没有中文界面承诺。
如何找到论文对应代码?
在论文目录或论文详情页检查Code、Dataset和Project等附件,再核对仓库作者与论文信息。
可以申请加入实验室吗?
可以按官网提供的博士后、博士和学生项目渠道申请,具体开放状态和截止日期会变化。
适合初学者吗?
官网适合了解研究方向,但多数论文和复现项目需要Python、深度学习、统计或神经科学基础。
类似于Bethge Lab的工具

 桂公网安备45132202000164号