




Storm
Storm, outil intelligent axé sur l’écriture par IA
Étiquettes :Outils d’écriture par IAQu’est-ce que STORM ?
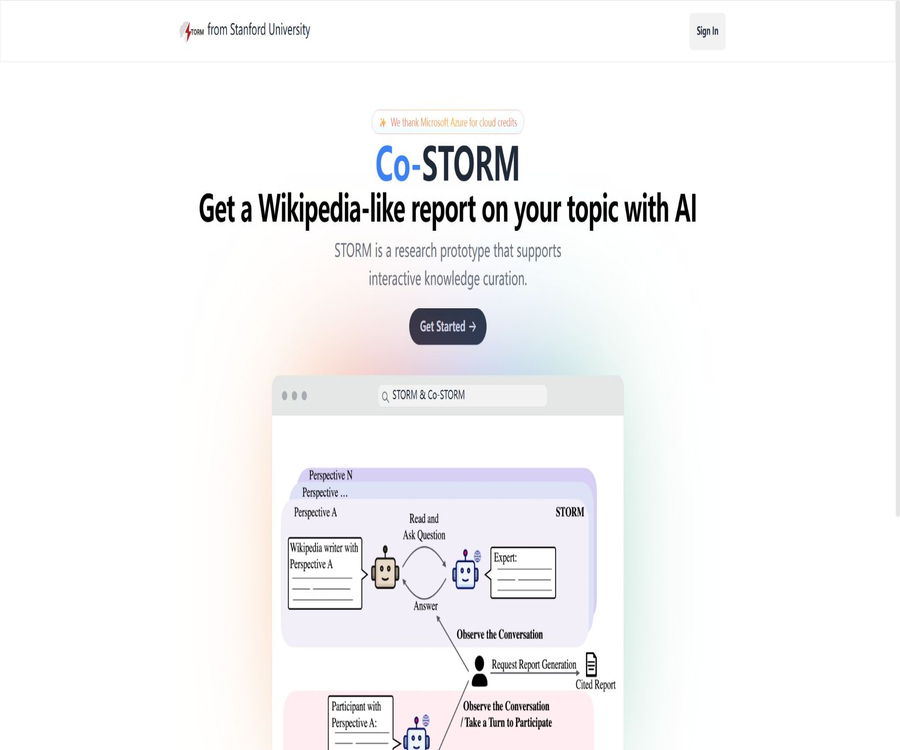
STORM, dont le nom complet est Synthesis of Topic Outlines through Retrieval and Multi-perspective Question Asking, est un système open source de structuration des connaissances développé par l’équipe OVAL de Stanford. Il recherche des documents en ligne autour d’un thème, pose des questions sous plusieurs perspectives, génère des plans et rédige des rapports longs accompagnés de citations.
STORM sert principalement à la recherche et à la phase préliminaire d’écriture, et non à la production directe d’articles prêts à être publiés. Il est clairement indiqué que les résultats générés nécessitent généralement encore une grande quantité de révisions et de vérifications factuelles.
Le flux de travail de STORM
- Recevoir le sujet de recherche saisi par l’utilisateur.
- Rechercher des articles sur des sujets similaires et identifier les points de vue différents.
- Permettez aux auteurs virtuels de poser des questions depuis plusieurs perspectives.
- Simuler des entretiens successifs entre l’auteur et des experts du sujet.
- Rechercher des informations à l’aide d’un moteur de recherche ou d’un corpus personnalisé.
- Organiser les preuves recueillies et créer un plan hiérarchique.
- Rédiger un article complet en fonction du plan et des sources.
- Ajouter des citations supplémentaires, des résumés et réduire le contenu répétitif.
Fonction principale
- Déclencher automatiquement plusieurs tours de recherche en réseau à partir d’un thème.
- Élargir la portée du problème à travers les points de vue de différents personnages.
- Simuler un entretien et poser des questions supplémentaires en fonction de nouvelles informations.
- Rassembler des informations de pages web et des citations traçables.
- Organiser les résultats de recherche en un plan d’article hiérarchique.
- Générer un rapport long au style Wikipédia.
- Séparer les quatre modules : recherche, planification, rédaction et révision.
- Permet de remplacer les modèles de langage, les moteurs de recherche et les rechercheurs vectoriels.
- Prend en charge la création de corpus de recherche VectorRM à partir de documents propriétaires de l’utilisateur.
- Fournit des paquets Python, des scripts d’exemple et une interface Streamlit légère.
Pourquoi adopter des questions à plusieurs perspectives
Laisser le modèle formuler directement des questions risque de se limiter à des concepts courants et à des informations superficielles. STORM examine d’abord des articles sur des sujets similaires ainsi que les points de vue de différentes personnes, avant de demander à des auteurs virtuels différents de poser des questions plus variées.
- Identifier les parties prenantes en dehors du récit dominant.
- Couvre l’histoire, la technologie, l’économie, les aspects éthiques et les impacts sociaux.
- Réduire les limites liées à une recherche uniquement basée sur la formulation initiale de l’utilisateur.
- Compléter les concepts inconnus et les lacunes en preuves par des questions supplémentaires.
- Fournir un éventail plus large de propositions de chapitres pour le plan final.
Qu’est-ce que Co-STORM ?
Co-STORM est un modèle de mise en ordre collaborative des connaissances développé sur la base de STORM. Il permet aux utilisateurs, à plusieurs experts en IA et à un agent facilitateur de discuter d’un sujet et de maintenir en continu des organigrammes dynamiques.
| Personnage | Principales responsabilités |
|---|---|
| Expert en IA | Répondre aux questions ou poser des questions supplémentaires en se basant sur des informations externes |
| Agent de présentation | Détecter des informations importantes encore non abordées et poser des questions heuristiques |
| Utilisateurs humains | Observer les discussions ou contribuer activement par des opinions pour ajuster la direction de la recherche |
| Mind map dynamique | Organiser le contenu de la discussion en une structure conceptuelle hiérarchisée |
La valeur de Co-STORM
- Les utilisateurs n’ont pas besoin d’attendre le rapport final pour découvrir que la direction de la recherche a dévié.
- On peut ajouter des objectifs, des contraintes et un parcours professionnel au cours de la discussion.
- Les mind maps dynamiques réduisent la charge cognitive des discussions prolongées.
- L’agent de modération aide à découvrir des connaissances déjà recherchées mais pas encore abordées.
- Le rapport final peut être élaboré sur la base d’un processus d’exploration commune.
Comparaison de STORM et Co-STORM
| dimension | STORM | Co-STORM |
|---|---|---|
| Mode de fonctionnement | Article généré après recherche automatique | L’humanité et les multi-entités explorent ensemble |
| Participation des utilisateurs | Fournit principalement des thèmes et des paramètres de configuration | On peut intervenir continuellement dans la discussion |
| Structure du savoir | Plan et article | Mind maps dynamiques, discussions et rapports |
| Adéquat pour la tâche | Aperçu rapide sur un sujet relativement clair | Problèmes complexes, ouverts et nécessitant une clarification progressive |
| Sortie principale | Article en style Wikipédia avec citations | Espace de connaissances collaboratif et rapport final |
| Complexité | Plus bas | Plus d’agents, plus d’appels, coûts plus élevés |
Guide d'utilisation de la prévisualisation de recherche en ligne
- Accédez à la prévisualisation de la recherche STORM de Stanford.
- Lisez et acceptez les conditions de service actuelles.
- Sujet de recherche dont les critères d’entrée sont clairs et faciles à rechercher.
- Complétez les objectifs à connaître et la portée à exclure.
- Attendre que le système effectue la recherche, les entretiens et génère l’aperçu.
- Voir la structure du rapport ainsi que chaque source citée.
- Ouvrez la page web originale pour vérifier les chiffres, les dates et le contexte.
- Exporter les résultats en version préliminaire de la recherche et les réécrire manuellement.
Comment choisir un sujet de recherche
- Utiliser des objets concrets, une période temporelle et des questions de recherche.
- Évitez d’entrer un seul mot dont le sens est trop large.
- Décrire les technologies, politiques, personnalités ou projets à comparer.
- Préciser s’il faut aborder l’histoire, la situation actuelle, les controverses ou les tendances futures.
- Indiquer la date de péremption des informations pour les sujets en évolution rapide.
- Les sujets à haut risque exigent l’utilisation prioritaire de sources primaires.
- Découper le grand problème en plusieurs sous-problèmes pouvant être vérifiés indépendamment.
Quels scénarios d'utilisation conviennent
- Les étudiants établissent un cadre de recherche pour leurs mémoires et leurs devoirs de cours.
- Les chercheurs comprennent rapidement les concepts et les controverses dans des domaines inconnus.
- Les créateurs de contenu collectent des informations de fond et un plan d’article.
- Le manager de produit étudie le marché, la technologie et les problèmes des utilisateurs.
- Les spécialistes en politiques et en conseil rassemblent les points de vue divers et les preuves publiques.
- L’enseignant établit des fiches de lecture et des questions de discussion pour le cours.
- Les développeurs créent des systèmes personnalisés pour la recherche approfondie et l’établissement de rapports.
- L’équipe explore ensemble des sujets complexes à l’aide de Co-STORM.
Tâches qui ne conviennent pas à une exécution directe
- Encyclopédies ou articles officiels pouvant être publiés sans édition.
- Revues systématiques et méta-analyses exigeant l’épuisement de toute la littérature.
- Recherches nécessitant l’accès à des bases de données payantes, à des documents internes ou à des pages web non publiques.
- Diagnostic médical, avis juridique et conseils d’investissement personnalisés.
- Il est impératif de s’assurer que les rapports à haut risque cités soient strictement identiques phrase par phrase aux affirmations.
- Exigence d’un suivi en temps réel, au niveau des secondes, pour les actualités ou les données complètes des réseaux sociaux.
- Chaîne de publication automatique de contenu sans vérification manuelle.
Prix et coûts d’utilisation
Stanford Online Research Preview ne communique pas le prix de ses abonnements publics ; il s’agit d’un service de prévisualisation de recherche. Il peut présenter des restrictions d’utilisation, des files d’attente et des conditions particulières, et ne doit pas être considéré comme une offre gratuite permanente au sens d’un SaaS commercial.
| Mode d'utilisation | Prix du logiciel | Coût potentiel |
|---|---|---|
| Stanford Research Preview | Aucun frais publics non indiqués | Sous réserve de la capacité des services de recherche et des conditions applicables |
| Le paquet Knowledge-Storm pour Python | MIT open source gratuit | Modèles volumineux, recherche, embeddings et coûts de serveur |
| Déploiement du code source personnalisé | MIT open source gratuit | GPU ou API, bibliothèques vectorielles, coûts d’opération et de sécurité |
| Modèle local et corpus local | Code gratuit | Coûts du matériel, du stockage, de l’électricité et de la maintenance |
Une étude complète implique plusieurs tours de recherche, de questions-réponses, d’élaboration d’organigrammes, d’écriture et de révision, ce qui entraîne généralement des coûts plus élevés qu’une simple conversation. Les discussions multi-acteurs et les organigrammes de pensée de Co-STORM augmentent également le nombre d’appels nécessaires.
Modèles et rechercheurs pris en charge
Knowledge-Storm 1.1.0 intègre LiteLLM, ce qui permet de se connecter aux modèles de langage et aux modèles d’embedding pris en charge par LiteLLM. Les différents composants peuvent choisir des modèles distincts, permettant une configuration hiérarchisée entre qualité, vitesse et coût.
| Composant | Exemples de support public actuel |
|---|---|
| Modèle de langue | Modèles pris en charge par LiteLLM, OpenAI, Azure, etc. |
| Modèle intégré | Services d’incorporation pris en charge par LiteLLM |
| Recherche | You.com, Bing, Serper, Brave, DuckDuckGo, Tavily, Google, etc. |
| Recherche auto-hébergée | SearXNG |
| Recherche d’entreprises | Azure AI Search |
| Corpus propre | VectorRM et bases de données vectorielles |
Tutoriel de déploiement local
- Préparer l’environnement Python 3.11.
- Installez le paquet knowledge-storm ou clonez le dépôt officiel.
- Sélectionnez le modèle de langue, le modèle d’embedding et le service de recherche.
- Enregistrez la clé API dans la configuration secrets ou dans une variable d’environnement sécurisée.
- Exécuter les scripts d’exemple officiels STORM ou Co-STORM.
- Utiliser des thèmes à faible risque pour vérifier les recherches, les plans et les résultats de citation.
- Ajuster respectivement des modèles bon marché et des modèles de rédaction de haute qualité en fonction du budget.
- Ajouter des journaux, des quotas, du masquage des données et un traitement des erreurs avant l’utilisation en production.
Recommandations pour la hiérarchisation des modèles
- La décomposition des requêtes et la simulation de dialogues peuvent utiliser des modèles plus rapides et moins chers.
- La génération d’outils structurés exige des capacités importantes en matière de structuration et de compréhension globale.
- Pour la génération de textes, il convient de choisir des modèles qui respectent les citations et ont de meilleures capacités pour les textes longs.
- Lors de la phase de mise en forme, il faut empêcher le modèle de supprimer des références ou d’ajouter des faits sans source.
- Tous les composants sont d’abord évalués à petite échelle, avant d’augmenter le nombre de concurrences et de thèmes.
Documents propriétaires et bases de connaissances privées
VectorRM permet à STORM de procéder à des recherches à partir de documents fournis par l’utilisateur, plutôt que de dépendre entièrement des moteurs de recherche publics. Il convient aux documents internes, aux collections de thèses ou à des corpus professionnels vérifiés.
- Organiser les documents et métadonnées autorisés.
- Supprimer les fichiers redondants, obsolètes et dont les droits d’accès ne sont pas clairs.
- Diviser le texte selon les exigences du projet et créer un index vectoriel.
- Configurer une connexion VectorRM à la base de données vectorielle.
- Utiliser des questions avec des réponses connues pour tester le taux de rappel.
- Vérifier si la citation finale permet de localiser le paragraphe d’origine.
- Définir les droits d’accès aux documents, la durée de conservation et le processus de suppression.
Pourquoi la citation doit-elle encore être vérifiée ?
- Les résultats de recherche peuvent provenir de pages web de faible qualité ou obsolètes.
- Le site peut refuser d’être extrait, ce qui empêche l’analyse du texte.
- Le fait qu’une page soit citée ne signifie pas qu’elle soutient toutes les affirmations qui s’y rapportent.
- Le modèle peut fusionner de manière erronée des informations provenant de plusieurs sources.
- Après mise à jour de la page web, le contenu des références et les dates peuvent changer.
- Les rapports secondaires peuvent interpréter de manière erronée des articles, des lois ou des données officielles.
- La génération d’articles peut omettre des contre-exemples et des controverses importantes.
Processus de vérification des faits
- Marquer chaque paragraphe pour les affirmations factuelles pouvant être vérifiées externement.
- Ouvrez la référence correspondante et localisez le contenu directement pris en charge.
- Privilégier la substitution par des thèses, des données officielles et des documents originaux.
- Vérification croisée des chiffres, dates, noms et relations de cause à effet.
- Rechercher des preuves contraires et des sources fiables contradictoires.
- Supprimer les conclusions sans source ou dont la source n’est pas prise en charge.
- Dates limites de soumission des documents et questions encore indéterminées.
Confidentialité et sécurité des données
Pour la prévisualisation en ligne de la recherche, il est nécessaire d’envoyer le sujet et les interactions au service hébergé par Stanford ; les utilisateurs doivent lire les conditions d’utilisation actuelles. Le projet de recherche a également publié un ensemble de données WildSeek établi à partir des données de prévisualisation, par conséquent les sujets sensibles ne devraient pas être soumis pour une démonstration publique.
- Ne saisissez pas d’informations personnelles, de secrets clients ou de documents de recherche non publiés.
- Ne mettez pas les clés API dans le dépôt de code.
- Pour une mise en œuvre locale, il est également nécessaire de vérifier les politiques de données du modèle et du fournisseur de recherche.
- Assurez-vous que les droits d’accès et le masquage des données sont en place avant de créer une base de vecteurs à partir de documents existants.
- Le journal peut contenir des requêtes, du contenu de page web et du texte généré.
- Définir des contrôles de conservation, de suppression et d’accès pour les données de recherche.
- Les projets à haute sensibilité privilégient l’utilisation de composants locaux approuvés.
Avantages du produit
- Relier la recherche, les questions à plusieurs perspectives, l’organisation et l’écriture en un processus complet.
- La poursuite de questions simulées permet de détecter les lacunes de connaissances plus facilement qu’une seule recherche.
- L’article final contient des citations, ce qui facilite le retour à la page web originale pour vérification.
- Les modules de recherche, d’élaboration d’un plan, d’écriture et de révision peuvent être configurés séparément.
- Co-STORM permet aux utilisateurs de guider activement le processus de recherche.
- Les mind maps dynamiques conviennent aux discussions complexes et à long terme.
- Prend en charge plusieurs modèles, moteurs de recherche et corpus propres.
- La licence MIT facilite la recherche, la modification et le développement secondaire.
- Les articles, le code, les ensembles de données et les matériaux d’expériences de reconstitution sont relativement complets.
Restrictions d'utilisation et précautions
- Les autorités ont clairement indiqué que les résultats ne peuvent généralement pas être publiés directement.
- Citer ne signifie pas que chaque affirmation a été vérifiée avec précision.
- Les pages web impossibles à récupérer génèrent des erreurs 403, des échecs de parsing ou des lacunes de preuves.
- La qualité de la recherche dépend fortement des moteurs de recherche et des modèles linguistiques.
- Plusieurs recherches et génération peuvent entraîner des coûts API élevés.
- Les sujets complexes peuvent donner naissance à des rapports longs, répétitifs ou qui s’éloignent du sujet principal.
- La prévisualisation en ligne n’est pas un produit commercial avec des engagements de service.
- Le déploiement nécessite des compétences en programmation, en gestion de clés et en infrastructure.
- Pages web dynamiques, barrières payantes et couverture limitée des contenus non textuels.
- Les domaines à haut risque doivent être examinés par des professionnels.
- La prévisualisation publique n’est pas adaptée aux sujets sensibles ou confidentiels.
- La licence du code MIT ne comprend pas les frais ni les licences pour des modèles tiers et des services de recherche.
GitHub et l’état open source
Les dépôts officiels de STORM et Co-STORM sont gérés par stanford-oval et sont soumis à la licence MIT. Le projet comprend le paquet principal knowledge_storm, des exemples de STORM et Co-STORM, une interface frontale légère, ainsi que des ensembles de données et des ressources pour la reproductibilité.
Les paquets Python peuvent être installés directement, et le code source peut également être modifié. Les grands modèles tiers, les moteurs de recherche, les services d’incorporation et le téléchargement de contenu restent soumis à leurs propres conditions ; il ne faut pas ignorer ces restrictions sous prétexte que le code STORM est open source.
Informations de base
| champ | Contenu |
|---|---|
| Nom de l’outil | STORM / Co-STORM |
| Équipe de développement | Stanford OVAL |
| Type d’outil | Organisation des connaissances, recherche approfondie et rédaction de rapports détaillés |
| Méthode centrale | Questions à plusieurs perspectives, entretiens simulés, amélioration de la recherche et plan automatique |
| Version en ligne | Research Preview |
| Paquet Python | knowledge-storm |
| Licence open source | MIT |
| Prix | Le code est gratuit, les modèles et les ressources de recherche sont facturés séparément. |
| Fournit-on une API ? | Fournir une interface Python, et non une API commerciale gérée de manière unifiée |
| Sortie principale | Rapports longs avec citations, discussions et organigrammes dynamiques |
Indice de recommandation
4,7 / 5. STORM a transformé la recherche multidimensionnelle et la rédaction de rapports longs en un processus open source étudiable et extensible ; la collaboration homme-machine de Co-STORM est également très utile ; cependant, les citations et les faits doivent encore être vérifiés un par un, et le coût ainsi que la complexité de l’autodéploiement sont élevés.
Questions fréquentes
STORM peut-il être utilisé gratuitement ?
La version en ligne de Research Preview n’a pas de frais de membre publics, et le code source est sous licence MIT. Après déploiement, il faut assumer les coûts liés aux modèles, à la recherche, aux intégrations, aux serveurs et au stockage.
Les articles générés par STORM peuvent-ils être publiés directement ?
Ce n’est pas recommandé. Les autorités affirment clairement qu’il est généralement nécessaire de procéder à de nombreuses modifications ; les citations, les faits, la structure et le style doivent être vérifiés manuellement.
Quelle est la différence entre STORM et Co-STORM ?
STORM est axé sur la recherche automatisée et l’élaboration de documents, tandis que Co-STORM permet aux utilisateurs, aux experts en IA et aux agents de médiation de discuter ensemble et de maintenir des organigrammes dynamiques.
Puis-je utiliser mes propres documents ?
Oui. VectorRM permet de fonder la recherche sur des documents et des bases de vecteurs fournis par l’utilisateur.
Est-ce que les modèles locaux sont pris en charge ?
L’architecture permet de remplacer les composants du modèle, et LiteLLM élargit également la compatibilité. Les modèles locaux spécifiques doivent être testés séparément en fonction du contexte, de la qualité et du matériel.
Pourquoi apparaît-il parfois une erreur 403 ?
Certains sites refusent d’être indexés ou la lecture des pages échoue ; STORM enregistre les erreurs et saute par-dessus le contenu concerné, ce qui peut entraîner des lacunes dans les références et la couverture des informations.
STORM propose-t-il une API commerciale ?
Le projet propose des interfaces de classes et de modules Python, mais ne dispose d’aucun forfait API commerciale géré de manière unifiée. Les développeurs doivent se connecter eux-mêmes aux services de modèles et de recherche.
STORM est-il open source ?
Open source. Le dépôt officiel GitHub et le code de knowledge-storm sont sous licence MIT.
Outils similaires à Storm

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164