




ContextClue - Next-Gen Knowledge Management for Engineering
ContextClue – Gestion des connaissances de nouvelle génération pour l’ingénierie, qui rend la recherche assistée par l’IA plus efficace et plus simple
Étiquettes :Moteur de recherche IAQu’est-ce que ContextClue ?
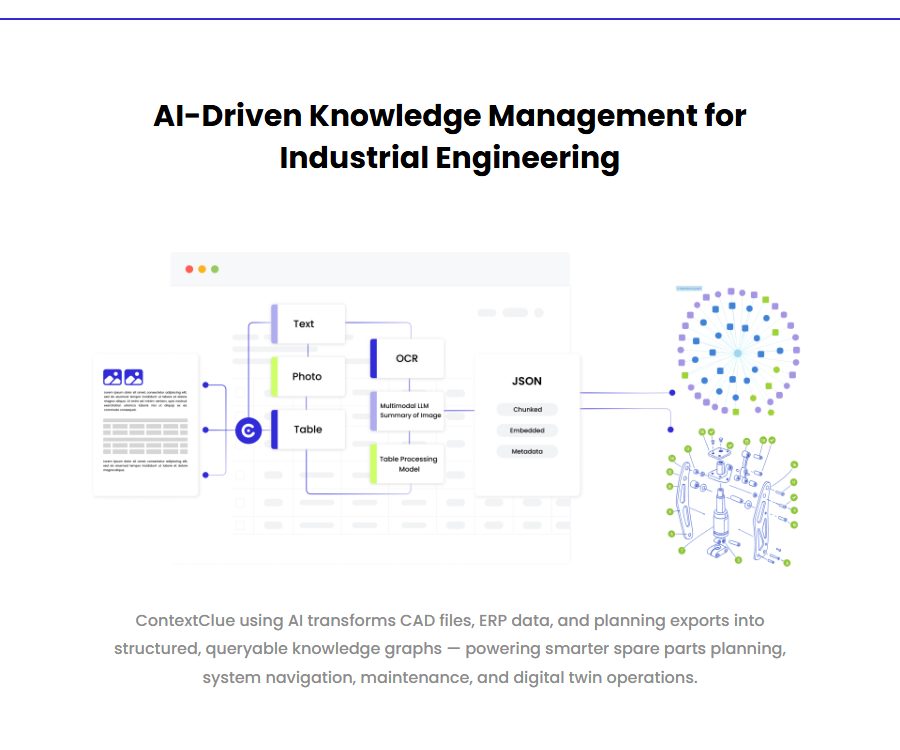
ContextClue est une plateforme de gestion des connaissances d’entreprise développée par l’entreprise d’intelligence artificielle et de conseil en données Addepto, qui cible actuellement les équipes d’ingénierie industrielle, de fabrication, de recherche et développement ainsi que les équipes de maintenance. Elle relie le CAD, l’ERP, le PLM, les documents techniques et les données de planification en une couche de connaissances consultable et traçable.
La plateforme n’est pas un SaaS léger qui peut être utilisé de manière indépendante après inscription, mais plutôt un PaaS de niveau entreprise nécessitant des conseils, une intégration de données, une configuration des droits d’accès et un soutien à la mise en œuvre. Les organisations peuvent choisir le produit complet ou ne déployer que les modules de capture de données, de recherche ou de génération de contenu.
Trois types de modules centraux
Ingestion et normalisation des données
- Connecter les systèmes existants de PLM, ERP, de gestion de documents et de systèmes de fichiers, afin de réduire la nécessité de migrer l’ensemble des données pour mettre en place une plateforme de connaissances.
- Gérer des fichiers CAD, PDF, Word, Excel, export de plans, scans, dépôts de code, etc., et prendre en charge plus de 20 formats de documents techniques.
- En utilisant l’OCR, le classement, la reconnaissance d’entités et le complétion des métadonnées, organiser les documents disparates en une structure unifiée exploitable par l’IA.
- Création automatique de liens entre les pièces, les plans, l’équipement, les emplacements, les niveaux de système et les historiques de maintenance.
Retrieve : Récupération et navigation des connaissances
- Prend en charge les recherches par mots-clés, langage naturel, métadonnées et relations structurelles, permettant de trouver des informations par pièce, fonction, comportement, emplacement ou rôle.
- Les résultats peuvent être présentés sous forme de questions-réponses en chat, d’arbres de système, de recherche sémantique et de graphes de connaissances visuels, ce qui est adapté pour localiser les spécifications et les historiques entre systèmes.
- La plateforme peut synchroniser les données connectées et permet également un renouvellement manuel selon des paramètres configurés ; la fréquence dépend du système spécifique et de la méthode de mise en œuvre.
- Le contrôle d’accès aux rôles est utilisé pour limiter les ensembles de données visibles pour les départements et les utilisateurs, tandis que des outils de communication tels que Slack et Teams peuvent servir d’entrée au travail.
Générer et visualiser
- Utiliser les informations organisées dans la base de connaissances pour générer des premières versions de SOP, de documents techniques, de matériaux de conformité, de rapports de projet et de documents modélisés.
- La sortie peut être destinée à la lecture par des personnes, ou former des données lisibles par des machines telles que du JSON, des graphes de connaissances et des mappages de coordonnées.
- Les relations de cartographie peuvent être utilisées pour la planification des composants, l’analyse de la maintenance, la navigation dans la structure de l’usine et la préparation des données de jumeau numérique.
- Le contenu généré doit encore être examiné par un ingénieur ou le responsable commercial, en particulier pour les étapes de sécurité, les conclusions réglementaires et les paramètres du matériel.
Capacités et valeurs principales
- Compréhension inter-documents : conservation du contexte entre différents fichiers et systèmes, liaison des composants, assemblages, emplacements et événements de maintenance.
- Réutilisation des documents d’ingénierie : trouver plus rapidement des spécifications existantes, des plans et des composants standard, afin de réduire la redondance dans la conception et la perte de connaissances.
- Support technique : suivi des pannes à partir de la vue des équipements, historique des opérations et documents associés, afin d’aider au diagnostic et à la planification des pièces de rechange.
- Automatisation des rapports : rassemblement des données selon des modèles organisationnels, réduction du temps de préparation des SOP, des audits et des rapports de conformité.
- Analyse de données interactive : accès aux bases de données SQL, aux tableaux de bord BI et aux rapports d’affaires par le biais du langage naturel.
- Modèles interchangeables : la plateforme adopte une approche de type plug-and-play pour les modèles, et les LLM réels peuvent être configurés en fonction des besoins du client et des contraintes de déploiement.
Entrée et sortie
| Type de données | Entrées courantes | Mode de traitement | Sortie ou utilisation |
|---|---|---|---|
| Documents d’ingénierie | CAD, plans, BOM, export de la planification | Analyse, reconnaissance d’entités, mappage de relations | Schémas de composants, arbre système, données de jumeau numérique |
| Document général | PDF, Word, scans, rapports | OCR, classification, résumé, index sémantique | Résultats de recherche, questions-réponses, SOP et rapports |
| Système structuré | Données ERP, PLM, SQL, BI | Connexion API, standardisation, synchronisation régulière | Requêtes inter-systèmes, analyse et interprétation des indicateurs |
| Entrée interactive | Problèmes de langage naturel, modèles et exigences de génération | Recherche améliorée de génération et filtrage des permissions | Réponse, brouillon, JSON ou structure de graphe |
Processus de mise en œuvre
- Définir les problématiques commerciales, le public cible, la portée des données, les exigences de conformité et la valeur attendue grâce à des consultations gratuites, et assister à des démonstrations ciblées.
- Choisissez un produit full-stack ou les modules Ingest, Retrieve, Generate, et déterminez le mode de déploiement : pilote, cloud, local ou hybride.
- Les équipes IT et de mise en œuvre établissent des connexions entre les systèmes tels que l’ERP, le PLM et la bibliothèque de documents, et configurent l’authentification, les droits des rôles ainsi que le stockage des données.
- Les fichiers d’échantillons sont récupérés, puis analysés, classés, normalisés en termes d’entités et utilisés pour construire un graphe de connaissances, avant que des experts du domaine ne vérifient la qualité des relations.
- Activer la recherche, les Q&A, la navigation par graphes et les workflows de génération, et définir des modèles de rapports, des règles d’approbation et des interfaces avec les systèmes métier.
- Mener les tests d’acceptation par l’utilisateur et la formation, puis surveiller en continu, après mise en ligne, la qualité de la recherche, les hallucinations, les droits d’accès, la synchronisation et le coût du modèle.
L’intégration de base nécessite généralement plusieurs semaines à plusieurs mois ; l’ampleur, la complexité des fichiers, le nombre de connecteurs et l’optimisation du modèle influencent tous ce délai. Le déploiement au niveau entreprise requiert la participation du service informatique et ne peut pas être effectué uniquement par les utilisateurs finaux.
Comparaison des méthodes de déploiement
| Plan | Composition | Caractéristiques du déploiement | Adéquat pour les utilisateurs |
|---|---|---|---|
| All-in-one Product | Processus complet de gestion des connaissances prédéfini | Moins de personnalisation au niveau du backend, mise en ligne relativement plus rapide, processus plus standardisés | Premières grandes organisations à mettre en place une plateforme de connaissances unifiée |
| Modular Integration | Sélectionner selon les besoins les modules d’acquisition, de recherche ou de génération | Intégration dans les systèmes existants, personnalisation plus poussée, possibilité de mise en œuvre pilote avant expansion | Équipes disposant déjà d’une stack technologique ou souhaitant résoudre uniquement des goulots d’étranglement spécifiques |
| Déploiement dans le cloud | Infrastructure de gestion et connexion aux entreprises | Facile à étendre, l’emplacement des données et les limites des services doivent faire l’objet d’une confirmation par contrat. | Les organisations qui acceptent l’environnement cloud et valorisent l’élasticité |
| Déploiement local ou hybride | Environnement client ou combinaison cloud et local | Souveraineté et contrôle des données plus forts, exigences en matière de matériel et d’exploitation plus élevées | Scénarios de données sensibles tels que la fabrication, la médecine et le droit |
Prix et modalités d’achat
ContextClue ne publie pas de prix uniforme par utilisateur ou par volume d’utilisation ; pour les projets professionnels, un devis est nécessaire en fonction du volume de données, des modules, des connecteurs, du mode de déploiement et de l’étendue des personnalisations. Une consultation gratuite ne signifie pas un produit gratuit ni une version d’essai gratuite.
| Forfait ou version | Prix | Période de facturation | Droits ou crédit principal | Adéquat pour les utilisateurs |
|---|---|---|---|---|
| Plan Phase de planification | Gratuit | Communication initiale unique | Consultation LLM, sélection de fonctionnalités et démonstration ; sans système de production | Organisation chargée d’évaluer les besoins et la faisabilité |
| Mise en œuvre | Cotation sur mesure | Prix fixe du projet | Analyse des cas d’utilisation, déploiement dans l’environnement, ingestion de données, personnalisation, validation et mise en production | Équipe pilote ou équipe de construction officielle |
| Maintenance Entretien | Cotation sur mesure | Chaque mois | Maintenance et support du système, niveaux de service spécifiques selon le contrat | Clients déjà mis en ligne et nécessitant une maintenance continue |
La page publique ne mentionne pas le crédit d’essai, le nombre de licences autorisées, la politique de remboursement, les frais de modèles, les coûts matériels ou les valeurs SLA. Avant l’achat, il convient de vérifier point par point dans la proposition et le contrat les critères d’acceptation de la mise en œuvre, l’étendue des modifications, les frais liés à des tiers, les modalités de sortie et de migration des données.
API, modèles et intégration
- La plateforme adopte une architecture API-first, permettant de se connecter aux systèmes d’entreprise et d’intégrer des fonctionnalités modulaires dans les processus existants, mais ne fournit pas de documentation complète des API du produit ni de SDK universel.
- Selon les documents publics, le modèle peut être configuré en fonction des besoins du client ; il ne faut pas considérer un fournisseur de modèles particulier ou un modèle spécifique comme une configuration fixe.
- Les exigences en matière de matériel dépendent du volume de données, du nombre d’utilisateurs simultanés et du déploiement du modèle ; il existe une grande différence entre de petits projets pilotes et des installations d’entreprise traitant des millions de fichiers.
- Il n’y a pas de limite fixe et uniforme pour le stockage ; la capacité réelle est déterminée par l’infrastructure déployée, les prévisions de croissance et le contrat.
Licences de projets et produits open source
| Projet | Statut open source | Utilisation principale | Relation avec ContextClue |
|---|---|---|---|
| Plateforme complète ContextClue | Licence open source non divulguée | Gestion des connaissances d’entreprise et déploiement sur mesure | Produits commerciaux |
| ContextClue Graph Builder | Licence MIT | Extraction d’un graphique de connaissances à partir de documents et de tableaux, avec des implémentations en Python et FastAPI | Outils de construction de cartes publiques |
| ContextCheck | Licence MIT | Tester les LLM, RAG et chatbots avec YAML, intégration possible dans CI | Cadre d’évaluation de la qualité public |
Deux projets open source ne sont que des outils indépendants au sein d’un écosystème de produits complet ; on ne peut donc pas en déduire que l’ensemble de la plateforme d’entreprise ContextClue est entièrement open source. La version actuelle de Graph Builder ne conserve pas de manière permanente les graphes en cours d’exécution au-delà d’une redémarrage API, et une conception de persistance supplémentaire est nécessaire pour une utilisation en production.
Confidentialité, sécurité et droits d’auteur
- La plateforme prend en charge le déploiement local, cloud et hybride, et permet de configurer une authentification forte, des droits par rôle, du chiffrement et de la surveillance ; la décision d’activer ces fonctionnalités dépend du plan de mise en œuvre.
- L’organisation peut limiter les systèmes et ensembles de données auxquels ContextClue a accès, et choisir l’emplacement où les données seront stockées en fonction des exigences régionales.
- La politique de confidentialité publique d’Addepto couvre principalement les visites du site et les données de contact, indiquant que sa société polonaise en est le responsable, et porte sur les cookies, l’analyse du site, le marketing, l’hébergement ainsi que les prestataires essentiels.
- Les rôles de traitement des documents d’entreprise, des indications, des appels de modèles et des résultats générés, la durée de conservation, les transferts transfrontaliers ainsi que les utilisations pour l’entraînement doivent être spécifiquement définis dans le contrat du produit et l’accord de traitement des données.
- Le contenu du site est la propriété d’Addepto ; l’utilisation de la plateforme commerciale est déterminée par un contrat, tandis que les modules open source sont soumis à la licence MIT.
- La page publique ne mentionne pas les modalités de remboursement des produits ; les étapes de paiement du projet, l’acceptation, la résiliation ainsi que l’annulation de la maintenance doivent être stipulées dans le contrat.
Limites des capacités
- La qualité de l’analyse des fichiers CAD, des scans et des documents historiques dépend du format du fichier, de la clarté de l’image, de la cohérence de la nommage et de l’intégralité des métadonnées.
- Les entités ou relations erronées dans les graphes de connaissances se propagent aux résultats de recherche et de génération, nécessitant une vérification et une correction par des experts du domaine.
- Les réponses aux dialogues et les documents automatisés peuvent présenter des omissions ou des illusions ; ils ne doivent pas être utilisés directement pour des opérations critiques en matière de sécurité sans avoir été vérifiés.
- Les solutions modulaires réduisent le besoin de remplacer les systèmes, mais l’intégration d’ERP, de PLM anciens ou de systèmes développés en interne peut encore nécessiter un développement sur mesure.
Questions fréquentes
À quels types d’entreprises ContextClue convient-il principalement ?
Il convient mieux aux organisations qui disposent d’une grande quantité de documents techniques, de données ERP ou PLM, et qui ont besoin de recherches inter-systèmes, de graphes de connaissances, de maintenance ou d’automatisation des documents.
ContextClue est-il un SaaS ordinaire ?
Ce n’est pas un simple SaaS à usage autonome. Il s’agit d’une plateforme d’entreprise qui nécessite des conseils, une intégration IT, une mise en œuvre et un soutien continu, l’intégration de base prenant généralement plusieurs semaines à plusieurs mois.
Peut-on l’installer localement ?
Oui. La plateforme prend en charge le déploiement cloud, local et hybride ; l’emplacement des données, les modèles, le matériel ainsi que les contrôles de sécurité doivent être déterminés lors de la phase de mise en œuvre.
Y a-t-il une version gratuite de ContextClue ?
La phase gratuite comprend uniquement des consultations, le choix des fonctionnalités et une démonstration, sans inclure la plateforme de production. La mise en œuvre est facturée selon un tarif forfaitaire pour projet, tandis que les services de maintenance sont facturés mensuellement.
ContextClue est-il open source ?
La plateforme d’entreprise complète ne dispose pas de licence open source publique. Graph Builder et ContextCheck sont des projets associés utilisant respectivement la licence MIT.
Quels fichiers et systèmes sont pris en charge ?
Les entrées courantes incluent CAD, PDF, Word, Excel, scans, exportations de plans et dépôts de code ; il est également possible de se connecter à des systèmes ERP, PLM, SQL, BI et systèmes de documents.
Outils similaires à ContextClue – Gestion du savoir de nouvelle génération pour l’ingénierie

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164