




DumplingAI
DumplingAI, outil intelligent spécialisé dans la recherche par IA
Étiquettes :Moteur de recherche IAUne phrase pour présenter
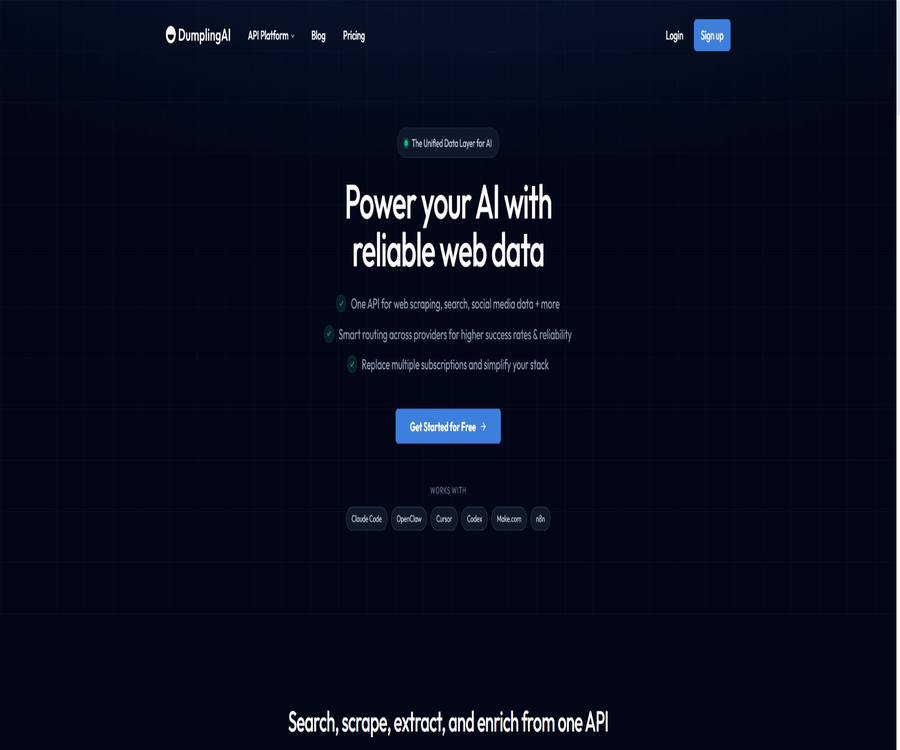
DumplingAI est une plateforme API de données unifiée destinée aux agents IA, aux développeurs et aux équipes d’automatisation, qui permet d’accéder, depuis le même compte, à la recherche en temps réel, au scraping de pages web, aux données sociales, à l’extraction de documents et de médias, à la génération d’images, à des bases de connaissances ainsi qu’à l’exécution de code dans le cloud.
Présentation des outils
DumplingAI intègre les capacités, auparavant dispersées dans la recherche, les outils d’exploration web, YouTube, TikTok, LinkedIn, PDF et les services de modèles, sous un solde de points unique. Les utilisateurs peuvent choisir l’API directe, l’automatisation sans code, MCP, la CLI ou une plateforme d’automatisation du contenu.
Le site officiel indique que la plateforme dispose de plus de 50 capacités de traitement des données, et le catalogue public actuel présente 35 points d’API. Le nombre de capacités et le nombre de points d’API ne sont pas identiques : un même point d’API peut prendre en charge plusieurs modèles, canaux ou paramètres de traitement.
Mode d’accès
| Méthode | Certification | Scénarios adaptés | Caractéristiques principales |
|---|---|---|---|
| Unified API v2 | Clé API porteur | Création d’une intégration de données et d’un appel unifié | Fonctionne en fonction des capacités ou des points d’entrée du fournisseur ; la recommandation officielle est d’utiliser ce mode en priorité pour les nouveaux projets. |
| Direct API v1 | Clé API porteur | Compatibilité avec les endpoints directs existants | Conserver la structure des demandes spécifiques et les anciens processus automatisés |
| MCP à distance v2 | Connexion OAuth | Clients d’agents tels que Claude, Codex, Cursor, ChatGPT, etc. | Il n’est pas nécessaire de coller la clé API dans le client. |
| Serveur MCP open source | Clé API de DumplingAI | Commande locale ou processus MCP autogéré | Licence MIT, pouvant être exécutée via npm ou des conteneurs |
| CLI | Connexion OAuth | Capacité d’exploration de terminal et exécution de tâches | Idéal pour rechercher dans les catalogues, visualiser les entrées/sorties et effectuer des tests rapides |
| Plateforme sans code | Clés API pour les identifiants de connexion | Make, n8n, Zapier, etc. | Idéal pour les workflows ne nécessitant pas de backend personnalisé |
Capacités principales
Recherche et découverte en temps réel
La capacité de recherche couvre les pages web, les actualités, les cartes, les lieux, les suggestions de recherche et les avis Google. La recherche sur les pages web peut être filtrée par pays, lieu, langue et période de temps, et il est possible de choisir de ne récupérer que les premiers résultats.
Extraction de pages web, crawling et extraction structurée
La plateforme peut extraire une page à la fois, parcourir un site de manière récursive, prendre des captures d’écran des pages web, et extraire des champs selon les instructions et les modèles de structure fournis par l’utilisateur. La rendu dynamique des pages, le défilement automatique et les paramètres de mise en attente peuvent augmenter les coûts.
Données YouTube
Il est possible d’obtenir des sous-titres vidéo, des informations sur la vidéo, des données sur la chaîne, les vidéos de la chaîne, Shorts, des commentaires et des résultats de recherche. Les données publiques peuvent être utilisées pour la recherche et les workflows de contenu, mais il reste nécessaire de respecter les conditions de la plateforme et les droits sur le contenu.
Données de TikTok et LinkedIn
Le catalogue liste les utilisateurs TikTok, les vidéos, les commentaires, les relations de suivi, les sous-titres et les recherches des utilisateurs, et offre également l’extraction des informations personnelles et professionnelles LinkedIn. Le traitement des profils concerne la vie privée, les restrictions d’utilisation et les lois locales ; il ne doit pas être effectué de manière massive et sans distinction.
Traitement de documents et de PDF
L’API peut convertir des documents en texte ou en PDF, fusionner des PDF, lire et écrire des métadonnées PDF, ainsi que extraire du contenu structuré à partir des documents. Les différentes requêtes consomment des points en fonction du nombre d’appels, du nombre de pages ou de la taille du fichier de sortie.
Extraction d’images, d’audio et de vidéo
La plateforme peut extraire du texte ou des objets à partir d’images, générer des transcriptions et des analyses à partir d’audio, ainsi que des sous-titres, des scènes ou des objets à partir de vidéos. L’audio est facturé en fonction de la durée, et la vidéo en fonction du nombre de secondes ; les coûts liés aux médias longs augmentent rapidement.
Cadrage vidéo
Le découpage vidéo permet de créer des extraits en fonction des délais de début et de fin, et de définir la qualité de sortie ainsi que le taux de rafraîchissement. La facturation se fait en fonction des minutes du vidéo de sortie, arrondi à l’unité supérieure ; il convient de calculer le budget avant de traiter des fichiers en masse.
Génération d’images par IA
L’API d’images prend en charge des modèles tels que FLUX.1 schnell, dev, pro, 1.1 pro, Kontext pro et Recraft v3, et permet de définir des prompts, des proportions, des quantités, une qualité ainsi que des paramètres spécifiques au modèle. Le coût de chaque image varie en fonction du modèle.
Agent d’IA et base de connaissances
La plateforme offre des fonctionnalités de complétion d’agent, de recherche dans une base de connaissances et d’écriture de contenu, permettant de fournir des données externes aux modèles pour qu’ils y répondent ou en tant que contexte de recherche. La génération par l’agent est facturée en fonction du nombre total de tokens d’entrée et de sortie.
Exécution de Python et JavaScript dans le cloud
Les outils de développement permettent d’exécuter Python ou JavaScript dans un environnement cloud contrôlé, et de déclarer les dépendances, les délais et les fichiers de sortie selon les besoins. Les entrées externes ne peuvent pas être exécutées directement en tant que code fiable ; il est nécessaire de limiter les dépendances, les temps d’exécution et les droits sur les données.
Catalogue des compétences
| Catégorie | Capacité de représentation | Utilisations courantes |
|---|---|---|
| Pages web et données | Extraction, crawling, capture d’écran, extraction structurée par IA | Collecte de RAG, surveillance et structuration des informations |
| Recherche et lieu | Pages web, actualités, cartes, lieux, recommandations, commentaires | Recherche en temps réel, commerce local et découverte de tendances |
| YouTube | Sous-titres, vidéos, chaînes, Shorts, commentaires et recherche | Analyse de contenu, réutilisation et étude des chaînes |
| TikTok | Utilisateurs, vidéos, commentaires, abonnements et sous-titres | Recherche sur les vidéos courtes et analyse de données publiques |
| Données personnelles et d’entreprise | Recherche d’entreprise et informations abondantes | |
| Documents et PDF | Convertir en texte, convertir en PDF, fusionner, métadonnées et extraction | Chaîne de traitement des documents et stockage des connaissances |
| Médias | Extraction d’images, d’audio et de vidéo ainsi que découpage vidéo | Transcription, analyse visuelle et montage de contenu |
| AI | Agent, base de connaissances et génération d’images | Applications intelligentes et génération de contenu |
| Code | Exécution en cloud de Python et JavaScript | Conversion de données et logique personnalisée |
Différences entre v1, v2 et MCP
| Projet | v1 endpoint direct | Plateforme unifiée v2 | MCP v2 |
|---|---|---|---|
| Positionnement | Répertoire des endpoints existants | Interface prioritaire pour la recommandation de nouveaux projets | Permettre à l’application IA d’utiliser directement les outils |
| Organisation des chemins | Chaque fonction dispose d’une structure de demande directe | Entrée d’exécution unifiée et identification des capacités | Protocole d’outil MCP à distance |
| Certification | Clé API | Clé API | OAuth |
| Adéquat pour les utilisateurs | Intégration et points d’extrémité spécifiques déjà disponibles | Développeurs et automatisation sans code | Utilisateurs de Claude, Codex, Cursor et ChatGPT |
| Relations de compte | Partager le compte et la clé API avec v2 | Partager le compte et la clé API avec v1 | Se connecter au même service DumplingAI |
v1 et v2 peuvent coexister dans le même compte ; il n’est pas nécessaire de migrer immédiatement tous les flux de travail anciens. Pour les nouvelles fonctionnalités et les intégrations à long terme, v2 doit être évalué en priorité, tandis que les endpoints stables existants peuvent être migrés progressivement après vérification de leur équivalence.
Tutoriel d'utilisation
Effectuer la première appel avec l’API v2
- Inscrivez-vous sur DumplingAI, créez une clé API dans le tableau de bord et conservez-la dans un outil de gestion de clés sécurisé.
- Ouvrez Workbench, recherchez la capacité souhaitée et vérifiez les champs d’entrée, la structure de sortie et le coût d’intégration.
- Utilisez une entrée d’exécution unifiée pour spécifier le type de capacité, l’identifiant de capacité et les paramètres d’entrée.
- Utilisez la clé Bearer dans l’en-tête de demande Authorization, et ne l’inscrivez pas dans l’interface du navigateur.
- Testez d’abord la structure de réponse avec le plus petit nombre de résultats, des fichiers courts ou des requêtes une seule page.
- Lire la quantité d’unités utilisées dans les résultats de lecture réussie, et gérer les erreurs de paramètres, le throttling et les erreurs de service.
- Intégrez au lancement le renouvellement des clés, des plafonds de budget, des tentatives de reprise différées, du cache et du masquage des journaux.
Se connecter au MCP distant
- Vérifier que le client AI utilisé prend en charge les connexions MCP à distance et OAuth.
- Ajouter le service MCP distant DumplingAI au client et initier l’autorisation.
- Connectez-vous avec votre compte DumplingAI et n’accordez que l’accès nécessaire pour le travail en cours.
- Après la connexion, consultez les outils de recherche, d’extraction, de documents, de médias et de code mis à disposition.
- Exécuter d’abord une requête à faible coût pour vérifier que la sortie de l’outil et la déduction de points correspondent aux attentes.
- Définir des limites de confirmation manuelle et d’appel pour le scraping de pages web, les profils personnels et l’exécution de code.
- Désactivez la connexion OAuth du compte lorsque vous ne l’utilisez plus.
Créer des flux de travail de données sur des plateformes sans code
- Créez une clé API spécifique à ce flux de travail dans DumplingAI.
- Enregistrez la clé comme identifiants de connexion dans Make, n8n, Zapier ou d’autres plateformes.
- Sélectionnez la recherche, le scraping, les données sociales ou le traitement de documents comme étapes du flux de travail.
- Vérifier la mise en correspondance des champs, le pagination, les résultats vides et les branches d’erreur à l’aide d’entrées de exemple.
- Effectuer la suppression des doublons et la vérification du format avant d’enregistrer les résultats dans un tableau, une base de données ou un système de contenu.
- Définir le nombre de pages par exécution, la longueur du fichier et le budget de points maximal.
- Surveiller l’historique d’exécution pour éviter que les tâches planifiées ne consomment rapidement des points en étant déclenchées en boucle ou de manière répétée.
Processus de recherche et d’extraction
La requête de recherche peut retourner des résultats naturels, des résumés sélectionnés, des questions pertinentes et des recherches similaires ; il est également possible de choisir de récupérer les pages les mieux classées. Le nombre de résultats récupérés ne peut pas dépasser 10, et par défaut, 3 résultats sont généralement obtenus en l’absence de spécification.
- Le coût de base de la recherche est calculé en fonction de la page de résultats ; l’extraction continue de pages entraîne une déduction supplémentaire en points d’extraction.
- La région, le lieu, la langue et la période de dates doivent être en accord avec les objectifs de la recherche.
- Pour le téléchargement du résultat, vous pouvez choisir Markdown, HTML ou une capture d’écran, et définir s’il faut le nettoyer.
- Le rendu dynamique et les temps d’attente augmentent le temps de fonctionnement, et les captures d’écran peuvent également ajouter des points.
- Le classement des résultats et le contenu de la page changeront, les faits clés doivent être enregistrés dans le temps et vérifiés de manière croisée.
- Les conditions d’accès au site cible, les règles robots et les restrictions relatives aux données personnelles restent en vigueur.
Traitement de documents et de médias
| Capacité | Points de base | Facturation supplémentaire |
|---|---|---|
| Transformer un document en texte | 20/fois | Selon les paramètres de l’endpoint actuel |
| Convertir en PDF | 50/par 100 MB de sortie | Selon la taille du PDF de sortie |
| Fusionner PDF | 50/par 100 MB de sortie | Selon la taille du PDF de sortie |
| Lire les métadonnées PDF | 10/fois | Aucun élément supplémentaire public |
| Écrire des métadonnées PDF | 50/par 100 MB de sortie | Selon la taille du PDF de sortie |
| Extraire le document | 100/pour partie | 10 de plus par page traitée |
| Extraire l’image | 100/pour partie | 10 supplémentaires par image |
| Extraire l’audio | 100/pour partie | 20 de plus par minute, arrondi à l’entier supérieur |
| Extraire une vidéo | 100/pour partie | 10 de plus par seconde pour la vidéo |
| Couper une vidéo | 200 par minute de sortie | Arrondir à l’entier supérieur par minute |
L’extraction de vidéos longues est facturée au nombre de secondes, ce qui peut entraîner des coûts nettement plus élevés que pour les sous-titres ou les points de recherche. Pour les tâches en masse, il convient d’abord de prendre des échantillons courts pour estimer l’intégrale, puis de définir la durée, le nombre de fichiers et le nombre maximal de tentatives en cas d’échec.
Intégrale des points d’extrémité de données courantes
| Fonctionnalité | Coût actuel des points | Explication |
|---|---|---|
| Extraction de pages web | 10/fois | Les paramètres dynamiques peuvent affecter le traitement réel. |
| Crawling de site web | 10 par page | À mesure que le nombre de pages de retour augmente |
| Screenshot de page web | 20/fois | Défilement automatique ou attente non nulle : +10 respectivement |
| Extraction structurée par l’IA | 250/pour partie | Traiter les pages web selon les instructions structurelles |
| Données de vidéos ou de chaînes YouTube | 10/fois | Facturation séparée pour chaque point de terminaison |
| Sous-titres YouTube | 20/fois | Tarification selon le document actuel |
| Points d’accès couramment utilisés pour TikTok et LinkedIn | 10/fois | Se référer aux points d’extrémité spécifiques. |
| Recherche sur le web | 30 par page | Des frais supplémentaires seront facturés pour les résultats de récupération. |
| Recherche de carte | 100 par page | Le prix varie selon le lieu et la recherche ordinaire. |
| Recherche de lieu ou d’actualités | 30 par page | Tourner la page pour continuer à être facturé |
| Commentaires Google | Chaque 10, 50 | Moins que ou supérieur à : arrondi à l’entier supérieur par groupes de 10 |
| Exécuter Python ou JavaScript | 50/pour partie | Les dépendances externes et les ressources restent limitées |
Score de compétences en IA
| Capacités de l’IA | Coût intégral | Indications clés |
|---|---|---|
| Agent Completion | 10 pour 1000 tokens totaux | Total entrées et sorties |
| FLUX.1 schnell | 30 par pièce | Génération rapide d’images |
| FLUX.1 dev | 150 par pièce | Soutien à des paramètres plus riches |
| FLUX.1 pro | 300 par pièce | Modèle de haut niveau |
| FLUX.1.1 pro | Chaque pièce 500 | Le coût est élevé dans la liste actuelle |
| FLUX.1 Kontext pro | 200 par pièce | Soutien à l’édition de diagrammes de référence |
| Recraft v3 | 200 par pièce | Soutient plusieurs tailles et styles |
| Outil de recherche Perplexity | 50 pour 1000 tokens | Utilisation en tant qu’outil Agent |
Prix et forfaits
Au 22 août 2026, le site officiel propose trois forfaits avec facturation annuelle. La page affiche le prix mensuel moyen après paiement annuel, tandis que la limite annuelle est indiquée d’un seul coup selon le plan choisi ; les taxes et le montant final à payer sont ceux indiqués sur la page de commande.
| forfait | Affichage mensuel moyen | Référence de paiement annuel | Points annuels | Taux de demande | Soutien |
|---|---|---|---|---|---|
| Starter | 40 dollars/mois | 480 dollars/an | 1,2 million | 30 fois/minute | Soutien de base |
| Pro | 124 dollars/mois | 1488 dollars/an | 4,2 millions | 60 fois/minute | Support standard |
| Business | 249 dollars/mois | 2988 dollars/an | 9,6 millions | 120 fois/minute | Soutien prioritaire |
Règles de scoring
- Un solde peut être utilisé pour plus de 50 fonctionnalités de données et d’IA sur la plateforme.
- Chaque action et chaque paramètre consomme de un à plusieurs points, et il ne faut pas se baser uniquement sur le nombre de demandes.
- Les points du plan d’abonnement ne sont pas transférés au cycle suivant.
- Les forfaits de points achetés séparément ne expirent pas et sont utilisés une fois que les points de l’abonnement sont épuisés.
- Les demandes échouées ne déduisent pas de points, seules les demandes réussies sont facturées.
- Il est possible d’activer la recharge automatique, qui permet d’acheter automatiquement des forfaits de points lorsque le solde est inférieur à un seuil.
- Pour une consommation supérieure de manière continue au forfait standard, vous pouvez contacter les services officiels afin d’en discuter pour un plan à grande échelle.
Changement de la méthode de calcul des points
Les autorités ont ajusté la valeur des points le 19 novembre 2025 ; les nouveaux points équivalent à un dixième du coût des anciens points. Lors de la vérification des anciennes données, il faut multiplier les valeurs historiques par 10 avant de les comparer avec le tableau actuel ; il n’est pas possible d’utiliser directement le nombre de points indiqué dans les anciens blogs.
MCP et CLI
| Projet | MCP à distance v2 | Serveur MCP open source officiel | CLI |
|---|---|---|---|
| Emplacement d’exécution | Hébergement par DumplingAI | Environnement local ou géré par l’utilisateur | Terminal local |
| Certification | OAuth | Clé API dans la variable d’environnement | OAuth |
| Installation | Ajout d’un service distant par le client | npm, Smithery ou conteneurs | Exécuter avec npx |
| Utilisation principale | Appel direct des capacités depuis le client IA | Intégration MCP locale traditionnelle | Rechercher dans le catalogue, voir les détails et tester les capacités |
| Code source | Le service de gestion n’est pas open source | Répertoire sous licence MIT | L’état du code source complet doit être confirmé selon le projet. |
Authentification API et pratiques d’ingénierie
- Les clés API ne doivent être stockées que dans le système de gestion des clés du serveur, et ne doivent pas être soumises à Git, aux journaux ou au code frontend.
- Séparer les clés en environnements de développement, de test et de production, et mettre en place des processus de rotation et d’annulation.
- Lire le champ de réponse de limitation de débit, en utilisant un recul exponentiel plutôt que des tentatives sans limite.
- Fixer des limites maximales pour le pagination, la durée des médias et le nombre de pages à indexer.
- Une réponse réussie doit également vérifier la structure, les canaux, les valeurs nulles et l’utilisation des points.
- Utiliser un cache pour les résultats de recherche et d’extraction, afin d’éviter les requêtes répétées et la pression sur les sources de données.
- Lorsque le MCP à distance n’est plus utilisé, l’autorisation OAuth est annulée, tandis que le MCP local renouvelle les clés API en temps opportun.
À qui s’adresse-t-il
- Développeur d’agent IA : besoin d’outils unifiés pour la recherche, les pages web, les réseaux sociaux, les documents et le code.
- Ingénieur en automatisation : combiner plusieurs étapes de traitement de données dans Make, n8n ou Zapier.
- Équipe de contenu : extraction des sous-titres vidéo, des commentaires et du contenu des documents pour les intégrer au processus de publication.
- Équipe de recherche et de surveillance : obtention de pages web en temps réel, d’actualités, de coordonnées géographiques et de données sociales publiques.
- Développeur SaaS : réduire les coûts de maintenance liés à la connexion à plusieurs fournisseurs de données grâce à une API unifiée.
- Utilisateur MCP : Permettre à Claude, Codex, Cursor ou ChatGPT d’appeler directement des données externes.
Scénarios d'utilisation typiques
- Laissez l’agent de recherche d’abord rechercher des nouvelles, puis extraire les pages et générer un résumé structuré.
- Obtenir régulièrement les sous-titres et les commentaires de YouTube afin de créer une base de données sur les sujets abordés et les retours des utilisateurs.
- Extraire du contenu de PDF, d’images, d’audio et de vidéo pour l’enregistrer dans une base de connaissances.
- Récupérer les informations des produits du site et les exporter dans un tableau ou un CRM selon une structure fixe.
- Enrichir les fiches d’entreprise sur les pages publiques, mais établir des limites conformes pour les données personnelles.
- Exécuter en cloud de la logique Python ou JavaScript courte pour nettoyer les résultats d’une API.
- Fournir des outils de recherche, de documents et de médias via MCP aux clients IA pour qu’ils les appellent selon leurs besoins.
Confidentialité et traitement des données
Selon la politique de confidentialité, les utilisateurs peuvent fournir des données à DumplingAI pour aider à « entraîner » l’IA, certaines de ces données pouvant être stockées dans le système afin d’améliorer les services. Avant de traiter des données sensibles, relatives aux clients ou protégées par des contrats, il convient de s’assurer auprès des responsables des limites précises des données, des modalités de retrait et de la durée de conservation.
La plateforme utilise PostHog et Google pour l’analyse des pages web et des produits, Stripe pour les paiements, et les tâches peuvent être traitées par des fournisseurs de modèles tels que OpenAI, Anthropic, Perplexity, Groq, etc. La politique stipule qu’aucunes données des utilisateurs ne sont partagées publiquement, mais les exigences légales et le traitement nécessité par des tiers constituent des exceptions.
Conseils sur la vie privée et la conformité
- Ne passez pas les clés API, les mots de passe, le contenu des dépôts privés et les données clients non masquées à des tâches publiques.
- En traitant les données personnelles, enregistrer l’usage légal, les champs minimums, la durée de conservation et la procédure de suppression.
- LinkedIn, TikTok, YouTube et le scraping de pages web sont également soumis aux règles de la plateforme cible.
- Lors de l’exécution de code dans le cloud, il est interdit d’assembler directement du contenu de pages web non fiables en code.
- Confirmer les options de stockage temporaire ou permanent pour les fichiers médias et les actifs générés.
- Les utilisateurs en Europe et dans d’autres régions peuvent demander l’accès à leurs informations personnelles ou leur suppression.
- Avant d’effectuer des achats, l’entreprise doit compléter par un accord de traitement des données, des sous-traitants et une vérification des contrôles de sécurité.
Contenu, droits d’auteur et licences de données
- Le fait que l’API puisse accéder à des données publiques ne signifie pas que l’utilisateur a automatiquement le droit de les copier, de les républier ou de les vendre à des fins commerciales.
- Les résultats de recherche, les informations sociales, les commentaires, les sous-titres, les images et les documents ont chacun leurs propres voies de droits.
- L’autorisation de consultation temporaire mentionnée dans les conditions du site ne peut pas être simplement assimilée à une autorisation commerciale illimitée pour les résultats de l’API.
- Tenter de récupérer du contenu restreint par un accès enregistré, payant ou restreint peut enfreindre les règles du service cible.
- Les images générées par l’IA doivent toujours faire l’objet d’une vérification des risques liés aux marques, aux personnages, aux portraits et aux données d’entraînement.
- Les ensembles de données publiés à l’extérieur doivent conserver le canal d’archivage, l’heure de capture, l’utilisation des champs et le mécanisme de suppression.
API, SDK et situation du logiciel open source
| Projet | Résultat de la vérification | Explication |
|---|---|---|
| API publique | Fournir | Coexistence de l’endpoint direct v1 et de la plateforme unifiée v2 |
| Certification | Clé API porteur | v1 et v2 partagent le même compte et la même clé. |
| MCP à distance | Fournir | v2 utilise OAuth et ne nécessite pas de coller de clé API. |
| CLI officielle | Fournir | Exécuter via npx et utiliser OAuth |
| Entrepôt officiel MCP | Open source | Implémentation en JavaScript, licence MIT |
| SDK officiel universel | Aucun résultat trouvé | On peut appeler directement l’API ou utiliser MCP avec la CLI |
| La plateforme elle-même | Pas open source | Le fait que les connecteurs MCP soient open source ne signifie pas que les services de gestion de données le soient également. |
Avantages du produit
- Un compte et un solde de points couvrent la recherche, le scraping, les réseaux sociaux, les documents, les médias, l’IA et le code.
- L’API unifiée v2 réduit les différences en matière d’authentification et d’appel entre les différentes capacités.
- v1 et v2 coexistent, ce qui facilite la migration progressive des intégrations existantes.
- Prend en charge simultanément les API, le sans code, le MCP à distance, le MCP local et la CLI.
- Le document des coûts de crédit est détaillé par page, minute, seconde, image et modèle, ce qui facilite l’établissement du budget.
- Les demandes échouées ne déduisent pas de points, les forfaits de points supplémentaires ne expirent pas et permettent de faire face aux pics à court terme.
- Le serveur MCP officiel utilise la licence MIT, ce qui permet d’examiner et d’étendre le code des connecteurs.
Restrictions d'utilisation et précautions
- Tous les forfaits publics sont facturés annuellement ; le prix mensuel affiché est uniquement une conversion pour un paiement annuel.
- Les points de abonnement ne sont pas transférables, ce qui peut entraîner un gaspillage de solde dans les mois à faible utilisation.
- Chaque capacité a un coût différent ; les vidéos longues, les cartes et l’extraction structurée peuvent consommer rapidement des points.
- Le service agrège plusieurs fournisseurs externes ; la stabilité, la couverture et la structure des données peuvent varier en fonction du canal.
- Les interfaces de socialisation et de profil présentent des risques en matière de confidentialité, de règles de la plateforme et de précision des données.
- La politique de confidentialité autorise certaines utilisations pour l’entraînement ou l’amélioration ; les données sensibles nécessitent une confirmation supplémentaire.
- Le serveur MCP open source n’est qu’un connecteur ; le traitement réel des données dépend toujours d’une API cloud payante.
- Aucun SDK de langue officielle commune n’a été trouvé ; l’équipe de développement doit elle-même gérer les tentatives de réessai, le pagination et les types.
Informations de base
| Projet | Contenu |
|---|---|
| Nom de l’outil | DumplingAI |
| Type d’outil | API de données unifiée, plateforme d’automatisation et d’outils d’agents IA |
| Échelle de capacité | Plus de 50 capacités, catalogue public présentant 35 points d’API |
| Catégories principales | Recherche, capture, réseaux sociaux, documents, médias, IA et code |
| Version API | Étendue directe v1 et plateforme unifiée v2 |
| MCP | OAuth MCP à distance et serveur local open source officiel |
| CLI | Fournir |
| Forfait public minimum | Équivalent annuel du starter : 40 dollars/mois |
| Règles de scoring | Les points d’abonnement ne sont pas transférables, les forfaits de points ne expirent pas, le paiement n’est facturé qu’en cas de demande réussie. |
| Taux de demande | 30, 60 ou 120 fois/minute, selon le forfait |
| SDK officiel | Aucun SDK de langage universel non trouvé |
| Statut open source | La plateforme n’est pas open source ; le serveur MCP officiel est sous licence MIT |
Indice de recommandation
Indice de recommandation : 4,5 / 5. DumplingAI offre une large gamme de capacités, des méthodes d’intégration complètes, des documents détaillés sur les coûts, et s’adapte aux workflows modernes d’agents IA via v2, MCP et CLI.
Les principaux obstacles sont le paiement annuel requis, les systèmes de points complexes et la conformité avec différentes sources de données. Cela convient aux équipes de développement capables de définir des budgets, de gérer le cache, d’assurer la gouvernance des données et de gérer les erreurs, mais ce n’est pas adapté à ceux qui considèrent l’extraction de données et les interfaces de profils comme des canaux de données accessibles sans condition.
Questions fréquentes
DumplingAI est-il gratuit ?
La page des prix actuellement publiée ne propose pas de forfait gratuit fixe ; le tarif minimum est de 40 dollars par mois pour l’abonnement annuel Starter. Après approbation de la demande pour le Creator Program, il est possible d’obtenir jusqu’à 10 000 points gratuits par mois, mais ce n’est pas une version gratuite accessible automatiquement à tous les utilisateurs.
Combien coûte réellement un Starter par an ?
La page indique 40 dollars par mois avec un paiement annuel ; le montant annuel de référence est de 480 dollars, incluant 1,2 million de points annuels. Les taxes et le montant final sont indiqués sur la page de paiement.
Les points sont-ils reportés ?
Les points du plan d’abonnement ne sont pas reportés, et les forfaits de points achetés séparément ne expirent pas. Les forfaits de points sont utilisés une fois que les points de l’abonnement ont été épuisés.
Les demandes échouées déduisent-elles des points ?
Pas de frais : la page officielle indique que seuls les appels réussis sont facturés. Les développeurs doivent néanmoins limiter le nombre de tentatives pour éviter de nombreuses requêtes réussies suite à une récupération d’erreur.
Quelle est la différence entre v1 et v2 ?
v1 conserve la structure d’endpoint directe existante, tandis que v2 effectue des appels unifiés en fonction des capacités et est recommandée pour les nouvelles intégrations. Les deux peuvent coexister au sein d’un même compte et partager la clé API.
DumplingAI prend-il en charge MCP ?
Soutien : le MCP à distance v2 utilise OAuth, et un serveur MCP open source officiel nécessitant une clé API est également fourni. Ne confondez pas ces deux méthodes d’accès.
Peut-on l’utiliser dans Codex ou ChatGPT ?
La documentation officielle liste des clients MCP tels que Codex, ChatGPT, Claude et Cursor. La possibilité de se connecter dépend de la version du client, des permissions de l’organisation et des paramètres du connecteur.
Y a-t-il un SDK API ?
Une API complète, une CLI et un MCP sont fournis, mais aucun SDK officiel universel multilingue n’a été trouvé. Les développeurs peuvent créer leurs propres encapsulations en se référant à la documentation v2.
DumplingAI est-il open source ?
La plateforme de gestion elle-même n’est pas open source ; le serveur MCP officiel est soumis à la licence MIT. Les connecteurs open source doivent néanmoins appeler l’API cloud de DumplingAI et consommer des points de compte.
Les données seront-elles utilisées pour l’entraînement ?
La politique de confidentialité indique que les données fournies par certains utilisateurs peuvent être stockées et utilisées pour améliorer l’IA. Les données sensibles ou relatives aux clients doivent faire l’objet d’une confirmation officielle avant soumission, concernant les détails de l’entraînement, du retrait, de la conservation et de la suppression.
Les résultats de recherche et d’extraction peuvent-ils être utilisés commercialement directement ?
On ne peut pas généraliser : la capacité d’accès à une API ne transfère pas automatiquement les droits d’auteur du contenu cible, les droits de base de données ou les licences de plateforme. Il est nécessaire d’examiner chaque cas séparément en fonction de la source des données, de la région et de l’usage.
Résumé
DumplingAI intègre les données externes, le traitement de documents, l’extraction de médias, les capacités d’IA et l’exécution de code en une infrastructure unifiée orientée vers les agents. La version 2, MCP, la CLI et les connexions sans code permettent aux utilisateurs ayant différents niveaux de compétences techniques d’y accéder.
Avant le déploiement officiel, il convient de définir un budget de points pour chaque capacité, ainsi que des mécanismes de cache, des limites de conformité et des procédures de gestion des pannes. Il faut d’abord valider les coûts et la structure des résultats à l’aide d’échantillons courts, avant d’augmenter progressivement le nombre de pages, la durée des médias et la fréquence d’automatisation.
Outils similaires à DumplingAI

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164