




Bethge Lab
Bethge Lab, outils intelligents spécialisés dans la recherche par IA
Étiquettes :Moteur de recherche IAUne phrase pour présenter
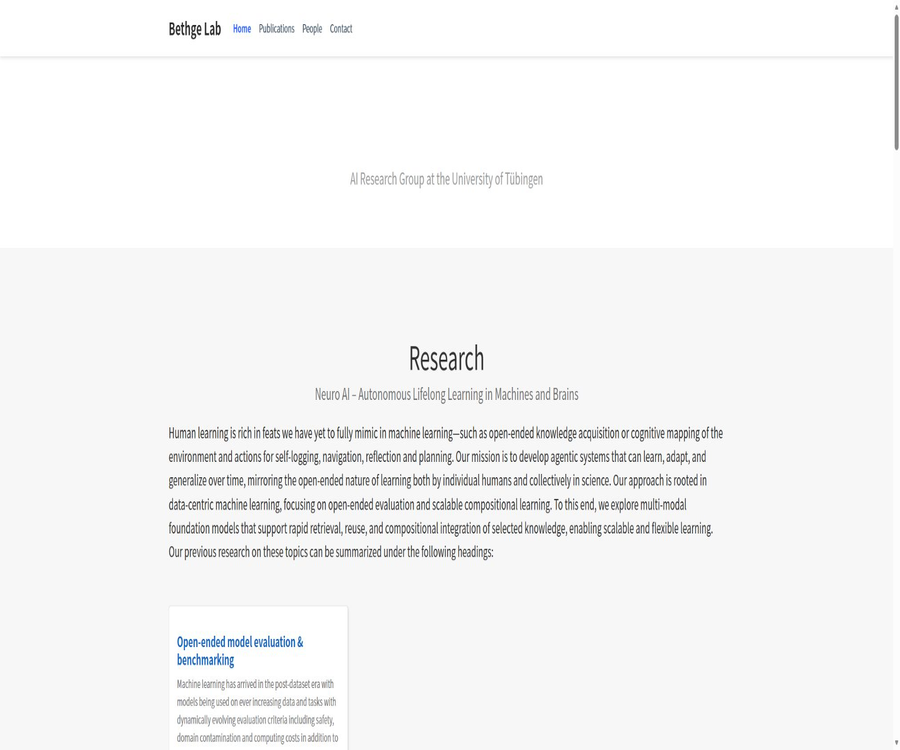
Le Bethge Lab est une équipe de recherche en IA et en neurosciences computationnelles de l’Université de Tübingen. Son site web présente principalement les domaines de recherche, les membres, les articles scientifiques, les jeux de données et le code open source, sans offrir de service de chat en ligne ou de génération de contenu.
Présentation du laboratoire
Le laboratoire Bethge, dirigé par Matthias Bethge, mène des recherches dans les domaines de l’apprentissage automatique, de la neurosciences computationnelles, des sciences visuelles et de l’apprentissage autonome tout au long de la vie. Son objectif est de comprendre les mécanismes de raisonnement et d’apprentissage du cerveau biologique, ainsi que d’explorer des systèmes machines capables d’adapter continuellement, de combiner des connaissances et de généraliser.
Matthias Bethge est professeur de neurosciences computationnelles et d’apprentissage automatique à l’université de Tübingen, et dirige le Centre d’IA de Tübingen. Le laboratoire collabore avec des universités locales, les instituts Max Planck, ELLIS ainsi que d’autres réseaux académiques.
Ce n’est pas un outil d’IA ordinaire
- Il n’y a ni champ de saisie de prompts destiné au grand public, ni interface de chat IA générale.
- Aucun logiciel d’écriture, de recherche ou de bureautique avec abonnement mensuel n’est proposé.
- Le site officiel sert principalement à se renseigner sur les projets, à lire des articles scientifiques, à trouver les membres et à postuler pour des postes.
- Les ressources vraiment opérationnelles se trouvent généralement dans les annexes du mémoire, les dépôts de code et les pages des ensembles de données.
- Les différents projets de recherche présentent des dépendances, des licences, un niveau d’entretien et une difficulté de reproductibilité différents.
Axes de recherche principaux actuels
Évaluation et référentiels de modèles ouverts
Le laboratoire s’intéresse aux problèmes d’évaluation après l’entrée du modèle dans l’ère des ensembles de données, y compris les tâches en constante évolution, la sécurité, la pollution des données, le coût de calcul et la démocratisation de l’évaluation. Les recherches connexes tentent d’étendre les classements statiques à une évaluation ouverte, durable, combinable et au niveau des échantillons.
Agent de modèle linguistique intelligent
Cette direction de recherche concerne des agents intelligents modélisés par des langages capables de raisonner, de communiquer et d’exécuter des tâches de manière autonome. Les problèmes abordés incluent la démonstration de théorèmes, l’automatisation de la découverte scientifique, la recherche de citations scientifiques ainsi que la collecte d’informations sur des événements futurs incertains.
Apprentissage centré sur des combinaisons à vie et des objectifs
Le laboratoire considère que l’apprentissage continu ne vise pas seulement à éviter l’oubli catastrophique, mais aussi à transformer les expériences passées en modules réutilisables pour l’avenir. La recherche relie la généralisation combinée, la représentation axée sur l’objectif, le pré-apprentissage multimodal et un apprentissage tout au long de la vie scalable.
Représentations neuronales et interprétabilité des mécanismes
L’équipe de recherche utilise l’apprentissage automatique pour analyser des données nerveuses, afin d’étudier la manière dont les populations de neurones biologiques effectuent le raisonnement et l’apprentissage. Le travail porte sur des jumeaux numériques de la rétine et de la cortex visuel, ainsi que sur la comparaison des représentations neuronales et des modèles de régions cérébrales affinés selon les besoins.
L’attention de l’homme et de la machine
Cette direction étudie la salience, les trajectoires de balayage et le mouvement oculaire dans les images, les vidéos et la réalité virtuelle, et compare les mécanismes d’attention humaine à ceux de la vision par ordinateur. L’un des objectifs est d’utiliser des modèles d’attention plus conformes au comportement humain dans les recherches visuelles et comportementales.
Entrepreneuriat en science de l’IA
Le laboratoire s’intéresse également à la manière de transformer les recherches en apprentissage automatique en solutions ayant une valeur pratique à long terme, et collabore avec des entreprises issues de la recherche. Les informations sur l’entrepreneuriat et la coopération indiquées sur le site ne signifient pas que le laboratoire vend au public des produits commerciaux standardisés.
Correspondance des directions de recherche
| Axes de recherche | Problème principal | Ressources typiques | Adéquat pour les lecteurs |
|---|---|---|---|
| Évaluation ouverte | Comment évaluer de manière continue des modèles en évolution rapide | Cadres d’évaluation, benchmarks et ensembles de données | Chercheur en évaluation et gouvernance des modèles |
| Agent de modèle linguistique intelligent | Comment améliorer les compétences en raisonnement, en citation et en collaboration sur des tâches | Thèse, références et code expérimental | Chercheurs en NLP et en agents intelligents |
| Apprentissage combiné à vie | Comment réutiliser les connaissances et réduire l’oubli | Apprentissage continu et projets multimodaux | Chercheur en apprentissage automatique |
| Représentation neuronale | Comment les groupes de neurones calculent et apprennent | Modèles de données nerveuses et code d’analyse | Chercheur en neurosciences computationnelles |
| Attention homme-machine | Comment comparer les mouvements oculaires humains et l’attention des machines | Modèle de significativité, données de mouvements oculaires et référence | Chercheurs en sciences visuelles et cognitives |
| Entrepreneuriat scientifique | Comment transformer les résultats de la recherche en solutions réalisables | Informations sur les projets de collaboration et les entreprises dérivées | Étudier les entrepreneurs |
Ressources disponibles sur le site officiel
- Aperçu de la recherche : une vue rapide de la mission actuelle de l’équipe et de ses principaux défis.
- Table des matières des articles : parcourir les articles, les préprints et les communications de conférence par année et par type de publication.
- Annexes du projet : certains articles fournissent un PDF, du code, des ensembles de données, une page du projet, des vidéos ou des diapositives.
- Page des membres : Consultez les responsables, les post-doctorants, les doctorants, les masters, le personnel administratif et les anciens élèves.
- Page de candidature : Découvrez les opportunités de post-doctorat, de doctorat, de stage, de rotation et de thèse.
- Actualités et coopération : Consultez les activités de laboratoire, les collaborations académiques et les projets d’impact social.
Sujets de thèses représentatives
Le catalogue des articles couvre l’attention visuelle, la modélisation de données neuronales, l’apprentissage continu, la généralisation combinatoire, les modèles multimodaux et l’évaluation des grands modèles de langage. L’état des articles dans le catalogue peut inclure des publications officielles, des communications de conférence et des préprints ; il convient de vérifier la version lors des citations.
- Évaluation de modèles au niveau d’échantillon pour les capacités ouvertes.
- Capacité à associer les affirmations scientifiques aux citations bibliographiques.
- Pré-entraînement continu et fusion de modèles multimodaux.
- Fréquence conceptuelle et performance sans échantillon des modèles de langage visuel.
- Apprentissage centré sur l’objectif et généralisation par combinaison.
- Generalisation externe adaptative et distribuée lors des tests continus.
- Prédiction de la fixation visuelle humaine, de la salience et des trajectoires de balayage.
- Modélisation fonctionnelle de la rétine et du cortex visuel.
Ressources open source de GitHub
L’organisation GitHub, portant le même nom que le laboratoire et dont la page d’accueil mène au site officiel, compte actuellement des dizaines de dépôts publics, contenant principalement des implémentations de articles scientifiques, des benchmarks, des outils de traitement de données et du code d’expérimentation. Ces dépôts ne forment pas un paquet logiciel unique ; il est nécessaire de consulter individuellement les instructions et les licences avant de les utiliser.
Foolbox
Foolbox est une boîte à outils Python utilisée pour créer des exemples d’adversarial pour les réseaux de neurones, et peut être utilisée avec PyTorch, TensorFlow et JAX. Elle convient à la recherche sur la robustesse et à l’évaluation des modèles, mais ne doit pas être employée pour attaquer des systèmes réels sans autorisation.
imagecorruptions
imagecorruptions offre la capacité en Python d’ajouter des altérations courantes aux images, ce qui peut être utilisé pour tester la stabilité des modèles face au bruit, à la flouïté, aux conditions météorologiques et aux distorsions numériques. Le dépôt est licencié sous la licence Apache 2.0, mais les données d’entrée et les modèles peuvent encore faire l’objet d’une licence distincte.
model-vs-human
model-vs-human est utilisé pour comparer des modèles et un comportement humain sur des données hors distribution. Ce projet convient à étudier si la vision par ordinateur dépend de pistes différentes de celles des humains ; le dépôt actuel ne présente pas explicitement la licence standard dans les métadonnées.
CiteME et ONEBench
CiteME se concentre sur la capacité des modèles linguistiques à retrouver les articles cités dans les textes scientifiques, tandis que ONEBench porte sur des benchmarks au niveau d’échantillons pour l’open source. Tous deux peuvent être utilisés pour évaluer des recherches, mais les données, le code et les résultats des évaluations doivent être interprétés conformément aux instructions de leurs répertoires respectifs.
Études récentes sur les entrepôts
L’organisation a également rendu publics des projets tels que l’évaluation de modèles à vie, l’entraînement préalable multimodal, l’apprentissage par renforcement, les représentations neuronales et les benchmarks linguistiques. Les mises à jour du dépôt ne suivent pas le rythme de publication des articles, il ne faut donc pas assimiler directement les dernières versions publiées à des versions stables.
Comparaison des projets open source
| Projet | Utilisation | Langue principale | Statut de la licence | Précautions à prendre |
|---|---|---|---|---|
| Foolbox | Échantillons de contre et évaluation de la robustesse | Python | MIT | À usage exclusif pour la recherche et les tests autorisés |
| imagecorruptions | Érosion d’image et tests de robustesse | Python | Apache 2.0 | Vérification des données et autorisation du modèle |
| model-vs-human | Comparaison entre les modèles et le comportement humain | Python | Les métadonnées du entrepôt ne sont pas spécifiées. | Lire le fichier du projet avant utilisation |
| CiteME | Évaluation de la recherche de citations scientifiques | Python | Déclaration non standard | Vérifier séparément les données et les clauses de code |
| ONEBench | Évaluation au niveau d’échantillon de capacité d’ouverture | Python | MIT | Les résultats dépendent de l’échantillon et des paramètres d’évaluation |
| frequency_determines_performance | Étude sur la fréquence de l’entraînement préalable multimodal | Notebook | MIT | La reconstitution peut nécessiter de grandes quantités de données et une forte puissance de calcul. |
Comment trouver un article de recherche approprié
- Commencez par déterminer, à partir d’un aperçu de la recherche, si le thème relève de l’évaluation, des agents intelligents, de l’apprentissage tout au long de la vie, des représentations neuronales ou de l’attention.
- Accédez au répertoire des articles et restreignez la recherche par année, conférence ou type d’article.
- Lisez le titre et le résumé pour vérifier que la tâche, les données, les méthodes et les indicateurs d’évaluation correspondent aux besoins.
- Vérifiez si la page du mémoire fournit du code, des ensembles de données, une page de projet ou des diapositives.
- Privilégiez la version finalement publiée et vérifiez l’auteur, la conférence, l’année et l’identifiant d’objet numérique.
- Enregistrer les versions des articles, les soumissions de code et les versions des données pour garantir une reproductibilité ultérieure.
Comment utiliser le code de recherche
- Trouvez le dépôt correspondant sur la page de la thèse et vérifiez que le dépôt est bien maintenu par l’auteur ou le laboratoire.
- Lire les documents d’instruction, les articles, les licences, les versions dépendantes et les problèmes connus.
- Créez un environnement Python isolé, ne l’installez pas directement sur le système de production.
- Exécutez d’abord l’exemple minimal officiel ou les tests, puis essayez avec des données complètes et des tâches d’entraînement.
- Soumission de code fixe, graine aléatoire, version des données et environnement matériel.
- Comparer ses résultats aux indicateurs du papier et noter les écarts qui ne peuvent pas être reproduits.
- Lors de la publication d’œuvres dérivées, il convient de citer en respectant la licence et les normes académiques.
Processus de reproductibilité d’un article
- Il faut préciser si l’on souhaite reproduire les résultats d’entraînement, les résultats d’évaluation, des graphiques ou des cas qualitatifs.
- Vérifier si les données brutes sont publiques, s’il est nécessaire de déposer une demande et s’une redistribution est autorisée.
- Enregistrer l’environnement logiciel, les pilotes, les frameworks, la carte graphique et la graine aléatoire.
- Vérifier d’abord la lecture des données et le calcul de la perte sur un échantillon de petite taille.
- Vérifiez les hyperparamètres, le prétraitement, la division des données et le protocole d’évaluation dans l’annexe du mémoire.
- Exécuter au moins plusieurs fois et rapporter la moyenne, l’écart type et le nombre d’échecs.
- Distinguer la reproduction complète, la reproduction approximative et la validation conceptuelle, sans exagérer la cohérence.
Demande d’adhésion au laboratoire
Le site officiel explique respectivement les démarches de candidature pour les post-doctorants, les doctorants, les stages, les rotations en laboratoire, ainsi que pour les thèses de licence ou de master. L’équipe précise que le nombre de demandes est élevé et qu’il convient d’utiliser les formulaires de candidature spécifiques, plutôt que d’envoyer des demandes complètes directement par e-mail ordinaire.
- Lisez les orientations de recherche actuelles et choisissez un sujet qui correspond le mieux à votre expérience personnelle.
- Préparer un CV, une présentation de recherche, des projets représentatifs ainsi que du code ou des articles vérifiables.
- Expliquez le problème que vous souhaitez résoudre, plutôt que de simplement exprimer un intérêt général pour l’IA.
- Soumettre par les voies indiquées pour les programmes postdoctoraux, doctoraux ou étudiants.
- Vérifier la date limite de dépôt, les exigences en matière de documents et l’organisation des lettres de recommandation.
- Attendez une notification officielle ; ne considérez pas la confirmation automatique comme une admission ou un entretien.
À qui s’adresse-t-il
- Chercheurs en apprentissage automatique : recherche d’opportunités en apprentissage continu, multimodal et évaluation de modèles.
- Chercheurs en neurosciences computationnelles : recherche de modèles du système visuel et des représentations neuronales.
- Doctorants et masters : recherche de thèses, de données, de projets de reproductibilité et d’opportunités de candidature.
- Ingénieur : Évaluer les outils de recherche tels que Foolbox et imagecorruptions.
- Équipe de sécurité des modèles : recherche sur la robustesse contre les attaques et les évaluations ouvertes.
- Spécialistes des sciences visuelles et cognitives : utilisation de ressources basées sur la salience, les mouvements oculaires et les comparaisons comportementales.
- Entrepreneurs scientifiques : comprendre la transformation des résultats de recherche et les projets dérivés du laboratoire.
Scénarios d'utilisation typiques
- Établir un point de départ dans la littérature pour l’apprentissage continu ou la généralisation par combinaison.
- Reproduire la thèse et comparer la nouvelle méthode avec la baseline publique du laboratoire.
- Utiliser des outils d’échantillons adverses pour évaluer la robustesse des modèles visuels.
- Utilisation du modèle de test de corrosion d’image pour évaluer son comportement en cas de variation de distribution.
- Étude des citations scientifiques et de l’évaluation de la capacité d’ouverture des modèles linguistiques.
- Comparer les prédictions de la vision par ordinateur aux données des mouvements oculaires ou du comportement humain.
- Recherchez des opportunités de recherche pour les post-doctorants, les doctorants et les étudiants.
Avantage en ressources
- Placer l’apprentissage automatique et les neurosciences computationnelles dans le même cadre de recherche.
- Le catalogue des thèses couvre une longue période et fournit des informations relativement complètes sur les auteurs et les éditions.
- De nombreuses pages de mémoires fournissent en même temps du code, des données ou des annexes de projet.
- L’organisation GitHub contient des outils matures et des implémentations issues de publications récentes.
- Les domaines de recherche couvrent l’évaluation de modèles, les agents intelligents, le multimodal, la vision et les données neuronales.
- Certains entrepôts utilisent des licences claires telles que MIT ou Apache 2.0.
- Le site officiel présente clairement l’équipe, le réseau de partenariats et les modalités de candidature.
Restrictions d'utilisation et précautions
- Le Bethge Lab est une équipe de recherche, et non un outil SaaS permettant d’effectuer directement des tâches quotidiennes.
- Le contenu du site officiel est principalement en anglais, et les articles requièrent des connaissances de base en apprentissage automatique ou en neurosciences.
- Une partie du code fait partie des matériaux de reconstitution de la thèse et n’offre pas nécessairement une stabilité adaptée à un usage en production.
- Les licences varient selon les entrepôts, et certains projets n’ont pas de licence standard définie.
- Le code du mémoire peut dépendre de versions anciennes de frameworks, de matériel spécialisé ou de données à grande échelle.
- Les modèles et référentiels publics peuvent présenter des biais de données, de la pollution ou des fuites d’évaluation.
- Les projets d’échantillons de contre attaque ne peuvent être utilisés qu’à des fins de tests autorisés, d’enseignement et de recherche en matière de défense.
- Les versions préimprimées et celles présentées lors de conférences peuvent différer du contenu finalement publié.
- Les étoiles sur le dépôt, la fréquence de soumission et les citations des articles ne suffisent pas seuls à prouver la fiabilité de la méthode.
- La page de demande et les informations personnelles peuvent varier ; il convient de se référer à l’état du site officiel au moment de la soumission.
Prix et coûts d’utilisation
Le site officiel du laboratoire Bethge, le catalogue des articles et les dépôts GitHub publics ne proposent pas de forfaits d’abonnement commerciaux. La lecture des pages web est généralement gratuite, mais les textes complets des articles, l’accès aux données, les ressources de calcul pour l’entraînement et les services cloud tiers peuvent entraîner des coûts supplémentaires.
| Ressources | Prix public | Coût potentiel | Explication |
|---|---|---|---|
| Site officiel du laboratoire | Accès gratuit | Coûts de réseau et de temps | Pas besoin d’acheter un abonnement |
| Table des matières du mémoire | Consultation gratuite | Certaines publications peuvent être soumises à des restrictions d’accès aux revues. | Rechercher en priorité la version ouverte |
| Code GitHub | Accès public | Puissance de calcul, stockage et maintenance technique | Respecter les licences de chaque entrepôt |
| Ensemble de données | Varie selon le projet | Coûts de demande, de téléchargement, de stockage et de conformité | Voir le contrat d'utilisation des données |
| Projet de demande | Les frais de service ne sont pas indiqués sur le site officiel | L’éducation, les visas et le coût de la vie sont à part. | Les règles d’admission sont déterminées par chaque programme spécifique. |
Plateforme et modes d’accès
| Plateforme | Soutien disponible | Utilisation |
|---|---|---|
| Site web officiel | Soutien | Aperçu de la recherche, articles, membres et informations sur les demandes |
| GitHub | Soutien | Code, description des données, problèmes et historique des versions |
| Windows | Selon le projet | Utiliser via un navigateur ou un environnement de recherche local |
| macOS | Selon le projet | Utiliser via un navigateur ou un environnement de recherche local |
| Linux | La plupart des codes de recherche ont la priorité | Entraînement, évaluation et reproductibilité |
| Mobile | Naviguer sur le web | Ce n’est pas équivalent à fournir une application mobile indépendante |
API, SDK et statut open source
Le labo Bethge ne dispose d’aucune API commerciale unifiée, de console de gestion des comptes ou de SDK général. Les capacités open source sont organisées en dépôts de recherche distincts ; les utilisateurs doivent choisir un projet en fonction des articles scientifiques et respecter la licence de ce dépôt ainsi que celle de ses données, modèles et dépendances.
Le laboratoire en tant que tel n’est pas un produit open source pouvant être installé dans son intégralité, mais de nombreux codes de recherche sont publiés. Le statut open source indiqué dans le répertoire convient mieux à être décrit comme « partie des codes de recherche est open source », on ne peut pas simplement affirmer que tous les résultats utilisent la même licence.
Sécurité et éthique de la recherche
- Les exemples d’attaque et les attaques de modèle ne peuvent être utilisés que sur des systèmes autorisés.
- Les données nerveuses, comportementales et oculaires peuvent être liées à la recherche sur le corps humain et aux restrictions de confidentialité.
- Vérifiez l’approbation éthique, la portée du consentement et les conditions de redistribution avant de télécharger les données.
- L’évaluation des grands modèles doit enregistrer le prompt, la version du modèle, la température et le risque de contamination des données.
- Le code de recherche doit être exécuté dans un environnement isolé, et ses dépendances ainsi que les opérations sur les fichiers doivent être vérifiées.
- La génération ou l’évaluation des résultats ne peut pas remplacer l’évaluation par des pairs et la vérification indépendante.
Informations de base
| champ | Contenu |
|---|---|
| Nom | Bethge Lab |
| Nature | Équipe de recherche en apprentissage automatique et en neurosciences computationnelles à l’université |
| Responsable | Matthias Bethge |
| Organisation à laquelle on appartient | Université de Tübingen |
| Direction principale | Apprentissage tout au long de la vie, évaluation de modèles, agents intelligents, représentations neuronales et attention visuelle |
| Modèle de prix | Le site officiel et le code source sont accessibles gratuitement, sans abonnement commercial. |
| Faut-il s’inscrire ? | Il n’est pas nécessaire de consulter le site officiel, mais des ressources tierces peuvent en nécessiter une visite. |
| API unifiée | Pas de |
| SDK unifié | Pas de |
| GitHub | Il existe des organisations du même nom et des dizaines de entrepôts publics |
| Statut open source | Une partie du code de recherche est open source, la licence varie selon le répertoire. |
| Langue principale | anglais |
Indice de recommandation
L’indice de recommandation global est de 4,4 sur 5. Pour les chercheurs en apprentissage automatique, en neurosciences computationnelles et en évaluation de modèles, le Bethge Lab offre un catalogue d’articles présentant une continuité thématique ainsi que de riches ressources en code.
Il n’est pas adapté aux utilisateurs ordinaires en quête de services d’IA, d’écriture ou de bureautique avec une seule commande. Les chercheurs doivent également assumer les coûts de filtrage des articles, de configuration de l’environnement, de vérification des licences et de répétition des expériences.
Questions fréquentes
Qu’est-ce que le Bethge Lab ?
Il s’agit de l’équipe de recherche en IA et en neurosciences computationnelles de l’université de Tübingen, et non d’une application commerciale d’IA.
Le Bethge Lab peut-il être utilisé directement en ligne ?
Il est possible de consulter des recherches et des articles, mais il n’existe pas d’outil de génération en ligne unifié. En pratique, il faut généralement accéder au répertoire de code correspondant et configurer l’environnement de recherche.
Faut-il payer pour accéder au site officiel ?
Le site officiel et le code public ne nécessitent pas de abonnement, mais les publications scientifiques, les ressources cloud et certains données peuvent entraîner des frais supplémentaires.
Quelles sont les principales directions de recherche ?
Y compris l’évaluation de modèles ouverts, les agents de modèles linguistiques, l’apprentissage combiné tout au long de la vie, les représentations neuronales, l’attention homme-machine et l’entrepreneuriat en science de l’IA.
Le Bethge Lab est-il open source ?
On ne peut pas qualifier tout le laboratoire de produit open source, mais son organisation GitHub met à disposition une grande quantité de code de recherche.
Tous les entrepôts peuvent-ils être utilisés à des fins commerciales ?
On ne peut pas généraliser ; il faut vérifier séparément les licences et les conditions d’utilisation pour chaque entrepôt, ensemble de données, modèle et dépendance.
À quoi sert Foolbox ?
Idéal pour générer des exemples adversaires dans un environnement autorisé et évaluer la robustesse des réseaux de neurones.
Une API unifiée est-elle fournie ?
Non, les ressources publiques se composent principalement de projets de articles indépendants, de paquets Python, de notebooks et de jeux de données.
Est-ce que c’est compatible avec le chinois ?
Le site officiel et la plupart des articles sont principalement en anglais ; une partie du code peut être utilisée pour des recherches multilingues, mais aucune interface en chinois n’est garantie.
Comment trouver le code correspondant à un article ?
Vérifiez les fichiers joints tels que Code, Dataset et Project dans le sommaire du mémoire ou sur la page des détails du mémoire, puis comparez l’auteur du dépôt avec les informations du mémoire.
Puis-je demander à rejoindre le laboratoire ?
Il est possible de postuler via les canaux de programmes de post-doctorat, de doctorat et d’étudiants fournis sur le site officiel ; les conditions d’ouverture et les dates limites peuvent varier.
Est-ce adapté aux débutants ?
Le site officiel est utile pour se familiariser avec les domaines de recherche, mais la plupart des articles et des projets de reconstitution nécessitent des connaissances de base en Python, en apprentissage profond, en statistiques ou en neurosciences.
Outils similaires au Bethge Lab

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164