




Elicit
Assistant de recherche en IA capable de rechercher, résumer et extraire des centaines de millions d’articles scientifiques
Étiquettes :Moteur de recherche IAQu’est-ce que Elicit ?
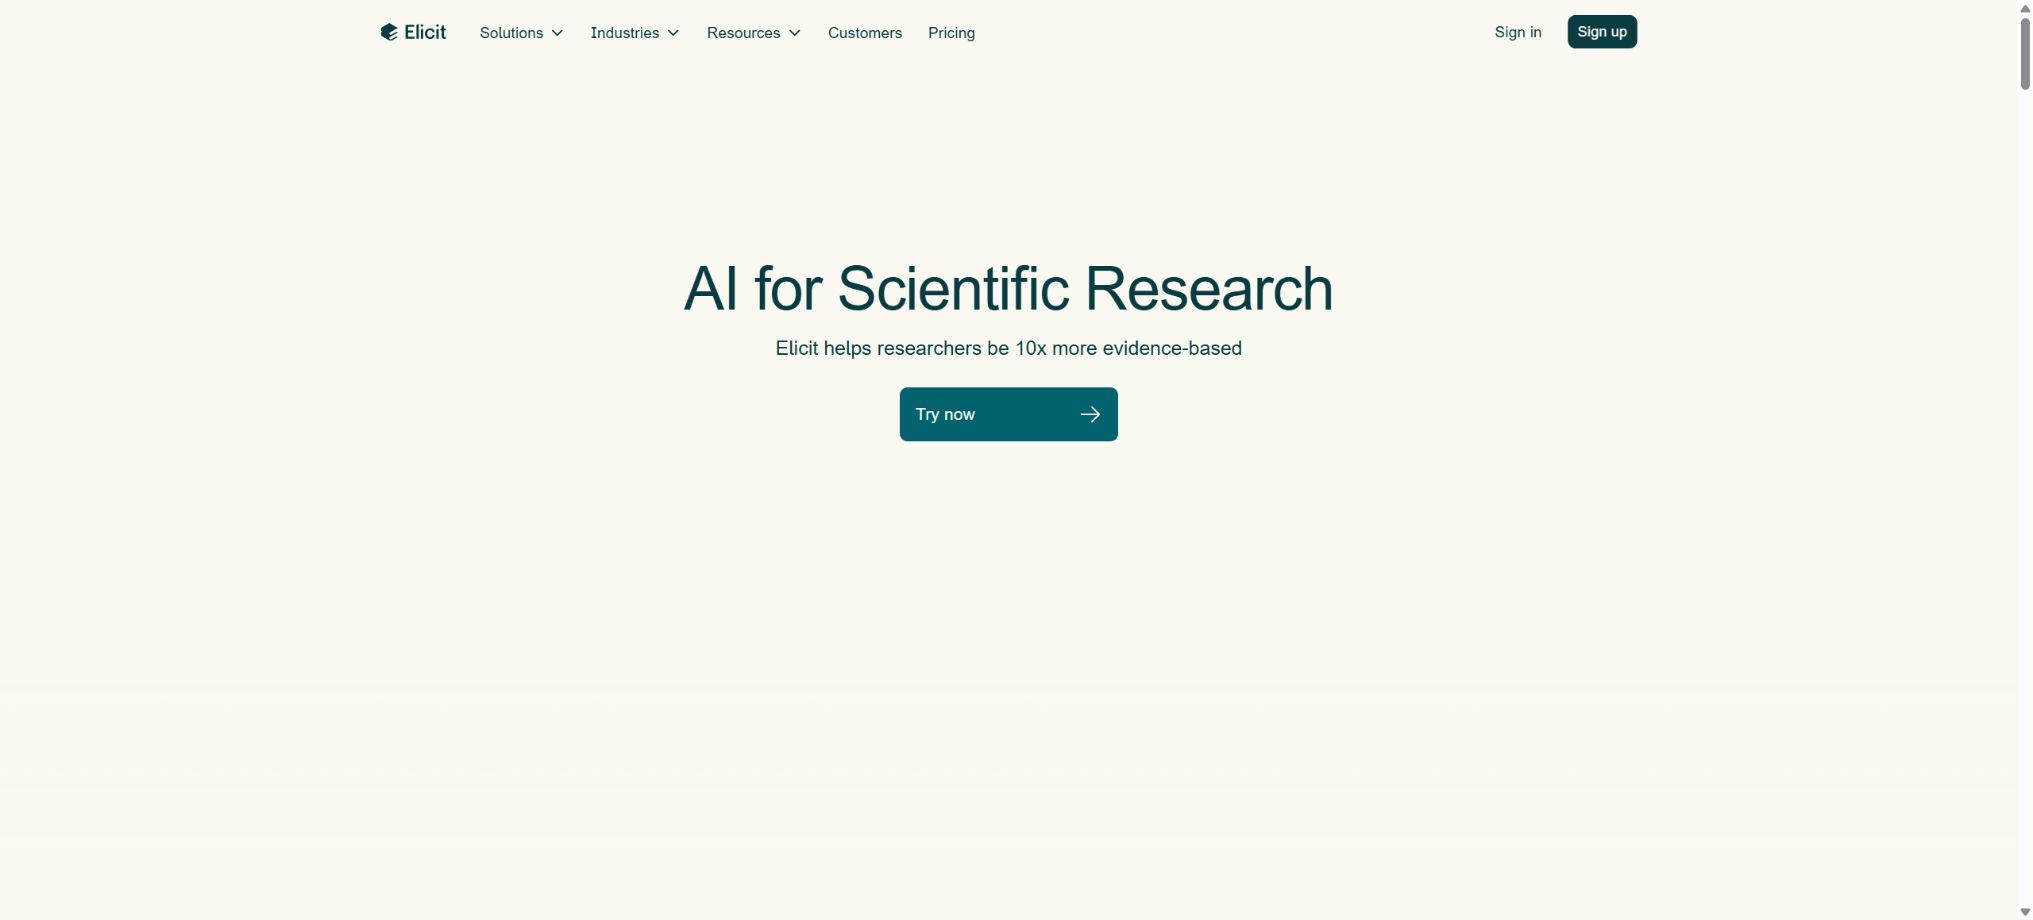
Elicit est un assistant de recherche en IA destiné aux chercheurs, aux équipes en sciences médicales et biologiques, aux chercheurs en politiques publiques et aux professionnels de la synthèse des données, géré par Elicit Research PBC. Ce n’est pas un simple robot de conversation, ni simplement un outil qui génère un résumé après l’entrée d’une question ; il décompose la recherche dans la littérature, le filtrage, la lecture intégrale, l’extraction structurée, la vérification des preuves et la génération de rapports en étapes vérifiables, permettant aux utilisateurs de voir les articles, les citations de référence et les raisons du filtrage.
Jusqu’à cette vérification, Elicit est passé du « formulaire de recherche de littérature en IA » initial à un outil qui comprendAgent de recherche, Recherche de documents, Chat sur les articles, Rapports de recherche, Revue systématique, Bibliothèque, Alertes, API et MCPUne plateforme de recherche intégrée.
Son champ de recherche couvre plus de 138 millions d’articles académiques, et certaines solutions permettent également de rechercher plus de 500 000 enregistrements de essais cliniques.
Le produit est principalement utilisé via une interface web, tandis que les applications et modèles clés sont des services exclusifs dans le cloud.
Fonctionnalités clés
1. Recherche sémantique de documents académiques
Les utilisateurs peuvent poser des questions de recherche en langue naturelle ; Elicit cherche alors des articles pertinents en se basant sur la similarité sémantique, de sorte que des articles pouvant ne pas utiliser exactement les mêmes mots-clés que la question peuvent également être trouvés. La recherche sémantique est adaptée pour explorer de nouveaux domaines et combler les omissions liées aux synonymes dans la recherche traditionnelle par mots-clés.
La recherche avancée et le filtrage par mots-clés conviennent pour cibler des concepts plus précis.
Leur combinaison est plus flexible que de se fier uniquement aux mots-clés du titre.
Les résultats de recherche sont présentés sous forme de tableau ; chaque article génère un résumé lié au sujet actuel, et affiche des informations telles que l’année, l’auteur, la revue, le nombre de citations, le type de recherche, etc. L’utilisateur peut filtrer selon la date de publication, le design de la recherche, la qualité de la revue, la disponibilité du texte intégral, etc., et peut également ajouter des colonnes personnalisées pour extraire en masse le nombre d’échantillons, les sujets étudiés, l’intervention, les résultats, les méthodes et les principaux résultats.
Il convient de noter que le fait qu’Elicit couvre un large éventail de bases de données ne signifie pas qu’il en couvre toutes. Une revue systématique formelle doit toujours effectuer des recherches dans PubMed, MEDLINE, Embase, Web of Science, Scopus, la Cochrane Library ou d’autres bases de données spécifiques à la discipline, en enregistrant l’expression de recherche, la date et le nombre de résultats pour chaque base de données.
La recherche sémantique convient pour étendre le rappel et découvrir des recherches pertinentes, mais elle ne peut pas remplacer automatiquement les stratégies de recherche de niveau publication.
2. Questions-réponses sur l’article Paper Chat
Paper Chat permet de poser des questions supplémentaires au sujet d’un ou plusieurs articles, par exemple pour comparer les designs de recherche, interpréter les résultats statistiques, identifier les limites ou synthétiser les conclusions de différents articles. Pour les articles dont le texte intégral est accessible via le système, la version gratuite offre également des discussions sur le texte intégral sans limite de nombre de fois.
S’il n’y a que des résumés ou des métadonnées, il y aura moins de bases sur lesquelles répondre.
La bonne façon d’utiliser cet outil est de demander une réponse accompagnée de la preuve originale, du numéro de page ou du fragment de soutien, puis d’ouvrir le mémoire pour vérifier. Les tableaux, annexes, images scannées, formules complexes et informations visuelles dans le mémoire peuvent ne pas être analysés complètement, et les résumés secondaires peuvent également omettre certaines conditions.
Lorsqu’il s’agit de dose, de sécurité, de significativité, du nombre d’échantillons et de la définition des résultats, il ne faut pas se contenter de copier la réponse de l’IA.
3. Table de extraction de données personnalisée
Elicit peut transformer les articles en tableaux structurés. L’utilisateur ajoute une nouvelle colonne et y entre des questions ; le système extrait alors les réponses pour chaque article, ce qui est idéal pour créer des tableaux de caractéristiques de recherche, des matrices d’arguments, ou des comparaisons de concurrents ou de mécanismes.
Les plans Pro et supérieurs offrent également une extraction personnalisée, des explications des réponses par l’IA et davantage de modèles de sortie ; Scale améliore la capacité d’extraction et d’interprétation des graphiques des articles.
Les colonnes à extraire doivent être aussi spécifiques que possible ; par exemple, on peut diviser les « résultats de la recherche » en objectifs principaux, durée du suivi, ampleur de l’effet, intervalles de confiance et effets indésirables. Les questions vagues risquent de mélanger des définitions différentes.
L’extraction automatique convient pour effectuer la première phase de tri, mais les articles scientifiques officiels, les documents réglementaires et les décisions médicales doivent encore faire l’objet d’un échantillonnage ou d’une vérification ligne par ligne du texte intégral, avec conservation des traces des modifications manuelles.
4. Rapports de recherche
Les rapports de recherche effectuent des recherches, des filtrages et une extraction d’informations autour d’une question, pour ensuite générer un aperçu de la recherche accompagné de preuves. Les affirmations importantes peuvent être retracées jusqu’aux articles spécifiques et aux citations de référence ; l’utilisateur peut également consulter les étapes intermédiaires, modifier les paramètres et continuer à interagir avec le rapport.
Actuellement, le rapport Pro permet d’extraire des informations à partir de 135 sources de données au maximum, et ce chiffre passe à 200 sources de données.
Le rapport convient pour prendre rapidement connaissance d’une direction de recherche, préparer le contexte d’un projet, définir un point de départ pour une étude de faisabilité ou élaborer une note interne. Il n’est pas équivalent à un article soumis à révision par les pairs ou à une revue systématique complète.
Les conclusions du rapport, les formulations causales, l’évaluation de la qualité de la recherche et les lacunes en matière de preuves doivent encore être examinées par des professionnels, en particulier il ne faut pas transformer des études de corrélation en conclusions causales.
5. Research Agent
L’agent de recherche commence par décomposer les problèmes complexes en procédures de recherche, puis choisit des sources, effectue des recherches en plusieurs étapes, organise les preuves et génère, selon les besoins, des tableaux, des rapports narratifs ou plusieurs résultats. Son champ d’action dépasse celui des articles scientifiques : il peut traiter des essais cliniques, des documents réglementaires, des communiqués de presse, des étiquettes de produits, etc., et prend en charge l’analyse du paysage concurrentiel, du paysage de la recherche, des essais cliniques ainsi que l’exploration de sujets ouverts.
La mise à jour de 2026 ajoute des capacités supplémentaires pour le traitement des séquences génétiques, des données d’omique, des images microscopiques, des affiches de recherche scientifique, du PDB, du FCS et de fichiers personnalisés, ainsi que pour l’analyse de données, la création de graphiques et la compréhension d’images. L’agent demandera d’abord les limites et les préférences de sortie ; une fois les résultats obtenus, il est possible de poser des questions supplémentaires, de restreindre le champ d’analyse ou de générer de nouvelles analyses.
Les agents de recherche, les rapports et les revues systématiques partagent actuellement un pool d’utilisation mensuel au sein du programme ; les tâches complexes consomment plus de crédits que les recherches ordinaires.
6. Revue systématique
Elicit propose un flux de travail spécialisé pour les revues systématiques, couvrant la collecte des articles candidats, les critères d’inclusion et d’exclusion, le filtrage des titres et résumés, le filtrage du texte intégral, l’ extraction structurée et la génération de rapports. Les utilisateurs peuvent importer leurs propres résultats de recherche et fichiers PDF, puis compléter les articles candidats à l’aide de la recherche sémantique ;
L’IA donnera un jugement pour chaque critère, en fournissant une explication et des preuves de soutien, tandis que l’humain pourra toujours reprendre la décision.
Pro permet de filtrer jusqu’à 5000 articles dans des workflows dédiés, tandis qu’Enterprise peut gérer jusqu’à 40 000 articles et extraire 40 colonnes. Le processus prend en charge l’exportation des tableaux de filtrage et d’extraction, ce qui facilite la création de documents d’audit.
La mise à jour PRISMA 2020 de 2026 a renforcé les aspects de suppression des doublons, de statistiques de processus et d’évaluation par deux personnes, l’IA pouvant assister les deux évaluateurs humains ou agir en tant que deuxième évaluateur.
Les évaluations officielles montrent qu’il atteint des taux de rappel ou de précision élevés pour la recherche, le filtrage et l’extraction sur des ensembles de données en accès libre Cochrane spécifiques, mais ces évaluations présentent également des limites évidentes : l’échantillon de test complet est petit, l’extraction repose principalement sur les articles en accès libre disponibles, et les résultats ne peuvent pas nécessairement être généralisés aux articles derrière un paywall, à tous les domaines non médicaux ou à différentes normes de revues systématiques.
Pour les publications, les guides cliniques ou les revues de niveau réglementaire, les chercheurs doivent pré-enregistrer leur protocole, valider leurs expressions de recherche, effectuer un tri par deux personnes et évaluer le risque de biais, plutôt que de confier l’ensemble de ces responsabilités à l’IA.
7. Bibliothèque, Zotero et exportation
Library sert à conserver des articles et à les organiser en collections. La version gratuite permet d’importer des données depuis Zotero ;
Les utilisateurs peuvent également télécharger des PDF ou ajouter les résultats de recherche à leur bibliothèque personnelle.
Il convient de noter que l’ensemble de la bibliothèque Elicit ne peut pas être exporté d’un seul coup, ce qui l’empêche de servir de sauvegarde littéraire à long terme unique ou de remplacer complètement Zotero, EndNote et Mendeley.
Les rapports de recherche peuvent être exportés en PDF ou en Word dans tous les forfaits. Les forfaits Plus et supérieurs permettent d’exporter les tableaux Find Papers et Paper Chat, tandis que les forfaits Pro, Scale et Enterprise permettent d’exporter le tableau Systematic Review.
Le tableau prend en charge CSV ou Excel, et certaines listes de sources prennent en charge RIS et BIB, ce qui permet d’importer à nouveau dans un gestionnaire de références pour générer le format de citation souhaité. Le format de citation et le DOI doivent néanmoins être vérifiés avant la soumission officielle.
8. Research Alerts
Les rappels de recherche permettent de suivre en continu de nouveaux articles autour d’un thème de conservation, ce qui est idéal pour maintenir une « revue vivante » ou pour suivre des domaines en rapide développement. Pro propose 10 rappels personnalisés, tandis qu’Enterprise offre un nombre illimité de rappels d’articles.
Rappel : les résultats restent influencés par la portée de la recherche et la stratégie de correspondance, et ne doivent pas servir de canal unique pour la pharmacovigilance, le suivi réglementaire ou les informations urgentes.
9. API et MCP
Elicit met à disposition des APIs et MCP pour les versions Pro, Scale et Enterprise. L’API de recherche permet de effectuer des recherches sémantiques ou par mots-clés parmi plus de 138 millions d’articles et d’enregistrements sur ClinicalTrials.gov, avec des filtres par année, par catégorie de revue et par type d’étude ; les articles retirés sont exclus par défaut.
L’API de rapport peut générer des rapports en Markdown, PDF ou DOCX ; l’API d’analyse systématique peut effectuer des recherches, du résumé et du filtrage du texte intégral, de l’extraction ainsi que du rapport final, et exporter chaque étape au format CSV ou XLSX.
MCP intègre le même ensemble de capacités dans Claude Desktop, Claude Code et d’autres clients compatibles, via l’authentification OAuth 2.0. Le répertoire api-examples officiel de GitHub fournit des exemples d’intégration avec Python et MCP, sous licence MIT.
Les développeurs doivent conserver correctement les identifiants, limiter les droits d’appel et le budget, et enregistrer dans les pipelines automatisés les paramètres de recherche, les sorties des modèles, les tentatives de réessai en cas d’échec ainsi que l’état de l’approbation manuelle.
Prix et forfaits
Elicit propose une version gratuite, des abonnements personnels, des abonnements d’équipe et des demandes de devis pour les entreprises. Le site officiel affiche à la fois le paiement annuel et le paiement mensuel, et la page affiche différentes options en fonction du mode de facturation choisi.
Voici les prix en dollars publiés au moment de cette vérification ; les taxes, les frais régionaux et les ajustements ultérieurs sont indiqués sur la page de règlement.
| Forfait ou version | Prix, plafonds et avantages clés |
|---|---|
| Basic | Gratuit. Les fonctionnalités Research Agent et Reports sont limitées ; il est possible de rechercher indéfiniment plus de 138 millions d’articles, de générer des résumés d’articles, de discuter avec les articles dont le texte complet est disponible, de consulter les sources des réponses et d’importer depuis Zotero. |
| Plus annuel | Cela équivaut à 11 dollars par personne et par mois, soit 132 dollars par an. Il prend en charge l’exportation en RIS, CSV, BIB, PDF et DOCX, permet d’ajouter 5 colonnes à chaque fois, et offre la possibilité de rechercher indéfiniment plus de 500 000 enregistrements de essais cliniques. |
| Abonnement Pro annuel | La page indique 39 dollars par personne et par mois, soit 480 dollars pour une facturation annuelle ; le paiement mensuel est de 49 dollars. Cela comprend un flux de travail dédié à la revue systématique, une capacité de filtrage de 5000 articles, 20 colonnes par extraction, jusqu’à 135 sources de données pour les rapports, 10 rappels de recherche, des modèles personnalisés d’extraction, d’interprétation et de sortie, ainsi qu’une API et un MCP. |
| Scale, abonnement annuel | 89 dollars par personne et par mois, soit 1068 dollars par an ; le paiement mensuel est de 169 dollars. Augmentation de l’utilisation des fonctionnalités Research Agent, Reports et Systematic Review, avec des explications graphiques, une collaboration en temps réel, 200 sources de données pour les rapports, 30 colonnes par fois, ainsi que la gestion de l’utilisation et des comptes des administrateurs. |
| Enterprise | Demande de prix. Offre des options de déploiement telles que des quantités personnalisées, jusqu’à 40 000 filtres, extraction en 40 colonnes, SSO/SAML, authentification à deux facteurs, vérification des noms de domaine, analyse des utilisateurs, sources de données et modèles personnalisés, services de succès client et architecture single-tenant ; le site officiel indique que par défaut, les données des clients entreprises ne sont pas utilisées pour l’entraînement. |
Les mentions « 39 dollars par mois » et « 480 dollars par an » pour l’abonnement annuel Pro sur le site officiel ne correspondent pas à une simple multiplication ; le catalogue conserve les valeurs indiquées directement sur la page, sans conversion automatique. Il se peut que Plus apparaisse ou non lors du passage à un abonnement mensuel, et que les limites spécifiques de l’API ainsi que la consommation en fonction des différents flux de travail varient ; il convient de vérifier à nouveau ces informations sur la page de paiement du compte avant d’acheter.
GitHub et l’état open source
Elicit dispose d’une organisation officielle sur GitHub, mettant à disposition des exemples d’API, des évaluations de recherche de documents, des ressources d’apprentissage du machine learning, des ensembles de données de recherche et un petit nombre de projets historiques. Les répertoires tels que api-examples et paper-search-eval sont licenciés sous la licence MIT, tandis que certains anciens répertoires ont été archivés.
Les applications web Elicit, Research Agent, les index de recherche, les flux de travail pour les revues systématiques et les modèles cloud ne sont pas entièrement open source.Il n’existe pas non plus de version communautaire officielle que l’on puisse déployer soi-même. Les exemples publics et les codes d’évaluation ne couvrent que l’utilisation des interfaces ou certains actifs de recherche ; on ne peut donc pas qualifier le produit de logiciel open source sur cette base.
Tutoriel d'utilisation d’Elicit
Terminer une tâche de base
- Définir le problème, la période, la région, la priorité des sources et le format de sortie ;
- Dans Elicit, téléchargez des documents dont vous avez les droits d’utilisation ou saisissez des questions de recherche ;
- On établit d’abord un cadre à l’aide de la recherche sémantique de documents Find Papers, puis on complète les preuves par des questions-réponses sur des articles grâce à Paper Chat.
- Il est nécessaire de distinguer les faits de source, les opinions de l’auteur et les inférences de l’IA ;
- Vérifier une par une les dates, les chiffres, l’emplacement dans le texte original et les preuves contradictoires ;
- Modifier manuellement les conclusions et enregistrer l’heure de vérification avant de les publier ;
Créer des flux de travail professionnels réutilisables
- Découper les sujets complexes en quatre catégories de questions : contexte, données, comparaisons et conclusions ;
- La combinaison de la recherche sémantique de documents Find Papers, du système de questions-réponses sur les articles Paper Chat et des tableaux d’extraction de données personnalisés constitue des étapes de recherche fixes.
- Privilégier les sites officiels, les articles scientifiques, les documents réglementaires et les données brutes ;
- Mettre en place une vérification par une deuxième personne pour les conclusions à haut risque ;
- Conserver les requêtes, les preuves, les versions et les problèmes non résolus ;
- Redémarrer après modification des données et mettre à jour les conclusions ;
À qui s’adresse-t-il ?
- Étudiants et chercheurs qui recherchent des articles, organisent le contexte de la recherche et établissent des listes de lectures ;
- Équipe de recherche effectuant une revue rapide des preuves, une revue de la littérature ou une revue systématique ;
- Équipes en sciences pharmaceutiques et biologiques nécessitant le filtrage d’essais cliniques, de documents réglementaires et d’étiquetages de produits ;
- Conseillers et responsables politiques chargés de créer des tableaux d’éléments de preuve structurés, des rapports d’étude et des analyses du paysage concurrentiel ;
- Développeurs souhaitant intégrer des recherches académiques, des rapports ou des revues systématiques dans des systèmes internes ;
- Des organisations de recherche qui doivent suivre en continu les sujets et entretenir une revue vivante.
Avantages du produit
- La recherche sémantique combinée au filtrage par mots-clés est adaptée pour découvrir des articles ayant un sujet similaire mais une formulation différente ;
- Les réponses, les décisions de filtrage et les résultats extraits doivent être accompagnés autant que possible de preuves issues du mémoire, afin de faciliter la vérification ;
- L’extraction en masse sous forme de tableau est plus adaptée à l’organisation des caractéristiques de recherche que la copie article par article ;
- Couvrant en même temps les rapports rapides, les revues systématiques rigoureuses et l’agent de recherche plus ouvert ;
- Soutien à l’importation depuis Zotero ainsi qu’à l’export vers CSV, Excel, RIS, BIB, PDF et Word ;
- Fournit des API et MCP, pouvant être intégrés dans des pipelines de recherche automatisée ;
- La version gratuite permet déjà de réaliser des recherches approfondies sur les articles, d’obtenir des résumés et des réponses à certaines questions sur le texte intégral.
Restrictions et précautions
- Elicit peut réduire les coûts de recherche, de lecture et d’organisation, mais il ne peut pas garantir que les articles soient complets, que leur analyse textuelle soit sans erreur ou que les conclusions de l’IA soient correctes.
- Il peut également y avoir des retards ou des absences en ce qui concerne le filtrage des retraits, la reconnaissance du type de recherche, la classification des revues, les citations et l’accès au texte intégral.
- Les recherches importantes doivent se référer aux publications, aux matériaux complémentaires, aux registres d’enregistrement et à la vérification des données brutes ;
- Une revue systématique ne doit pas se concentrer uniquement sur la vitesse de production ;
- Les chercheurs doivent encore définir le cadre PICO ou un autre cadre de problématique, les protocoles d’enregistrement, concevoir des requêtes de recherche reproductibles, consigner les raisons des exclusions, gérer les études redondantes, évaluer les risques de biais et la certitude des preuves, et préciser le rôle de l’IA à chaque étape ;
- Les décisions en matière de soins médicaux, de médicaments, de politiques publiques et d’investissement ne peuvent pas se baser uniquement sur des rapports automatisés.
- Avant de télécharger des articles non publiés, des données de patients, des secrets commerciaux ou l’intégralité de bases de données restreintes, il convient de consulter la politique de données de votre institution ainsi que les conditions actuelles de confidentialité d’Elicit.
- Enterprise offre un contrôle plus fort en matière d’identité, de sécurité et de déploiement, mais les modalités spécifiques de conservation des données, des sous-traitants, des régions, ainsi que les engagements concernant l’utilisation et la suppression doivent être définis dans le contrat et au sein du centre de confiance.
Questions fréquentes
Est-ce que Elicit est gratuit ?
Il existe une version gratuite Basic qui permet de rechercher indéfiniment plus de 138 millions d’articles, de générer des résumés et de discuter avec les articles dont le texte complet est accessible. Cependant, les fonctionnalités Research Agent et Reports sont limitées, et les capacités avancées en matière d’exportation et de revues systématiques nécessitent un abonnement payant.
Elicit peut-il être utilisé pour rédiger une revue systématique ?
Il peut aider à la recherche, au résumé et au filtrage du texte intégral, à l’extraction de données et à la génération de rapports, ainsi qu’à enregistrer chaque décision. Cependant, pour les revues systématiques de niveau publication ou réglementaire, il reste nécessaire de définir manuellement le plan, de rechercher dans plusieurs bases de données spécifiées, de vérifier le filtrage et l’extraction, et d’effectuer une évaluation du risque de biais.
Elicit prend-il en charge les thèses en chinois ?
Il est possible de rechercher et de traiter certains articles en langue étrangère à part de l’anglais, mais la couverture, les métadonnées et la disponibilité du texte intégral varient généralement en fonction de la langue et de la base de données. Il ne faut pas supposer que toutes les revues chinoises de premier plan, les thèses et les bases de données locales soient incluses ; pour les sujets en chinois, il convient de compléter avec Zhiwang, Wanfang, VIP ou des sources désignées par l’institution.
Quelle est la différence entre Elicit et Google Scholar ?
Google Scholar ressemble davantage à une entrée vers un vaste corpus de découvertes académiques ; Elicit met l’accent sur la recherche par problématique sémantique, les résumés liés aux questions, l’extraction personnalisée en masse, les questions-réponses sur les articles, ainsi que les processus de rapport et de revue systématique.
Dans une recherche rigoureuse, les deux peuvent se compléter, mais ne doivent pas se remplacer entièrement l’un l’autre.
Elicit propose-t-il une API ?
Disponible. Pro, Scale et Enterprise disposent de fonctionnalités de recherche, de rapports, d’API pour les revues systématiques et de MCP ; des exemples sont disponibles sur le GitHub officiel.
Le montant réel d’appel varie en fonction de l’abonnement et du pool d’utilisation.
Elicit est-il open source ?
Le produit principal n’est pas open source. GitHub officiel met à disposition des exemples d’API, des évaluations et des documents de recherche, dont certains sont sous licence MIT, mais il ne comprend pas la plateforme Elicit complète pouvant être déployée par soi-même.
Outils similaires à Elicit

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164