




Julep → memory.store
Julep → memory.store, outil intelligent axé sur la conception en IA
Étiquettes :Outils de conception IAUne phrase pour présenter
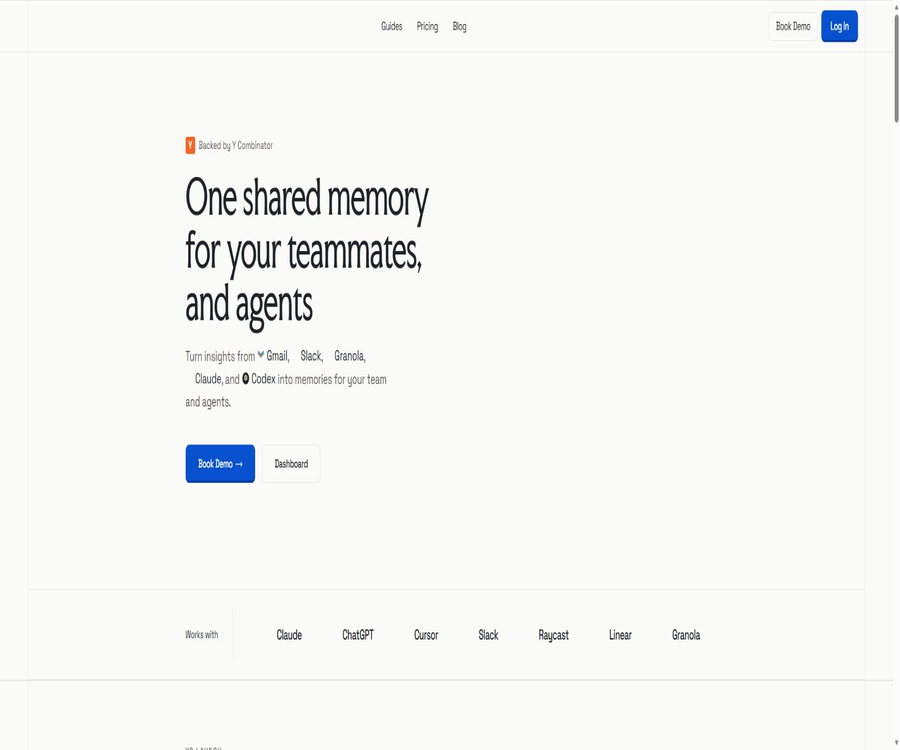
Julep est une plateforme open source de proxy d’IA et de workflows persistants destinée aux développeurs, tandis que Memory Store, que la même équipe gère actuellement en priorité, organise les conversations, réunions, décisions et contextes de travail inter-applications en une mémoire partagée pouvant être consultée par plusieurs clients d’IA.
État actuel du produit
Dans les documents, « Julep ou memory.store » correspond désormais à deux produits liés mais ayant des utilisations différentes. La plateforme Julep est entièrement open source, et le site officiel de l’équipe indique clairement que l’attention principale du produit se porte désormais sur Memory Store.
| Produit | Position actuelle | Utilisateurs principaux | Statut open source |
|---|---|---|---|
| Julep | Agents d’IA persistants et plateforme de workflows composables | Développeurs d’applications d’IA et équipes de plateformes | Open source Apache-2.0 |
| Open Responses | Interface compatible Responses pouvant être gérée en self-hosting | Développeurs ayant besoin de modèles de contrôle propre et de déploiement | Open source Apache-2.0, phase Alpha |
| Memory Store | Partage de mémoires individuelles et collectives à l’aide d’outils d’IA interconnectés | Travailleurs du savoir et équipes | Le produit hébergé ne mentionne pas explicitement qu’il est open source. |
| Marché des plugins de stockage mémoire | Plugins de flux de travail pour Codex et des hôtes tels que Claude | Utilisateur de flux de travail d’agent intelligent | Open source Apache-2.0 |
Le fait que le code de Julep soit open source ne signifie pas que les services de hébergement Memory Store ainsi que leur backend de données soient entièrement open source. Les licences des dépôts de produits, de connecteurs et d’extensions doivent être indiquées séparément dans le répertoire.
Quel problème Julep résout-il ?
Les prototypes d’agents intelligents ordinaires utilisent souvent des modèles et des outils enchaînés par des boucles temporaires ; en cas d’interruption, il est difficile de reprendre le fonctionnement, et il n’est pas aisé d’auditer chaque étape. Julep représente les agents comme des flux de données persistants et composables, permettant aux tâches longues de conserver leur état, de tenter à nouveau leur exécution et d’interpréter le processus d’exécution.
- Définir des agents IA avec une configuration et des permissions d’outil précises.
- Maintenir le dialogue entre les sessions et le contexte de l’utilisateur.
- Organiser des tâches comprenant des conditions, des boucles, du parallélisme et des appels d’outils.
- Enregistrer l’état d’exécution, les sorties des étapes et les erreurs.
- Après un échec, réessayer ou se remettre en état de manière sécurisée selon la stratégie.
- Récupérer des informations pertinentes à partir de documents et d’archives.
- Accès via Python, Node.js, API ou service auto-hébergé.
Agents
L’agent stocke le modèle, le nom, l’usage, les instructions, les modèles système, les paramètres de génération par défaut, les métadonnées, la documentation et les outils autorisés. Un même agent peut servir plusieurs sessions ou tâches.
| Configuration du proxy | effet | Conseils de conception |
|---|---|---|
| Instructions | Définir les rôles, les tâches et les limites de comportement | Restez clairs et évitez les conflits entre vous. |
| Model | Sélectionner le modèle de raisonnement pratique | Selon les tests de qualité, de délai et de coût |
| Default Settings | Configurer les paramètres tels que la température, le format de sortie, etc. | Commencer par une valeur conservatrice |
| System Template | Rendre les agents, les utilisateurs, les sessions et les documents dans le contexte | Éviter d’injecter des instructions non fiables |
| Tools | Accorder des capacités à des fonctions, systèmes, intégrations ou API | Seules les permissions nécessaires à l’accomplissement de la tâche sont autorisées. |
| Docs | Fournir des matériaux de connaissance consultables | Enregistrer la version, les droits d’accès et le cycle de mise à jour |
| Metadata | Classer par projet, environnement ou usage | Ne pas stocker de clés en clair |
État de la session Sessions
La session est utilisée pour conserver l’interaction continue entre l’agent et l’utilisateur, y compris les messages historiques, le contexte, les modèles système, les métadonnées et les stratégies de débordement de contexte. La mémoire de la conversation fait partie de la session, et non intégrée de manière permanente à la définition de l’agent.
- Créer plusieurs sessions isolées pour le même agent.
- Lier les utilisateurs et les agents à une conversation spécifique.
- Conserver les messages historiques et la situation actuelle.
- Définir une stratégie de troncature ou de contexte adaptatif.
- Recherche vectorielle, textuelle ou mixte pour contrôler le rappel des documents.
- Décider si l’appel d’outil doit être exécuté ou redirigé automatiquement.
- Enregistrer l’état métier non sensible à l’aide de métadonnées.
Mémoire à long terme et RAG
Julep peut associer des documents à des agents ou des utilisateurs, et effectuer des recherches vectorielles, textuelles ou mixtes au cours d’une session. Le stockage des documents, les embeddings ainsi que les messages historiques fournissent ensemble un contexte à long terme aux agents.
| Couche de mémoire | Enregistrer le contenu | Utilisation | Précautions à prendre |
|---|---|---|---|
| Session History | Messages de dialogue par tour | Maintenir la cohérence de la session actuelle | Il est nécessaire de définir un budget de contexte. |
| Situation | Contexte de la session actuelle | Fournir un contexte à court terme pour le modèle | Mettre à jour en temps opportun l’état obsolète |
| User Docs | Documents exclusifs pour les utilisateurs | Recherche personnalisée | Isoler les permissions par utilisateur |
| Agent Docs | Partage des connaissances par l’intermédiaire d’un agent | Fournir des documents pour toutes les sessions pertinentes | Contrôler la version et la portée de visibilité |
| Embeddings | Vecteur à dimension fixe | Recherche de similarité | Le remplacement du modèle nécessite une évaluation de la compatibilité. |
| Metadata | Étiquettes structurées et champs métier | Filtrage, agrégation et gestion d’état | Éviter d’écrire des identifiants confidentiels |
Les résultats de rappel ne sont que des documents pertinents ; ils ne garantissent ni l’exactitude des faits, ni leur mise à jour, ni leur aptitude à être utilisés pour la tâche en cours. L’application doit encore mettre en place une durée de validité pour les documents, un filtrage des droits d’accès et un mécanisme de citation des réponses.
Tâches Tâches à plusieurs étapes
Un Task est une recette de workflow inspirée de GitHub Actions, qui décrit la structure des entrées, les outils et une série d’étapes. Il convient à l’automatisation de tâches nécessitant un exécution prolongée et un flux de contrôle clair, telles que la recherche, le traitement de documents, le service client ou les pipelines de données.
- Vérifier la structure d’entrée de la tâche.
- Transmettre la sortie de l’étape précédente à l’étape suivante.
- Exécuter une branche conditionnelle en fonction des résultats intermédiaires.
- Traiter des collections à l’aide de foreach ou de mapping.
- Appeler des modèles, des outils système, des intégrations et des API externes.
- Définir des tentatives de réessai, des délais d’attente et des chemins d’erreur pour les étapes.
- Utiliser l’objet Execution pour consulter l’état et les résultats de la tâche.
Les indications du document conseillent de ne pas insérer directement dans l’entrée du flux de travail des objets très volumineux de plusieurs MB. Les gros fichiers doivent être téléchargés puis une référence transmise, ou être traités par pagination et par blocs.
Exécution persistante
Julep permet de reprendre une tâche en cas de plantage de processus, d’échec réseau ou d’erreur de service temporaire, et met en œuvre des stratégies pour les erreurs reproductibles. Chaque exécution enregistre les changements d’état, les résultats des étapes, les points d’échec ainsi que les messages d’erreur.
| Capacité d’exécution | effet | Valeur d’ingénierie |
|---|---|---|
| Frozen IR | Compiler le processus de construction en une représentation fixe | Réduire le dérive structurelle en temps de fonctionnement |
| Retries | Réexécuter en cas d’erreur reproductible | Gérer les pannes temporaires du réseau ou des services |
| Timeouts | Limiter l’attente par étape ou tâche | Prévenir le suspension permanente |
| Transitions | Enregistrer les étapes et les changements d’état | Facilite l’audit et le débogage |
| Resume | Reprendre depuis l’état persistant | Soutien aux processus métier à long terme |
| Idempotency | Outil pour marquer les exécutions sécurisées répétées | Réduire les effets secondaires dus aux tentatives de réessai répétées |
Modèle de programmation Flow
Julep 3 organise les noms Python standards en flux combinables, prend en charge les étapes pures, les raisonneurs, les outils, les branches, les sorties, les tentatives de réessai et les délais d’attente, et compile tout cela en une représentation linéaire unifiée. La version 3.x est actuellement encore proposée en version candidate ; son installation nécessite l’option pré-release.
L’interface de la version candidate peut varier ; les projets en production doivent utiliser une version fixe, exécuter des tests d’intégration et établir un plan de mise à niveau. Les anciens documents Tasks et la nouvelle Flow API ne doivent pas non plus être mélangés arbitrairement dans les mêmes exemples de code.
Système d’outils
| Type d’outil | Emplacement d’exécution | Utilisations typiques | Risque |
|---|---|---|---|
| User-defined Function | Retour après traitement par le client | Appeler les capacités locales de l’application | Le client doit valider les paramètres. |
| System Tool | Backend Julep | Séances de manipulation, tâches et métadonnées | Modifier éventuellement l’état de la plateforme |
| Integration | Service d’intégration Julep | Appeler un service commercial tiers | Il est nécessaire de conserver les identifiants en toute sécurité |
| API Call | Pendant l’exécution du flux de travail | Demande directe à une interface externe | Il faut limiter les adresses, les permissions et les frais. |
| MCP Tool | Serveur MCP découvert dynamiquement | Connecter l’écosystème des outils externes | Vérifier les droits du serveur et des outils |
Le modèle ne peut appeler que les outils explicitement autorisés, mais la liste blanche des outils peut néanmoins être trop large. Les outils qui envoient des messages, effectuent des paiements, suppriment ou modifient des données de production doivent disposer d’une validation supplémentaire, d’une clé d’identité et d’un journal d’audit.
Intégration MCP
L’agent Julep peut se connecter à des serveurs publics ou privés compatibles avec MCP, afin de découvrir dynamiquement les outils disponibles. La documentation prend en charge deux modes de transmission : la réponse à une demande et le flux d’événements du serveur.
- Vérifier l’opérateur du serveur MCP et son emplacement de déploiement.
- Listez les outils et les opérations dont l’agent a réellement besoin.
- Mettre le jeton d’authentification dans le stockage secret de Julep.
- Se connecter à l’environnement de test et vérifier les outils découverts.
- Restreindre les opérations d’écriture et la transmission de données sensibles.
- Simuler les délais d’attente, les appels répétés et l’indisponibilité du serveur.
- Enregistrer chaque appel d’outil et ses résultats métier.
- Annuler régulièrement les anciennes identifiants et les connexions inutilisées.
Gestion secrète
Secrets est utilisé pour stocker les clés de modèle, les tokens d’API de tiers et d’autres valeurs sensibles, et pour les référencer par nom dans les tâches et les outils. La documentation indique que les clés sont chiffrées statiquement avec AES-256 et isolées selon le compte du développeur.
- Ne pas écrire la clé dans le code, YAML ou les journaux.
- Des identifiants différents sont utilisés pour le développement, les tests et la production.
- Attribuez les droits minimums en fonction de l’intégration et de l’usage.
- Effectuer un roulement régulier et enregistrer les responsables des identifiants.
- Annuler immédiatement en cas de fuite, plutôt que de simplement supprimer le code.
- Vérifier si la sortie du flux de travail contient accidentellement des clés.
Modèles et fournisseurs
Julep relie de manière unifiée Anthropic, OpenAI, Google, Groq, OpenRouter, Amazon Nova ainsi que divers modèles embarqués via LiteLLM. Les développeurs peuvent changer de fournisseur de modèles sous la même interface de proxy.
| Groupe de fournisseurs | Capacité de représentation | Précautions de production |
|---|---|---|
| OpenAI | Texte, visuel, appel d’outils et sortie structurée | Utiliser sa propre clé de production et la facturation |
| Anthropic | Contexte long, appels d’outils et mémoire cache | Vérifier les régions et paramètres du modèle spécifique |
| Contexte long, multimodalité et capacités audio | Vérifier les différences entre Vertex et AI Studio | |
| Groq | Inférence à faible latence avec plusieurs modèles open source | Les capacités varient selon le modèle. |
| OpenRouter | Accès unifié à plusieurs modèles | Ajouter un niveau de relation entre les données et les coûts |
| Modèles locaux ou self-hébergés | Contrôler le déploiement et les limites des données | Assumer la puissance de calcul, les performances et l’exploitation |
| Embedding Models | Vectorisation de documents et recherche | Julep utilise actuellement uniformément 1024 dimensions. |
La plateforme peut fournir des clés pour le développement et les tests, mais le déploiement en production exige l’utilisation de ses propres clés fournisseur. Les frais liés aux modèles, la limitation du trafic, la conservation des données et les politiques régionales sont déterminés par le fournisseur correspondant ou par un environnement auto-hébergé.
SDK Python et Node.js
Julep fournit des paquets Python et un SDK Node.js pour créer des proxies, des utilisateurs, des sessions, des documents, des tâches et des exécutions. La clé API doit être lue à partir d’une variable d’environnement ou d’un système de gestion des secrets.
- Choisissez la version stable ou une version candidate clairement fixée.
- Installez le SDK correspondant à la langue.
- Créer un environnement de développement isolé et une clé API.
- Créez d’abord un proxy à responsabilité unique.
- Créer des sessions et des utilisateurs de test pour l’agent.
- Ajouter les outils minimaux et la documentation d’exemple.
- Créer une tâche et surveiller l’état d’Exécution.
- Vérifier les erreurs, réessayer, les permissions et les frais avant de reprendre le service.
Open Responses
Open Responses est une interface compatible avec Responses, open source et auto-hébergée, fournie par Julep. Elle permet de se connecter à différents backends de modèles et d’assurer l’intégration des SDK existants en modifiant l’adresse de base. Elle convient aux équipes qui ont besoin d’un déploiement local ou privé afin de réduire la dépendance vis-à-vis des modèles.
| Capacité | État actuel | Utilisation | Restrictions |
|---|---|---|---|
| Interfaces compatibles avec les réponses | Disponible | Entrée de génération de réponses similaires en remplacement | Ce n’est pas une couverture de tous les actes officiels |
| Déploiement Docker | Soutien | Démarrer des microservices dans le cloud ou localement | Nécessite Docker Compose |
| Installation CLI | Soutien | Génération automatique des fichiers de configuration et de conteneur | Le niveau inférieur dépend toujours de Docker |
| Changement de modèle | Soutien | Connecter Claude, Qwen, DeepSeek, etc. | Il est nécessaire de disposer de la clé du fournisseur correspondante. |
| Outils intégrés | Soutien à des alternatives amovibles | Exécuter des appels d’outils tels que la recherche | Il est nécessaire d’évaluer la sécurité et la cohérence. |
| Maturité | Alpha | Expérimentation et validation | L’interface peut changer. |
Architecture auto-hébergée
Le Julep complet peut être exécuté via Docker Compose en mode unique ou multi-locataires, avec des composants tels que l’API du proxy, le stockage mémoire, les services d’intégration, le proxy de modèles, Temporal, le stockage d’objets ou de blobs, la surveillance et le gateway.
| Composant | effet | Exigences de maintenance |
|---|---|---|
| Agents API | Gestion des agents, des sessions, des tâches et de l’exécution | Authentification, élargissement et surveillance des API |
| Memory Store | Enregistrer les données de relations et les embeddings vectoriels | Sauvegarde, migration et contrôle d’accès |
| Temporal | Workflow long persistant | Gestion de la file d’attente des tâches et de la capacité historique |
| Integrations Service | Mettre en œuvre l’adaptation d’outils tiers | Gestion des clés et des sorties réseau |
| LLM Proxy | Appel du modèle unifié | Limitation de la charge du modèle, coûts et basculement en cas de panne |
| Blob Store | Stocker de plus grands données d’exécution | Cycle de vie et chiffrement |
| Grafana et Prometheus | Surveillance et indicateurs | Alertes, journaux et conservation des données |
| Gateway | Router et exécuter l’authentification du locataire | Certificats, débits et sécurité des frontières |
Un seul locataire et plusieurs locataires
Le mode unique locataire permet d’utiliser directement le SDK sans exiger de clé API, ce qui convient au développement local ou à des environnements internes contrôlés. Le mode multi-locataires nécessite la génération de JWT et l’isolation des ressources des développeurs au niveau du gateway.
Le fait que la clé ne soit pas requise ne signifie pas que les services monotenant puissent être exposés au réseau public. Un environnement de production nécessite toujours un proxy inversé, une authentification, une isolation réseau, des sauvegardes et une auditabilité.
Qu’est-ce que Memory Store ?
Memory Store est le produit phare actuel de l’équipe, décrit comme un Dropbox destiné au contexte des agents intelligents. Il organise les réunions, les messages, les notes, les décisions, les personnes et les pistes de projets en une mémoire lisible pour les individus ou les entreprises.
- Synchroniser du contenu depuis des outils de travail tels que Slack, Gmail, Granola et Fathom.
- Organiser le dialogue et les notes en personnages, projets et décisions.
- Créer des Living Briefs qui sont mis à jour avec de nouvelles mémoires.
- Conserver les préférences, les notes et le contexte à long terme pour l’utilisateur.
- Conserver pour l’équipe les discussions et les raisons derrière la décision.
- Permettre à différents clients IA d’accéder au même contexte via MCP.
- Permettre aux utilisateurs de consulter et de supprimer les souvenirs.
Partage de la mémoire entre outils
Memory Store se connecte via MCP à des clients compatibles tels que Claude, Codex, ChatGPT, Cursor, Raycast, etc., permettant ainsi de récupérer le contexte enregistré dans une application dans une autre. Le site officiel indique qu’il est compatible avec tous les clients MCP, et que Claude a fait l’objet des tests les plus approfondis.
| Opérations de mémoire | effet | Principes d'utilisation |
|---|---|---|
| checkin | Créer le contexte de compte et de travail actuel | Exécuté au début de chaque flux de travail important |
| recall | Rechercher des souvenirs pertinents selon une question | Ne prendre que les matériaux nécessaires à la tâche |
| list-briefs | Voir les Living Briefs disponibles | Sélectionner le graphique thématique d’autorité |
| record | Enregistrer les faits ou décisions confirmés | Ne pas consigner des suppositions non confirmées |
| report-issue | Problème de mémoire de retour ou d’outil | Contexte reproductible joint |
Le partage de mémoires entre clients élargit la portée de l’accès aux données. Les utilisateurs doivent distinguer les espaces personnels de ceux liés à l’équipe, et éviter d’y stocker des informations confidentielles, des identifiants ou des conversations privées dans des mémoires partagées inappropriées.
Living Briefs
Les Living Briefs sont des documents thématiques mis à jour en fonction de nouvelles informations, qui permettent de regrouper le journal des décisions, l’état de l’équipe, les besoins des clients, le contexte du projet ou les règles de la marque. Ils ne se contentent pas d’accumuler tous les dialogues originaux, mais maintiennent plutôt une compréhension du travail relativement stable.
- Définir un thème clair et une personne responsable pour chaque Brief.
- Conserver les preuves clés derrière la conclusion.
- Marquer les décisions qui sont dépassées ou annulées.
- Évitez de transformer chaque événement temporaire en règle permanente.
- Une confirmation manuelle est requise pour les changements importants.
- Nettoyer régulièrement les mémoires redondantes et conflictuelles.
Mode d’installation de Memory Store
Les hébergeurs qui ne disposent pas de système de plugins, tels que Claude Desktop, peuvent se connecter directement à Memory Store MCP. Claude Code et Codex peuvent également installer des compétences de flux de travail Memory Store via un marché de plugins public, avant d’obtenir la certification MCP.
| hôte | Mode d’accès | État actuel | Précautions à prendre |
|---|---|---|---|
| Claude Code | Marché des plugins + MCP | Vérifié | Redémarrez et authentifiez-vous après l’installation. |
| Codex CLI | Ajouter un marché et l’activer dans l’interface du plugin | Vérifié | L’installation au niveau des plugins s’effectue principalement via l’interface. |
| Claude Cowork | Marché de téléchargement d’interfaces de plugins personnels | Vérifié | Il est recommandé d’activer la synchronisation automatique. |
| Claude Desktop | Se connecter uniquement au MCP | Prend en charge les connecteurs, pas les plugins | Les compétences de plugins ne seront pas chargées. |
| Autres clients MCP | Configurer Memory Store MCP | Compatibilité en principe | L’hôte spécifique n’a pas encore été vérifié. |
Marché des plugins de stockage mémoire
Le dépôt public mem-plugins est licencié sous la licence Apache-2.0 et comprend le plugin de base memory-store ainsi que le plugin indépendant gtm-agent. Le code des plugins est open source, mais leur utilisation normale dépend néanmoins de l’hébergement par Memory Store pour les certifications MCP.
L’agent GTM peut également faire appel à la recherche, aux e-mails, au calendrier et aux connecteurs automatisés, et être capable d’exécuter des workflows d’approche. Avant d’installer toute extension, il convient de vérifier les droits requis, l’approbation pour l’envoi, les listes de suppression et les coûts liés aux services externes.
Prix et coûts
Les informations sur les prix ont été vérifiées le 23 août 2026 ; les montants réels, les taxes, les taux de change et les remises peuvent varier. Les données finales seront celles affichées sur la page de paiement.
Le code source de Julep peut être utilisé et modifié gratuitement, mais l’hébergement propre n’est pas sans coût. La version personnelle de Memory Store permet une mise à l’épreuve gratuite, tandis que la version d’équipe nécessite une demande pour une démonstration ; aucun forfait fixe public n’est actuellement disponible.
| Produit ou coût | État du prix actuel | Qu’est-ce que ça contient ? | Adéquat pour les utilisateurs |
|---|---|---|---|
| Code source de Julep | Gratuit, Apache-2.0 | Agents, sessions, tâches, outils et composants auto-hébergés | Développeurs et équipes de plateforme |
| Open Responses | Gratuit, Apache-2.0 | Interfaces compatibles self-hostées et CLI | Équipes ayant besoin d’une interface de modèle de contrôle de soi |
| Appel du modèle | Facturation par fournisseur ou capacité de calcul locale | Recherche sur les textes, les modalités multiples et les embeddings | Toutes les déploiements de production |
| Infrastructure | Selon les ressources cloud et les coûts de gestion | Bases de données, Temporal, stockage d’objets, surveillance et réseau | Équipe auto-hébergée |
| Expérience personnelle de Memory Store | Essai gratuit, limite fixe non divulguée | Mémoires personnelles, pages et connexion MCP | Utilisateurs d’outils d’IA personnels |
| Édition équipe Memory Store | Réservation d’une démonstration ou demande de devis sur mesure | Partager la mémoire de l’entreprise, synchroniser et le contexte d’équipe | Organisations et entreprises |
| Code source de mem-plugins | Gratuit, Apache-2.0 | Plugins de flux de travail Memory Store et GTM | Codex et les utilisateurs hôtes tels que Claude |
Lors de l’achat de Memory Store, il convient de confirmer par écrit les emplacements, les connecteurs, le stockage, le nombre de rappels, la conservation des données, les exportations, le support et les processus de suppression. Pour Julep auto-hébergé, il faut inclure les modèles, les ressources cloud, les sauvegardes, la sécurité et les ressources humaines pour les mises à jour dans le coût total.
Précautions relatives aux données et à la sécurité
- Créer une isolation des locataires pour les agents, les utilisateurs, les sessions et les projets.
- Appliquer un filtrage des droits cohérent avec les activités métier à la recherche de documents.
- Envoyer uniquement aux outils les données nécessaires pour effectuer l’opération.
- Considérez le modèle et l’intégration avec des tiers comme des parties indépendantes de traitement des données.
- Définir la durée de conservation des messages, des documents, de l’historique d’exécution et des journaux.
- Bases de données chiffrées, stockage d’objets, sauvegardes et trafic réseau.
- Ajouter une validation manuelle pour les outils de suppression, d’envoi et de paiement.
- Testez régulièrement la restauration des sauvegardes et le renouvellement des identifiants.
L’autogestion complète de Julep permet aux équipes de contrôler l’infrastructure, mais la responsabilité en matière de sécurité est également transférée à celui qui effectue le déploiement. Memory Store fait partie des produits à contexte partagé ; il convient donc, avant son utilisation, de vérifier la région d’hébergement, le sous-traitant et le contrat d’entreprise.
Licence open source
| Entrepôt ou produit | Licence | Que peut-on faire | On ne peut rien en déduire. |
|---|---|---|---|
| julep-ai/julep | Apache-2.0 | Utiliser, modifier, déployer et distribuer du code | Ressources cloud et modèles gratuits |
| Open Responses | Apache-2.0 | Services compatibles self-hébergés | Entièrement conforme à toute interface commerciale |
| julep-ai/mem-plugins | Apache-2.0 | Réutilisation et extension des compétences des plugins | Stockage mémoire hébergé backend open source |
| Memory Store SaaS | Licence de code source du produit non déclarée | Utiliser conformément aux règles de service | Produit entièrement géré pouvant être déployé en autonomie |
Apache-2.0 autorise l’utilisation commerciale et contient des clauses de licence sur les brevets, mais la licence et la déclaration doivent être conservées lors de toute redistribution. Le déploiteur doit également se conformer aux licences des modèles, des bases de données, des dépendances et des outils tiers.
À qui s’adresse-t-il
- Développeurs d’applications IA ayant besoin de persister pour les tâches longues.
- Équipe backend nécessitant des branches, des boucles, des tentatives répétées et l’orchestration d’outils.
- Les entreprises qui souhaitent disposer d’une plateforme d’agent auto-hébergée et d’une couche de données.
- Équipe de produits nécessitant RAG trans-sessionnel et mémoire utilisateur.
- Développeurs qui souhaitent changer de fournisseur de modèles grâce à une interface unifiée.
- Utilisateurs individuels qui ont besoin d’outils tels que Claude et Codex pour partager le contexte.
- Souhaite créer une équipe pour la prise de décision en entreprise et la mémoire des projets.
- Membres de la communauté qui développent les plugins Memory Store et les workflows d’agents intelligents.
Avantages du produit
- La plateforme principale Julep est éditée sous une licence permissive Apache-2.0.
- Gérer de manière unifiée les agents, les sessions, les documents, les tâches et l’exécution.
- Prend en charge la persistance, le redémarrage en cas d’échec, les tentatives de réessai et le suivi des états.
- Fournit des méthodes de déploiement en Python, Node.js, API et Docker.
- Plusieurs fournisseurs de modèles sont pris en charge via LiteLLM.
- Open Responses offre des interfaces compatibles à héberger soi-même.
- Memory Store permet de partager le contexte entre plusieurs clients IA.
- Living Briefs est adapté pour maintenir une connaissance d’équipe constamment mise à jour.
- Le code du marché des plugins est ouvert et extensible.
Principales restrictions
- Julep 3 est toujours en phase de publication candidate.
- Une architecture autonome complète comporte de nombreux composants, ce qui rend son exploitation assez complexe.
- L’appel du modèle de production nécessite une clé fournisseur et entraîne des frais.
- Certains documents anciens peuvent coexister avec la nouvelle interface Flow.
- Les réponses ouvertes sont encore en phase Alpha.
- Fournir une interface compatible ne garantit pas un comportement identique.
- Les forfaits fixes Memory Store, les quotas et les conditions relatives aux données d’entreprise ne sont pas divulgués.
- Le partage de mémoires entre outils élargit l’accès aux informations sensibles.
- Les plugins open source ne signifient pas que le backend hébergé par Memory Store est open source.
Recommandations de sélection
| Demande | Préférence donnée | Raison |
|---|---|---|
| Construire des agents intelligents complexes réparables | Julep | Fournit des workflows durables, des outils et un état d’exécution |
| Nécessite une conversation continue et RAG | Julep Sessions et Docs | Intégration de l’historique des sessions et du rappel de documents |
| Interface compatible avec les Responses auto-hébergées | Open Responses | Modèles contrôlables et infrastructure |
| Outils d’IA personnels partageant la mémoire à long terme | Memory Store | Enregistrement et récupération à travers les clients via MCP |
| Cerveau de l’entreprise d’équipe et enregistrement des décisions | Memory Store Team | Synchroniser les canaux de travail et gérer les Living Briefs |
| Étendre les workflows Codex ou Claude | mem-plugins | Marché public des plugins et compétences |
Liste de vérification avant mise en ligne
- Vérifier s’il est nécessaire d’orchestrer via un agent ou de partager la mémoire entre clients.
- Sélectionner une version stable de Julep et fixer les dépendances.
- Listez les coûts de modèles, de bases de données, deTemporal et de stockage.
- Définir des niveaux de permissions minimales et de niveaux d’effets secondaires pour chaque outil.
- Concevoir le contrôle d’accès des locataires, des utilisateurs, des projets et des documents.
- Rétablissement en cas d’échec de test, idempotence, délai d’expiration et appels répétés.
- Politique de traitement des données pour l’évaluation des modèles et leur intégration avec des tiers.
- L’équipe Memory Store confirme par écrit avec l’utilisateur les prix et les conditions des données.
- Mettre en place des processus de correction, de suppression, d’exportation des mémoires et de transmission en cas de départ.
- Effectuer l’acceptation en matière de sécurité et de coûts à l’aide de flux de travail réels à petite échelle.
Questions fréquentes
Julep est-il maintenant open source ?
Oui. Le dépôt principal de Julep est sous licence Apache-2.0, il peut être utilisé, modifié et hébergé en propre ; la version 3.x est actuellement encore une version candidate.
Memory Store est-il aussi Julep ?
Les deux sont gérés par la même équipe mais à des fins différentes. Julep est une plateforme d’agent pour développeurs, tandis que Memory Store est un produit de mémoire d’agents partagée destiné aux individus et aux équipes.
Le Julep est-il gratuit ?
Le code source est gratuit, mais les modèles, les bases de données, le stockage d’objets, Temporal, le réseau et l’exploitation entraînent des coûts réels. Les prix des anciennes solutions cloud ne doivent pas servir de forfait fixe pour les produits open source actuels.
Combien coûte Memory Store ?
Le site officiel indique que les utilisateurs individuels peuvent bénéficier d’une version d’essai gratuite, tandis que la version d’équipe nécessite une demande de démonstration préalable ; le prix et les quotas fixes ne sont pas encore publiés. Lors de l’achat, il convient de confirmer le contrat complet avec le service des ventes.
Julep prend-il en charge la mémoire à long terme ?
Soutien. Sessions conserve les dialogues et les contextes, Docs ainsi que le stockage intégré prennent en charge la récupération vectorielle, textuelle ou mixte ; l’architecture entièrement auto-hébergée inclut également un service de mémoire persistante.
Julep prend-il en charge MCP ?
Il prend en charge la connexion à des serveurs compatibles MCP ainsi que la découverte dynamique d’outils. Memory Store lui-même permet également, via MCP, à plusieurs clients IA d’enregistrer et de récupérer des mémoires partagées.
Le Julep peut-il être déployé en mode privé ?
Oui. La plateforme complète et Open Responses offrent toutes deux des chemins de self-hosting Docker, mais le déploiteur est responsable de l’authentification, des données, du monitoring, des sauvegardes et des mises à jour.
Memory Store est-il open source ?
Le code du marché des plugins Memory Store est soumis à la licence Apache-2.0, mais les produits hébergés et le backend ne sont pas entièrement déclarés open source. Ne pas considérer les plugins comme open source revient à ne pas considérer la plateforme SaaS comme telle.
Résumé
Julep est adapté aux équipes de développement d’applications IA qui ont besoin d’un état à long terme, d’un flux de contrôle complexe, de récupération en cas d’échec, de RAG et d’intégration de multiples outils. Sa licence Apache-2.0, sa capacité à être auto-hébergée et ses interfaces multi-modèles offrent un fort contrôle technique.
Memory Store résout le problème que rencontrent les individus et les équipes pour fournir à plusieurs reprises du contexte entre différentes outils d’IA. Lors du choix, il convient d’abord de distinguer entre « la création d’un backend pour agent intelligent » et « l’achat d’un service de mémoire partagée », puis d’évaluer séparément les coûts de maintenance open source, les prix de hébergement, les droits sur les données et la gouvernance de la mémoire entre clients.
Outil similaire à Julep → memory.store

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164