




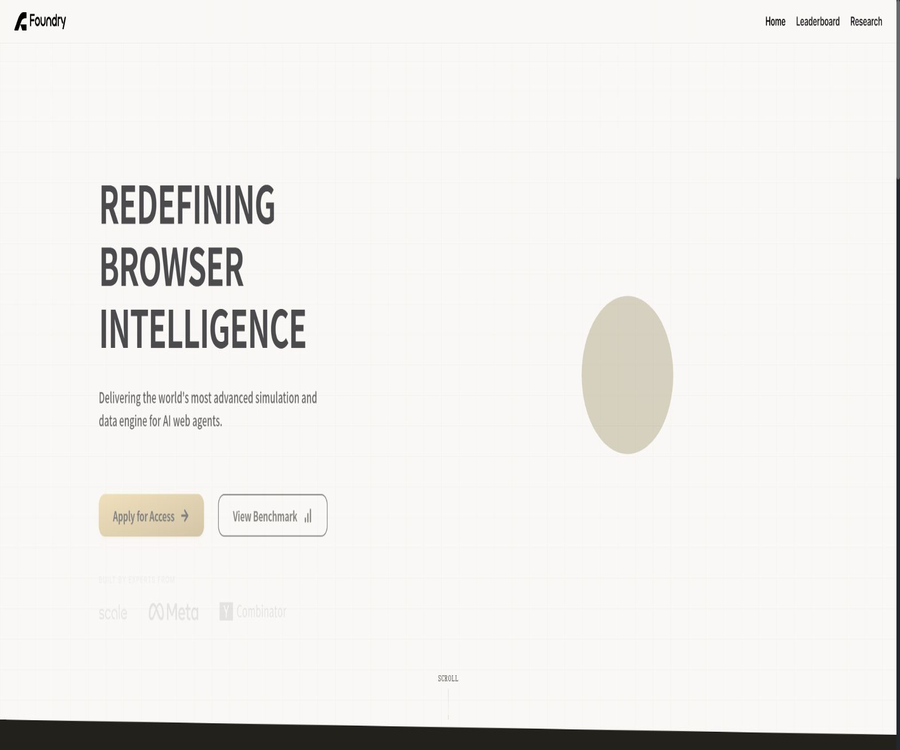
Foundry
Foundry, outil intelligent spécialisé dans la conception par IA
Étiquettes :Outils de conception IAQu’est-ce que Foundry ?
Foundry est une plateforme de simulation, d’évaluation et d’entraînement des données destinée aux équipes de développement d’agents intelligents pour navigateurs IA. Grâce à un environnement web d’entreprise réinitialisable, elle permet aux développeurs de tester et d’entraîner des agents automatisés sans avoir recours à des sites web réels en perpétuel changement.
Il s’agit ici de la plateforme d’agents navigateurs opérant sur thefoundryai.com, qui utilisait auparavant le nom de domaine foundryrl.com ; il ne s’agit pas de Microsoft Foundry, de Foundry VTT ou d’autres produits portant un nom similaire.
Une phrase pour présenter
Foundry fournit aux agents navigateurs des simulations de pages web reproductibles, une évaluation par action, des données de trajectoires longues d’experts et des environnements d’apprentissage par renforcement, et permet d’intégrer des agents existants via le SDK Python.
Positionnement du produit
| Projet | Positionnement de Foundry | Utilisateurs principaux |
|---|---|---|
| simulation | Recréation de la page web de l’entreprise et de son état d’activité | Plateforme d’agents intelligents et équipe de recherche |
| Évaluation | Enregistrer, classer et noter chaque action | Équipe d’évaluation, de qualité et de modèles |
| Données | Générer des trajectoires expertes orientées vers les processus d’entreprise réels | Équipe de supervision du fine-tuning |
| Apprentissage renforcé | Échantillonnage de nombreuses trajectoires dans un environnement réinitialisable | Entraînement postérieur et équipe Agent RL |
| Classement | Comparer le taux de réussite et le temps de traitement sur des tâches standard | Décideurs de sélection de modèles et de développement |
Pourquoi les agents navigateurs ont-ils besoin de simulation
Les sites web réels sont constamment mis à jour, leurs données sont mises à jour et différents états de compte apparaissent, ce qui fait que le même agent est confronté à des environnements différents à différents moments. Les codes de vérification, les mesures anti-automatisation, les limites de vitesse et les fluctuations réseau rendent également difficile la répétition de l’entraînement.
Foundry tente de figer les pages web, les comptes et les données commerciales dans un état contrôlé, afin que chaque évaluation parte d’un point de départ identique. L’équipe peut ainsi attribuer les échecs à l’agent lui-même, plutôt qu’à des déviations des pages inexplicables.
Environnement de navigateur reproductible
Le module de simulation met l’accent sur un environnement de navigateur reproductible au niveau des pixels, et évite le décalage des pages, le bruit aléatoire et les restrictions de vitesse externes. L’environnement peut être réinitialisé à son état initial pour les tests en série et la comparaison de stratégies.
La valeur de la reproductibilité
- Faire face à des modèles différents avec les mêmes pages, données et conditions de tâche.
- En cas d’échec, il est possible de rejouer l’opération et d’identifier le problème spécifique lié à l’interface ou à la stratégie.
- Exécuter des tests de régression cohérents après la mise à niveau des suggestions, des modèles ou des outils.
- Tester les opérations d’écriture sans polluer le système de gestion réel.
- L’échantillonnage en lot des trajectoires n’est pas perturbé par les mécanismes d’anti-automatisation des sites réels.
Évaluation des agents intelligents
Le module d’évaluation suit, classe et met en étiquette chaque action de l’agent. Les échecs de clic, les changements de disposition, les opérations incorrectes et les états où l’objectif n’a pas été atteint ne sont pas réduits à un seul score final.
Indicateurs clés d’évaluation
| Indicateur | Signification | Mode d’interprétation |
|---|---|---|
| Taux de réussite de la tâche | Pourcentage d’exécution visant l’atteinte de l’objectif | Il convient de tenir compte de la difficulté de la tâche et de la taille de l’échantillon. |
| Temps moyen de réalisation | Temps moyen pour une tâche réussie | Plus rapide ne signifie pas nécessairement plus fiable. |
| Nombre d’actions | Étapes à suivre pour accomplir une tâche | Trop peut signifier faire un détour ou se remettre en route. |
| Type d’échec | Catégories : clics, mise en page, erreurs d’opération, etc. | Utilisé pour localiser les problèmes d’ingénierie |
| Changement d’état | Comment les pages web et les données métier sont-elles modifiées | Vérifier les résultats plutôt que de se fier uniquement au texte |
| Consistance inter-environnements | Corrélation entre les résultats de simulation et ceux de l’environnement réel | Évaluer la fidélité de la simulation |
Enregistrement des trajectoires, des événements et des états
Les exemples du SDK Python montrent que les développeurs peuvent obtenir des indications sur la tâche, la page de départ, les identifiants d’accès, les détails de paiement et des notes supplémentaires, ainsi que enregistrer des événements, l’état final et les changements d’état. L’évaluateur compare ensuite le résultat final avec la réponse parfaite.
Preuves d’exécution adaptées à la conservation
- ID de la tâche, version de l’environnement et version de l’agent.
- Chaque étape : observation, action, retour de l’outil et temps.
- Clics, saisie, navigation et événements d’erreur.
- Changements d’état initial, d’état final et d’états intermédiaires.
- Normes artificielles, notation automatique et catégories d’échec.
- Modèles, prompts, paramètres d’échantillonnage et coûts.
Données d’entraînement au niveau entreprise
Le module Data génère des données de trajectoires longues personnalisées par des annotateurs experts, destinées aux plateformes d’entreprises réelles et aux workflows interapplications. Ces données peuvent être utilisées pour le fine-tuning supervisé, permettant au modèle d’apprendre la séquence correcte des opérations, le jugement des champs et la récupération en cas d’échec.
Caractéristiques des données de trajectoire longue
- La tâche nécessite de traverser plusieurs pages et applications.
- L’opération précédente modifiera l’état des pages suivantes.
- L’erreur peut ne se révéler qu’après de nombreuses étapes.
- Il ne faut pas seulement inclure des chemins vers le succès, mais aussi des exemples de récupération et de correction d’erreurs.
- Le résultat de la tâche est vérifié en fonction de l’état métier, et non seulement par la dernière réponse.
Environnement d’apprentissage renforcé
Le module RL permet de sampler et d’évaluer en boucle un grand nombre de trajectoires dans des simulations sécurisées, évitant ainsi les risques liés aux codes de vérification, aux blocages et aux données de production des sites réels. L’équipe de développement peut ainsi optimiser l’attribution du crédit et la récupération en cas d’erreur au sein de processus longs.
Problèmes de recherche adaptés à l’apprentissage renforcé
- Comment attribuer la récompense finale pour le succès aux actions intermédiaires.
- Quand un agent doit réessayer, faire marche arrière ou changer de stratégie.
- Mémoire et suivi de l’état dans les workflows inter-applications.
- Alignement et validation des champs dans les formulaires complexes.
- Équilibrer les coûts d’action, le temps nécessaire et le taux de réussite.
Benchmark SDRBench
SDRBench, publié par Foundry, est un ensemble de benchmarks réinitialisables en navigateur et un terrain d’entraînement à l’apprentissage renforcé conçu pour le processus des représentants de développement des ventes. Il comprend 50 tâches déterministes et conserve l’état entre les applications.
La tâche couvre des processus métier similaires à ceux de Gmail, Sheets et LinkedIn pour le développement de clients, ainsi qu’Apollo et Salesforce, servant à l’étude des leads, à la personnalisation des approches, à la gestion des clients et à l’évaluation du potentiel des prospects.
Capacité de couverture de référence
| Phase de travail | Tâche de représentation | Capacités nécessaires à l’agent intelligent |
|---|---|---|
| Recherche d’indices | Rechercher des informations sur les entreprises et les contacts | Recherche, lecture et intégration des preuves |
| Préparation des relations extérieures | Rédiger du contenu personnalisé en fonction des indices | Compréhension du contexte et génération de texte |
| Gestion de tableaux | Lire et mettre à jour la liste des indices | Opérations sur les données structurées |
| Maintenance CRM | Créer, modifier et faire avancer les enregistrements | Permissions, champs et vérification d’état |
| Évaluation des qualifications | Évaluer les prospects selon les règles | Raisonnement multicritère |
| Transfert entre applications | Transférer l’état entre e-mails, formulaires et CRM | Mémoire à long terme et cohérence |
Classement public
Le classement est conçu pour afficher les modèles, le taux de réussite moyen et le temps moyen de réalisation des tâches réussies, tout en offrant une analyse par étape du processus. Il permet également aux équipes de soumettre des agents, d’optimiser les agents existants ou de mettre leurs processus métier en référence.
Lors de la vérification, la version du SDR Automation Benchmark indiquée sur la page est celle de septembre 2025, mais le tableau ne montre aucune performance publique disponible. Le texte du répertoire ne doit pas inventer de classements de modèles ou de taux de réussite.
Conformité entre simulation et environnement réel
Foundry propose d’exécuter des tâches en parallèle dans un environnement de simulation et dans un environnement réel, puis de vérifier la fidélité à l’aide de la corrélation du taux de réussite, de la corrélation de Pearson et de la cohérence de tri. Le système doit également détecter les dérives de l’interface réelle et calibrer en continu la simulation.
Évaluer la fiabilité de la simulation
- Sélectionnez un ensemble de tâches commerciales réelles, autorisées et dont le risque est maîtrisé.
- Utiliser les mêmes agents et définitions de tâches dans l’environnement de simulation et dans l’environnement réel.
- Comparer le taux de réussite, les étapes, le temps nécessaire et les types d’échecs.
- Calculer la différence absolue, la corrélation et la cohérence du classement des modèles.
- Déterminer si les différences proviennent des pages, des données, du réseau ou des règles métier.
- Modifier la simulation et la relancer jusqu’à atteindre la marge d’erreur prédéfinie.
Méthode d’intégration du SDK Python
L’exemple du site officiel crée une tâche via l’objet d’environnement AWE, obtient l’adresse de connexion de la tâche au CDP, puis transfère la session du navigateur à l’agent existant. Après exécution, il est possible de lire l’état final, les changements d’état et les événements.
Processus d’accès
- Demandez un test privé et obtenez un compte de plateforme, des tâches et des clés.
- Installez le SDK Python fourni par la plateforme dans un environnement de développement isolé.
- Créer un environnement AWE à l’aide de l’ID de tâche et activer l’enregistrement des événements.
- Lire les instructions de la tâche et transmettre l’adresse de connexion du navigateur à l’agent.
- Exécutez l’agent et attendez qu’il soumette des résultats ou que les conditions de terminaison soient remplies.
- Obtenir l’état final, les changements d’état, les événements et les trajectoires.
- Calculer les scores en utilisant les réponses standard ou des heuristiques commerciales.
Créer un tutoriel d’évaluation de régression
- Sélectionner un ensemble de tâches représentatif en fonction de la valeur commerciale, de la difficulté et du risque.
- Geler l’entrée de la tâche, l’état initial, les conditions d’acceptation et la version de l’environnement.
- Définir des scores pour succès, succès partiel, modification incorrecte et délai dépassé.
- Enregistrer le modèle, les prompts, la version des outils, les paramètres et la graine aléatoire.
- Exécuter plusieurs fois pour calculer la moyenne, la variance et les intervalles de confiance.
- Localisez les problèmes de type d’échec : indication, visuel, planification ou exécution.
- Intégrer un seuil dans le processus de publication pour empêcher la mise en ligne de versions clairement dégradées.
Tutoriel pour créer des données d’entraînement
- Déterminer la plateforme cible, les rôles des utilisateurs, les permissions et les processus à haute valeur.
- Découper le flux de travail en états initiaux vérifiables, étapes et résultats.
- Exécuté par des experts autorisés et avec un suivi complet du parcours enregistré.
- Marquer l’observation, l’action, le champ, la raison, l’erreur et la récupération.
- Supprimer les informations personnelles réelles, les clés et les secrets du client.
- Vérifier la qualité des trajectoires par double vérification et par contrôle de règles automatiques.
- Diviser les ensembles d’entraînement, de validation et de test pour éviter le fuitage des tâches.
Tutoriel pour l’évaluation des agents intelligents
- Vérifiez les critères d’accès aux tests privés et lisez les exigences actuelles de soumission.
- Fixer la version de l’agent intelligent, le modèle, les outils et les paramètres de fonctionnement.
- Utiliser une clé de test pour valider la connexion, la terminaison et le traitement des erreurs.
- Soumettre l’agent et laisser la plateforme exécuter des tâches standard.
- Voir le taux de réussite, le temps écoulé, les actions et les étiquettes d’échec.
- Corriger selon la phase d’échec et rétester dans le même environnement.
- Lors de la publication des résultats, il convient d’indiquer en même temps la version, la date et la méthode.
À qui s’adresse-t-il
- Entreprise d’agents navigateurs : nécessité d’évaluer de manière fiable les mises à jour des produits.
- Équipe des grands modèles : entraînement de la capacité de compréhension et d’interaction avec les pages web.
- Équipe Agent RL : un environnement réinitialisable et scalable est nécessaire.
- Équipe d’automatisation d’entreprise : Vérifier si les agents peuvent opérer en toute sécurité les systèmes internes.
- Équipe des données : Achat ou création de données de haute qualité à longue trajectoire.
- Institution de recherche : Analyse de la planification inter-applications, du redressement et de l’attribution du crédit.
- Équipe d’évaluation des modèles : création de benchmarks navigateurs avec des preuves d’état.
Scénarios d'utilisation typiques
- Comparer le taux de réussite des différents modèles dans le même processus d’entreprise.
- Avertissements de tests de régression, mises à jour d’outils ou d’exécuteurs de navigateur.
- Déterminer à quel étape l’agent échoue en cliquant, en saisissant ou en prenant une décision.
- Former des agents pour gérer les e-mails, les tableurs, le développement de clients et le CRM.
- Tester les tâches d’écriture sans toucher aux données de production.
- Générer des trajectoires d’ajustement supervisé et d’apprentissage par renforcement.
- Transformer les processus de travail propres aux clients en références internes.
- Évaluer si la page web est facile à utiliser pour des agents intelligents automatisés.
Avantages du produit
- L’environnement peut être réinitialisé, ce qui facilite une comparaison équitable entre différents agents.
- En se basant sur l’état final et les tâches de vérification des changements d’état, et non seulement sur les réponses.
- La classification des événements par action permet de déterminer la véritable cause de l’échec.
- La simulation évite les codes de vérification, les blocages et les limitations de vitesse des sites web réels.
- Couvrant en même temps l’évaluation, les données et la chaîne d’entraînement par apprentissage renforcé.
- Prend en charge les workflows longs, transversaux aux applications et les workflows SaaS d’entreprise.
- Le SDK Python peut s’intégrer aux frameworks d’agents navigateur existants.
- SDRBench offre un accès public à la conception de tâches et à la recherche.
Restrictions d'utilisation et précautions
- La plateforme est encore en test privé et un accès doit être demandé.
- Le site officiel ne divulgue pas de forfaits fixes, de crédits gratuits ou de tarifs à la consommation.
- La page du jeu de données d’exemple est indiquée comme bientôt disponible et ne peut pas être considérée comme accessible pour téléchargement.
- Lors de la vérification du classement public, les résultats des modèles disponibles n’ont pas été affichés.
- La simulation peut toujours présenter des différences visuelles, de latence et de règles par rapport au site réel.
- Les environnements propres à l’entreprise et les trajectoires artificielles peuvent entraîner des coûts de production élevés.
- Les comptes réels, les identifiants de connexion et les détails de paiement sont des informations hautement sensibles.
- Les scores de référence ne représentent que des tâches et des versions spécifiques, et ne peuvent pas prouver une capacité d’autonomie générale.
- Le fait que le SDK Python soit disponible ne signifie pas que la plateforme, l’environnement ou les données soient open source.
- Aucun dépôt GitHub officiel public ou licence open source explicite n’a été trouvé.
- La politique de confidentialité ne fixe pas de durée de conservation déterminée pour les différents types de données.
Prix et modes d’accès
| Projet | État actuel | Explication des frais |
|---|---|---|
| Navigation sur le site officiel | Public | Voir gratuitement les descriptions de produits, les études et les classements |
| Consultation des classements | Public | Pas de frais requis, mais les données de notes ne sont pas affichées pour le moment. |
| Test privé | Demande d’accès | Prix fixe non divulgué |
| Plateforme complète | Demande d’accès | Négocier par équipe, environnement, tâche et taille |
| Simulation d’entreprise personnalisée | Services aux entreprises | Il faut établir un devis en fonction du site et du flux de travail |
| Données d’entraînement pour les experts | Services aux entreprises | Tarification selon le domaine, la longueur de la trajectoire et les exigences de qualité |
| L’agent soumet l’évaluation | Contacter l’équipe | Les règles de tarification ne sont pas indiquées sur la page publique. |
| Ensemble de données d’exemple | Bientôt disponible | Aucun prix public ou téléchargement disponible |
La date de vérification des prix est le 22 août 2026. Foundry n’a pas encore annoncé les tarifs pour l’abonnement standard, le paiement par utilisation ou les contrats entreprises, il est donc impossible de remplir les prix en se basant sur d’autres produits Foundry portant le même nom.
Que faut-il confirmer lors de la soumission d’un prix ?
| Variable de tarification | Contenu à confirmer | Raisons qui peuvent affecter les coûts |
|---|---|---|
| Quantité environnementale | Applications d’entreprise et versions à simuler | Chaque application doit être modélisée et maintenue. |
| Taille de la tâche | Nombre de tâches, difficulté, nombre moyen d’étapes et état | Exécution de tâches longues et annotation supplémentaire |
| Concurrentiel et fréquence | Trajectoires quotidiennes ou mensuelles, concurrence et pics | Impact sur le calcul et les ressources du navigateur |
| Services de données | Est-il nécessaire une démonstration par un expert, une vérification et la correction des erreurs ? | Les écarts de coûts de qualité artificielle sont importants |
| Fidélité | Exigences visuelles, comportementales, de données et de délais | Le haut-parleur haute fidélité nécessite plus de calibration. |
| Déploiement et sécurité | Environnements partagés, dédiés ou privés | Les exigences de séparation et de conformité affectent l’architecture |
| Soutien | SLA, réponse, personnalisation et assistance à la recherche | Le soutien aux entreprises est généralement facturé séparément |
Plateformes de support et interfaces techniques
| Plateforme ou interface | État de support | Utilisation |
|---|---|---|
| Site web officiel | Soutien | Présentation du produit, demande et contenu de la recherche |
| Environnement de navigateur de simulation | Soutien | Exécuter et réinitialiser les tâches de page web |
| Python SDK | Tests privés disponibles | Se connecter aux workflows d’agents intelligents existants |
| Connexion du navigateur CDP | L’exemple montre le support. | Laisser l’agent contrôler le navigateur de tâches |
| Interface événements et états | L’exemple montre le support. | Lire les événements, l’état final et les modifications |
| Classement public | Soutien | Présenter les normes de référence et les méthodes |
| Application de bureau ou mobile indépendante | Aucun résultat trouvé | Le produit s’adresse principalement au développement et à l’interface avec les entreprises |
| Console de contrôle autonome publique | Aucun résultat trouvé | Une capacité complète nécessite une qualification de test privé. |
Sécurité des clés API et des identifiants
Les exemples SDK nécessitent une clé Foundry ; les tâches peuvent également inclure des identifiants de connexion et des détails de paiement. L’équipe doit utiliser des comptes de test, des moyens de paiement fictifs et un système de gestion des clés isolé, afin d’éviter que les identifiants de production ne parviennent dans l’ensemble d’entraînement ou les journaux.
- Utiliser des clés indépendantes et rotatives pour chaque environnement et équipe.
- Accordez uniquement aux comptes de test les permissions nécessaires pour atteindre le référentiel.
- Masquer les mots de passe, les tokens, les informations de paiement et les champs personnels dans les journaux et les trajectoires.
- Il est interdit aux agents d’accéder à des noms de domaine et des réseaux en dehors du champ de la tâche.
- Définir le délai de fonctionnement, la limite d’actions et l’arrêt d’urgence.
- Ajout d’une validation pour l’export des données et la publication des classements.
- Détruire régulièrement les identifiants expirés et les données de test des projets terminés.
Confidentialité et collecte de données
Les informations soumises par les utilisateurs mentionnées dans la politique de confidentialité comprennent l’adresse e-mail, le nom, l’organisation, les soumissions d’agents, les résultats de référence et le contenu des communications. Les informations collectées automatiquement incluent l’analyse d’utilisation, le dispositif, l’IP, les cookies, les indicateurs de performance et les journaux d’erreurs.
Ces données sont utilisées pour les services opérationnels, le traitement des soumissions d’agents intelligents, la génération de résultats de référence, l’amélioration des produits, ainsi que pour soutenir la communication et la sécurité. Les prestataires de services d’hébergement, d’analyse et de support client peuvent traiter les données correspondantes dans l’exercice de leurs fonctions.
Listes de classement publiques et confidentielles
Selon les directives, les performances des agents intelligents et les résultats de référence peuvent être affichés dans des classements publics, mais les informations personnelles ne seront pas divulguées sans un accord explicite. Les entreprises doivent néanmoins s’assurer avant soumission que le nom de l’agent, la configuration du modèle et les traces d’échec seront rendus publics.
Conservation des données, transfrontalier et droits
Les informations personnelles sont conservées pendant la durée nécessaire à la prestation des services et à la réalisation des objectifs de la politique en vigueur, ou plus longtemps si cela est exigé par la loi ; aucun nombre de jours fixe n’est indiqué. Les données peuvent être transférées dans d’autres pays pour y être traitées, et des mesures de protection des données applicables doivent être mises en œuvre.
Selon leur lieu de résidence, les utilisateurs peuvent demander l’accès, la mise à jour, la suppression, la limitation ou l’opposition au traitement de leurs données, ainsi que le transfert de celles-ci et le retrait de leur consentement. Le service n’est pas destiné aux enfants de moins de 13 ans.
GitHub, SDK et statut open source
Le site officiel présente clairement des exemples d’intégration du SDK Python, mais aucun dépôt GitHub public confirmé par l’éditeur, aucune page de package ou licence open source n’a été trouvée. Le SDK est probablement distribué uniquement à des clients de test privés.
| Projet | Statut public | Conclusion |
|---|---|---|
| Plateforme Foundry | Services d’entreprise à code fermé | Le produit lui-même n’est pas open source. |
| Python SDK | Affiché sur le site officiel, l’accès doit être obtenu | La page publique ne précise pas la licence. |
| Article SDRBench | Lisible publiquement | La publication d’un article ne signifie pas que le code environnemental est open source. |
| Ensemble de données d’exemple | La marque sera bientôt lancée | Ne pas traiter comme publié |
| GitHub officiel | Aucun entrepôt confirmable non trouvé | Ne confondez pas Microsoft ou d’autres projets du même nom. |
| Code de l’environnement de simulation | Non divulgué | Il est impossible de se déployer seul uniquement via le site officiel |
Différences avec Microsoft Foundry
| Élément de comparaison | Cette page Foundry | Microsoft Foundry |
|---|---|---|
| Entité opérationnelle | Équipe indépendante de plateforme d’agents intelligents pour navigateurs | Microsoft |
| Utilisation principale | Simulation de pages web, évaluation, données et apprentissage par renforcement | Construire, déployer et gérer les applications d’IA d’entreprise et les agents intelligents |
| Interface principale | SDK Python privé et navigateur de simulation | Plateforme cloud Azure, SDK et services |
| Prix | Tests privés, non publics | Facturation selon les services et ressources Azure spécifiques |
| SDRBench | Référence de recherche officielle | Ce n’est pas la composition de son produit |
| Nom de domaine du site officiel | thefoundryai.com | Service cloud Microsoft |
Informations de base
| Projet | Contenu |
|---|---|
| Nom de l’outil | Foundry |
| Ancien nom de domaine de la marque | foundryrl.com |
| Type d’outil | Plateforme d’simulation d’agents navigateurs, d’évaluation, de données et d’apprentissage par renforcement |
| Moteur principal | Agent Web Engine |
| Référence publique | SDRBench |
| Taille de la tâche | SDRBench contient 50 tâches déterministes |
| État de connexion | Test privé |
| Modèle de prix | Non divulgué, demande d’accès pour négociation avec l’entreprise |
| Plateformes principales | Web, navigateur de simulation et SDK Python |
| Langage de développement | L’exemple du site officiel est en Python |
| API publique | Aucune documentation d’aide publique complète n’est fournie. |
| SDK officiel | Fournir le chemin d’accès au SDK Python |
| Le produit est-il open source | Pas open source |
| GitHub officiel | Non confirmé |
| Date de mise à jour de la politique de confidentialité | 28 octobre 2025 |
| Date de vérification du prix | 22 août 2026 |
Indice de recommandation
Indice de recommandation : 4,1 / 5. Foundry propose des orientations complètes pour résoudre les problèmes les plus difficiles liés aux agents navigateurs, tels que le décalage environnemental, l’évaluation sur de longues trajectoires et les données d’entraînement, et convient aux équipes spécialisées dans le développement d’agents.
Le principal défaut est que ce reste un test privé, les prix et la documentation complète ne sont pas publics, et il n’y a pas de résultats disponibles pour le classement. Les utilisateurs ordinaires et les entreprises qui souhaitent simplement automatiser des pages web ne bénéficieront pas directement.
Questions fréquentes
À quoi sert Foundry ?
Il fournit à l’équipe des agents navigateurs des simulations de pages web réinitialisables, des exécutions d’évaluation, des données de trajectoires longues d’experts et un environnement d’entraînement pour l’apprentissage par renforcement.
Est-ce Microsoft Foundry ?
Non. Les produits de cette page sont gérés par une équipe indépendante, spécialisée dans la simulation et l’évaluation d’agents navigateurs, et sont distincts de la plateforme cloud portant le même nom chez Microsoft.
Foundry est-il gratuit ?
Le site officiel peut être consulté gratuitement, mais la plateforme complète est en phase de test privé ; aucun quota gratuit, forfait standard ou prix fixe pour les entreprises n’a été annoncé.
Comment obtenir les droits d’accès ?
Il est nécessaire de soumettre une demande de test privé sur le site officiel ou de contacter l’équipe pour préciser les agents intelligents, les tâches, l’environnement, la quantité de trajectoires et les besoins en données.
Y a-t-il un SDK Python ?
Un chemin d’accès est fourni ; le site officiel présente des exemples en Python utilisant l’environnement AWE, l’ID de tâche, la connexion du navigateur et la lecture des événements.
Qu’est-ce que SDRBench ?
Il s’agit d’une référence de navigateur réinitialisable et d’un terrain d’entraînement à l’apprentissage renforcé pour les workflows de développement des ventes, comprenant 50 tâches déterministes inter-applications.
Y a-t-il des scores de modèles dans le classement ?
Le classement comprend des champs pour le modèle, le taux de succès et le temps de traitement, mais lors de la vérification, la page indique qu’il n’y a pas de résultats de référence disponibles, ce qui empêche de déterminer un classement.
Est-il possible d’évaluer des agents intelligents propriétaires ?
Il est possible de soumettre des agents intelligents, ou de contacter l’équipe pour utiliser son propre ensemble de données ou son flux de travail d’entreprise comme référence. Les critères d’éligibilité et les frais ne sont pas divulgués.
Peut-on s’entraîner sur un site réel ?
L’accent de Foundry est mis sur la simulation contrôlée, afin d’éviter les déviations des sites réels et les restrictions liées à l’anti-automatisation. Les résultats de la simulation doivent néanmoins être vérifiés dans un environnement réel autorisé.
Peut-on générer des données d’entraînement ?
Des données de trajectoires longues personnalisées, annotées par des experts, peuvent être fournies pour un fine-tuning supervisé sur des plateformes d’entreprise réelles. La taille exacte, les normes de qualité et les prix doivent faire l’objet de négociations.
Foundry est-il open source ?
Pas de code open source. Les articles et les exemples SDK sont accessibles au public, mais aucun code de plateforme open source officielle, d’environnement de simulation ou de licence explicite n’a été trouvé.
Le jeu de données d’exemple peut-il être téléchargé ?
Lors de la vérification, l’ensemble de données d’exemple est toujours indiqué comme bientôt disponible et ne peut pas être considéré comme déjà accessible.
Les résultats seront-ils rendus publics ?
La politique de confidentialité indique que les performances des agents et les résultats de référence peuvent figurer dans des classements publics. Il convient de vérifier les champs publics et les exigences de confidentialité avant soumission.
Pendant combien de temps les données sont-elles conservées ?
La politique de confidentialité ne précise que la période nécessaire pour remplir les objectifs du service ou répondre aux exigences légales, sans fixer de durée de conservation déterminée. Les contrats d’entreprise doivent être stipulés par catégorie.
Est-ce adapté aux utilisateurs ordinaires d’automatisation de sites web ?
Généralement inadapté. Il s’adresse à des équipes spécialisées dans la création, l’entraînement et l’évaluation d’agents intelligents pour navigateurs, et non aux utilisateurs ordinaires qui souhaiteraient enregistrer directement le déroulement des pages web.
Résumé
Foundry regroupe l’environnement du site web, son état, les événements, les évaluations et les trajectoires d’entraînement au sein d’une même infrastructure, permettant aux équipes d’agents navigateurs d’obtenir des cycles de développement stables, comparables et reproductibles. SDRBench montre une direction concrète pour des processus longs à l’échelle inter-applications.
L’équipe souhaitant l’adopter doit d’abord demander un test privé, utiliser ses propres tâches de représentation pour vérifier la cohérence entre la simulation et l’environnement réel, et confirmer dans le contrat le prix, la confidentialité des données, la divulgation des résultats, l’isolement des identifiants, la durée de conservation et la licence SDK.
Outils similaires à Foundry

 Numéro d’enregistrement de sécurité publique du Guangxi : 45132202000164